 Embedded HandbookПриложения
75а. Профилировщик на самом камне: выборка счётчика команд по таймеру и через DWT
Раздел 75.2 показал профилировщик на компьютере и оставил для камня два приёма: счётчик тактов по участкам кода (73.1, 35.3) и учёт времени задач ядром ОСРВ (26.9, 33б). У обоих одно условие — надо заранее знать, что мерить: расставить метки или разбить работу на задачи. Когда неизвестно, где искать, нужен третий приём: прерывание таймера раз за разом смотрит, какую команду программа выполняла в этот миг. Тысяча таких выборок — и доля выборок в каждой функции равна её доле времени. Меток в коде нет вовсе.
Здесь два способа. Первый — свой обработчик прерывания таймера: работает на любом Cortex-M, весь код — 114 байт без выдачи. Он собран, прогнан в QEMU и сверен с истиной — счётом каждой выполненной команды. На этом же стенде пойманы две ловушки, из-за которых профиль врёт, не подавая виду: выборка в такт программе и участки с запретом прерываний. Второй — выборку ведёт само ядро: блок DWT шлёт адреса в поток ITM по линии SWO (раздел 21), и программа не тратит на это ни одной команды. Для него здесь настройка регистров и свой разбор потока, проверенный на синтетических данных.
Опоры: кадр исключения и EXC_RETURN — раздел 7а; SWO, ITM и пакеты — раздел
21; счётчик тактов — 35.3 и 73; трассировка задач — 33б. Документы:
core_cm3.h и core_cm4.h из CMSIS 5.9.0 (биты DWT->CTRL), RM0090 и RM0008
(блоки DWT и ITM у F4 и F1), RM0468 (описание полей DWT_CTRL). Формат
пакетов DWT взят из разборщика pyOCD 0.45.1 (github.com/pyocd/pyOCD, файл
pyocd/trace/swo.py, лицензия Apache-2.0). Опыт — в образе stm-arm:1:
arm-none-eabi-gcc 12.2.1, QEMU 7.2.22, машины netduinoplus2 (Cortex-M4,
та же, что в 33б) и netduino2 (Cortex-M3; RCC, USART1 и TIM2 у неё по
тем же адресам, что у F4).
Как это называется в документации
Оригинал Перевод sampling (statistical) profiler профилировщик выборкой: раз в период смотрит, где программа PC sample выборка счётчика команд histogram bucket корзина: один счётчик на диапазон адресов lockstep sampling выборка в такт программе: период кратен её обороту randomized sampling period период выборки со случайной добавкой skid снос: выборка приписана не той команде, что работала periodic PC sample packet пакет периодической выборки PC от блока DWT hardware source packet пакет от железа ядра, а не от программы POSTCNT, POSTPRESET счётчик-делитель периода выборки в DWT и число, с которого он считает
75а.1 Идея: выборка вместо меток
Счётчик тактов отвечает на вопрос «сколько длится этот участок». Выборка отвечает на другой: «на что уходит время всей программы». Таймер прерывает программу через равные промежутки; обработчик записывает адрес команды, на которой её застал. Функция, занимающая 70 % времени, попадётся в 70 % выборок — как прохожие на фотографиях улицы, снятых раз в минуту.
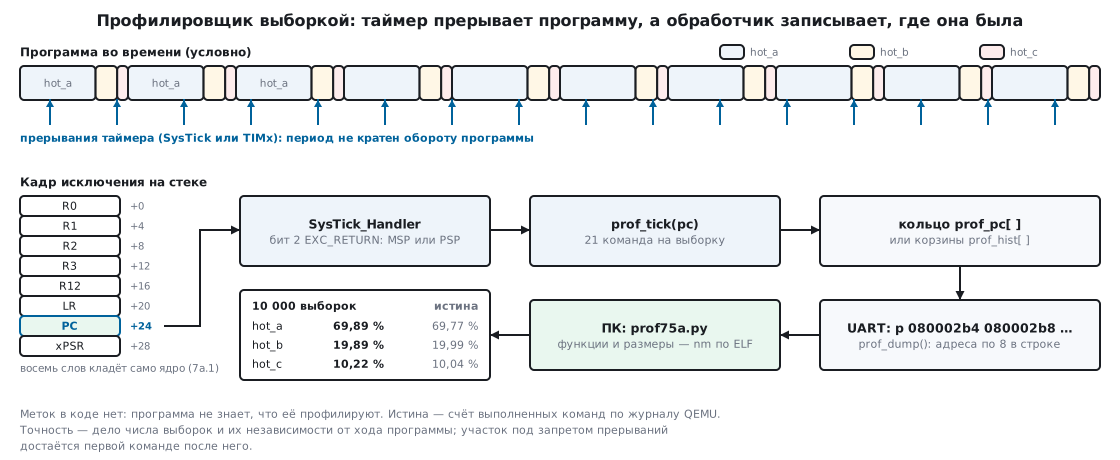
Что это даёт и чего не даёт:
- даёт долю времени каждой функции, включая библиотечные и те, о которых не подумали; с сырыми адресами — до строки исходника;
- не даёт числа вызовов, цепочки «кто кого позвал» и точной длительности одного прохода — для этого остаются счётчик тактов и трассировка;
- точность — статистическая: она растёт с числом выборок и только если выборки не связаны с ходом программы (75а.4).
75а.2 Обработчик: PC из кадра исключения
На входе в прерывание ядро само кладёт на стек восемь слов (7а.1). Слово с
индексом 6, смещение 24 байта, — PC: адрес команды, которая выполнилась бы
следующей. Его и надо забрать. Тонкость одна: кадр лежит на том стеке,
на котором работал прерванный код, — на MSP или на PSP; какой из двух,
говорит бит 2 числа EXC_RETURN в LR (7а.3). Пролог из шести команд
находит кадр и передаёт PC обычной функции на C:
__attribute__((naked)) void PROF_ISR(void)
{
    __asm volatile(
        "tst   lr, #4        \n"         /* бит 2 EXC_RETURN: на каком стеке лежит кадр */
        "ite   eq            \n"
        "mrseq r0, msp       \n"
        "mrsne r0, psp       \n"
        "ldr   r0, [r0, #24] \n"         /* слово 6 кадра — PC прерванной программы */
        "b     prof_tick     \n");
}
PROF_ISR — имя обработчика того таймера, который ведёт выборку. Их два на
выбор, и разница между ними спрятана в три макроса:
#if PROF_TIM3                            /* выборку ведёт TIM3 */
#define PROF_ISR          TIM3_IRQHandler
#define PROF_ACK()        (TIM_SR(TIM3_BASE) = ~1u)          /* снять флаг обновления UIF */
#define PROF_PERIOD(t)    (TIM_ARR(TIM3_BASE) = (t) - 1u)
#else                                    /* выборку ведёт SysTick: флаг снимать не нужно */
#define PROF_ISR          SysTick_Handler
#define PROF_ACK()        ((void)0)
#define PROF_PERIOD(t)    (SYST_RVR = (t) - 1u)
#endif
Сама выборка — запись адреса в кольцо или прибавление единицы к корзине:
__attribute__((used)) void prof_tick(uint32_t pc)
{
    PROF_ACK();                          /* первым делом, иначе прерывание TIM3 повторится */
#if PROF_HIST
    uint32_t i = (pc - (uint32_t)&_stext) >> PROF_SHIFT;
    if (i >= PROF_BINS)
        prof_out++;                      /* адрес вне корзин: ОЗУ, загрузчик, чужой код */
    else if (prof_hist[i] != 0xFFFFu)
        prof_hist[i]++;                  /* насыщение: счётчик не обернётся в ноль */
#else
    prof_pc[prof_n & (PROF_RAW_N - 1u)] = pc;   /* кольцо: новая выборка затирает самую старую */
#ifdef PROF_TAG
    prof_tag[prof_n & (PROF_RAW_N - 1u)] = (uint32_t)PROF_TAG;
#endif
#endif
#if PROF_JITTER
    prof_rnd ^= prof_rnd << 13;          /* xorshift32: следующий период — случайной длины */
    prof_rnd ^= prof_rnd >> 17;
    prof_rnd ^= prof_rnd << 5;
    PROF_PERIOD(prof_period + (prof_rnd & PROF_JITTER));
#endif
    if (++prof_n == prof_limit)
        prof_stop();                     /* набрали заказанное — таймер стоп */
}
prof_tick возвращается обычным bx lr: в LR всё ещё лежит EXC_RETURN,
и ядро само снимает кадр. Зачем строки PROF_JITTER и PROF_TAG — в 75а.4
и 75а.5. Запуск:
void prof_start(uint32_t period, uint32_t limit)
{
    prof_n = 0u;
    prof_limit = limit;                  /* 0 — без остановки: в кольце последние PROF_RAW_N выборок */
#if PROF_JITTER
    prof_period = period;
#endif
#if PROF_TIM3
    RCC_APB1ENR |= RCC_TIM3EN;
    TIM_CR1(TIM3_BASE) = 0u;
    TIM_PSC(TIM3_BASE) = PROF_TIM3_PSC;  /* TIM3 16-битный: период длиннее 65 536 отсчётов — через делитель */
    PROF_PERIOD(period);
    TIM_EGR(TIM3_BASE) = 1u;             /* UG: делитель и период действуют сразу */
    TIM_SR(TIM3_BASE) = 0u;              /* флаг от UG не нужен */
    TIM_DIER(TIM3_BASE) = 1u;            /* UIE: прерывание по обновлению */
    NVIC_IPR(TIM3_IRQ) = 0u;             /* приоритет 0 — срочнее всех */
    NVIC_ISER0 = 1u << TIM3_IRQ;
    TIM_CR1(TIM3_BASE) = 1u;             /* CEN */
#else
    SCB_SHPR_SYSTICK = 0u;               /* приоритет 0 — срочнее всех */
    PROF_PERIOD(period);                 /* период — в тактах ядра, до 2^24 */
    SYST_CVR = 0u;
    SYST_CSR = 7u;                       /* ENABLE | TICKINT | CLKSOURCE: счёт от частоты ядра */
#endif
}
Какой таймер. SysTick есть у каждого STM32, но в живой прошивке он
обычно занят: тик HAL или ядра ОСРВ. Тогда выборку отдают свободному таймеру
— сборка с PROF_TIM3=1, обработчик тот же. Опыты ниже идут на SysTick;
вариант с TIM3 собран для F103 и F407, но не запускался: в QEMU 7.2 событие
обновления TIM3 приходит не с периодом ARR — при ARR = 9999 между
прерываниями прошло больше 100 000 отсчётов.
Cortex-M0. Команд tst с константой и ite там нет; в файле есть
второй пролог из десяти команд, он выбирается сам по __ARM_ARCH_6M__ и
собран для -mcpu=cortex-m0.
После сборки -Os обработчик — 6 команд пролога и 15 команд prof_tick:
21 команда на выборку. Набранное выдаёт prof_dump() — адреса
шестнадцатерично, по восемь в строке:
prof raw n=10000
p 080002b4 080002b8 080002ac 080002b2 080002ce 080002aa 080002b0 080002b0
p 080002b4 080002b8 080002ac 080002b2 080002ce 080002aa 080002ba 080002b0
75а.3 Разбор на компьютере и первый профиль
Адреса превращает в имена таблица символов ELF. Команда
arm-none-eabi-nm -n -S печатает для каждой функции адрес и размер; остаётся
найти, в чей диапазон попал каждый адрес, и посчитать. Скрипт prof75a.py —
пять функций (строки import и запуск из командной строки опущены):
def load_symbols(elf, nm="arm-none-eabi-nm"):
    """Функции из ELF: список (адрес, размер, имя) по возрастанию адреса."""
    out = subprocess.run([nm, "-n", "-S", "--defined-only", elf],
                         capture_output=True, text=True, check=True).stdout
    syms, seen = [], set()
    for line in out.splitlines():
        f = line.split()
        if len(f) == 4 and f[2] in "TtW" and int(f[0], 16) not in seen:
            seen.add(int(f[0], 16))             # слабые синонимы по тому же адресу — один раз
            syms.append((int(f[0], 16), int(f[1], 16), f[3]))
    return syms


def lookup(syms, pc):
    """Имя функции, в которую попадает адрес, или «?»."""
    i = bisect.bisect_right(syms, (pc, 1 << 32)) - 1
    if i >= 0 and pc < syms[i][0] + syms[i][1]:
        return syms[i][2]
    return "?"


def read_dump(path):
    """Вернуть (сырые адреса, корзины): корзины — список (начало, размер, счётчик)."""
    raw, bins, base, shift, k = [], [], 0, 0, 0
    for line in open(path, encoding="ascii", errors="replace"):
        m = re.match(r"prof hist base=0x([0-9a-f]+) shift=(\d+)", line)
        if m:
            base, shift, k = int(m.group(1), 16), int(m.group(2)), 0
        elif line.startswith("p "):
            raw += [int(x, 16) for x in line.split()[1:]]
        elif line.startswith("h "):
            for x in line.split()[1:]:
                if int(x, 16):
                    bins.append((base + (k << shift), 1 << shift, int(x, 16)))
                k += 1
    return raw, bins


def by_function(syms, raw, bins):
    """Счёт выборок по функциям. Корзина на стыке функций делится между ними по числу байт."""
    cnt = collections.Counter()
    for pc in raw:
        cnt[lookup(syms, pc)] += 1
    for start, size, n in bins:
        owners = [lookup(syms, a) for a in range(start, start + size, 2)]   # команды Thumb — по чётным адресам
        owners = [o for o in owners if o != "?"] or ["?"]                   # заполнитель между функциями не в счёт
        for o in owners:
            cnt[o] += n / len(owners)
    return cnt


def report(cnt):
    total = sum(cnt.values())
    print("samples %d" % round(total))
    for name, n in sorted(cnt.items(), key=lambda kv: (-kv[1], kv[0])):
        print("  %6.2f %%  %8.1f  %s" % (100.0 * n / total, n, name))
Контрольная программа. Чтобы проверить профилировщик, нужна программа, про которую ответ известен заранее. Три одинаковых цикла, доля времени задаётся числом оборотов:
__attribute__((noinline)) void hot_a(uint32_t n)
{
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
}
        while (prof_n < limit) {
            hot_a(700);
            hot_b(200);
            hot_c(100);
        }
Истина. QEMU запущен с ключом -icount shift=0: модельное время идёт по
командам, одна команда — одна наносекунда, и прогон повторяется команда в
команду. С ключами -singlestep -d exec эмулятор пишет в журнал каждую
выполненную команду с именем функции. По журналу один оборот цикла — ровно
5022 команды: hot_a — 3504 (69,77 %), hot_b — 1004 (19,99 %), hot_c —
504 (10,04 %), сам цикл в run — 10 (0,20 %). Это и есть истинные доли: в
QEMU команды стоят одинаково.
Профиль. В SysTick->LOAD — 2012: при частоте ядра 168 МГц у этой машины
QEMU выходит одна выборка в 11 982 команды. Таблица prof75a.py по 10 000
выборок:
samples 10000
   69.89 %    6989.0  hot_a
   19.89 %    1989.0  hot_b
   10.22 %    1022.0  hot_c
То же по первым 100 и 1000 выборкам, рядом с истиной (последний столбец — наибольшее расхождение, в процентных пунктах):
N            hot_a     hot_b     hot_c       run   max error
truth        69.77     19.99     10.04      0.20
100          70.00     20.00     10.00      0.00   0.23
1000         69.80     19.90     10.30      0.00   0.26
10000        69.89     19.89     10.22      0.00   0.20
Профиль верен до четверти процента уже на ста выборках. Но две вещи должны
насторожить. Ошибка не падает: десять тысяч выборок не точнее сотни. И
run не получила ни одной выборки из десяти тысяч, хотя ей положено
двадцать. Обе странности — одна ловушка.
75а.4 Две ловушки: выборка в такт программе и запрет прерываний
Выборка в такт программе
Между двумя выборками программа проходит 11 982 − 21 = 11 961 команду: 21
съедает сам обработчик. Оборот цикла — 5022 команды, то есть за одну выборку
точка внутри оборота сдвигается на 11 961 − 2 × 5022 = 1917 команд. У чисел
1917 и 5022 общий делитель 27. Значит, выборка обходит всего 5022 / 27 = 186
точек оборота и дальше ходит по ним по кругу. Разбор дампа это подтвердил:
последовательность адресов повторяется каждые 186 выборок, разных адресов
среди десяти тысяч — 15. Команды run в эти 186 точек не попали — и не
попадут никогда. После 186-й выборки профиль новых сведений не получает.
Хуже, когда период подобран «удачно»:
LOAD + 1 |
Период, команд | Что вышло |
|---|---|---|
| 1691 | 10 065 = 2 × 5022 + 21 | все 1000 выборок — один адрес 0x080002b0: hot_a — 100 % |
| 1681 | 10 005 | сдвиг 60 команд за выборку; первые 100 выборок: 58 / 25 / 16 / 1 % — ошибка 11,77 |
| 2013 | 11 982 | 186 точек оборота; ошибка 0,2 и не падает |
Свободный цикл попадает в такт случайно. Но есть программы, которые в такте всегда: главный цикл, работающий по таймеру.
__attribute__((noinline)) void wait_tick(void)
{
    while ((int32_t)(now() - next_at) < 0) {
    }
    next_at += TICK;
}
    while (prof_n < limit) {
        wait_tick();
        control();
        filter();
    }
Раз в 9999 команд — управление и фильтр, остальное время — ожидание. Истина
по журналу: wait_tick — 59,82 %, control — 30,08 %, filter — 10,03 %.
Выборка с тем же периодом 9999 команд — естественное желание «мерить раз в
тик» — дала три прогона и три разных ответа, смотря когда главный цикл
стартовал относительно выборки:
| Сдвиг старта, команд | Профиль по 1000 выборок |
|---|---|
| 1000 | wait_tick — 100 % |
| 8000 | control — 100 % |
| 6500 | filter — 100 % |
Каждый ответ выглядит убедительно и каждый ложный. Период на шесть команд длиннее (10 005) — тоже плохо: за 1000 выборок точка проползла 6000 команд из 9999, и вышло 33,20 / 50,10 / 16,70 % при истине 59,82 / 30,08 / 10,03. Период 10 577, далёкий от кратного, дал 60,00 / 30,20 / 9,80 % — ошибка 0,23.
Лечение — случайная добавка к периоду. Сборка с PROF_JITTER=2047: после
каждой выборки обработчик прибавляет к периоду случайное число от 0 до 2047
тактов таймера (строки xorshift32 в prof_tick). Основной период взят
нарочно худший — 1691, тот самый, что давал один адрес. Со случайной
добавкой 100 000 выборок контрольной программы дали 69,98 / 19,91 / 9,93 /
0,18 % — и run получила свои 0,18 % при истинных 0,20. Последовательность
больше не повторяется.
Цена — честная статистика. Выборки стали независимыми, и ошибка теперь
подчиняется закону √N: для функции с долей p среднеквадратичное
отклонение равно √(p(1 − p) / N). Те же 100 000 выборок, разбитые на блоки
по N; в каждой клетке — измеренный разброс и теория, в процентных пунктах:
| N в блоке | Блоков | hot_a |
hot_b |
hot_c |
|---|---|---|---|---|
| 100 | 1000 | 4,59 / 4,59 | 4,07 / 4,00 | 2,90 / 3,00 |
| 1000 | 100 | 1,54 / 1,45 | 1,25 / 1,26 | 0,97 / 0,95 |
| 10 000 | 10 | 0,47 / 0,46 | 0,37 / 0,40 | 0,36 / 0,30 |
Измеренное совпало с теорией. Отсюда правило: вдесятеро точнее — в сто раз больше выборок. Тысяча выборок различает функции с точностью около процента — для поиска узкого места этого хватает. Программа с главным циклом по таймеру с той же добавкой дала на 1000 выборок 58,80 / 32,40 / 8,70 % — ошибка 2,32 при теоретическом разбросе 1,45.
Запрет прерываний
Вторая ловушка — код, в который прерывание войти не может.
__attribute__((noinline)) void irq_off(void)
{
    __asm volatile("cpsid i");
}

__attribute__((noinline)) void irq_on(void)
{
    __asm volatile("cpsie i");
}

__attribute__((noinline)) void locked(uint32_t n)
{
    irq_off();
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
    irq_on();
}
Программа по очереди зовёт locked(300) и hot_a(700). По журналу locked
занимает 30,00 % времени, irq_on — 0,04 %: в ней две команды. Профиль по
10 000 выборок (с добавкой к периоду):
samples 10000
   69.89 %    6989.0  hot_a
   29.92 %    2992.0  irq_on
    0.15 %      15.0  main
    0.03 %       3.0  locked
    0.01 %       1.0  irq_off
Всё время locked досталось irq_on. Таймер сработал внутри закрытого
участка, прерывание ждало — и вошло сразу после cpsie i. Все 2992 выборки
лежат на одном адресе 0x080002fc: это bx lr, следующая команда за
cpsie i; addr2line называет строку 169 — закрывающую скобку irq_on.
Доля верная, место — нет: время приписано первой команде после участка.
Если участок длиннее периода выборки, теряется и доля. Прерывание умеет
ждать только в единственном числе: сколько бы раз таймер ни сработал за время
запрета, выборка будет одна. locked(7500) — это 37 507 команд, около двух
периодов. Истина та же, 30,00 %; профиль показал 17,10 % у irq_on и 82,89 %
у hot_a. На те же 10 000 выборок ушло 213 734 338 команд против 180 510 156
в прошлом прогоне: 15,5 % срабатываний таймера пропали.
Чужой обработчик — тот же запрет. Прерывание не вытесняет обработчик
с тем же или более срочным приоритетом. В опыте обработчик EXTI0 крутит
isr_work — 29,97 % времени по журналу. При равном приоритете с выборкой
isr_work не получила ни одной выборки из 10 000, а 30,35 % легли на main:
из них 30,26 — на одну команду по адресу 0x08000366, следующую за той, что
подняла прерывание. Стоило сделать EXTI0 менее срочным (приоритет 0x80) — и
isr_work получила свои 30,22 %. Поэтому prof_start ставит выборке
приоритет 0.
75а.5 Цена, корзины и задачи ОСРВ
Команды на выборку. Одна и та же работа прогнана без профилировщика и с ним; разность счётчика команд, делённая на число выборок, — целое число, на Cortex-M3 и Cortex-M4 одинаковое:
| Сборка | Команд на выборку |
|---|---|
| кольцо сырых адресов | 21 |
| корзины | 30 |
| кольцо + случайная добавка | 32 |
| корзины + случайная добавка | 41 |
Такты на плате не мерялись. Оценка сверху по правилу из 9.7 — по 12 тактов на вход и выход и по два такта на команду: 12 + 12 + 2 × 21 = 66 тактов.
| 1000 выборок в секунду | 10 000 в секунду | |
|---|---|---|
| F103, 72 МГц | 0,09 % | 0,92 % |
| F407, 168 МГц | 0,04 % | 0,39 % |
Тысяча выборок в секунду почти бесплатна. Самая дорогая сборка, 41 команда, — это 106 тактов и 1,47 % на 72 МГц при 10 000 выборок в секунду.
Память (-Os, Cortex-M3, адреса F103). Пролог, prof_tick, prof_start
и prof_stop — 20 + 44 + 40 + 10 = 114 байт; prof_dump — ещё 118; весь
объектный файл — 256 байт кода и строк. ОЗУ — 4104 байта: кольцо на 1024
выборки по 4 байта и два счётчика. Сборка с корзинами — 348 байт кода и 524
байта ОЗУ: 256 корзин по 2 байта покрывают 4 КБ кода.
Кольцо или корзины. Кольцо хранит адрес каждой выборки: точность — до команды, но 10 000 выборок — это 40 КБ, вдвое больше всего ОЗУ F103C8. Корзины — счётчик на диапазон адресов: память не зависит от числа выборок, копить можно часами. Расплата — точность. Одни и те же 100 000 выборок, разложенные по корзинам разного размера (код программы — 760 байт):
| Корзина, байт | Корзин | ОЗУ, байт | hot_a |
hot_b |
hot_c |
run |
Ошибка |
|---|---|---|---|---|---|---|---|
| сырые адреса | — | 400 000 | 69,98 | 19,91 | 9,93 | 0,18 | 0 |
| 2 | 380 | 760 | 69,98 | 19,91 | 9,93 | 0,18 | 0 |
| 4 | 190 | 380 | 63,02 | 26,87 | 8,94 | 1,16 | 6,96 |
| 16 | 48 | 96 | 43,45 | 31,98 | 10,22 | 3,86 | 26,53 |
Корзина в 2 байта точна — команды Thumb лежат по чётным адресам, — но ОЗУ под
неё столько же, сколько кода. Крупнее — и корзина накрывает стык функций:
hot_a занимает 14 байт, и её горячие команды делят корзину с соседкой.
Прошивка с корзинами по 16 байт показала hot_a — 46,06 %, а 13,95 % отдала
prof_dump, которая в это время не работала: она просто лежит перед hot_a.
Лечение — поставить функции на границы корзин. Ключ -ffunction-sections
и слово SUBALIGN(16) у секции .text в скрипте компоновщика выравнивают
каждую функцию по 16 байт. Код вырос с 1064 до 1208 байт, зато те же корзины
по 16 байт дали 69,20 / 20,23 / 10,34 / 0,23 %. В настоящей прошивке функции
крупнее четырнадцати байт, и на стыках лежит малая часть выборок; но
проверить это стоит на своей программе — одним прогоном с кольцом.
Под ОСРВ. Задачи работают на PSP, и кадр прерванной задачи лежит на её
стеке (7а.3). Пролог из 75а.2 это уже учитывает: контрольная программа,
переведённая на PSP, дала те же 686, 193 и 121 выборку из 1000, что и на
MSP. Остаётся вопрос «чьё это время»: одну функцию зовут разные задачи.
Ответ — класть рядом с адресом указатель на блок текущей задачи. Сборка с
-DPROF_TAG=pxCurrentTCB добавляет в prof_tick одну запись (строки
PROF_TAG в 75а.2) и 4 байта на выборку. Опыт — FreeRTOS 10.5.1
(github.com/FreeRTOS/FreeRTOS-Kernel, лицензия MIT), порт ARM_CM3; две задачи
зовут одну и ту же hot_a:
static void task_motor(void *arg)
{
    (void)arg;
    prof_start(PERIOD, cfg_samples);     /* после старта планировщика: он опускает приоритет SysTick */
    for (;;) {
        hot_a(600);
        if (prof_n >= cfg_samples)
            finish();
        taskYIELD();
    }
}

static void task_link(void *arg)
{
    (void)arg;
    for (;;) {
        hot_a(300);
        hot_b(100);
        taskYIELD();
    }
}
Перед дампом прошивка печатает таблицу «адрес блока — имя» (pcTaskGetName),
и разбор делит 5000 выборок по задачам:
samples 5000, tags 5000
   60.46 %    3023  task motor
   39.54 %    1977  task link
   59.06 %    2953  motor / hot_a
   29.02 %    1451  link / hot_a
    9.14 %     457  link / hot_b
По функциям hot_a — 88,08 % (по журналу 87,72 %), и эти проценты делятся
между задачами как два к одному — как 600 оборотов к 300. Переключение задач
(vTaskSwitchContext и PendSV_Handler) заняло 2,36 % выборок при 2,02 % по
журналу. Три оговорки. Выборка идёт с приоритетом 0 — срочнее порога
configMAX_SYSCALL_INTERRUPT_PRIORITY, поэтому видит и критические секции
ядра, но звать функции ядра из неё нельзя (28.6); чтение одного указателя —
можно. В опыте SysTick отдан профилировщику, тик ядра выключен, задачи
уступают друг другу сами; на плате тик остаётся ядру, а выборке дают TIMx.
И учёт времени задач ядром (33б.6, 35.3) даёт те же доли по задачам дешевле —
выборка нужна, когда вопрос «какая функция внутри задачи».
75а.6 Выборка самим ядром: DWT и ITM
У Cortex-M3 и M4 выборку умеет делать железо. RM0090 и RM0008 называют среди ролей блока DWT «PC sampler», а среди пакетов ITM — программные, от записи в канал (раздел 21), и аппаратные: их порождает DWT, а ITM только отправляет. Обработчика нет, программа не тратит ни одной команды. Цена другая: нужен вывод SWO и отладчик, который его принимает (21.1).
Биты управления — в DWT->CTRL. Позиции взяты из core_cm3.h и
core_cm4.h (они совпадают), смысл полей — из RM0468, где этот регистр
расписан для Cortex-M7 той же архитектуры; RM0090 и RM0008 полей не
описывают:
| Поле | Биты | Что делает |
|---|---|---|
CYCCNTENA |
0 | включает счётчик тактов CYCCNT (35.3) |
POSTPRESET |
4:1 | число, с которого счётчик-делитель POSTCNT считает вниз |
POSTINIT |
8:5 | его начальное значение; пишется, только пока POSTCNT выключен |
CYCTAP |
9 | по какому биту CYCCNT шагает POSTCNT: 0 — бит 6, 1 — бит 10 |
PCSAMPLENA |
12 | POSTCNT работает таймером пакетов периодической выборки PC |
CYCEVTENA |
22 | второй потребитель POSTCNT — пакеты счётчика событий |
Ещё один бит — в ITM->TCR: DWTENA, бит 3, пропускает пакеты DWT в поток.
Настройка целиком; линию SWO, ключ ITM и делитель скорости готовит
swo_init() из 21.2:
/* Включить периодическую выборку PC: tap — PCS_TAP_64 или PCS_TAP_1024, reload — 0…15. */
void pcs_start(uint32_t tap, uint32_t reload)
{
    swo_init();
    ITM->TCR |= ITM_TCR_DWTENA_Msk;      /* пропускать пакеты DWT в поток ITM */

    /* POSTINIT пишется, только пока POSTCNT выключен: сначала снять оба разрешения */
    DWT->CTRL &= ~(DWT_CTRL_PCSAMPLENA_Msk | DWT_CTRL_CYCEVTENA_Msk);
    DWT->CYCCNT = 0u;
    DWT->CTRL = (DWT->CTRL & ~(DWT_CTRL_CYCTAP_Msk | DWT_CTRL_POSTPRESET_Msk | DWT_CTRL_POSTINIT_Msk))
              | (tap << DWT_CTRL_CYCTAP_Pos)
              | (reload << DWT_CTRL_POSTPRESET_Pos)      /* с какого числа POSTCNT считает вниз */
              | (reload << DWT_CTRL_POSTINIT_Pos)        /* и с какого начинает */
              | DWT_CTRL_CYCCNTENA_Msk;                  /* POSTCNT шагает по биту CYCCNT: счётчик тактов должен идти */
    DWT->CTRL |= DWT_CTRL_PCSAMPLENA_Msk;                /* выборка пошла */
}
Период. Бит 6 двоичного счётчика переключается раз в 64 такта, бит 10 — раз в 1024: это шаг POSTCNT. Счётчик четырёхбитный; если считать, что от 15 до перезагрузки он делает 16 шагов, самая редкая выборка — раз в 1024 × 16 = 16 384 такта: 4394 выборки в секунду на 72 МГц и 10 254 на 168 МГц. На плате период не мерялся.
Пакет. Формат — по разборщику pyOCD. Заголовок пакета источника устроен
как в 21.6: биты 1:0 — размер данных (1, 2 или 4 байта), биты 7:3 — номер
источника. Добавляется бит 2: ноль — пишет программа, единица — железо. У
железа номер 0 — счётчики событий, 1 — трассировка исключений, 2 —
периодическая выборка PC. Отсюда заголовок выборки 0x17 и четыре байта
адреса младшим вперёд; адрес 0x080002b4 на линии — 17 b4 02 00 08.
Нулевой адрес pyOCD трактует как выборку во сне: PC нет. В синтетическом
потоке ниже такой пакет короткий — 15 00. Пять байт на выборку
при 200 000 байт в секунду на линии 2 МГц (21.7) — это потолок в 40 000
выборок в секунду на весь поток.
Разборщик itm75a.py — одна функция:
def parse(data, wait_sync=False):
    """Вернуть список событий (тип, значение, …). Типы: pc, sleep, itm, cnt, exc, dwt, sync, ovf, ts, bad."""
    i, out = 0, []
    if wait_sync:                               # подключились посреди потока: ждать синхропакет
        i = data.find(SYNC)
        i = len(data) if i < 0 else i
    while i < len(data):
        h = data[i]
        i += 1
        if h == 0x00:                           # синхропакет: нули и завершающий 0x80
            j = i
            while j < len(data) and data[j] == 0x00:
                j += 1
            if j < len(data) and data[j] == 0x80 and j - i >= 4:
                out.append(("sync",))
            else:
                out.append(("bad", h))
            i = j + 1
        elif h == 0x70:                         # переполнение: часть пакетов потеряна
            out.append(("ovf",))
        elif h & 0x03 == 0:                     # служебный пакет: метка времени или расширение
            while h & 0x80 and i < len(data):   # бит 7 — «дальше ещё байт»
                h = data[i]
                i += 1
            out.append(("ts",))
        else:                                   # пакет источника: 1, 2 или 4 байта данных
            size = 1 << ((h & 0x03) - 1)
            if i + size > len(data):
                break                           # хвост потока оборван посреди пакета
            value = int.from_bytes(data[i:i + size], "little")
            i += size
            src = h >> 3
            if h & 0x04 == 0:
                out.append(("itm", src, value, size))       # запись программы в канал src
            elif src == 2:                                  # периодическая выборка PC
                out.append(("pc", value) if size == 4 else ("sleep", value))
            elif src == 0:
                out.append(("cnt", value))                  # переполнение счётчика событий DWT
            elif src == 1:
                out.append(("exc", value))                  # вход в исключение и выход
            else:
                out.append(("dwt", src, value))             # трассировка данных
    return out
Проверка. QEMU блоки DWT и ITM не моделирует: после записи DEMCR,
ITM->TCR и DWT->CTRL читаются нулями, CYCCNT стоит. Поэтому поток
синтетический: 10 000 адресов из опыта 75а.3 упакованы в пакеты выборки
вперемешку со всем, что бывает на линии, — записями в каналы 0 и 1, метками
времени, трассировкой исключений, счётчиками событий, пакетами сна,
переполнениями и синхропакетами:
packet for pc 0x080002b4: 17 b4 02 00 08
stream 54887 bytes from 10000 samples: pc=10000 sleep=156 itm=1629 cnt=20 exc=100 dwt=0 sync=11 ovf=10 ts=101 bad=0
decoded = source: yes
Адреса вернулись все и в том же порядке; таблица prof75a.py по
разобранному потоку совпала с таблицей по дампу UART. Тот же поток разобран
разборщиком pyOCD — события совпали. Поток, обрезанный посреди пакета,
начался с ложной записи в канал 0; с ожиданием синхропакета
00 00 00 00 00 80 (ключ --sync) разбор начинается с целого пакета.
Чем отличается от способа A. Выборка DWT — не прерывание, поэтому запрет прерываний и чужие обработчики мешать ей не должны: вторая ловушка из 75а.4 к ней не относится. Первая остаётся: период выбирается из немногих ступеней, случайной добавки нет. В Keil то же включается в настройках трассировки (PC Sampling), записи видны в окне Trace Records как «PC Sample». Есть и готовые открытые приёмники такого потока — например, Orbuculum (github.com/orbcode/orbuculum); здесь он не запускался. На железе способ B в разделе не проверялся.
75а.7 Грабли
Профиль не уточняется, сколько ни копи; короткая функция не получила ни одной выборки. Программа периодична, период выборки постоянный — выборка ходит по кругу по немногим точкам. В опыте их было 186 из 5022. Лечит случайная добавка к периоду.
Одна функция — 100 %. Период выборки кратен периоду программы: главный цикл по таймеру и выборка «раз в тик». Три прогона дали 100 % трём разным функциям. Период не кратный и не близкий к кратному, а лучше — со случайной добавкой.
В профиле «горячая» функция из двух команд. Это конец участка с
запретом прерываний: время закрытого участка досталось команде после
cpsie i. В опыте — 29,92 % у irq_on. Смотреть надо на то, что было
перед этим адресом.
Долгий закрытый участок получил меньше, чем должен. За время запрета запоминается одно прерывание. Участок в два периода выборки показал 17,10 % вместо 30,00 %.
Обработчик прерывания не виден, а код после него «горячий». У выборки
приоритет не срочнее, чем у него. В опыте 30,35 % ушли в main; с
приоритетом выборки выше — 30,22 % у обработчика.
Все адреса — нули или мусор. Кадр взят не с того стека. Основной код на
PSP, а пролог читает MSP: в опыте все 1000 выборок дали адрес
0x00000000. Стек выбирают по биту 2 EXC_RETURN.
Функция пропала из профиля. Компилятор её встроил. Та же программа при
-O2: 100 % у main, hot_a нет вовсе. Сырые адреса это лечат —
arm-none-eabi-addr2line -f -i разворачивает встроенные вызовы:
hot_a at app75a.c:27
 (inlined by) run at app75a.c:79
 (inlined by) main at app75a.c:97
Корзины показали функцию, которая не работала. Корзина накрыла стык
функций: 13,95 % у prof_dump при корзине 16 байт и функциях по 14.
Корзина мельче или функции, выровненные по её границе.
Имена не те. Адреса переводит в имена только ELF той самой сборки (35в.7): после любой пересборки функции переезжают.
Поток SWO начинается с мусора. Приёмник включился посреди пакета. Ждать синхропакет.
В QEMU профиль по TIM3 не сходится. Модель таймера в QEMU 7.2 не
повторяет обновление с периодом ARR; для опытов в эмуляторе — SysTick.
75а.8 Итоги
- Выборка
PCпо прерыванию таймера показывает, на что уходит время всей программы, без меток в коде.PC— слово 6 кадра исключения, стек кадра — по биту 2EXC_RETURN. - Обработчик — 21 команда на выборку (30 с корзинами, 32 и 41 со случайной добавкой); 114 байт кода без выдачи. По оценке это 66 тактов: 0,09 % процессора при 1000 выборок в секунду на 72 МГц.
- На контрольной программе с истиной 69,77 / 19,99 / 10,04 % профиль дал
69,89 / 19,89 / 10,22 % по 10 000 выборок. Разбор —
prof75a.pyпо таблице символов изarm-none-eabi-nm. - Постоянный период и периодичная программа — ловушка: 186 точек из 5022, а при кратном периоде — один адрес и 100 % у одной функции. Случайная добавка к периоду возвращает закон √N: у функции с долей 70 % разброс 4,59 % на 100 выборках, 1,54 % на 1000, 0,47 % на 10 000.
- Запрет прерываний сносит выборку на команду после участка (29,92 % у
irq_onиз двух команд), а долгий участок ещё и теряет выборки (17,10 % вместо 30,00 %). Чужой обработчик виден, только если выборка срочнее его. - Кольцо адресов точно, но стоит 4 байта на выборку. Корзины не зависят от числа выборок, но на стыках функций врут: ошибка 6,96 при корзине 4 байта и 26,53 при 16; выравнивание функций по 16 байт её снимает ценой 144 байт кода.
- Под ОСРВ рядом с адресом кладут
pxCurrentTCB: 60,46 % у одной задачи и 39,54 % у другой при общей функции. - Cortex-M3 и M4 умеют выборку сами:
PCSAMPLENAвDWT->CTRL, пакет0x17и четыре байта адреса в потоке ITM. Разборщик проверен на синтетическом потоке в 54 887 байт и сверен с pyOCD; на железе не запускался.
Полные исходники
prof75a.c — профилировщик выборкой.
/* Раздел 75а: профилировщик выборкой. Прерывание таймера берёт из кадра исключения PC
 * прерванной программы и кладёт его в кольцо (PROF_HIST = 0) или в гистограмму (PROF_HIST = 1). */
#include "prof75a.h"
#include "io75a.h"

#if PROF_TIM3                            /* выборку ведёт TIM3 */
#define PROF_ISR          TIM3_IRQHandler
#define PROF_ACK()        (TIM_SR(TIM3_BASE) = ~1u)          /* снять флаг обновления UIF */
#define PROF_PERIOD(t)    (TIM_ARR(TIM3_BASE) = (t) - 1u)
#else                                    /* выборку ведёт SysTick: флаг снимать не нужно */
#define PROF_ISR          SysTick_Handler
#define PROF_ACK()        ((void)0)
#define PROF_PERIOD(t)    (SYST_RVR = (t) - 1u)
#endif

extern uint32_t _stext;                  /* начало кода — из скрипта компоновщика */

volatile uint32_t prof_n;
static uint32_t prof_limit;
#if PROF_HIST
uint16_t prof_hist[PROF_BINS];
uint32_t prof_out;
#else
uint32_t prof_pc[PROF_RAW_N];
#ifdef PROF_TAG                          /* метка к каждой выборке, например текущая задача ОСРВ */
extern void *volatile PROF_TAG;
uint32_t prof_tag[PROF_RAW_N];
#endif
#endif
#if PROF_JITTER
static uint32_t prof_period;
static uint32_t prof_rnd = 2463534242u;
#endif

#if defined(__ARM_ARCH_6M__)             /* Cortex-M0/M0+: команд tst с константой и ite там нет */
__attribute__((naked)) void PROF_ISR(void)
{
    __asm volatile(
        "movs  r0, #4        \n"
        "mov   r1, lr        \n"
        "tst   r1, r0        \n"         /* бит 2 EXC_RETURN: на каком стеке лежит кадр */
        "bne   1f            \n"
        "mrs   r0, msp       \n"
        "b     2f            \n"
        "1: mrs r0, psp      \n"
        "2: ldr r0, [r0, #24]\n"         /* слово 6 кадра — PC прерванной программы */
        "ldr   r1, =prof_tick\n"
        "bx    r1            \n");
}
#else
__attribute__((naked)) void PROF_ISR(void)
{
    __asm volatile(
        "tst   lr, #4        \n"         /* бит 2 EXC_RETURN: на каком стеке лежит кадр */
        "ite   eq            \n"
        "mrseq r0, msp       \n"
        "mrsne r0, psp       \n"
        "ldr   r0, [r0, #24] \n"         /* слово 6 кадра — PC прерванной программы */
        "b     prof_tick     \n");
}
#endif

__attribute__((used)) void prof_tick(uint32_t pc)
{
    PROF_ACK();                          /* первым делом, иначе прерывание TIM3 повторится */
#if PROF_HIST
    uint32_t i = (pc - (uint32_t)&_stext) >> PROF_SHIFT;
    if (i >= PROF_BINS)
        prof_out++;                      /* адрес вне корзин: ОЗУ, загрузчик, чужой код */
    else if (prof_hist[i] != 0xFFFFu)
        prof_hist[i]++;                  /* насыщение: счётчик не обернётся в ноль */
#else
    prof_pc[prof_n & (PROF_RAW_N - 1u)] = pc;   /* кольцо: новая выборка затирает самую старую */
#ifdef PROF_TAG
    prof_tag[prof_n & (PROF_RAW_N - 1u)] = (uint32_t)PROF_TAG;
#endif
#endif
#if PROF_JITTER
    prof_rnd ^= prof_rnd << 13;          /* xorshift32: следующий период — случайной длины */
    prof_rnd ^= prof_rnd >> 17;
    prof_rnd ^= prof_rnd << 5;
    PROF_PERIOD(prof_period + (prof_rnd & PROF_JITTER));
#endif
    if (++prof_n == prof_limit)
        prof_stop();                     /* набрали заказанное — таймер стоп */
}

void prof_start(uint32_t period, uint32_t limit)
{
    prof_n = 0u;
    prof_limit = limit;                  /* 0 — без остановки: в кольце последние PROF_RAW_N выборок */
#if PROF_JITTER
    prof_period = period;
#endif
#if PROF_TIM3
    RCC_APB1ENR |= RCC_TIM3EN;
    TIM_CR1(TIM3_BASE) = 0u;
    TIM_PSC(TIM3_BASE) = PROF_TIM3_PSC;  /* TIM3 16-битный: период длиннее 65 536 отсчётов — через делитель */
    PROF_PERIOD(period);
    TIM_EGR(TIM3_BASE) = 1u;             /* UG: делитель и период действуют сразу */
    TIM_SR(TIM3_BASE) = 0u;              /* флаг от UG не нужен */
    TIM_DIER(TIM3_BASE) = 1u;            /* UIE: прерывание по обновлению */
    NVIC_IPR(TIM3_IRQ) = 0u;             /* приоритет 0 — срочнее всех */
    NVIC_ISER0 = 1u << TIM3_IRQ;
    TIM_CR1(TIM3_BASE) = 1u;             /* CEN */
#else
    SCB_SHPR_SYSTICK = 0u;               /* приоритет 0 — срочнее всех */
    PROF_PERIOD(period);                 /* период — в тактах ядра, до 2^24 */
    SYST_CVR = 0u;
    SYST_CSR = 7u;                       /* ENABLE | TICKINT | CLKSOURCE: счёт от частоты ядра */
#endif
}

void prof_stop(void)
{
#if PROF_TIM3
    TIM_CR1(TIM3_BASE) = 0u;
#else
    SYST_CSR = 0u;
#endif
}

void prof_dump(void)
{
    uint32_t n = prof_n;
#if PROF_HIST
    puts1("prof hist base=0x");
    puthex((uint32_t)&_stext, 8);
    puts1(" shift=");
    putdec(PROF_SHIFT);
    puts1(" n=");
    putdec(n);
    puts1(" out=");
    putdec(prof_out);
    for (uint32_t i = 0; i < PROF_BINS; i++) {
        puts1((i % 16u) ? " " : "\nh ");
        puthex(prof_hist[i], 4);
    }
#else
    uint32_t first = (n > PROF_RAW_N) ? n - PROF_RAW_N : 0u;
    puts1("prof raw n=");
    putdec(n);
    for (uint32_t i = first; i < n; i++) {
        puts1(((i - first) % 8u) ? " " : "\np ");
        puthex(prof_pc[i & (PROF_RAW_N - 1u)], 8);
    }
#ifdef PROF_TAG
    for (uint32_t i = first; i < n; i++) {
        puts1(((i - first) % 8u) ? " " : "\ng ");
        puthex(prof_tag[i & (PROF_RAW_N - 1u)], 8);
    }
#endif
#endif
    puts1("\nend\n");
}
app75a.c — контрольные программы для профилировщика.
/* Раздел 75а: контрольные программы для профилировщика. QEMU, -icount shift=0: одна команда —
 * один отсчёт TIM2. SCEN 1 — три функции с долями около 70/20/10 %; 2 — главный цикл с жёстким
 * периодом (ловушка синхронной выборки); 3 — участок с запретом прерываний; 4 — работа в чужом
 * обработчике; 5 — цена одной выборки. */
#include "prof75a.h"
#include "io75a.h"

#ifndef SCEN
#define SCEN 1
#endif
#ifndef PERIOD
#define PERIOD 1681u                     /* период выборки в тактах SysTick */
#endif
#ifndef SAMPLES
#define SAMPLES 10000u
#endif
#ifndef CHUNKS
#define CHUNKS 1u
#endif

/* сколько выборок набрать — константой в данных: код прошивки от её значения не зависит */
const volatile uint32_t cfg_samples = SAMPLES;

/* три одинаковых цикла: доля времени задаётся числом оборотов */
__attribute__((noinline)) void hot_a(uint32_t n)
{
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
}

__attribute__((noinline)) void hot_b(uint32_t n)
{
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
}

__attribute__((noinline)) void hot_c(uint32_t n)
{
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
}

#if SCEN == 1
#if USE_PSP
static uint32_t pstack[128];

__attribute__((naked, noinline)) static void thread_on_psp(__attribute__((unused)) uint32_t *top)
{
    __asm volatile(
        "msr   psp, r0     \n"
        "movs  r0, #2      \n"           /* CONTROL.SPSEL = 1: основной код — на PSP, как задача ОСРВ */
        "msr   control, r0 \n"
        "isb               \n"
        "bx    lr          \n");
}
#endif

#if BAD_MSP
/* Нарочно неверный пролог: кадр всегда берётся с MSP. В опыте подменяет обработчик из prof75a.c
 * (там символ ослаблен командой objcopy --weaken-symbol). */
void prof_tick(uint32_t pc);

__attribute__((naked)) void SysTick_Handler(void)
{
    __asm volatile(
        "mrs   r0, msp       \n"
        "ldr   r0, [r0, #24] \n"
        "b     prof_tick     \n");
}
#endif

__attribute__((noinline)) static void run(void)
{
    uint32_t limit = cfg_samples;
    for (uint32_t c = 0; c < CHUNKS; c++) {
        uint32_t t0 = now();
        prof_start(PERIOD, limit);
        while (prof_n < limit) {
            hot_a(700);
            hot_b(200);
            hot_c(100);
        }
        puts1("span=");
        putdec(now() - t0);
        puts1("\n");
        prof_dump();
    }
}

int main(void)
{
    uart_init();
    clock_start();
#if USE_PSP
    thread_on_psp(&pstack[128]);
#endif
    run();
    sh_exit();
    for (;;) {
    }
}
#endif

#if SCEN == 2
/* главный цикл с жёстким периодом: раз в TICK команд — управление и фильтр, остальное — ожидание */
#ifndef TICK
#define TICK 9999u
#endif
#ifndef PHASE
#define PHASE 1000u                      /* когда первый запуск цикла относительно старта выборки */
#endif
static uint32_t next_at;

__attribute__((noinline)) void wait_tick(void)
{
    while ((int32_t)(now() - next_at) < 0) {
    }
    next_at += TICK;
}

__attribute__((noinline)) void control(void)
{
    for (uint32_t i = 0; i < 1000u; i++)
        __asm volatile("nop");
}

__attribute__((noinline)) void filter(void)
{
    for (uint32_t i = 0; i < 333u; i++)
        __asm volatile("nop");
}

int main(void)
{
    uint32_t limit = cfg_samples;
    uart_init();
    clock_start();
    prof_start(PERIOD, limit);
    next_at = now() + PHASE;
    while (prof_n < limit) {
        wait_tick();
        control();
        filter();
    }
    prof_dump();
    sh_exit();
    for (;;) {
    }
}
#endif

#if SCEN == 3
/* участок с запретом прерываний: LOCK_N оборотов под cpsid, OPEN_N — с открытыми прерываниями */
#ifndef LOCK_N
#define LOCK_N 300u
#endif
#ifndef OPEN_N
#define OPEN_N 700u
#endif

__attribute__((noinline)) void irq_off(void)
{
    __asm volatile("cpsid i");
}

__attribute__((noinline)) void irq_on(void)
{
    __asm volatile("cpsie i");
}

__attribute__((noinline)) void locked(uint32_t n)
{
    irq_off();
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
    irq_on();
}

int main(void)
{
    uint32_t limit = cfg_samples;
    uart_init();
    clock_start();
    uint32_t t0 = now();
    prof_start(PERIOD, limit);
    while (prof_n < limit) {
        locked(LOCK_N);
        hot_a(OPEN_N);
    }
    puts1("span=");
    putdec(now() - t0);
    puts1("\n");
    prof_dump();
    sh_exit();
    for (;;) {
    }
}
#endif

#if SCEN == 4
/* работа в чужом обработчике: EXTI0 поднимается программно и крутит 300 оборотов */
#ifndef ISR_PRIO
#define ISR_PRIO 0u                      /* 0 — как у выборки; 0x80 — менее срочный */
#endif
#define NVIC_ISPR0 REG(0xE000E200u)
#define EXTI0_IRQ  6

__attribute__((noinline)) void isr_work(uint32_t n)
{
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
}

void EXTI0_IRQHandler(void)
{
    isr_work(300);
}

int main(void)
{
    uint32_t limit = cfg_samples;
    uart_init();
    clock_start();
    NVIC_IPR(EXTI0_IRQ) = ISR_PRIO;
    NVIC_ISER0 = 1u << EXTI0_IRQ;
    prof_start(PERIOD, limit);
    while (prof_n < limit) {
        NVIC_ISPR0 = 1u << EXTI0_IRQ;    /* поднять прерывание: обработчик отработает сразу */
        hot_a(700);
    }
    prof_dump();
    sh_exit();
    for (;;) {
    }
}
#endif

#if SCEN == 5
/* цена выборки: одна и та же работа без профилировщика и с ним, разность — команды обработчика */
int main(void)
{
    uart_init();
    clock_start();
    uint32_t t0 = now();
    hot_a(250000);
    uint32_t off = now() - t0;
    prof_start(PERIOD, 0u);
    t0 = now();
    hot_a(250000);
    uint32_t on = now() - t0;
    uint32_t n = prof_n;
    prof_stop();
    puts1("cost off=");
    putdec(off);
    puts1(" on=");
    putdec(on);
    puts1(" samples=");
    putdec(n);
    puts1(" per_sample=");
    putdec((on - off) / n);
    puts1(" rem=");
    putdec((on - off) % n);
    puts1("\n");
    sh_exit();
    for (;;) {
    }
}
#endif
rtos75a.c — выборка под FreeRTOS с меткой задачи.
/* Раздел 75а: выборка под ОСРВ. FreeRTOS 10.5.1, порт ARM_CM3, QEMU netduino2. Две задачи зовут
 * одну и ту же функцию hot_a; рядом с PC профилировщик кладёт pxCurrentTCB (сборка с
 * -DPROF_TAG=pxCurrentTCB), и выборки делятся не только по функциям, но и по задачам. */
#include "FreeRTOS.h"
#include "task.h"
#include "prof75a.h"
#include "io75a.h"

#ifndef PERIOD
#define PERIOD 1691u
#endif
#ifndef SAMPLES
#define SAMPLES 10000u
#endif

const volatile uint32_t cfg_samples = SAMPLES;
static TaskHandle_t task_handle[2];

__attribute__((noinline)) void hot_a(uint32_t n)
{
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
}

__attribute__((noinline)) void hot_b(uint32_t n)
{
    for (uint32_t i = 0; i < n; i++)
        __asm volatile("nop");
}

void vPortSetupTimerInterrupt(void)      /* тик ядру не нужен: SysTick занят профилировщиком */
{
}

void rtos_assert(void)
{
    puts1("assert\n");
    sh_exit();
}

static void finish(void)
{
    for (uint32_t i = 0; i < 2u; i++) {  /* таблица «адрес блока задачи — имя» для разбора */
        puts1("task ");
        puthex((uint32_t)task_handle[i], 8);
        putc1(' ');
        puts1(pcTaskGetName(task_handle[i]));
        puts1("\n");
    }
    prof_dump();
    sh_exit();
}

static void task_motor(void *arg)
{
    (void)arg;
    prof_start(PERIOD, cfg_samples);     /* после старта планировщика: он опускает приоритет SysTick */
    for (;;) {
        hot_a(600);
        if (prof_n >= cfg_samples)
            finish();
        taskYIELD();
    }
}

static void task_link(void *arg)
{
    (void)arg;
    for (;;) {
        hot_a(300);
        hot_b(100);
        taskYIELD();
    }
}

int main(void)
{
    uart_init();
    clock_start();
    xTaskCreate(task_motor, "motor", 128, NULL, 1, &task_handle[0]);
    xTaskCreate(task_link, "link", 128, NULL, 1, &task_handle[1]);
    vTaskStartScheduler();
    for (;;) {
    }
}
prof75a.py — сводка выборок в таблицу «функция — доля времени».
#!/usr/bin/env python3
"""Раздел 75а: свести выборки профилировщика в таблицу «функция — доля времени».

    python3 prof75a.py uart.txt fw.elf [первые N выборок]

uart.txt — вывод prof_dump(): строки «p …» с сырыми адресами или «h …» со счётчиками корзин.
Функции и их размеры берутся из таблицы символов ELF командой arm-none-eabi-nm."""
import bisect
import collections
import re
import subprocess
import sys


def load_symbols(elf, nm="arm-none-eabi-nm"):
    """Функции из ELF: список (адрес, размер, имя) по возрастанию адреса."""
    out = subprocess.run([nm, "-n", "-S", "--defined-only", elf],
                         capture_output=True, text=True, check=True).stdout
    syms, seen = [], set()
    for line in out.splitlines():
        f = line.split()
        if len(f) == 4 and f[2] in "TtW" and int(f[0], 16) not in seen:
            seen.add(int(f[0], 16))             # слабые синонимы по тому же адресу — один раз
            syms.append((int(f[0], 16), int(f[1], 16), f[3]))
    return syms


def lookup(syms, pc):
    """Имя функции, в которую попадает адрес, или «?»."""
    i = bisect.bisect_right(syms, (pc, 1 << 32)) - 1
    if i >= 0 and pc < syms[i][0] + syms[i][1]:
        return syms[i][2]
    return "?"


def read_dump(path):
    """Вернуть (сырые адреса, корзины): корзины — список (начало, размер, счётчик)."""
    raw, bins, base, shift, k = [], [], 0, 0, 0
    for line in open(path, encoding="ascii", errors="replace"):
        m = re.match(r"prof hist base=0x([0-9a-f]+) shift=(\d+)", line)
        if m:
            base, shift, k = int(m.group(1), 16), int(m.group(2)), 0
        elif line.startswith("p "):
            raw += [int(x, 16) for x in line.split()[1:]]
        elif line.startswith("h "):
            for x in line.split()[1:]:
                if int(x, 16):
                    bins.append((base + (k << shift), 1 << shift, int(x, 16)))
                k += 1
    return raw, bins


def by_function(syms, raw, bins):
    """Счёт выборок по функциям. Корзина на стыке функций делится между ними по числу байт."""
    cnt = collections.Counter()
    for pc in raw:
        cnt[lookup(syms, pc)] += 1
    for start, size, n in bins:
        owners = [lookup(syms, a) for a in range(start, start + size, 2)]   # команды Thumb — по чётным адресам
        owners = [o for o in owners if o != "?"] or ["?"]                   # заполнитель между функциями не в счёт
        for o in owners:
            cnt[o] += n / len(owners)
    return cnt


def report(cnt):
    total = sum(cnt.values())
    print("samples %d" % round(total))
    for name, n in sorted(cnt.items(), key=lambda kv: (-kv[1], kv[0])):
        print("  %6.2f %%  %8.1f  %s" % (100.0 * n / total, n, name))


if __name__ == "__main__":
    symbols = load_symbols(sys.argv[2])
    samples, buckets = read_dump(sys.argv[1])
    if len(sys.argv) > 3:
        samples = samples[:int(sys.argv[3])]
    report(by_function(symbols, samples, buckets))
dwt75a.c — выборка PC самим ядром через DWT и ITM.
/* Раздел 75а, способ B: выборку PC ведёт само ядро. Блок DWT раз в заданное число тактов
 * выдаёт пакет с текущим PC, ITM ставит его в поток, поток уходит по линии SWO в отладчик.
 * Нужны Cortex-M3/M4/M7 и отладчик, принимающий SWO. Заголовки — CMSIS из пака устройства. */
#if defined(STM32F10X_MD)
#include "stm32f10x.h"
#else
#include "stm32f4xx.h"
#endif

#define PCS_TAP_64    0u                 /* шаг POSTCNT — бит 6 счётчика тактов: раз в 64 такта */
#define PCS_TAP_1024  1u                 /* бит 10: раз в 1024 такта */

void swo_init(void);                     /* раздел 21.2: TRACE_IOEN, TRCENA, ключ ITM, делитель SWO, ITMENA */

_Static_assert(DWT_CTRL_PCSAMPLENA_Msk == (1u << 12), "PCSAMPLENA - bit 12");
_Static_assert(DWT_CTRL_CYCTAP_Msk == (1u << 9), "CYCTAP - bit 9");
_Static_assert(DWT_CTRL_POSTINIT_Msk == (0xFu << 5), "POSTINIT - bits 8:5");
_Static_assert(DWT_CTRL_POSTPRESET_Msk == (0xFu << 1), "POSTPRESET - bits 4:1");
_Static_assert(DWT_CTRL_CYCEVTENA_Msk == (1u << 22), "CYCEVTENA - bit 22");
_Static_assert(DWT_CTRL_CYCCNTENA_Msk == 1u, "CYCCNTENA - bit 0");
_Static_assert(ITM_TCR_DWTENA_Msk == (1u << 3), "ITM TCR DWTENA - bit 3");

/* Включить периодическую выборку PC: tap — PCS_TAP_64 или PCS_TAP_1024, reload — 0…15. */
void pcs_start(uint32_t tap, uint32_t reload)
{
    swo_init();
    ITM->TCR |= ITM_TCR_DWTENA_Msk;      /* пропускать пакеты DWT в поток ITM */

    /* POSTINIT пишется, только пока POSTCNT выключен: сначала снять оба разрешения */
    DWT->CTRL &= ~(DWT_CTRL_PCSAMPLENA_Msk | DWT_CTRL_CYCEVTENA_Msk);
    DWT->CYCCNT = 0u;
    DWT->CTRL = (DWT->CTRL & ~(DWT_CTRL_CYCTAP_Msk | DWT_CTRL_POSTPRESET_Msk | DWT_CTRL_POSTINIT_Msk))
              | (tap << DWT_CTRL_CYCTAP_Pos)
              | (reload << DWT_CTRL_POSTPRESET_Pos)      /* с какого числа POSTCNT считает вниз */
              | (reload << DWT_CTRL_POSTINIT_Pos)        /* и с какого начинает */
              | DWT_CTRL_CYCCNTENA_Msk;                  /* POSTCNT шагает по биту CYCCNT: счётчик тактов должен идти */
    DWT->CTRL |= DWT_CTRL_PCSAMPLENA_Msk;                /* выборка пошла */
}

void pcs_stop(void)
{
    DWT->CTRL &= ~DWT_CTRL_PCSAMPLENA_Msk;
}
itm75a.py — разбор потока ITM/DWT с линии SWO.
#!/usr/bin/env python3
"""Раздел 75а, способ B: разбор потока ITM/DWT с линии SWO — достать пакеты выборки PC.

    python3 itm75a.py parse swo.bin [--sync] > dump.txt     адреса — строками «p …» для prof75a.py
    python3 itm75a.py gen   dump.txt swo.bin                синтетический поток из дампа способа A
    python3 itm75a.py test  dump.txt                        собрать поток, разобрать, сравнить

Формат пакетов — как его разбирает pyOCD (github.com/pyocd/pyOCD, pyocd/trace/swo.py)."""
import sys

SYNC = bytes([0, 0, 0, 0, 0, 0x80])


def parse(data, wait_sync=False):
    """Вернуть список событий (тип, значение, …). Типы: pc, sleep, itm, cnt, exc, dwt, sync, ovf, ts, bad."""
    i, out = 0, []
    if wait_sync:                               # подключились посреди потока: ждать синхропакет
        i = data.find(SYNC)
        i = len(data) if i < 0 else i
    while i < len(data):
        h = data[i]
        i += 1
        if h == 0x00:                           # синхропакет: нули и завершающий 0x80
            j = i
            while j < len(data) and data[j] == 0x00:
                j += 1
            if j < len(data) and data[j] == 0x80 and j - i >= 4:
                out.append(("sync",))
            else:
                out.append(("bad", h))
            i = j + 1
        elif h == 0x70:                         # переполнение: часть пакетов потеряна
            out.append(("ovf",))
        elif h & 0x03 == 0:                     # служебный пакет: метка времени или расширение
            while h & 0x80 and i < len(data):   # бит 7 — «дальше ещё байт»
                h = data[i]
                i += 1
            out.append(("ts",))
        else:                                   # пакет источника: 1, 2 или 4 байта данных
            size = 1 << ((h & 0x03) - 1)
            if i + size > len(data):
                break                           # хвост потока оборван посреди пакета
            value = int.from_bytes(data[i:i + size], "little")
            i += size
            src = h >> 3
            if h & 0x04 == 0:
                out.append(("itm", src, value, size))       # запись программы в канал src
            elif src == 2:                                  # периодическая выборка PC
                out.append(("pc", value) if size == 4 else ("sleep", value))
            elif src == 0:
                out.append(("cnt", value))                  # переполнение счётчика событий DWT
            elif src == 1:
                out.append(("exc", value))                  # вход в исключение и выход
            else:
                out.append(("dwt", src, value))             # трассировка данных
    return out


def pc_packet(pc):
    return bytes([0x17]) + pc.to_bytes(4, "little")         # 0x17 = источник 2, железный, 4 байта


def synth(pcs):
    """Поток, какой дала бы линия SWO: выборки PC вперемешку с остальными видами пакетов."""
    s = bytearray(SYNC)
    for k, pc in enumerate(pcs):
        s += pc_packet(pc)
        if k % 7 == 3:
            s += bytes([0x01, 0x48 + k % 20])               # канал 0, один байт (printf раздела 21)
        if k % 50 == 10:
            s += bytes([0x0B]) + (k * 977).to_bytes(4, "little")    # канал 1, слово (замер из 21.9)
        if k % 64 == 20:
            s += bytes([0x15, 0x00])                        # выборка во сне: PC нет
        if k % 100 == 30:
            s += bytes([0xC0, 0x85, 0x12])                  # метка времени с двумя байтами продолжения
        if k % 100 == 60:
            s += bytes([0x0E, 0x0F, 0x10])                  # трассировка исключений: вход в SysTick (15)
        if k % 500 == 250:
            s += bytes([0x05, 0x04])                        # переполнение счётчика событий
        if k % 1000 == 500:
            s += bytes([0x70])                              # переполнение
        if k % 1000 == 999:
            s += SYNC
    s += bytes([0x20])                                      # короткая метка времени — последним пакетом
    return bytes(s)


def read_pcs(path):
    pcs = []
    for line in open(path, encoding="ascii", errors="replace"):
        if line.startswith("p "):
            pcs += [int(x, 16) for x in line.split()[1:]]
    return pcs


def dump(events):
    pcs = [e[1] for e in events if e[0] == "pc"]
    print("prof raw n=%d" % len(pcs))
    for k in range(0, len(pcs), 8):
        print("p " + " ".join("%08x" % pc for pc in pcs[k:k + 8]))
    print("end")


def count(events):
    kinds = ("pc", "sleep", "itm", "cnt", "exc", "dwt", "sync", "ovf", "ts", "bad")
    return " ".join("%s=%d" % (k, sum(1 for e in events if e[0] == k)) for k in kinds)


if __name__ == "__main__":
    cmd = sys.argv[1]
    if cmd == "parse":
        dump(parse(open(sys.argv[2], "rb").read(), "--sync" in sys.argv))
    elif cmd == "gen":
        open(sys.argv[3], "wb").write(synth(read_pcs(sys.argv[2])))
    elif cmd == "test":
        src = read_pcs(sys.argv[2])
        stream = synth(src)
        ev = parse(stream)
        print("packet for pc 0x%08x: %s" % (src[0], pc_packet(src[0]).hex(" ")))
        print("stream %d bytes from %d samples: %s" % (len(stream), len(src), count(ev)))
        print("decoded = source: %s" % ("yes" if [e[1] for e in ev if e[0] == "pc"] == src else "NO"))
        cut = stream[5005:]                                 # приёмник включился посреди пакета
        blind, synced = parse(cut), parse(cut, wait_sync=True)
        tail = [e[1] for e in synced if e[0] == "pc"]
        print("cut at byte 5005: %s" % cut[:8].hex(" "))
        print("  no sync wait, first events: %s" % " ".join(str(e) for e in blind[:2]))
        print("  wait for sync: %s; tail of source: %s"
              % (count(synced), "yes" if tail and tail == src[len(src) - len(tail):] else "NO"))
Дальше: раздел 76 «Алгоритмы».