 Embedded HandbookПриложения
75. Оптимизация кода
Оптимизация — это превращение работающей программы в работающую программу получше: быстрее, меньше или экономнее. Ключевое слово — «работающей». Код, который ещё не отлажен, оптимизировать рано, а код, который и так укладывается во время, — незачем.
На микроконтроллере «получше» чаще значит «меньше»: Flash и ОЗУ кончаются раньше, чем время. Поэтому раздел начинается с уровней оптимизации компилятора — и с неожиданного результата, что «быстрый» уровень даёт код больше, чем отсутствие оптимизации. Потом — что компилятор делает сам, чем ему помочь, и почему всё это меркнет перед выбором алгоритма.
Как это называется в документации
Оригинал Перевод bottleneck, hot spot узкое место, горячая точка profiler, flat profile профилировщик, плоский профиль optimization level уровень оптимизации loop unrolling развёртка цикла strength reduction замена дорогой операции дешёвой inlining встраивание функции aliasing, restrictсовмещение указателей, обещание его отсутствия lookup table таблица значений code size, footprint размер кода premature optimization преждевременная оптимизация
75.1 Когда оптимизировать
Порядок один и тот же:
- Программа работает и проверена. Оптимизировать неработающий код — значит ускорять ошибку.
- Замер показал, что не укладываемся — во время, во Flash или в ОЗУ (раздел 73).
- Найдено узкое место. Почти всегда время уходит в малую часть кода, и угадывать её бесполезно — её измеряют.
- Сначала алгоритм, потом всё остальное (75.7).
- После каждого изменения — снова замер и снова проверка правильности.
Если код и так успевает, оптимизация — это потраченное время и усложнённый код, который потом кому-то читать.
75.2 Профилировщик
Профилировщик отвечает на вопрос, куда уходит время. На компьютере это,
например, gprof: программу собирают с ключом -pg, запускают, а
gprof показывает, сколько времени досталось каждой функции.
  %   cumulative   self              self     total
 time   seconds   seconds    calls  ms/call  ms/call  name
100.00      0.02     0.02        1    20.00    20.00  hot
  0.00      0.02     0.00        1     0.00     0.00  cold
Функция hot получила всё время, cold — ничего. Именно hot и стоит
оптимизировать, сколько бы строк ни было в cold.
На камне роль профилировщика играют счётчик тактов по участкам кода и статистика загрузки ОСРВ по задачам (раздел 35.3). Приём тот же: сначала понять, где время, потом что-то менять.
75.3 Уровни оптимизации компилятора
Один и тот же файл — суммирование массива, копирование, CRC-8,
сортировка пузырьком — собран armclang на шести уровнях:
| Уровень | Код, байт | Команд в функции суммирования |
|---|---|---|
-O0 |
352 | 26 |
-O1 |
188 | 10 |
-O2 |
780 | 44 |
-O3 |
784 | 44 |
-Os |
174 | 10 |
-Oz |
122 | 8 |
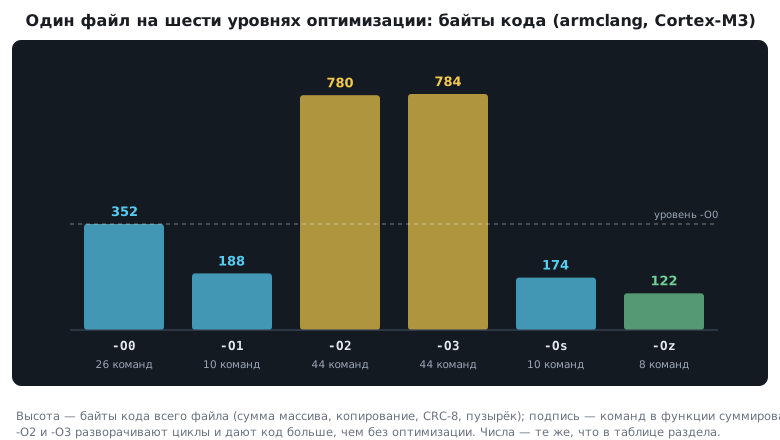
Главное открытие: -O2 дал код больше, чем -O0, и в 6,4 раза
больше, чем -Oz. Он разворачивает циклы — вместо одного сложения на
шаг делает четыре, чтобы реже проверять условие и переходить. На
компьютере с кэшем и гигабайтами это оправдано; на камне с 64 КБ Flash —
не всегда.
Что выбирать:
| Задача | Уровень |
|---|---|
| отладка | -O0; у GCC ещё -Og — оптимизации, которые не мешают отладчику. На -O1 часть переменных уже не видна (раздел 35) |
| прошивка, где главное — размер | -Os или -Oz |
| прошивка, где главное — скорость горячих мест | -O2, проверив, что влезает |
И проверка на всех уровнях, которые будут в работе: ошибка, которая есть
только при оптимизации, почти всегда — отсутствующий volatile
(раздел 3.4) или неопределённое поведение.
75.4 Что компилятор делает сам
Многие «ручные» приёмы оптимизации компилятор применяет без вас:
| Выражение | Что получилось на Cortex-M3 |
|---|---|
x * 8 |
сдвиг влево на 3 — одна команда |
x / 8, беззнаковое |
сдвиг вправо — одна команда |
x % 8, беззнаковое |
маска & 7 — одна команда |
x / 8, знаковое |
три команды |
x % 8, знаковое |
четыре команды |
a / b, переменные |
команда sdiv |
| то же на Cortex-M0 | вызов библиотечной __aeabi_idiv |
Выводы:
- писать
x >> 3вместоx / 8незачем — компилятор сделает то же, а код станет менее понятным; - знаковость важна: знаковое деление округляет к нулю (раздел 64.8), и для отрицательных нужна поправка. Если число не бывает отрицательным — объявите его беззнаковым, и деление станет одной командой;
- на Cortex-M0 (серия F0) деления нет в железе: каждое
a / b— вызов функции. В горячем цикле на F0 деление заменяют умножением на обратное число или сдвигом. На M3 и M4 деление на константу компилятор и так превращает в умножение (раздел 69.9), а на M0 ему не хватает умножения с 64-битным результатом, иx / 10там тоже становится вызовом__aeabi_uidiv. Выручает масштаб — степень двойки: тогда деление — это сдвиг.
Ещё из того, что уже встречалось в справочнике: цикл обнуления
становится вызовом библиотечного memclr (раздел 68.2), хвостовая
рекурсия — циклом (раздел 66.9), короткая static inline функция —
встроенным кодом (раздел 71.11).
75.5 Как помочь компилятору
restrict — обещание, что указатели не смотрят в одно место:
int f(int *p, int *q)                   { *p = 1; *q = 2; return *p; }
int g(int *restrict p, int *restrict q) { *p = 1; *q = 2; return *p; }
В первой функции компилятор обязан перечитать *p из памяти: вдруг
q указывает туда же, и запись двойки изменила *p. Во второй он сразу
возвращает единицу — чтения нет. Для функций обработки буферов, где
приёмник и источник заведомо разные, это заметная экономия. Но обещание
должно быть правдой: если указатели всё-таки совпадут, результат
непредсказуем.
Тип под размер регистра. Совет «берите самый маленький тип», верный
для 8-разрядных контроллеров, на ARM не работает. Регистры 32-разрядные,
и увеличение uint8_t на единицу — это сложение плюс лишняя команда
uxtb, чтобы обрезать результат до байта; для uint32_t — одно
сложение. В цикле компилятор часто прячет эту разницу, держа значение в
32 битах, но для локальных переменных и счётчиков естественный выбор на
Cortex-M — uint32_t или int. Маленькие типы нужны там, где их много:
в массивах и структурах, где они экономят ОЗУ.
static у функций файла позволяет компилятору встроить функцию или
выбросить её, если она не нужна. const у таблиц уносит их во Flash
(раздел 68.3). volatile — только там, где он нужен: каждое
обращение к volatile компилятор обязан выполнить буквально.
75.6 inline и ловушка компоновки
inline int foo(void) { return 2; }
int main(void) { return foo(); }
С оптимизацией эта программа собирается: вызов встроен. Без оптимизации
компоновщик останавливается — L6218E: Undefined symbol foo. По
правилам C слово inline без static даёт только встраиваемое
определение, а обычного тела функции для вызова не создаёт. Когда
компилятор без оптимизации решает не встраивать, вызывать оказывается
нечего.
Правильно — static inline: собирается на любом уровне. Именно так
пишут короткие функции в заголовках (раздел 71.11).
75.7 Алгоритм важнее всего
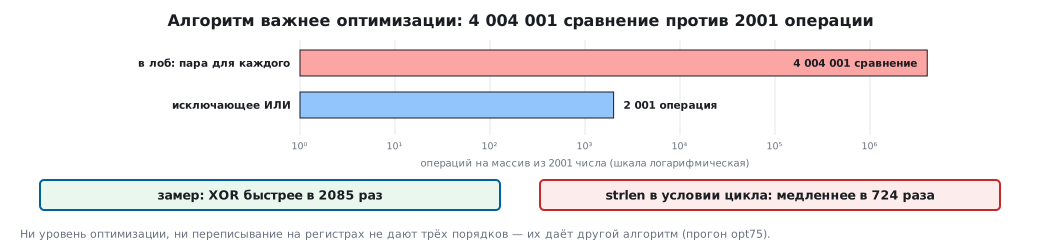
Задача: в массиве каждое число встречается дважды, и только одно — единожды. Найти его.
В лоб — для каждого элемента пройти весь массив и поискать пару:
for (int i = 0; i < n; i++) {
    int dup = 0;
    for (int j = 0; j < n; j++)
        if (i != j && a[i] == a[j]) dup = 1;
    if (!dup) same = a[i];
}
Через исключающее ИЛИ — одна строка: пары взаимно уничтожаются
(x ^ x = 0), остаётся непарное.
for (int i = 0; i < n; i++) same ^= a[i];
Для массива из 2001 элемента: 4 004 001 сравнение против 2001 операции — в 2001 раз меньше работы. Замер подтвердил: второй вариант быстрее на три порядка — примерно во столько же раз, во сколько меньше операций. Никакой уровень оптимизации и никакое переписывание первого варианта на регистрах такого не дадут.
Второй пример — strlen в условии цикла:
for (size_t i = 0; i < strlen(s); i++) ... /* strlen на каждом шаге */
Каждая проверка условия проходит всю строку, и цикл по строке из 20 000 символов делает около четырёхсот миллионов шагов вместо двадцати тысяч. Замер — медленнее в сотни раз. Длину вычисляют один раз до цикла.
Отсюда же знакомые приёмы: итерация вместо двойной рекурсии
(раздел 66.8), таблица вместо вычисления — на камне таблица в const
вообще не тратит ОЗУ, — обход двумерного массива по строкам
(раздел 68.7). Как оценивать алгоритмы заранее, без замера, —
раздел 76.
75.8 Оптимизация по памяти
На камне это часто важнее скорости:
- уровень
-Osили-Oz— см. таблицу в 75.3; - все неизменяемые таблицы —
const, чтобы они жили во Flash (раздел 68.3); - без
printf("%f")— это больше четырёх килобайт (раздел 74.4); - microlib вместо полной библиотеки, если её хватает (разделы 72.4 и 74.4);
- поля структур от больших к меньшим (раздел 70.2), маленькие типы в больших массивах;
- без кучи: память выделяется статически (раздел 72.4);
- для GCC —
-ffunction-sections -fdata-sectionsпри компиляции и-Wl,--gc-sectionsпри компоновке, иначе неиспользуемые функции остаются в прошивке (раздел 77.5): пример HAL с UART для F103 из пакета STM32Cube при-Osбез них занимает 16 536 байт Flash, с ними — 5 864; - оптимизация при компоновке:
-flto, уarmclang— вместе с ключом--ltoуarmlink. Компилятор видит всю программу сразу, встраивает функции между файлами и выбрасывает лишнее: тот же пример — 4 176 байт вместо 5 864, уarmclang— на треть меньше. Отлаживать такой код труднее, поэтому её включают в выпускной сборке и после этого проверяют всё заново.
75.9 Цена оптимизации
Оптимизированный код обычно менее понятен. Поэтому:
- комментируйте, зачем сделано так, — иначе следующий программист «исправит» странный код обратно;
- не применяйте приёмы везде подряд, только в найденном узком месте;
- сравнивайте цену: день работы ради сорока миллисекунд, которые никто не заметит, — плохая сделка. На камне бывает, что дешевле взять модель с большей Flash или частотой, чем неделю ужимать код.
И последнее: запись нескольких операторов в одну строку и удаление пробелов программу не ускоряют. Компилятору всё равно.
75.10 Грабли
Прошивка выросла после включения «быстрой» оптимизации. -O2
разворачивает циклы; для размера нужен -Os или -Oz.
Ускорили функцию, а программа быстрее не стала. Функция не была узким местом — сначала профиль.
Код ломается только с оптимизацией. Нет volatile или есть
неопределённое поведение.
x >> 3 вместо x / 8 «не ускорил». Компилятор и так делает сдвиг —
для беззнаковых.
Деление в цикле на F0 тормозит. У Cortex-M0 нет команды деления.
Перешли на uint8_t «для скорости» — стало медленнее. На ARM
маленькие типы требуют обрезки до байта.
С restrict функция выдаёт мусор. Указатели всё-таки совпали:
обещание оказалось ложным.
Без оптимизации не собирается: undefined symbol. inline без
static.
Цикл по строке тормозит. strlen в условии цикла.
Оптимизированный код «исправили» обратно. Не было комментария, зачем он такой.
75.11 Итоги
- Оптимизируют работающий код, после замера и только узкое место; профилировщик показывает, где время.
-O2разворачивает циклы: на одном наборе функций он дал 780 байт против 352 при-O0и 122 при-Oz. На камне для размера —-Osили-Oz.- Умножение и беззнаковое деление на степень двойки компилятор сам превращает в сдвиги; знаковое деление дороже; у Cortex-M0 нет команды деления.
restrictизбавляет от лишних чтений, если обещание правдиво.- На ARM естественный тип для локальных переменных — 32-разрядный;
uint8_tдобавляет обрезку. inlineбезstaticбез оптимизации даёт L6218E; пишутstatic inline.- Алгоритм решает больше всего: 4 004 001 сравнение против 2001 операции
XOR,
strlenв условии цикла — в сотни раз медленнее. - На камне оптимизация по памяти часто важнее, чем по скорости.
Дальше: раздел 75а «Профилировщик на самом камне: выборка счётчика команд по таймеру и через DWT» — где программа проводит время, без меток в коде.