 Embedded HandbookПриложения
76. Алгоритмы
В разделе 75 выяснилось, что выбор алгоритма даёт тысячи раз там, где переписывание кода даёт проценты. Здесь — как оценивать алгоритм до того, как его писать, и несколько приёмов, которые встречаются в программах для микроконтроллеров постоянно: двоичный поиск и поиск по таблице калибровки, быстрое возведение в степень, вычисления без переполнения, стек для разбора выражений, работа с битами.
Каждый ответ в разделе получен запуском программы и пересчитан независимо.
Как это называется в документации
Оригинал Перевод time, space complexity сложность по времени, по памяти big-O notation О-нотация worst, average case худший, средний случай binary search двоичный поиск lookup table, interpolation таблица, интерполяция exponentiation by squaring быстрое возведение в степень binomial coefficient биномиальный коэффициент reverse Polish notation обратная польская запись shunting-yard algorithm алгоритм сортировочной станции count leading zeros (CLZ) подсчёт ведущих нулей population count подсчёт единичных битов
76.1 Как оценивают алгоритм
Точное время работы зависит от процессора, компилятора и данных. Поэтому
алгоритмы сравнивают по тому, как растёт работа с ростом объёма
данных, — и записывают это О-нотацией, оставляя только главное
слагаемое. Алгоритм на 10n⁵ + 2n шагов — это O(n⁵).
Для тысячи элементов:
| Сложность | Шагов при n = 1000 | Пример |
|---|---|---|
| O(1) | 1 | элемент массива по индексу |
| O(log n) | около 10 | двоичный поиск |
| O(n) | 1000 | поиск максимума, линейный поиск |
| O(n log n) | около 10 000 | хорошая сортировка |
| O(n²) | 1 000 000 | пузырёк: в худшем случае 499 500 сравнений |
| O(2ⁿ) | число из 302 цифр | перебор всех подмножеств; рекурсивный Фибоначчи (раздел 66.8) растёт чуть медленнее — примерно как 1,618ⁿ |
Две оговорки для камня.
При малых n константы важнее порядка. Для десяти элементов пузырёк с его крошечным кодом может оказаться лучше «правильной» сортировки, которая тянет за собой заметно больше кода. Порядок начинает решать, когда данных сотни и тысячи.
Сложность по памяти важна не меньше, чем по времени. Алгоритм, которому нужен второй массив того же размера или глубокая рекурсия, на камне с 20 КБ ОЗУ может просто не поместиться (раздел 66.7).
76.2 Двоичный поиск
В упорядоченном массиве искомое находится делением пополам: сравнить с серединой и отбросить половину, где его заведомо нет.
int bsearch_int(const int *a, int n, int key)
{
    int lo = 0, hi = n - 1;
    while (lo <= hi) {
        int mid = lo + (hi - lo) / 2;
        if (a[mid] == key) return mid;
        if (a[mid] < key)  lo = mid + 1;
        else               hi = mid - 1;
    }
    return -1;                         /* нет */
}
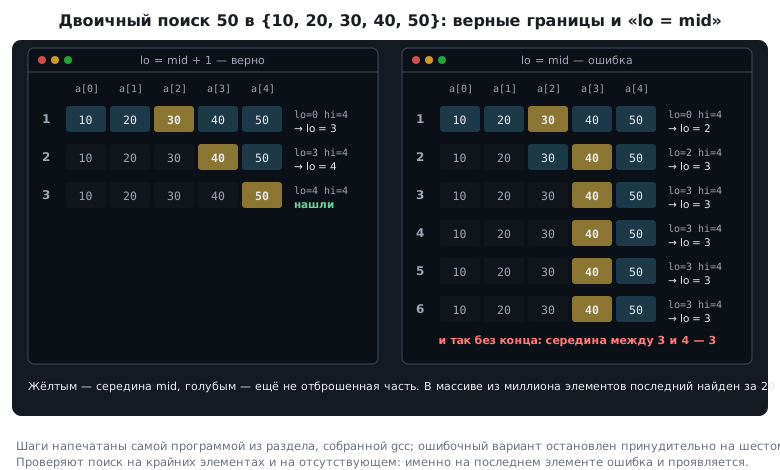
В массиве из миллиона элементов последний найден за 20 шагов, и столько же понадобилось, чтобы установить, что числа нет. Линейный поиск потратил бы до миллиона.
Классическая ошибка — границы без ±1: lo = mid и hi = mid вместо
lo = mid + 1 и hi = mid - 1. В массиве {10, 20, 30, 40, 50} такой
вариант находит 20 на втором шаге, но на поиске 50 — последнего элемента —
застревает навсегда: середина между 3 и 4 — это 3, граница сдвигается
на 3, и всё повторяется. Хватает и одной ошибки lo = mid: тогда
застревает уже поиск 20. Проверяют поиск всегда на крайних элементах и на
отсутствующем.
И тонкость: (lo + hi) / 2 на огромных массивах переполняется, а
lo + (hi - lo) / 2 — никогда. На камне массивы маленькие, но привычка
полезная. Готовая функция — bsearch из стандартной библиотеки
(раздел 74.7).
76.3 🔧 Таблица калибровки
Типичная задача на камне: характеристика датчика нелинейна и задана
таблицей точек. Таблицу кладут во Flash (const, раздел 68.3), нужный
отрезок находят двоичным поиском, а внутри отрезка — линейная
интерполяция в целых числах (раздел 69.9):
static const int16_t adc_tab[]  = { 400,  800, 1200, 1600, 2000, 2400, 2800, 3200, 3600};
static const int16_t temp_tab[] = {-400, -200,    0,  150,  300,  450,  600,  800, 1000}; /* 0,1 °C */

int16_t adc_to_temp(int adc)
{
    int lo = 0, hi = 8;
    if (adc <= adc_tab[lo]) return temp_tab[lo];      /* ниже таблицы */
    if (adc >= adc_tab[hi]) return temp_tab[hi];      /* выше таблицы */
    while (hi - lo > 1) {
        int mid = (lo + hi) / 2;
        if (adc_tab[mid] <= adc) lo = mid; else hi = mid;
    }
    return temp_tab[lo] + (temp_tab[hi] - temp_tab[lo]) * (adc - adc_tab[lo])
                        / (adc_tab[hi] - adc_tab[lo]);
}
Числа в таблице условные, но работа алгоритма проверена: код 1000 даёт −10,0 °C, 2000 — 30,0 °C, 3300 — 85,0 °C, а всё ниже таблицы ограничивается нижней точкой, −40,0 °C. Отрезок в таблице из девяти точек находится ровно за три шага, без единой операции с плавающей точкой.
76.4 Быстрое возведение в степень
aⁿ можно считать n умножениями, а можно — пользуясь тем, что
aⁿ = (aⁿ/²)² для чётного n и aⁿ = aⁿ⁻¹ · a для нечётного:
long binpow(long a, int n)
{
    if (n == 0) return 1;
    if (n & 1)  return binpow(a, n - 1) * a;
    long b = binpow(a, n >> 1);
    return b * b;
}
3¹³ = 1 594 323: 13 умножений в лоб, 6 быстрым способом. Для
степени 1000 — 15 умножений вместо тысячи. Число умножений — число
разрядов двоичной записи степени минус один плюс число единиц в ней:
вот почему алгоритм работает за O(log n).
Приём годится для любой операции, где порядок скобок не важен. Самое частое применение на камне — возведение в степень по модулю в криптографии (раздел 43).
76.5 Фибоначчи за логарифм
Числа Фибоначчи получаются возведением в степень матрицы
[[0, 1], [1, 1]] — а значит, тем же быстрым способом:
| Способ | Работы для F(n) |
|---|---|
| двойная рекурсия | O(2ⁿ) — 2 692 537 вызовов для n = 30 (раздел 66.8) |
| цикл | O(n) |
| степень матрицы | O(log n) |
Проверено: F(10) = 55, F(90) = 2 880 067 194 370 816 120 — последнее ещё помещается в 64 бита. Урок шире Фибоначчи: одна и та же задача решается за O(2ⁿ), O(n) и O(log n), и разница определяется идеей, а не кодом.
76.6 Биномиальные коэффициенты и переполнение
Число сочетаний C(n, k) — сколькими способами выбрать k предметов из n. По формуле через факториалы его считать нельзя: промежуточные значения огромны.
int cnk_naive(int n, int k)      /* 21 · 22 · … · 30, потом делить */
{
    int res = 1;
    for (int i = n - k + 1; i <= n; ++i) res *= i;
    for (int i = 2; i <= k; ++i)         res /= i;
    return res;
}
C(30, 10) так даёт −108 вместо 30 045 015: произведение 21 · … · 30
не помещается в int, и дальше делится уже мусор.
Правильно — умножать и делить по очереди:
long cnk(int n, int k)
{
    long res = 1;
    for (int i = 1; i <= k; ++i)
        res = res * (n - k + i) / i;       /* деление всегда нацело */
    return res;
}
После i-го шага в res лежит C(n − k + i, i) — целое число, и деление
на каждом шаге точное. Промежуточные значения остаются рядом с ответом.
Тип long даёт здесь запас только на компьютере с Linux, где пример и
проверялся: там он 64-битный. На Cortex-M long — те же 32 бита, что int
(раздел 64.3). Для C(30, 10) хватает и их: наибольшее промежуточное значение —
10 015 005 × 30 = 300 450 150, меньше 2³¹. А C(34, 17) = 2 333 606 220
не помещается в 32-битный знаковый даже ответом. На камне для запаса пишут
uint64_t — и у res, и у результата; с binpow из 76.4 та же история.
Третий способ — треугольник Паскаля, где каждое число — сумма двух над ним. В нём только сложения, и промежуточные значения никогда не превышают ответа. Строка 5: 1 5 10 10 5 1.
Пример из жизни камня: сколько байтов содержат ровно три единицы? C(8, 3) = 56 — и прямой перебор всех 256 байтов даёт те же 56.
76.7 Стек в деле: обратная польская запись
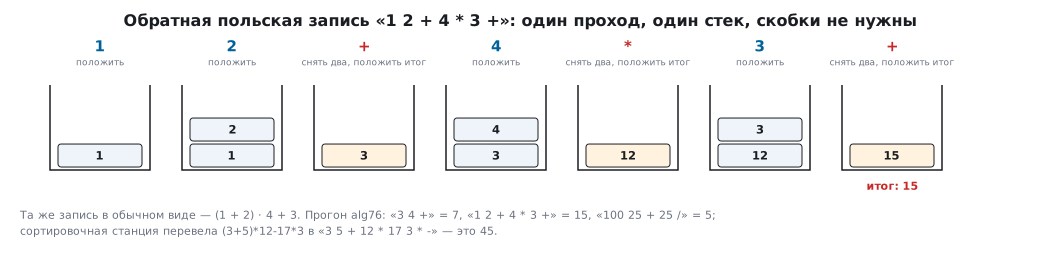
В обратной польской записи операция пишется после операндов:
1 2 + 4 * 3 + вместо (1 + 2) * 4 + 3. Скобки не нужны, а вычисляется
такая запись одним проходом со стеком (раздел 72.5): число — положить на
стек, операция — снять два числа, выполнить, положить результат.
| Запись | Результат |
|---|---|
3 4 + |
7 |
1 2 + 4 * 3 + |
15 |
100 25 + 25 / |
5 |
Обычную запись в польскую переводит алгоритм сортировочной станции:
числа сразу идут в выход; пришедшая операция сначала выталкивает со стека
в выход все операции с приоритетом не ниже своего и только потом ложится
на стек. «(» кладут на стек, «)» выталкивает всё до «(», в конце стек
выгружают в выход.
Проверено: (3+5)*12-17*3 → 3 5 + 12 * 17 3 * - → 45.
На камне это разбор команд и формул, пришедших по порту, и простые встроенные калькуляторы настроек.
76.8 Биты как алгоритм
Подсчёт нулей в двоичной записи. Сколько чисел от 1 до N имеют ровно K нулей? Перебор с разбором битов: для N = 8, K = 1 — 3 числа (10, 101 и 110 в двоичной), для 13 и 2 — 4, для 1000 и 5 — 210.
Логарифм по основанию 2 за одну команду. Номер старшего единичного
бита — это 31 − (число ведущих нулей). На Cortex-M3 и M4 для этого есть
команда clz, и __builtin_clz превращается ровно в неё. На Cortex-M0
такой команды нет, и то же вычисление — больше двух десятков команд.
Подсчёт единичных битов отдельной команды не имеет нигде: на M3
__builtin_popcount — дюжина команд.
Шифр исключающим ИЛИ — каждый байт текста складывается по модулю 2 с
байтом ключа, повторное применение того же ключа возвращает текст. Но с
ключом HASSWORD и текстом Hello world первый байт даёт H ^ H = 0, и
зашифрованная «строка» имеет длину ноль. Зашифрованное — это двоичные
данные, а не строка: хранят их вместе с длиной (раздел 68.8). И главное
— это не шифрование: ключ восстанавливается по нескольким байтам
известного текста. Настоящая защита данных — в разделе 43.
76.9 Выбор алгоритма на камне
- Худший случай важнее среднего. В устройстве с жёсткими сроками важно, сколько времени займёт самый неудачный вход: у двоичного поиска это log n, у пузырька — n².
- На месте, без второго массива. Память дороже времени.
- Без глубокой рекурсии, или с доказанной глубиной (раздел 66.7).
- Таблицы во Flash меняют память, которой много, на время, которого мало: синусы, калибровки, коэффициенты считают заранее.
- Целые вместо вещественных, если нет FPU (раздел 69.9).
- Простое, пока данных мало. Сложный алгоритм оправдан, когда замер (раздел 73) показал, что простой не успевает.
76.10 Грабли
Двоичный поиск зависает. Границы сдвигаются без ±1; проверять на последнем элементе и на отсутствующем.
Двоичный поиск возвращает не то. Массив не упорядочен.
Сочетания или факториалы дали отрицательное число. Переполнение промежуточного произведения.
Возведение в степень циклом тормозит. Быстрый способ — O(log n) умножений.
Интерполяция по таблице даёт скачки на краях. Не обработаны значения за пределами таблицы.
Разбор выражения ломается на скобках. Стек операций не ограничивается скобками.
Зашифрованная строка «обрезается». В результате появился нулевой байт; хранить с длиной.
__builtin_clz(0) ведёт себя непредсказуемо. Для нуля результат
встроенной функции не определён, и компилятор вправе считать, что ноль
не придёт. Ноль проверяют отдельно.
Логарифм «медленный» на F0. У Cortex-M0 нет команды clz.
Алгоритм хорош на компьютере и не влезает в камень. Не посчитана сложность по памяти.
76.11 Итоги
- Алгоритмы сравнивают по росту работы: при n = 1000 это 10 шагов для O(log n), тысяча для O(n) и миллион для O(n²).
- Двоичный поиск в миллионе элементов — 20 шагов; границы обязательно сдвигать на ±1, иначе поиск последнего элемента зависает.
- Таблица калибровки во Flash, двоичный поиск отрезка и целочисленная интерполяция — стандартный способ линеаризовать датчик.
- Быстрое возведение в степень: 3¹³ — 6 умножений вместо 13, степень 1000 — 15.
- Фибоначчи решается за O(2ⁿ), O(n) и O(log n) — решает идея, а не код.
- C(30, 10) через произведение в
int— −108; умножать и делить по очереди — 30 045 015. - Стек вычисляет обратную польскую запись, сортировочная станция переводит в неё обычную.
clzдаёт логарифм за одну команду на M3 и M4, но не на M0.- XOR с ключом — не шифрование, и результат — двоичные данные, а не строка.
Дальше: раздел 77 «Компиляция и компиляторы».