 Embedded HandbookПриложения
119а. Оптимизация модели для микроконтроллера: прунинг, кластеризация весов, дистилляция, выбор разрядности — размер, скорость и качество в реальной среде
В разделе 119 сеть сжата квантованием: те же веса, но в int8. Это одна ступень из нескольких. Модель можно уменьшить и по-другому: обнулить слабые веса (прунинг), убрать целые нейроны, заменить веса номерами из короткой таблицы (кластеризация), выучить маленькую сеть на ответах большой (дистилляция) или просто взять сеть уже. Здесь все способы проведены на одной задаче и измерены одинаково: верные ответы на отложенных записях, байты во флеш-памяти, команды на ответ в QEMU и энергия на ответ по даташиту F407. В конце — что бывает с моделью в поле: другой датчик, шум, порог уверенности и за чем следить на приборе.
Опоры: numpy 2.3.3 и scikit-learn 1.7.2 (только KMeans) в образе
stm-ml:1, скрипт train119b.py. Пакета tensorflow_model_optimization
в образах нет — маски прунинга, общие веса кластеров и мягкие ответы
учителя написаны в самом скрипте; повторный прогон даёт те же файлы.
Вывод на C (infer119b.c) собран gcc 12.2.0 (stm-sys:1) для сверки,
armclang 6.24 — размеры, arm-none-eabi-gcc 12.2.1 и QEMU 7.2
(stm-arm:1, платы netduinoplus2 со STM32F405 и mps2-an500
с Cortex-M7) — счёт команд. Ток — даташит DS8626 ред. 9 из пака Keil.
Квантование подробно — раздел 119, обучение — 118, признаки — 117.
Как это называется в документации
Оригинал Перевод pruning прунинг: обнуление части весов magnitude pruning прунинг по величине: обнулить самые малые по модулю unstructured / structured pruning неструктурный — отдельные веса; структурный — целые нейроны или каналы sparsity разреженность: доля нулей gradual pruning, pruning schedule постепенный прунинг по расписанию fine-tuning дообучение sparse format, CSR (compressed sparse row) разреженный формат: ненулевые значения и номера их входов weight clustering, weight sharing кластеризация весов: много весов — одно общее значение codebook, centroid таблица центров, центр кластера knowledge distillation дистилляция знаний teacher, student учитель, ученик soft targets, temperature мягкие ответы, температура half precision (float16) половинная точность: 2 байта на число latency, energy per inference задержка, энергия на ответ distribution shift, sensor drift сдвиг данных, дрейф датчика confidence threshold порог уверенности: ниже него ответ «не уверен»
119а.1 Задача, мера и разброс
Аналоговый акселерометр на корпусе мотора, АЦП STM32 — 12 бит на ±4 g, 1024 Гц, окно 256 отсчётов (250 мс). Признаки — 64 бина спектра с окном Ханна, от 4 до 256 Гц, в дБ относительно 1 g:
    q = np.clip(np.round(x / 8.0 * 4096 + 2048), 0, 4095)
    x = (q - 2048) * 8.0 / 4096
    x = x - x.mean(axis=1, keepdims=True)
    m = np.abs(np.fft.rfft(x * hann, axis=1))[:, 1:NB + 1] * (2.0 / N)
    return (20 * np.log10(m + 1e-4)).astype(np.float32)
Четыре класса: норма, дисбаланс (растёт гармоника частоты вращения около 25 Гц), перекос валов (растут вторая и третья гармоники) и подшипник (несущая 120…200 Гц, модулированная вращением). Шум датчика — 0,01 g, у каждой записи своё крепление ±10 %. Всего 160 записей по 10 окон; записи делятся целиком (раздел 118): обучение — 96 записей и 960 окон, подбор — 32 и 320, проверка — 32 и 320.
Рабочая сеть — 64 → 32 → 4 во float32, 2212 параметров: верно 278 из 320 окон проверки. Учитель — 64 → 128 → 64 → 4, 16 836 параметров: 283.
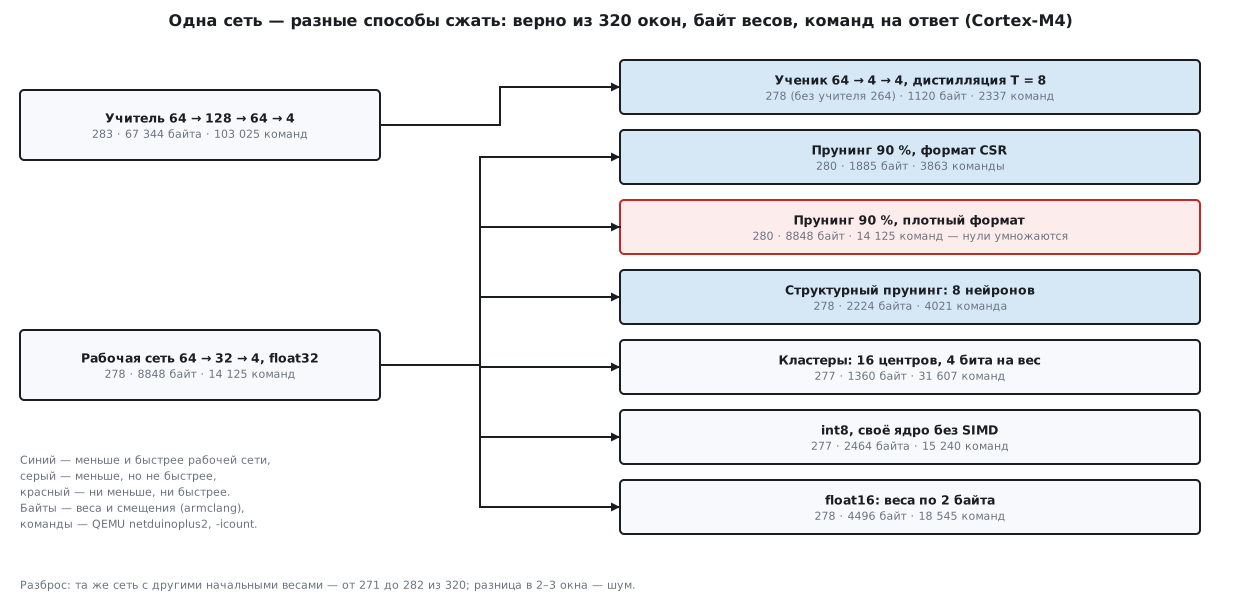
Прежде чем сравнивать, надо знать шум измерения. Та же сеть, обученная с пятью другими начальными весами, дала на проверке от 271 до 282. Вторая проверка — ещё 32 новые записи из того же генератора — у рабочей сети 301 из 320. Значит, разница в несколько окон — не выигрыш, а случай; выбирать вариант надо по подборочной выборке, а проверку трогать один раз.
119а.2 Прунинг по величине: нули без скорости
Неструктурный прунинг обнуляет долю самых малых по модулю весов слоя. Прорежен скрытый слой — 2048 весов; выходной слой (128 весов) оставлен целым:
    k = int(round(sparsity * W.size))
    thr = np.sort(np.abs(W).ravel())[k - 1]
    return (np.abs(W) > thr).astype(W.dtype)
Три способа. Разовый — обнулить и сразу считать. Разовый с дообучением — 40 эпох, градиент нулевых весов маской гасится. Постепенный — те же 40 эпох, но доля нулей растёт по кубическому расписанию за первые 30:
sched = lambda ep, sp=sp: sp * (1 - (1 - min(ep, 30) / 30.0) ** 3)
Верно из 320, подбор / проверка:
| Нулей в скрытом слое | разовый | разовый + дообучение | постепенный |
|---|---|---|---|
| 50 % (1024) | 268 / 275 | 269 / 281 | 269 / 278 |
| 75 % (1536) | 263 / 278 | 265 / 279 | 272 / 280 |
| 90 % (1843) | 241 / 250 | 267 / 277 | 271 / 280 |
| 95 % (1946) | 227 / 233 | 258 / 276 | 273 / 286 |
Без дообучения 90 % нулей стоят 28 окон проверки, 95 % — 45. Дообучение возвращает потерю, постепенный прунинг на подборе лучше разового при 75, 90 и 95 %: сеть успевает перераспределить вес на оставшиеся связи.
Почему нули не ускоряют. Плотное ядро перемножает все веса подряд, нули тоже. В QEMU сеть с 90 % нулей в плотном формате — те же 14 125 команд на ответ, что и без нулей. Чтобы пропускать нули, нужен разреженный формат: ненулевые значения строки и байт с номером входа у каждого.
        for (int k = L->rowp[j]; k < L->rowp[j + 1]; k++)
            s += v[k] * x[L->col[k]];
| Формат, нулей | Флеш, байт | Умножений | Команд на ответ, M4 |
|---|---|---|---|
| плотный, 0 % | 8848 | 2176 | 14 125 |
| плотный, 90 % | 8848 | 2176 | 14 125 |
| CSR, 50 % | 5980 | 1152 | 10 419 |
| CSR, 75 % | 3420 | 640 | 6323 |
| CSR, 90 % | 1885 | 333 | 3863 |
Номер входа — лишняя загрузка на каждое умножение: в CSR на один ненулевой вес уходит 11,6 команды против 6,5 в плотном цикле. Здесь формат окупается уже с половины нулей, но не вдвое: 50 % нулей сократили команды на 26 %, а не на 50.
119а.3 Структурный прунинг и кластеризация весов
Структурный прунинг убирает нейрон целиком — строку весов скрытого слоя и столбец выходного. Важность нейрона — произведение норм входящих и исходящих весов:
imp = np.linalg.norm(BASE[0][0], axis=1) * np.linalg.norm(BASE[1][0], axis=0)
| Оставлено нейронов | сразу | после 40 эпох дообучения | сеть такой ширины с нуля |
|---|---|---|---|
| 16 из 32 | 237 / 259 | 266 / 280 | 268 / 278 |
| 8 из 32 | 189 / 209 | 272 / 278 | 271 / 277 |
| 4 из 32 | 137 / 144 | 262 / 273 | 256 / 264 |
Подбор / проверка, верно из 320. Срезанная до 8 нейронов сеть сразу теряет 69 окон, после дообучения — ни одного; это просто сеть 64 → 8 → 4: 544 умножения вместо 2176, 4021 команда вместо 14 125, 2224 байта. Обычное ядро, никакого особого формата. При 4 нейронах дообученная срезанная сеть оказалась лучше обученной с нуля — 273 против 264: большая сеть дала ей хорошее начало.
Кластеризация заменяет веса слоя k общими значениями: k-средних по самим весам, в памяти — номер кластера у каждого веса и таблица центров.
km = KMeans(n_clusters=k - (1 if keep_zero else 0), n_init=10, random_state=SEED).fit(v[nz].reshape(-1, 1))
| Центров на слой | Бит на вес | сразу | после дообучения центров |
|---|---|---|---|
| 4 | 2 | 279 / 281 | 267 / 278 |
| 8 | 3 | 270 / 280 | 267 / 277 |
| 16 | 4 | 272 / 278 | 269 / 277 |
Дообучение центров (градиент центра — сумма градиентов его весов) здесь ничего не добавило: сеть почти не заметила, что у неё осталось 4 разных веса на слой. На приборе вес достаётся из таблицы:
s += L->tab[(p[k >> 1] >> ((k & 1) * 4)) & 15] * x[i];
16 центров: 1360 байт против 8848 — в 6,5 раза меньше. Но 31 607 команд на ответ — в 2,2 раза медленнее плотного float: распаковка номера и чтение таблицы на каждом весе. Кластеры — ради флеш-памяти и передачи модели по радио, а не ради скорости. Вместе с постепенным прунингом 90 % (ноль — свой центр, он не дообучается) — 277 на проверке; в этом формате номер хранится у каждого веса, и нули места не экономят.
119а.4 Дистилляция знаний
Учитель — 283 из 320, ученик 64 → 4 → 4, обученный с нуля, — 264. Дистилляция учит ученика не только меткам, но и мягким ответам учителя: логиты обоих делят на температуру T, и ученик подтягивает свои вероятности к учительским. Потери — 0,3 обычной перекрёстной энтропии и 0,7 · T² · KL; градиент по логитам ученика:
                pt = softmax(teacher[bi], T)
                    d += alpha * T * (softmax(acts[-1], T) - pt)
| Температура | Подбор | Проверка |
|---|---|---|
| без учителя | 256 | 264 |
| T = 1 | 256 | 264 |
| T = 2 | 265 | 264 |
| T = 4 | 271 | 276 |
| T = 8 | 280 | 278 |
При T = 1 толку нет: учитель на своих обучающих окнах прав в 960 из 960, и средняя наибольшая вероятность — 0,9998; мягкий ответ совпал с меткой. При T = 8 она 0,7614 — учитель сообщает, какие классы похожи. По подбору выбрана T = 8. С пятью другими начальными весами ученик без учителя дал от 263 до 279 (в среднем 268,0), с учителем — от 274 до 279 (в среднем 275,4): выигрыш около 7 окон и меньше разброс.
Ученик — 2337 команд и 1120 байт, учитель — 103 025 команд и 67 344 байта: в 44 раза быстрее и в 60 раз меньше при 5 окнах разницы.
119а.5 Ширина и разрядность: сводная таблица
Сети 64 → H → 4 с нуля, верно из 320 (int8 — свой: масштаб на тензор для входа и скрытого слоя, на выход — для весов; подробно — раздел 119):
| Скрытый слой | Подбор, float32 | Проверка: float32 | float16 | int8 |
|---|---|---|---|---|
| 4 | 256 | 264 | 264 | 266 |
| 8 | 271 | 277 | 277 | 277 |
| 16 | 268 | 278 | 278 | 279 |
| 32 | 269 | 278 | 278 | 277 |
| 64 | 274 | 275 | 275 | 276 |
Цена ответа. Флеш — веса и смещения из объектного файла armclang (нормировка, 512 байт, у всех общая); команды — QEMU, на Cortex-M4F (netduinoplus2) и Cortex-M7 (mps2-an500); время и энергия — по командам на 168 МГц:
| Вариант | Флеш, байт | Умножений | Команд, M4 | Команд, M7 | мкс, не меньше | мкДж, не меньше |
|---|---|---|---|---|---|---|
| H = 8, float32 | 2224 | 544 | 4021 | 4021 | 23,9 | 3,2 |
| H = 8, float16 | 1136 | 544 | 5129 | 5131 | 30,5 | 4,0 |
| H = 8, int8 | 640 | 544 | 6030 | 4268 | 35,9 | 4,7 |
| H = 32, float32 | 8848 | 2176 | 14 125 | 14 125 | 84,1 | 11,1 |
| H = 32, float16 | 4496 | 2176 | 18 545 | 18 547 | 110,4 | 14,6 |
| H = 32, int8 | 2464 | 2176 | 15 240 | 12 897 | 90,7 | 12,0 |
| H = 64, float32 | 17 680 | 4352 | 27 597 | 27 597 | 164,3 | 21,7 |
| H = 64, float16 | 8976 | 4352 | 36 433 | 36 435 | 216,9 | 28,6 |
| H = 64, int8 | 4896 | 4352 | 27 518 | 24 403 | 163,8 | 21,6 |
ОЗУ — стек: model_run берёт 1088 байт на любой вариант float (два
буфера по 128 чисел, по самой широкой сети — учителю), i8_run —
184 байта на M4 и 176 на M7 (gcc, -fstack-usage).
Что видно. С 8 нейронов качество больше не растёт, а цена растёт
линейно. float16 дал те же ответы, что float32, во всех пяти ширинах
и вдвое меньше флеш-памяти, но на 31 % больше команд: каждый вес
переводится во float командой vcvtb. int8 — ±2 окна и в 3,6 раза
меньше флеш-памяти у H = 32, но на M4 он не быстрее float: округление
входа и скрытого слоя floorf на M4 — вызов библиотеки, на M7 —
команда vrintm (по дизассемблеру gcc), и int8 там на 9 % быстрее float.
Простой цикл умножает по одному числу за команду; SMLAD, два умножения
за команду, — в ядрах CMSIS-NN из раздела 119. Для команд float QEMU
не различает M4 и M7: это один и тот же код. Такты M7 с двойной выдачей
команд и кэшем QEMU не моделирует, они не измерены.
119а.6 В реальной среде: задержка, энергия, датчик, уверенность
Задержка. Время в таблице — команды, делённые на 168 МГц: тактов у M4 не меньше, чем команд, а при 168 МГц у флеш-памяти 5 тактов ожидания (DS8626, раздел 5.3.6). Окно приходит раз в 250 мс; даже учителю нужно не меньше 613,2 мкс.
Энергия. DS8626 ред. 9, таблица 20: 168 МГц, ART включён, вся периферия выключена — 40 мА типично при 25 °C и 3,3 В (с включённой периферией — 87 мА). Энергия на ответ — 3,3 В · 40 мА · время: рабочая сеть — не меньше 11,1 мкДж, CSR с 90 % нулей — 3,0, ученик — 1,8, учитель — 80,9. Это ядро в счёте; АЦП, датчик и сон между окнами — отдельная статья.
Другой датчик, дрейф, шум. Те же 32 проверочные записи, но датчик другой: чувствительность −20 % и +25 % (дрейф калибровки или другой экземпляр), шум втрое больше (хуже крепление, наводка) и смещение нуля 0,1 g. Верно из 320:
| Модель | Как есть | ×0,8 | ×1,25 | Шум ×3 | Смещение 0,1 g |
|---|---|---|---|---|---|
| Учитель | 283 | 272 | 267 | 181 | 281 |
| Рабочая 64 → 32 → 4 | 278 | 271 | 274 | 161 | 279 |
| Прунинг 90 %, постепенный | 280 | 282 | 271 | 156 | 282 |
| Прунинг 90 % + 16 центров | 277 | 277 | 272 | 158 | 280 |
| Структурный, 8 нейронов | 278 | 273 | 272 | 130 | 272 |
| Ученик 64 → 4 → 4 | 278 | 278 | 265 | 142 | 278 |
| 64 → 4 → 4 без учителя | 264 | 265 | 256 | 105 | 268 |
| Рабочая, обучена с разбросом датчика | 256 | 256 | 253 | 232 | 255 |
Чувствительность в дБ — сдвиг на 1,9 дБ, и сеть его почти не заметила. Смещение нуля убирает вычитание среднего. Шум ×3 — обвал у всех: пол спектра поднялся, слабые признаки перекоса и подшипника утонули. Прорежённые и кластеризованные варианты держатся как исходная сеть; маленькие сети падают сильнее. Обучение с разбросом датчика — 6 копий обучающих записей, чувствительность 0,7…1,4 и шум в 1…3 раза больше — подняло шум ×3 до 232, но стоило 22 окон на чистых данных.
Порог уверенности. Ответ «не уверен», если наибольшая вероятность softmax меньше порога. Порог выбран на подборе — наибольший из 0,5…0,95, при котором «не уверен» не больше 5 %: 0,7 (14 окон из 320).
        sum += expf(s[c] - mx);
    return 1.0f / sum >= TAU;
У рабочей сети на проверке «не уверен» — 11 окон, из 309 уверенных верны 275. При шуме ×3 «не уверен» всего 19, а из 301 уверенного ответа верны лишь 159. Сеть ошибается уверенно: доля «не уверен» сдвиг данных почти не видит.
Мониторинг в поле. Поэтому следят и за входом. Пол спектра — медиана 64 бинов в дБ; на обучении он не выше −57,7 дБ (медиана −61,6). При шуме ×3 выше этого порога все 320 окон, на чистых данных, при другой чувствительности и смещении — ни одного. На приборе обе доли — «не уверен» и «вход вне обучения» — копят за сутки и отправляют наверх: их рост — повод проверить крепление и откалибровать датчик, а не верить классу.
119а.7 Грабли
После прунинга точность упала на 28 окон. Обнулили без дообучения: 90 % нулей — 250 вместо 278. Дообучение с маской — 277, постепенный прунинг — 280.
Модель на 90 % из нулей считает так же долго. Плотное ядро умножает нули: 14 125 команд и с ними, и без них. Нужен разреженный формат: CSR — 3863 команды и 1885 байт.
Кластеризованная модель медленнее исходной. Распаковка 4-битного номера и таблица на каждом весе: 31 607 команд против 14 125. Кластеры экономят флеш-память, не время.
Дистилляция ничего не дала. T = 1: учитель на своих обучающих окнах уверен на 0,9998, мягкие ответы равны меткам. Температуру — 4…8, выбирать по подбору.
Ученик стал неуверенным. Температура только у учителя, логиты ученика не поделены: ученик учится отвечать размазанно. Верных столько же (278), но средняя наибольшая вероятность 0,896 вместо 0,969 и «не уверен» — 55 окон из 320 вместо 11. Делить на T оба логита и умножать градиент на T.
На проверке прунинг 95 % «лучше» исходной сети. 286 против 278 — но на второй проверке из новых записей 300 против 301. Разброс от начальных весов — 271…282, а две проверки различаются на 23 окна. Подбирать по подбору, проверку трогать один раз, спорное — на новых записях.
int8 на F407 не быстрее float. Своё целочисленное ядро без SIMD
и floorf из библиотеки: 15 240 команд против 14 125. Нужны ядра
CMSIS-NN с SMLAD (раздел 119).
В поле модель уверенно ошибается. Шум ×3: верно 159 из 301 уверенного ответа, «не уверен» — 19. Следить за входом: пол спектра выше обучающего во всех 320 окнах.
119а.8 Итоги
- Мерить на отложенных записях и знать шум: от начальных весов — 271…282 из 320, две проверки различаются на 23 окна.
- Неструктурный прунинг 90 % с дообучением качества не стоит (280), но скорость даёт только разреженный формат: CSR — 3863 команды и 1885 байт против 14 125 и 8848.
- Структурный прунинг до 8 нейронов — 278, 4021 команда, обычное ядро.
- Кластеры: 16 центров — 1360 байт (в 6,5 раза меньше), но 31 607 команд.
- Дистилляция с T = 8: ученик 64 → 4 → 4 — 278 вместо 264; при T = 1 — ничего, без температуры у ученика — 55 «не уверен» вместо 11.
- float16 — те же ответы, вдвое меньше флеш-памяти, +31 % команд; int8 — в 3,6 раза меньше, на M4 без SIMD не быстрее.
- Энергия по DS8626 (40 мА при 168 МГц): рабочая сеть — не меньше 11,1 мкДж, ученик — 1,8.
- Шум ×3 роняет все варианты (278 → 161), а «не уверен» почти не растёт; следить и за входом — пол спектра выше обучающего во всех 320 окнах.
- Все 24 варианта на C совпали с Python бит в бит — на компьютере, в QEMU на Cortex-M4F и на Cortex-M7.
Полные исходники
train119b.py — данные, обучение на numpy, прунинг, кластеризация, дистилляция, проверка в поле и выгрузка всех вариантов в model119b.h.
# -*- coding: utf-8 -*-
"""Раздел 119а: оптимизация модели для микроконтроллера — прунинг, кластеризация весов,
дистилляция, ширина сети и разрядность.

Запуск — в образе stm-ml:1:  python train119b.py <каталог_вывода>

Всё на numpy (и KMeans из scikit-learn): пакета tensorflow_model_optimization нет, маски
весов, общие веса кластеров и мягкие ответы учителя написаны здесь же. Данные — вибрация
мотора с аналогового акселерометра на АЦП STM32 (12 бит, ±4 g, 1024 Гц, окно 256 отсчётов),
признаки — 64 бина спектра в дБ (4…256 Гц). Четыре класса: норма, дисбаланс, перекос валов,
подшипник. Записи делятся на обучение, подбор и проверку целиком.

Выход: model119b.h (веса всех вариантов для infer119b.c, проверочные окна, контрольные суммы
логитов, которые обязан повторить C) и summary119b.txt (все числа раздела)."""
import os
import sys

os.environ["OPENBLAS_NUM_THREADS"] = "1"
os.environ["OMP_NUM_THREADS"] = "1"
import numpy as np
import sklearn
from sklearn.cluster import KMeans

OUT = sys.argv[1] if len(sys.argv) > 1 else "."
SEED = 1192
N, FS, NB, WPR = 256, 1024.0, 64, 10           # отсчётов в окне, Гц, бинов, окон на запись
REC_TR, REC_VA, REC_TE = 24, 8, 8              # записей на класс: обучение, подбор, проверка
t = np.arange(N) / FS
hann = 0.5 * (1 - np.cos(2 * np.pi * np.arange(N) / N))
lines = ["versions=%s,%s" % (np.__version__, sklearn.__version__)]
S = {}                                          # сводка: ключ → строка


def put(k, *v):
    S[k] = ",".join(str(x) for x in v)
    lines.append("%s=%s" % (k, S[k]))


# ══ 1. Данные ═════════════════════════════════════════════════════════════
drng = np.random.RandomState(SEED)


def recording(c):
    """Одна запись: чистая вибрация в g (без шума датчика) и шум отдельно — датчик применяется потом."""
    u = lambda lo, hi: drng.uniform(lo, hi)
    f1 = 25.0 + u(-1.5, 1.5)                    # частота вращения
    mount = u(0.9, 1.1)                         # крепление этого датчика на этом моторе
    a1 = 0.06 * u(0.5, 1.5)
    a2, a3, ab, fb = 0.01 * u(0.5, 1.5), 0.0, 0.0, 0.0
    if c == 1:                                  # дисбаланс: сильная 1×
        a1 = 0.15 * u(0.6, 1.4)
    elif c == 2:                                # перекос: растут 2× и 3×
        a2, a3 = 0.05 * u(0.4, 1.6), 0.02 * u(0.5, 1.5)
    elif c == 3:                                # подшипник: несущая 120…200 Гц, модулированная вращением
        ab, fb = 0.02 * u(0.3, 1.5), u(120.0, 200.0)
    sig_n = 0.01 * u(0.8, 1.2)
    X, Nz = [], []
    for _ in range(WPR):
        p = drng.uniform(0, 2 * np.pi, 4)
        k = drng.uniform(0.95, 1.05, 4)
        x = (k[0] * a1 * np.sin(2 * np.pi * f1 * t + p[0]) + k[1] * a2 * np.sin(4 * np.pi * f1 * t + p[1])
             + k[2] * a3 * np.sin(6 * np.pi * f1 * t + p[2])
             + k[3] * ab * (1 + 0.6 * np.cos(2 * np.pi * f1 * t)) * np.sin(2 * np.pi * fb * t + p[3]))
        X.append(mount * x)
        Nz.append(sig_n * drng.randn(N))
    return X, Nz


CLEAN, NOISE, y, g = [], [], [], []
for c in range(4):
    for r in range(REC_TR + REC_VA + REC_TE):
        X_, N_ = recording(c)
        CLEAN += X_
        NOISE += N_
        y += [c] * WPR
        g += [r] * WPR
for c in range(4):                              # вторая проверка: ещё по 8 новых записей на класс
    for r in range(REC_TE):
        X_, N_ = recording(c)
        CLEAN += X_
        NOISE += N_
        y += [c] * WPR
        g += [100 + r] * WPR
CLEAN, NOISE, y, g = np.array(CLEAN), np.array(NOISE), np.array(y), np.array(g)
mtr, mva = g < REC_TR, (g >= REC_TR) & (g < REC_TR + REC_VA)
mte, mte2 = (g >= REC_TR + REC_VA) & (g < 100), g >= 100


def sensor(gain=1.0, noise=1.0, offset=0.0):
    """Акселерометр + АЦП 12 бит на ±4 g → 64 бина спектра в дБ относительно 1 g."""
    x = gain * CLEAN + noise * NOISE + offset
    q = np.clip(np.round(x / 8.0 * 4096 + 2048), 0, 4095)
    x = (q - 2048) * 8.0 / 4096
    x = x - x.mean(axis=1, keepdims=True)
    m = np.abs(np.fft.rfft(x * hann, axis=1))[:, 1:NB + 1] * (2.0 / N)
    return (20 * np.log10(m + 1e-4)).astype(np.float32)


X = sensor()
put("windows", int((g < 100).sum()), int(mtr.sum()), int(mva.sum()), int(mte.sum()), int(mte2.sum()))
put("recordings", 4 * (REC_TR + REC_VA + REC_TE), 4 * REC_TR, 4 * REC_VA, 4 * REC_TE, 4 * REC_TE)
MU = X[mtr].mean(axis=0).astype(np.float32)
SD = X[mtr].std(axis=0).astype(np.float32)
norm = lambda A: ((A - MU) / SD).astype(np.float32)
Z = norm(X)
Y1 = np.eye(4)[y]

# ══ 2. Обучение: numpy, Adam, маски и общие веса ═══════════════════════════


def init(sizes, rng):
    return [[rng.randn(o, i) * np.sqrt(2.0 / i), np.zeros(o)] for i, o in zip(sizes[:-1], sizes[1:])]


def forward(P, A):
    acts = [A]
    for k, (W, b) in enumerate(P):
        A = A @ W.T + b
        if k < len(P) - 1:
            A = np.maximum(A, 0.0)
        acts.append(A)
    return acts


def softmax(Zl, T=1.0):
    e = np.exp((Zl - Zl.max(axis=1, keepdims=True)) / T)
    return e / e.sum(axis=1, keepdims=True)


def magnitude_mask(W, sparsity):
    """Маска прунинга по величине: обнулить долю sparsity самых малых по модулю весов слоя."""
    k = int(round(sparsity * W.size))
    if k == 0:
        return np.ones_like(W)
    thr = np.sort(np.abs(W).ravel())[k - 1]
    return (np.abs(W) > thr).astype(W.dtype)


def prune_masks(P, sparsity):
    """Прунинг скрытых слоёв; выходной слой (32 × 4 = 128 весов) не трогаем — в нём каждый вес на счету."""
    return [magnitude_mask(W, sparsity) if k < len(P) - 1 else np.ones_like(W) for k, (W, _) in enumerate(P)]


def train(P, idx, epochs, lr, seed, masks=None, schedule=None, teacher=None, T=1.0, alpha=0.0, bug=None,
          clusters=None, l2=1e-4):
    """Обучение (или дообучение) сети P на окнах idx. masks — нули прунинга; schedule(эпоха) → доля нулей
    для постепенного прунинга; teacher — логиты учителя на тех же окнах (дистилляция); clusters — для
    каждого слоя (номера кластеров, центры): учатся только центры."""
    rng = np.random.RandomState(seed)
    P = [[W.copy(), b.copy()] for W, b in P]
    m1 = [[np.zeros_like(W), np.zeros_like(b)] for W, b in P]
    m2 = [[np.zeros_like(W), np.zeros_like(b)] for W, b in P]
    if clusters is not None:
        C = [c.copy() for _, c, _ in clusters]
        cm1, cm2 = [np.zeros_like(c) for c in C], [np.zeros_like(c) for c in C]
    step = 0
    for ep in range(epochs):
        if schedule is not None:
            masks = prune_masks(P, schedule(ep))
            for k in range(len(P)):
                P[k][0] *= masks[k]
        order = rng.permutation(idx)
        for s0 in range(0, len(order), 32):
            bi = order[s0:s0 + 32]
            acts = forward(P, Z[bi])
            p = softmax(acts[-1])
            d = (p - Y1[bi]) * (1.0 - alpha)
            if teacher is not None:
                pt = softmax(teacher[bi], T)
                if bug == "student_T1":                       # ученик без температуры
                    d += alpha * (softmax(acts[-1]) - pt)
                elif bug == "no_T2":                          # забыт множитель T²
                    d += alpha * (softmax(acts[-1], T) - pt) / T
                else:                                         # T² · KL → градиент T · (ps − pt)
                    d += alpha * T * (softmax(acts[-1], T) - pt)
            d /= len(bi)
            step += 1
            grads = []
            for k in range(len(P) - 1, -1, -1):
                gW = d.T @ acts[k] + l2 * P[k][0]
                gb = d.sum(axis=0)
                grads.append((k, gW, gb))
                if k:
                    d = (d @ P[k][0]) * (acts[k] > 0)
            for k, gW, gb in grads:
                if masks is not None:
                    gW = gW * masks[k]
                if clusters is not None:                      # общий вес: градиент центра — сумма по кластеру
                    a = clusters[k][0]
                    gC = np.bincount(a.ravel(), weights=gW.ravel(), minlength=len(C[k]))
                    if clusters[k][2]:
                        gC[0] = 0.0                           # кластер «ноль» остаётся нулём
                    cm1[k] = 0.9 * cm1[k] + 0.1 * gC
                    cm2[k] = 0.999 * cm2[k] + 0.001 * gC * gC
                    C[k] -= lr * (cm1[k] / (1 - 0.9 ** step)) / (np.sqrt(cm2[k] / (1 - 0.999 ** step)) + 1e-8)
                    P[k][0] = C[k][a]
                    gW = None
                for j, gr in ((0, gW), (1, gb)):
                    if gr is None:
                        continue
                    m1[k][j] = 0.9 * m1[k][j] + 0.1 * gr
                    m2[k][j] = 0.999 * m2[k][j] + 0.001 * gr * gr
                    P[k][j] -= lr * (m1[k][j] / (1 - 0.9 ** step)) / (np.sqrt(m2[k][j] / (1 - 0.999 ** step)) + 1e-8)
                if masks is not None:
                    P[k][0] *= masks[k]
    return P


def acc(P, mask, Zs=None):
    Zs = Z if Zs is None else Zs
    return int((forward(P, Zs[mask])[-1].argmax(axis=1) == y[mask]).sum())


TR = np.where(mtr)[0]
EPOCHS, LR = 150, 0.003

# ══ 3. Ширина сети и учитель ═══════════════════════════════════════════════
WIDTHS = (4, 8, 16, 32, 64)
NETS = {}
for h in WIDTHS:
    NETS["w%d" % h] = train(init((NB, h, 4), np.random.RandomState(SEED + h)), TR, EPOCHS, LR, SEED + h)
    put("width_%d" % h, acc(NETS["w%d" % h], mva), acc(NETS["w%d" % h], mte))
REP = [acc(train(init((NB, 32, 4), np.random.RandomState(SEED + 500 + r)), TR, EPOCHS, LR, SEED + 500 + r), mte)
       for r in range(5)]
put("w32_seeds", *REP)
TEACH = train(init((NB, 128, 64, 4), np.random.RandomState(SEED + 128)), TR, EPOCHS, LR, SEED + 128)
put("teacher", acc(TEACH, mva), acc(TEACH, mte), sum(W.size + b.size for W, b in TEACH))
BASE = NETS["w32"]

# ══ 4. Прунинг по величине: разовый, разовый + дообучение, постепенный ═══════
FT = 40
SPARS = (0.5, 0.75, 0.9, 0.95)
PRUNED = {}
for sp in SPARS:
    mk = prune_masks(BASE, sp)
    once = [[W * m, b.copy()] for (W, b), m in zip(BASE, mk)]
    ft = train(once, TR, FT, 0.001, SEED + 7, masks=mk)
    sched = lambda ep, sp=sp: sp * (1 - (1 - min(ep, 30) / 30.0) ** 3)
    grad = train(BASE, TR, FT, 0.001, SEED + 7, schedule=sched)
    grad_mask = prune_masks(grad, sp)
    grad = [[W * m, b] for (W, b), m in zip(grad, grad_mask)]
    PRUNED[sp] = grad
    zeros = sum(int((W == 0).sum()) for W, _ in grad)
    put("prune_%d" % round(sp * 100), acc(once, mva), acc(once, mte), acc(ft, mva), acc(ft, mte),
        acc(grad, mva), acc(grad, mte), zeros)

# выбор по проверке: лучшая из 12 настроек прунинга по mte — и она же на новых записях mte2
cand = []
for sp in SPARS:
    v = [int(x) for x in S["prune_%d" % round(sp * 100)].split(",")]
    cand += [(v[1], v[0], sp, "once"), (v[3], v[2], sp, "ft"), (v[5], v[4], sp, "grad")]
bt = max(cand, key=lambda c: (c[0], c[1]))
bv = max(cand, key=lambda c: (c[1], c[0]))
put("pick_by_test", bt[3], round(bt[2] * 100), bt[0], acc(PRUNED[bt[2]], mte2) if bt[3] == "grad" else -1)
put("pick_by_val", bv[3], round(bv[2] * 100), bv[1], bv[0], acc(PRUNED[bv[2]], mte2) if bv[3] == "grad" else -1)
put("base_test2", acc(BASE, mte2))

# ══ 5. Структурный прунинг: целые нейроны скрытого слоя ════════════════════
imp = np.linalg.norm(BASE[0][0], axis=1) * np.linalg.norm(BASE[1][0], axis=0)
STRUCT = {}
for keep in (16, 8, 4):
    kk = np.sort(np.argsort(-imp)[:keep])
    cut = [[BASE[0][0][kk], BASE[0][1][kk]], [BASE[1][0][:, kk], BASE[1][1].copy()]]
    ft = train(cut, TR, FT, 0.001, SEED + 9)
    STRUCT[keep] = ft
    put("struct_%d" % keep, acc(cut, mva), acc(cut, mte), acc(ft, mva), acc(ft, mte))

# ══ 6. Кластеризация весов: k-средних, номера + таблица центров ═════════════


def cluster(P, k, keep_zero=False):
    out = []
    for n, (W, _) in enumerate(P):
        v = W.ravel()
        nz = v != 0 if keep_zero and n < len(P) - 1 else np.ones(v.size, bool)
        km = KMeans(n_clusters=k - (1 if keep_zero else 0), n_init=10, random_state=SEED).fit(v[nz].reshape(-1, 1))
        cen = np.sort(km.cluster_centers_.ravel())
        lab = np.zeros(v.size, np.int64)
        idx = np.abs(v[nz][:, None] - cen[None, :]).argmin(axis=1)
        if keep_zero:
            cen = np.concatenate([[0.0], cen])
            lab[nz] = idx + 1
        else:
            lab[:] = idx
        out.append((lab.reshape(W.shape), cen, keep_zero))
    return out


CLUST = {}
for k in (4, 8, 16):
    cl = cluster(BASE, k)
    raw = [[c[a], b] for (a, c, _), (_, b) in zip(cl, BASE)]
    ft = train(raw, TR, 20, 0.001, SEED + 11, clusters=cl)
    CLUST[k] = (ft, cl)
    put("cluster_%d" % k, acc(raw, mva), acc(raw, mte), acc(ft, mva), acc(ft, mte),
        sum(len(np.unique(W)) for W, _ in ft))
cl = cluster(PRUNED[0.9], 16, keep_zero=True)
raw = [[c[a], b] for (a, c, _), (_, b) in zip(cl, PRUNED[0.9])]
DEEP = train(raw, TR, 20, 0.001, SEED + 11, clusters=cl)
DEEP_CL = cl
put("deep", acc(raw, mva), acc(raw, mte), acc(DEEP, mva), acc(DEEP, mte), sum(int((W == 0).sum()) for W, _ in DEEP))

# ══ 7. Дистилляция: ученик 64 → 4 → 4 на мягких ответах учителя ═══════════
TL = forward(TEACH, Z)[-1]
SW = 4
st0 = init((NB, SW, 4), np.random.RandomState(SEED + SW))
put("teacher_train", acc(TEACH, mtr), int(mtr.sum()),
    *["%.4f" % float(softmax(TL[mtr], T_).max(axis=1).mean()) for T_ in (1.0, 2.0, 4.0, 8.0)])
DIST = {}
for name, T, bug in (("T1", 1.0, None), ("T2", 2.0, None), ("T4", 4.0, None), ("T8", 8.0, None),
                     ("T4_noT2", 4.0, "no_T2"), ("T4_studentT1", 4.0, "student_T1")):
    st = train(st0, TR, EPOCHS, LR, SEED + SW, teacher=TL, T=T, alpha=0.7, bug=bug)
    DIST[name] = st
    pm = softmax(forward(st, Z[mte])[-1]).max(axis=1)
    put("dist_%s" % name, acc(st, mva), acc(st, mte), "%.3f" % float(pm.mean()))
pm = softmax(forward(NETS["w%d" % SW], Z[mte])[-1]).max(axis=1)
put("dist_scratch", acc(NETS["w%d" % SW], mva), acc(NETS["w%d" % SW], mte), "%.3f" % float(pm.mean()))
names = ("T1", "T2", "T4", "T8")
best_val = max(names, key=lambda n: (int(S["dist_" + n].split(",")[0]), -names.index(n)))
best_test = max(names, key=lambda n: (int(S["dist_" + n].split(",")[1]), -names.index(n)))
put("dist_pick", best_val, best_test)
STUDENT = DIST[best_val]
Tb = float(best_val[1:])
sc, di = [], []
for r in range(5):                              # то же с пятью другими начальными весами
    s0 = init((NB, SW, 4), np.random.RandomState(SEED + 700 + r))
    sc.append(acc(train(s0, TR, EPOCHS, LR, SEED + 700 + r), mte))
    di.append(acc(train(s0, TR, EPOCHS, LR, SEED + 700 + r, teacher=TL, T=Tb, alpha=0.7), mte))
put("dist_seeds_scratch", *sc)
put("dist_seeds_teacher", *di)

# ══ 8. Устойчивость: другой датчик, дрейф, шум ═════════════════════════════
DRIFTS = (("clean", 1.0, 1.0, 0.0), ("gain08", 0.8, 1.0, 0.0), ("gain125", 1.25, 1.0, 0.0),
          ("noise3", 1.0, 3.0, 0.0), ("offset", 1.0, 1.0, 0.1))
ZD = {n: norm(sensor(gn, nz, of)) for n, gn, nz, of in DRIFTS}
# обучение с разбросом датчика: те же записи, усиление 0,7…1,4 и шум в 1…3 раза больше
arng = np.random.RandomState(SEED + 3)
gains = np.concatenate([[1.0], arng.uniform(0.7, 1.4, 5)])          # первая копия — сам датчик
noises = np.concatenate([[1.0], arng.uniform(1.0, 3.0, 5)])
ZA = np.concatenate([norm(sensor(gn, nz))[mtr] for gn, nz in zip(gains, noises)])
YA = np.concatenate([y[mtr]] * len(gains))
_Z, _Y1 = Z, Y1
Z, Y1 = ZA, np.eye(4)[YA]
AUG = train(init((NB, 32, 4), np.random.RandomState(SEED + 32)), np.arange(len(YA)), EPOCHS, LR, SEED + 32)
Z, Y1 = _Z, _Y1
ROBUST = (("teacher", TEACH), ("w32", BASE), ("prune90", PRUNED[0.9]), ("deep", DEEP), ("struct8", STRUCT[8]),
          ("student", STUDENT), ("w4", NETS["w4"]), ("aug", AUG))
for n, P in ROBUST:
    put("robust_%s" % n, *[acc(P, mte, ZD[d]) for d, *_ in DRIFTS])

# ══ 9. Порог уверенности и доля «не уверен» ═══════════════════════════════
pv = softmax(forward(BASE, Z[mva])[-1]).max(axis=1)
TAUS = (0.5, 0.6, 0.7, 0.8, 0.9, 0.95)
tau = max(tt for tt in TAUS if (pv < tt).mean() <= 0.05)
put("tau", tau, int((pv < tau).sum()), int(mva.sum()))
for n, P in (("w32", BASE), ("aug", AUG), ("student", STUDENT), ("studentT4", DIST["T4"]), ("studentT1", DIST["T4_studentT1"])):
    row = []
    for d, *_ in DRIFTS:
        lo = forward(P, ZD[d][mte])[-1]
        pm = softmax(lo).max(axis=1)
        sure = pm >= tau
        row += [int((~sure).sum()), int(((lo.argmax(axis=1) == y[mte]) & sure).sum()), int(sure.sum())]
    put("conf_%s" % n, *row)

# монитор входа: «пол» спектра — медиана 64 бинов, дБ; порог — наибольший на обучении
floor = lambda A: np.median(A, axis=1)
fl_thr = float(floor(X[mtr]).max())
put("floor_thr", "%.1f" % fl_thr, "%.1f" % float(np.median(floor(X[mtr]))))
put("floor_flag", *[int((floor(sensor(gn, nz, of)[mte]) > fl_thr).sum()) for _, gn, nz, of in DRIFTS])

# ══ 10. Варианты для C: float32, float16, int8, CSR, кластеры ══════════════
ZT = Z[mte]
f32 = np.float32


def seq_dense(Wd, b, A, relu):
    """Как на C: s = b; s += w·x по входам по порядку, каждое действие во float32."""
    s = np.tile(b.astype(f32), (A.shape[0], 1))
    for i in range(Wd.shape[1]):
        s = (s + (Wd[:, i][None, :] * A[:, i][:, None]).astype(f32)).astype(f32)
    return np.where(s > f32(0), s, f32(0)) if relu else s


def run_float(layers, A):
    for k, (Wd, b) in enumerate(layers):
        A = seq_dense(Wd.astype(f32), b.astype(f32), A, k < len(layers) - 1)
    return A


def quant_i8(P):
    """int8: вход и скрытый слой — свой масштаб на тензор (по обучению), веса — на каждый выход."""
    (W1, b1), (W2, b2) = P
    sx = f32(np.abs(Z[mtr]).max() / 127.0)
    h = np.maximum(Z[mtr] @ W1.T + b1, 0)
    sh = f32(h.max() / 127.0)
    sw1 = (np.abs(W1).max(axis=1) / 127.0).astype(f32)
    sw2 = (np.abs(W2).max(axis=1) / 127.0).astype(f32)
    q1 = np.round(W1 / sw1[:, None]).astype(np.int8)
    q2 = np.round(W2 / sw2[:, None]).astype(np.int8)
    bq1 = np.round(b1 / (sx * sw1)).astype(np.int32)
    bq2 = np.round(b2 / (sh * sw2)).astype(np.int32)
    m1 = (sx * sw1 / sh).astype(f32)
    m2 = (sh * sw2).astype(f32)
    return dict(sx=sx, q1=q1, bq1=bq1, m1=m1, q2=q2, bq2=bq2, m2=m2)


def run_i8(Q, A):
    xq = np.clip(np.floor((A / Q["sx"]).astype(f32) + f32(0.5)), -128, 127).astype(np.int64)
    a1 = xq @ Q["q1"].T.astype(np.int64) + Q["bq1"]
    hq = np.clip(np.floor((a1.astype(f32) * Q["m1"]).astype(f32) + f32(0.5)), 0, 127).astype(np.int64)
    a2 = hq @ Q["q2"].T.astype(np.int64) + Q["bq2"]
    return (a2.astype(f32) * Q["m2"]).astype(f32)


def fnv(L):
    h = 2166136261
    for v in np.ascontiguousarray(L, f32).view(np.uint32).ravel():
        h = ((h ^ int(v)) * 16777619) & 0xFFFFFFFF
    return h


VARIANTS = []                                   # (имя, вид, данные для C, логиты на проверке)
for h in WIDTHS:
    P = NETS["w%d" % h]
    VARIANTS.append(("f32_w%d" % h, "f32", P, run_float(P, ZT)))
    P16 = [[W.astype(np.float16), b] for W, b in P]
    VARIANTS.append(("f16_w%d" % h, "f16", P16, run_float([[W.astype(f32), b] for W, b in P16], ZT)))
    Q = quant_i8(P)
    VARIANTS.append(("i8_w%d" % h, "i8", Q, run_i8(Q, ZT)))
VARIANTS.append(("f32_teacher", "f32", TEACH, run_float(TEACH, ZT)))
VARIANTS.append(("f32_struct8", "f32", STRUCT[8], run_float(STRUCT[8], ZT)))
VARIANTS.append(("f32_student", "f32", STUDENT, run_float(STUDENT, ZT)))
VARIANTS.append(("f32_prune90", "f32", PRUNED[0.9], run_float(PRUNED[0.9], ZT)))
for sp in (0.5, 0.75, 0.9):
    VARIANTS.append(("csr_p%d" % round(sp * 100), "csr", PRUNED[sp], run_float(PRUNED[sp], ZT)))
VARIANTS.append(("cl4_k16", "cl4", (CLUST[16][0], CLUST[16][1]), run_float(CLUST[16][0], ZT)))
VARIANTS.append(("cl4_deep", "cl4", (DEEP, DEEP_CL), run_float(DEEP, ZT)))
for name, kind, P, L in VARIANTS:
    unsure = int((softmax(L.astype(np.float64)).max(axis=1) < tau).sum())
    put("var_%s" % name, int((L.argmax(axis=1) == y[mte]).sum()), "%08x" % fnv(L), unsure)


# ══ 11. Заголовок для C ═══════════════════════════════════════════════════
def c_float(v):
    s_ = "%.9g" % v
    return (s_ if any(ch in s_ for ch in ".en") else s_ + ".0") + "f"


def c_arr(name, a, typ):
    flat = np.asarray(a).ravel()
    if typ in ("float", "half"):                # сначала во float32 (half — уже float16): тогда текст точен
        body = ", ".join(c_float(float(v)) for v in flat.astype(np.float32))
    else:
        body = ", ".join(str(int(v)) for v in flat)
    return "static const %s %s[%d] = { %s };\n" % (typ, name, len(flat), body)


def cl4_pack(a):
    v = a.ravel()
    return (v[0::2] | (v[1::2] << 4)).astype(np.uint8)


h_ = ["/* Раздел 119а: все варианты модели — сгенерировано train119b.py, не править */\n",
      "#define N_IN %d\n#define N_OUT 4\n#define N_TEST %d\n#define TAU %s\n" % (NB, int(mte.sum()), c_float(tau)),
      c_arr("MU", MU, "float"), c_arr("SD", SD, "float")]
descr, i8d = [], []
for name, kind, P, L in VARIANTS:
    u = name.upper()
    if kind == "i8":
        Q = P
        h_ += [c_arr(u + "_Q1", Q["q1"], "int8_t"), c_arr(u + "_BQ1", Q["bq1"], "int32_t"), c_arr(u + "_M1", Q["m1"], "float"),
               c_arr(u + "_Q2", Q["q2"], "int8_t"), c_arr(u + "_BQ2", Q["bq2"], "int32_t"), c_arr(u + "_M2", Q["m2"], "float")]
        i8d.append("    { \"%s\", %d, %s, %s_Q1, %s_BQ1, %s_M1, %s_Q2, %s_BQ2, %s_M2, 0x%08xu },\n"
                   % (name, Q["q1"].shape[0], c_float(float(Q["sx"])), u, u, u, u, u, u, fnv(L)))
        continue
    lay = []
    if kind == "cl4":
        P, cl = P
    for k, (W, b) in enumerate(P):
        n_out, n_in = W.shape
        relu = int(k < len(P) - 1)
        tag = "%s_L%d" % (u, k + 1)
        h_.append(c_arr(tag + "_B", b, "float"))
        if kind == "f32":
            h_.append(c_arr(tag + "_W", W, "float"))
            lay.append("{ L_F32, %d, %d, %d, %s_W, %s_B, 0, 0, 0 }" % (relu, n_in, n_out, tag, tag))
        elif kind == "f16":
            h_.append(c_arr(tag + "_W", W, "half"))
            lay.append("{ L_F16, %d, %d, %d, %s_W, %s_B, 0, 0, 0 }" % (relu, n_in, n_out, tag, tag))
        elif kind == "csr":
            nz = W != 0
            rowp = np.concatenate([[0], np.cumsum(nz.sum(axis=1))])
            h_ += [c_arr(tag + "_V", W[nz], "float"), c_arr(tag + "_COL", np.where(nz)[1], "uint8_t"),
                   c_arr(tag + "_ROWP", rowp, "uint16_t")]
            lay.append("{ L_CSR, %d, %d, %d, %s_V, %s_B, %s_ROWP, %s_COL, 0 }" % (relu, n_in, n_out, tag, tag, tag, tag))
        else:
            a, cen, _ = cl[k]
            cen = np.array([W[a == c][0] if (a == c).any() else cen[c] for c in range(len(cen))])  # центры после дообучения
            h_ += [c_arr(tag + "_IDX", cl4_pack(a), "uint8_t"), c_arr(tag + "_TAB", cen, "float")]
            lay.append("{ L_CL4, %d, %d, %d, %s_IDX, %s_B, 0, 0, %s_TAB }" % (relu, n_in, n_out, tag, tag, tag))
    h_.append("static const layer_t %s_LAYERS[%d] = { %s };\n" % (u, len(lay), ", ".join(lay)))
    descr.append("    { \"%s\", %d, %s_LAYERS, 0x%08xu },\n" % (name, len(lay), u, fnv(L)))
h_.append("static const model_t MODELS[%d] = {\n%s};\n" % (len(descr), "".join(descr)))
h_.append("static const i8model_t I8MODELS[%d] = {\n%s};\n" % (len(i8d), "".join(i8d)))
h_.append("#ifdef ML_DATA\n" + c_arr("TEST_X", X[mte], "float") + c_arr("TEST_Y", y[mte], "uint8_t") + "#endif\n")
open(OUT + "/model119b.h", "w", encoding="utf-8", newline="\n").write("".join(h_))
open(OUT + "/summary119b.txt", "w", encoding="utf-8", newline="\n").write("\n".join(lines) + "\n")
print("\n".join(lines))
infer119b.c — вывод всех вариантов на C: float32, float16, CSR, кластеры и int8.
/* Раздел 119а: вывод всех вариантов сети на C — плотный float32, веса float16, прореженный CSR,
 * кластеры (4-битные номера + таблица центров) и int8. Веса — из model119b.h (выгрузил train119b.py).
 * Вход — 64 бина спектра вибрации в дБ, ответ — 4 логита: норма, дисбаланс, перекос, подшипник.
 * На компьютере (-DML_HOST) main считает каждый вариант на проверочных окнах и сверяет логиты
 * с Python по контрольной сумме бит в бит. Собирать с -ffp-contract=off: без слитного
 * умножения-сложения порядок округлений тот же, что в numpy. Проверка — _verify/ml119b_check.py. */
#include <math.h>
#include <stdint.h>
#include <string.h>

#if defined(__arm__)
typedef __fp16 half;                    /* хранение: 2 байта, счёт — во float */
#else
typedef _Float16 half;
#endif

enum { L_F32, L_F16, L_CSR, L_CL4 };

typedef struct {
    uint8_t kind, relu;
    uint16_t n_in, n_out;
    const void *w;                      /* веса: float, half, значения CSR или упакованные номера */
    const float *b;                     /* смещения */
    const uint16_t *rowp;               /* CSR: начало строки каждого выхода */
    const uint8_t *col;                 /* CSR: номер входа каждого ненулевого веса */
    const float *tab;                   /* кластеры: 16 центров слоя */
} layer_t;

typedef struct {
    const char *name;
    uint8_t n_layers;
    const layer_t *layers;
    uint32_t hash;                      /* контрольная сумма логитов Python на проверке */
} model_t;

typedef struct {
    const char *name;
    uint16_t n_hid;
    float sx;                           /* масштаб входа int8 */
    const int8_t *q1;
    const int32_t *bq1;
    const float *m1;                    /* пересчёт суммы в масштаб скрытого слоя */
    const int8_t *q2;
    const int32_t *bq2;
    const float *m2;                    /* пересчёт суммы в логиты */
    uint32_t hash;
} i8model_t;

#if defined(ML_HOST) && !defined(ML_DATA)
#define ML_DATA
#endif
#include "model119b.h"

#define MAX_W 128

/* Плотный слой: каждый вес умножается, нули тоже */
static void dense_f32(const layer_t *L, const float *x, float *y)
{
    const float *w = (const float *)L->w;
    for (int j = 0; j < L->n_out; j++) {
        float s = L->b[j];
        for (int i = 0; i < L->n_in; i++)
            s += w[j * L->n_in + i] * x[i];
        y[j] = L->relu && !(s > 0.0f) ? 0.0f : s;
    }
}

/* Веса float16: вдвое меньше флеш-памяти, перед умножением — VCVTB в float */
static void dense_f16(const layer_t *L, const float *x, float *y)
{
    const half *w = (const half *)L->w;
    for (int j = 0; j < L->n_out; j++) {
        float s = L->b[j];
        for (int i = 0; i < L->n_in; i++)
            s += (float)w[j * L->n_in + i] * x[i];
        y[j] = L->relu && !(s > 0.0f) ? 0.0f : s;
    }
}

/* Разреженный слой CSR: только ненулевые веса, к каждому — номер входа */
static void dense_csr(const layer_t *L, const float *x, float *y)
{
    const float *v = (const float *)L->w;
    for (int j = 0; j < L->n_out; j++) {
        float s = L->b[j];
        for (int k = L->rowp[j]; k < L->rowp[j + 1]; k++)
            s += v[k] * x[L->col[k]];
        y[j] = L->relu && !(s > 0.0f) ? 0.0f : s;
    }
}

/* Кластеры: вес = таблица[номер], номер — 4 бита, два номера в байте */
static void dense_cl4(const layer_t *L, const float *x, float *y)
{
    const uint8_t *p = (const uint8_t *)L->w;
    for (int j = 0; j < L->n_out; j++) {
        float s = L->b[j];
        for (int i = 0; i < L->n_in; i++) {
            int k = j * L->n_in + i;
            s += L->tab[(p[k >> 1] >> ((k & 1) * 4)) & 15] * x[i];
        }
        y[j] = L->relu && !(s > 0.0f) ? 0.0f : s;
    }
}

/* Модель с весами float, float16, CSR или кластерами: нормировка и слои по очереди */
void model_run(const model_t *m, const float *x, float *out)
{
    float a[MAX_W], b[MAX_W], *in = a, *o = b, *t;
    for (int i = 0; i < N_IN; i++)
        a[i] = (x[i] - MU[i]) / SD[i];
    for (int l = 0; l < m->n_layers; l++) {
        const layer_t *L = &m->layers[l];
        float *dst = l == m->n_layers - 1 ? out : o;
        switch (L->kind) {
        case L_F32: dense_f32(L, in, dst); break;
        case L_F16: dense_f16(L, in, dst); break;
        case L_CSR: dense_csr(L, in, dst); break;
        default: dense_cl4(L, in, dst); break;
        }
        t = in;
        in = o;
        o = t;
    }
}

/* int8: вход и скрытый слой — байты, суммы — int32, пересчёт масштаба — одно умножение во float */
void i8_run(const i8model_t *m, const float *x, float *out)
{
    int8_t q[N_IN], h[64];
    for (int i = 0; i < N_IN; i++) {
        float z = (x[i] - MU[i]) / SD[i];
        int v = (int)floorf(z / m->sx + 0.5f);
        q[i] = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
    }
    for (int j = 0; j < m->n_hid; j++) {
        int32_t acc = m->bq1[j];
        for (int i = 0; i < N_IN; i++)
            acc += m->q1[j * N_IN + i] * q[i];
        int v = (int)floorf((float)acc * m->m1[j] + 0.5f);
        h[j] = (int8_t)(v < 0 ? 0 : v > 127 ? 127 : v);  /* ReLU — нижняя граница 0 */
    }
    for (int c = 0; c < N_OUT; c++) {
        int32_t acc = m->bq2[c];
        for (int j = 0; j < m->n_hid; j++)
            acc += m->q2[c * m->n_hid + j] * h[j];
        out[c] = (float)acc * m->m2[c];
    }
}

/* Уверенность: наибольшая вероятность softmax не меньше TAU, иначе ответ «не уверен» */
int confident(const float s[N_OUT])
{
    float mx = s[0], sum = 0.0f;
    for (int c = 1; c < N_OUT; c++)
        mx = s[c] > mx ? s[c] : mx;
    for (int c = 0; c < N_OUT; c++)
        sum += expf(s[c] - mx);
    return 1.0f / sum >= TAU;
}

int argmax4(const float s[N_OUT])
{
    int k = 0;
    for (int c = 1; c < N_OUT; c++)
        if (s[c] > s[k])
            k = c;
    return k;
}

/* Контрольная сумма FNV-1a по битам логитов: совпала — значит, совпало каждое число */
uint32_t fnv_add(uint32_t h, const float s[N_OUT])
{
    for (int c = 0; c < N_OUT; c++) {
        uint32_t u;
        memcpy(&u, &s[c], 4);
        h = (h ^ u) * 16777619u;
    }
    return h;
}

/* Все варианты под одним номером — чтобы ни одна таблица весов не выпала при сборке */
int n_models(void)
{
    return (int)(sizeof MODELS / sizeof MODELS[0] + sizeof I8MODELS / sizeof I8MODELS[0]);
}

void run_any(int k, const float *x, float *out)
{
    int nf = (int)(sizeof MODELS / sizeof MODELS[0]);
    if (k < nf)
        model_run(&MODELS[k], x, out);
    else
        i8_run(&I8MODELS[k - nf], x, out);
}

#ifdef ML_HOST
#include <stdio.h>

int main(void)
{
    int nf = (int)(sizeof MODELS / sizeof MODELS[0]), same = 0;
    for (int k = 0; k < n_models(); k++) {
        uint32_t h = 2166136261u, want = k < nf ? MODELS[k].hash : I8MODELS[k - nf].hash;
        int right = 0, unsure = 0;
        for (int n = 0; n < N_TEST; n++) {
            float s[N_OUT];
            run_any(k, &TEST_X[N_IN * n], s);
            h = fnv_add(h, s);
            right += argmax4(s) == TEST_Y[n];
            unsure += !confident(s);
        }
        same += h == want;
        printf("%s=%d,%08x,%d\n", k < nf ? MODELS[k].name : I8MODELS[k - nf].name, right, h, unsure);
    }
    printf("host_hash_ok=%d,%d\n", same, n_models());
    return 0;
}
#endif
Дальше: раздел 119б «Модель на плате: TensorFlow Lite Micro изнутри — MicroInterpreter, резолвер операторов, тензорная арена, входной буфер и поток отсчётов» — модель уезжает в прошивку: массив во флеш-памяти, набор ядер, арена, вход int8, поток от DMA до окна, время по операторам и сборка TFLM без make.