 Embedded HandbookПриложения
119. Квантование в int8: CMSIS-NN и TensorFlow Lite Micro
Перцептрон из раздела 118 считал во float: 4 байта на вес и умножение с плавающей точкой на каждую связь. На F407 это терпимо, на F103 без FPU каждое умножение — вызов библиотеки. Квантование заменяет вещественные числа восьмибитными целыми: веса занимают вчетверо меньше, а умножать можно по два за такт командой SMLAD. Раздел квантует две модели настоящим конвертером TensorFlow Lite, считает их ядрами CMSIS-NN — теми же, что TensorFlow Lite Micro вызывает на Cortex-M, — и проверяет, что C повторяет эталонный интерпретатор бит в бит.
Обучение и конвертер работают в образе stm-tf:1 — tensorflow-cpu 2.21.0
и numpy 2.3.3, — CMSIS-NN 7.0.0 взят из пака Keil. Обучение — раздел 118,
признаки и спектр — раздел 117.
Как это называется в документации
Оригинал Перевод quantization квантование: вещественные числа → целые post-training quantization квантование уже обученной модели scale, zero point масштаб и нулевая точка affine (asymmetric) quantization квантование со сдвигом нуля symmetric quantization квантование без сдвига: нулевая точка 0 per-tensor / per-channel один масштаб на тензор / свой на каждый выход representative dataset представительная выборка для калибровки requantization пересчёт суммы int32 в масштаб выхода fixed-point multiplier, shift множитель Q31 и сдвиг saturation насыщение на краях диапазона flatbuffer (.tflite) файл модели TensorFlow Lite interpreter, op resolver интерпретатор и набор ядер reference kernels эталонные ядра, без ускорений multiply-accumulate (MAC) умножение с накоплением
119.1 Зачем целые числа
Три выигрыша. Память: вес int8 — 1 байт вместо 4. Скорость: у Cortex-M4 есть SIMD-команды над парами 16-битных чисел (SMLAD — два умножения с накоплением за такт), а int8 в них укладываются. Переносимость: целочисленная модель одинаково работает на F103 без FPU и на F407. Плата — точность: у числа всего 256 уровней, и где они стоят, решает калибровка.
119.2 Масштаб и нулевая точка
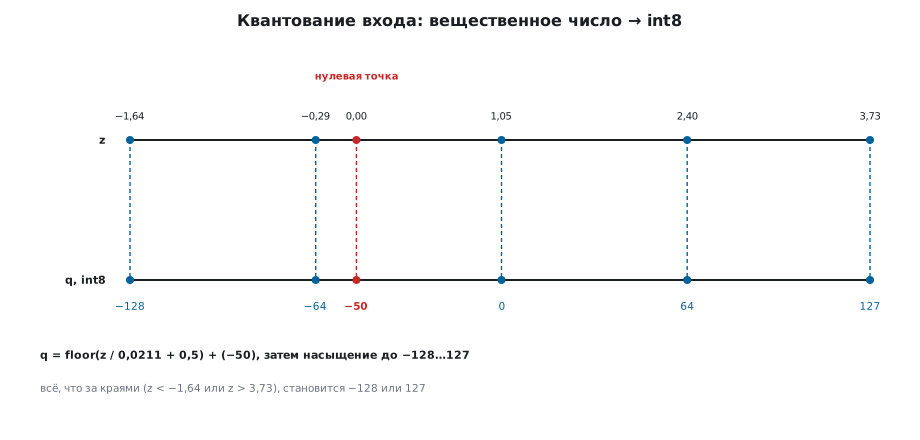
Вещественное число r хранится как целое q по правилу r = s · (q − z): s — масштаб, z — нулевая точка. Для входа модели A конвертер выбрал: масштаб 0,0211, нулевая точка −50; 256 уровней покрывают отрезок от −1,64 до 3,73 — столько занимали нормированные признаки в представительной выборке. Вещественный ноль ложится ровно на уровень −50: это важно, потому что нулём дополняют и с нулём сравнивает ReLU. Веса квантуются симметрично — нулевая точка 0, — чтобы в сумме произведений не было лишних слагаемых.
Вход на приборе квантуется той же формулой, что в Python:
float z = (x[i] - mu[i]) / sd[i];
int v = (int)floorf(z / s + 0.5f) + zp;
q[i] = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
119.3 Конвертер TensorFlow Lite
Модель учится в Keras во float, потом конвертер квантует её по представительной выборке — пропускает через модель несколько сотен обучающих окон и запоминает диапазон каждого тензора:
conv = tf.lite.TFLiteConverter.from_keras_model(model)
conv.optimizations = [tf.lite.Optimize.DEFAULT]
conv.representative_dataset = rep
conv.target_spec.supported_ops = [tf.lite.OpsSet.TFLITE_BUILTINS_INT8]
conv.inference_input_type = tf.int8
conv.inference_output_type = tf.int8
blob = conv.convert()
Строка TFLITE_BUILTINS_INT8 запрещает оставлять в модели операции
во float: если какую-то операцию квантовать нельзя, конвертер откажет,
а не соберёт смешанную модель. Входной и выходной тензоры — тоже int8:
квантование входа делает прибор, а на выходе достаточно номера
наибольшего числа.
119.4 Две модели: точность до и после
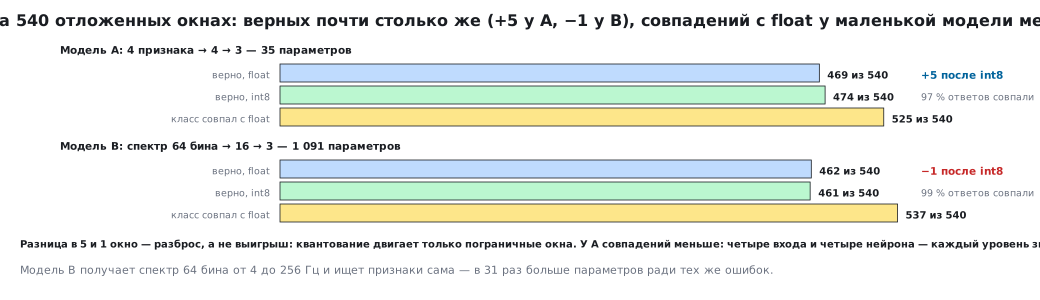
Модель A — четыре признака раздела 117; модель B получает сам спектр, 64 бина от 4 до 256 Гц, и признаки ищет сама. Обе проверены на 540 отложенных окнах — записях, которых не было в обучении:
| Модель | Параметров | Верно, float | Верно, int8 | Класс совпал |
|---|---|---|---|---|
| Модель A: 4 признака → 4 → 3 | 35 | 469 | 474 | 525 |
| Модель B: спектр 64 бина → 16 → 3 | 1091 | 462 | 461 | 537 |
Квантование сдвигает ответы в пограничных окнах, но общая доля верных почти не меняется: у A даже больше на 5, у B меньше на 1 — это разброс, а не выигрыш. У маленькой модели A совпадений с float меньше: четыре входа и четыре нейрона — каждый уровень квантования значит больше.
119.5 Представительная выборка
Если калибровать по данным, которые не похожи на рабочие, диапазоны выйдут неверными. Опыт: та же модель B, представительная выборка только из нормальных моторов. Входов за краем диапазона стало больше — насыщенных входов 330 вместо 221 из 34 560, — а верно 460 вместо 461. Здесь это почти не сказалось: насыщение задело меньше 1 % входов. Но правило общее: в представительную выборку идут все классы и все режимы работы, иначе редкий дефект с большой амплитудой упрётся в 127 и станет неотличим от просто сильного сигнала.
119.6 Масштаб на тензор или на выход
По умолчанию конвертер даёт каждому нейрону свой масштаб весов: у нейрона с малыми весами 256 уровней не пропадают на пустой диапазон соседа. Можно попросить один масштаб на весь тензор — файл меньше, ядро проще. Для модели B: один масштаб на тензор — 460 верных против 461, .tflite 2968 байт вместо 3376. На маленьких полносвязных сетях разница в точности — единицы окон; на свёрточных сетях с разными по силе фильтрами масштаб на выход заметно лучше, и CMSIS-NN умеет оба случая.
119.7 Слой в целых числах
Полносвязный слой в int8 — это сумма произведений в int32, смещение int32 и пересчёт суммы в масштаб выхода. Вещественный множитель s_вход · s_вес / s_выход заменяется целым Q31 и сдвигом — так же, как в TensorFlow Lite Micro:
q, shift = math.frexp(real)
qi = int(round(q * (1 << 31)))
if qi == (1 << 31):
    qi //= 2
    shift += 1
Последние три строки — для края: когда q у самой единицы, округление даёт
ровно 2^31, а это в int32 не помещается. Тогда множитель делят пополам,
а сдвиг увеличивают на один.
Слой на CMSIS-NN — одна функция, параметры квантования передаются структурами:
cmsis_nn_fc_params fp = { -za, 0, zo, { relu ? zo : -128, 127 } };
cmsis_nn_per_channel_quant_params qp = { (int32_t *)mult, (int32_t *)shift };   /* свой масштаб у каждого выхода */
arm_fully_connected_per_channel_s8(&ctx, &fp, &qp, &id, in, &fd, w, &bd, b, &od, out);
ReLU отдельно не считается: нижняя граница выхода равна нулевой точке, то есть вещественному нулю, — отрицательное просто не проходит. У модели B 1072 умножения с накоплением на ответ.
119.8 Бит в бит с интерпретатором
Эталон — интерпретатор TensorFlow Lite с эталонными ядрами. Первая сборка
CMSIS-NN с настройками по умолчанию: выходы совпали лишь 533 и 536 окон из
540 — в остальных число на выходе отличается на единицу. Верных ответов
столько же, но расхождение настоящее. Как округлять при пересчёте, задаёт
ключ сборки: настольный TensorFlow 2.21 округляет один раз, а CMSIS-NN
и TensorFlow Lite Micro по умолчанию — дважды (в TFLM это ключ
TFLITE_SINGLE_ROUNDING, и в паке 1.23.2 он не задан). С ключом
CMSIS_NN_USE_SINGLE_ROUNDING выходы int8 совпали бит в бит во всех
540 окнах у обеих моделей, и квантование входа на C совпало с Python
во всех 2160 и 34 560 числах.
Отсюда правило: ядра и эталон должны округлять одинаково. Ключ
CMSIS_NN_USE_SINGLE_ROUNDING нужен для сверки с настольным TensorFlow;
прибор, который сверяют с TFLM в режиме по умолчанию, оставляют с двойным
округлением. Проверять это надо сравнением выходов, а не долей верных
ответов — единица
в последнем разряде в пограничном окне меняет класс.
119.9 Память и код
Для модели B armclang дал: веса int8 — 1072 байта, смещения int32, множители Q31 и сдвиги — 228, нормировка во float — 512, всего 1812 байт. Та же модель во float — 4364 байта. Выигрыш в 2,4 раза, а не в 4: масштабы на каждый выход и нормировка тоже место занимают, и на маленьких моделях их доля велика. На моделях в десятки тысяч весов выигрыш приближается к четырём.
Код: ядро CMSIS-NN — 3564 байта на F407 и 2160 на F103. На F407 оно больше, потому что собрано с командами DSP: разворачивает циклы и считает по четыре выхода сразу. Где нет DSP, работает простая ветка на C — те же числа, медленнее.
119.10 Грабли
На плате ответы на единицу отличаются от Python. Разное округление
при пересчёте: настольный TensorFlow 2.21 округляет один раз, CMSIS-NN
и TFLM по умолчанию — дважды. Для сверки с настольным эталоном —
CMSIS_NN_USE_SINGLE_ROUNDING, с TFLM по умолчанию — режим по умолчанию;
сравнивать выходы, а не классы.
После квантования модель отвечает одним классом. Вход квантован
не тем масштабом или без нормировки. Масштаб и нулевая точка — из
входного тензора .tflite, нормировка — та же, что при обучении.
Сильный сигнал неотличим от очень сильного. Насыщение: калибровка не видела таких амплитуд. Все режимы и классы — в представительную выборку.
Конвертер оставил операции во float. Не задан
TFLITE_BUILTINS_INT8, модель собралась смешанной и на Cortex-M
потянет float-ядра. Запретить.
Модель в int8 почти не уменьшилась. Маленькая модель: масштабы на выход и нормировка сравнимы с весами. Для десятков весов квантование окупается скоростью на F103, а не памятью.
Интерпретатор на компьютере даёт другие числа. Ускоренные ядра (XNNPACK) считают иначе. Для сверки — эталонные ядра.
119.11 Итоги
- r = s · (q − z): масштаб и нулевая точка на тензор; веса симметричны.
- Конвертер TensorFlow Lite квантует по представительной выборке — в ней должны быть все классы и режимы.
- Точность почти не меняется: 469 → 474 у модели A, 462 → 461 у B.
- CMSIS-NN повторяет настольный TensorFlow 2.21 бит в бит только с одним округлением; по умолчанию CMSIS-NN и TFLM округляют дважды, и совпали лишь 533 и 536 окон из 540.
- Модель B: всего 1812 байт против 4364 во float; ядро CMSIS-NN — 3564 байта на F407.
Полные исходники
train119.py — квантование моделей в int8 конвертером TensorFlow Lite и выгрузка для CMSIS-NN.
# -*- coding: utf-8 -*-
"""Раздел 119: квантование в int8 — конвертер TensorFlow Lite и ядра CMSIS-NN.

Запуск — в образе stm-tf:1:  python train119.py <каталог_вывода>

Данные — генератор раздела 118 (записи моторов, калибровка крепления уже
сделана), зерно 119. Две модели:
  A — четыре признака раздела 117 → 4 нейрона → 3 класса;
  B — сам спектр: 64 бина (4…256 Гц) → 16 нейронов → 3 класса.
Каждая учится в Keras, затем конвертер TFLite квантует её в int8 по
представительной выборке. Из готового .tflite вынимаются целые веса,
сдвиги, масштабы и нулевые точки — они и уезжают в model119.h; интерпретатор
TFLite считает ответы int8 на отложенных окнах, и CMSIS-NN на C обязан
повторить их бит в бит. Опыт с плохой калибровкой: представительная выборка
только из нормальных моторов. Сводка — в summary119.txt."""
import math
import os
import sys

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "3"
os.environ["TF_ENABLE_ONEDNN_OPTS"] = "0"
import numpy as np
import tensorflow as tf
from sklearn.model_selection import train_test_split

OUT = sys.argv[1] if len(sys.argv) > 1 else "."
tf.keras.utils.set_random_seed(119)
tf.config.experimental.enable_op_determinism()
rng = np.random.RandomState(119)
N, FS, WPR, NB = 256, 1024.0, 20, 64
t = np.arange(N) / FS
hann = 0.5 * (1 - np.cos(2 * np.pi * np.arange(N) / N))


def window_features(x):
    y = x - x.mean()
    rms = np.sqrt((y ** 2).mean())
    crest = np.abs(y).max() / rms
    m = np.abs(np.fft.rfft(y * hann))[:N // 2]
    m[0] = 0
    k = int(m.argmax())
    a, b, c = m[k - 1], m[k], m[k + 1]
    peak = (k + 0.5 * (a - c) / (a - 2 * b + c)) * FS / N
    band = (m[25:63] ** 2).sum() / (m[1:] ** 2).sum()
    return [rms, peak, crest, band], list(m[1:NB + 1] * (2.0 / N))


def recording(c):
    f1 = 25.0 + rng.uniform(-1.5, 1.5)
    if c == 0:
        a1, a2 = 0.45 * rng.uniform(0.6, 1.4), 0.0
    elif c == 1:
        a1, a2 = 0.74 * rng.uniform(0.6, 1.4), 0.0
    else:
        a1, a2 = 0.35 * rng.uniform(0.6, 1.4), 0.45 * rng.uniform(0.08, 1.3)
    f2 = 160.0 + rng.uniform(-20, 20)
    F, S = [], []
    for _ in range(WPR):
        ph1, ph2 = rng.uniform(0, 2 * np.pi, 2)
        x = (1.65 + a1 * rng.uniform(0.95, 1.05) * np.sin(2 * np.pi * f1 * t + ph1)
             + a2 * rng.uniform(0.95, 1.05) * np.sin(2 * np.pi * f2 * t + ph2) + rng.uniform(-0.05, 0.05, N))
        f, s = window_features(x)
        F.append(f)
        S.append(s)
    return F, S


XF, XS, y, g = [], [], [], []
for c in range(3):
    for r in range(30):
        F, S = recording(c)
        XF += F
        XS += S
        y += [c] * WPR
        g += [c * 1000 + r] * WPR
XF, XS = np.array(XF, np.float32), np.array(XS, np.float32)
y, g = np.array(y), np.array(g)
recs = np.array(sorted(set(g)))
rtr, rte = train_test_split(recs, test_size=0.3, random_state=119, stratify=recs // 1000)
mtr, mte = np.isin(g, rtr), np.isin(g, rte)
lines = ["versions=%s,%s" % (tf.__version__, np.__version__), "test=%d" % int(mte.sum())]


def quantize_multiplier(real):
    """Как в TFLite Micro: множитель Q31 и сдвиг из вещественного масштаба."""
    if real == 0.0:
        return 0, 0
    q, shift = math.frexp(real)
    qi = int(round(q * (1 << 31)))
    if qi == (1 << 31):
        qi //= 2
        shift += 1
    return qi, shift


def train(X, hidden):
    mu, sd = X[mtr].mean(axis=0).astype(np.float32), X[mtr].std(axis=0).astype(np.float32)
    Z = ((X - mu) / sd).astype(np.float32)
    model = tf.keras.Sequential([tf.keras.Input((X.shape[1],)), tf.keras.layers.Dense(hidden, activation="relu"),
                                 tf.keras.layers.Dense(3)])
    model.compile(optimizer=tf.keras.optimizers.Adam(0.01),
                  loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True))
    model.fit(Z[mtr], y[mtr], epochs=150, batch_size=64, verbose=0, shuffle=True)
    return model, mu, sd, Z


def build(trained, rep_mask, per_channel=True):
    model, mu, sd, Z = trained
    fl = model.predict(Z[mte], verbose=0).argmax(axis=1)

    def rep():
        for row in Z[rep_mask][::3]:
            yield [row[None, :]]

    conv = tf.lite.TFLiteConverter.from_keras_model(model)
    conv.optimizations = [tf.lite.Optimize.DEFAULT]
    conv.representative_dataset = rep
    conv.target_spec.supported_ops = [tf.lite.OpsSet.TFLITE_BUILTINS_INT8]
    conv.inference_input_type = tf.int8
    conv.inference_output_type = tf.int8
    conv._experimental_disable_per_channel = not per_channel
    blob = conv.convert()
    # эталонные ядра — та же арифметика, что в TFLite Micro (не XNNPACK)
    it = tf.lite.Interpreter(model_content=blob,
                             experimental_op_resolver_type=tf.lite.experimental.OpResolverType.BUILTIN_REF)
    it.allocate_tensors()
    din, dout = it.get_input_details()[0], it.get_output_details()[0]
    s_in, zp_in = din["quantization"]
    # вход квантуется так же, как на C: float32, floor(x / s + 0.5) + zp, насыщение
    q_in = np.clip(np.floor(Z[mte] / np.float32(s_in) + np.float32(0.5)) + zp_in, -128, 127).astype(np.int8)
    outs = []
    for row in q_in:
        it.set_tensor(din["index"], row[None, :])
        it.invoke()
        outs.append(it.get_tensor(dout["index"])[0].copy())
    outs = np.array(outs, np.int8)
    q8 = outs.argmax(axis=1)
    # слои — FULLY_CONNECTED: веса int8 [выход][вход], сдвиги int32
    ops = [op for op in it._get_ops_details() if op["op_name"] == "FULLY_CONNECTED"]
    td = {d["index"]: d for d in it.get_tensor_details()}
    layers = []
    for op in ops:
        a, w, b = op["inputs"][:3]
        o = op["outputs"][0]
        sa, za = td[a]["quantization"]
        sw = td[w]["quantization_parameters"]["scales"]
        so, zo = td[o]["quantization"]
        assert not td[w]["quantization_parameters"]["zero_points"].any()
        wq = it.get_tensor(w)
        ms = [quantize_multiplier(float(sa) * float(v) / float(so)) for v in sw]
        ms = ms * (wq.shape[0] // len(ms))            # по тензору — один множитель на все выходы
        layers.append(dict(w=wq, b=it.get_tensor(b), za=int(za), zo=int(zo), mult=[m for m, _ in ms],
                           shift=[k for _, k in ms], nscale=len(sw)))
    return dict(mu=mu, sd=sd, s_in=float(s_in), zp_in=int(zp_in), layers=layers, outs=outs, fl=fl, q8=q8, qin=q_in,
                blob=len(blob), s_out=dout["quantization"], params=model.count_params())


yt = y[mte]
A = build(train(XF, 4), mtr)
tB = train(XS, 16)
B = build(tB, mtr)
Bbad = build(tB, mtr & (y == 0))                   # калибровка только по нормальным моторам
Bpt = build(tB, mtr, per_channel=False)            # один масштаб на весь тензор весов
for name, M in (("A", A), ("B", B), ("Bbad", Bbad), ("Bpt", Bpt)):
    lines.append("%s_float=%d" % (name, int((M["fl"] == yt).sum())))
    lines.append("%s_int8=%d" % (name, int((M["q8"] == yt).sum())))
    lines.append("%s_same=%d" % (name, int((M["fl"] == M["q8"]).sum())))
    lines.append("%s_params=%d" % (name, M["params"]))
    lines.append("%s_tflite=%d" % (name, M["blob"]))
    lines.append("%s_in=%.9g,%d" % (name, M["s_in"], M["zp_in"]))
    raw = np.floor(((XS if name != "A" else XF)[mte] - M["mu"]) / M["sd"] / np.float32(M["s_in"]) + 0.5) + M["zp_in"]
    lines.append("%s_sat=%d,%d" % (name, int(((raw < -128) | (raw > 127)).sum()), raw.size))
    lines.append("%s_layers=%s" % (name, ";".join("%d,%d,%d" % (L["nscale"], L["za"], L["zo"]) for L in M["layers"])))


def c_float(v):
    s_ = "%.9g" % v
    return (s_ if any(ch in s_ for ch in ".en") else s_ + ".0") + "f"


def c_arr(name, a, typ):
    flat = np.asarray(a).ravel()
    body = ", ".join(c_float(v) if typ == "float" else str(int(v)) for v in flat)
    return "static const %s %s[%d] = { %s };\n" % (typ, name, len(flat), body)


h = ["/* Раздел 119: модели A и B в int8 из конвертера TFLite — сгенерировано train119.py, не править */\n",
     "#include <stdint.h>\n#define N_TEST %d\n" % len(yt)]
for name, M, X in (("A", A, XF), ("B", B, XS)):
    L1, L2 = M["layers"]
    h.append("#define %s_IN %d\n#define %s_HID %d\n" % (name, X.shape[1], name, L1["w"].shape[0]))
    h.append("#define %s_S_IN %s\n#define %s_ZP_IN %d\n" % (name, c_float(M["s_in"]), name, M["zp_in"]))
    for k, L in (("1", L1), ("2", L2)):
        h.append("#define %s_ZA%s %d\n#define %s_ZO%s %d\n" % (name, k, L["za"], name, k, L["zo"]))
        h.append(c_arr("%s_M%s" % (name, k), L["mult"], "int32_t"))
        h.append(c_arr("%s_SH%s" % (name, k), L["shift"], "int32_t"))
        h.append(c_arr("%s_W%s" % (name, k), L["w"], "int8_t"))
        h.append(c_arr("%s_B%s" % (name, k), L["b"], "int32_t"))
    h.append(c_arr("%s_MU" % name, M["mu"], "float"))
    h.append(c_arr("%s_SD" % name, M["sd"], "float"))
    h.append("#ifdef ML_HOST\n")
    h.append(c_arr("%s_TEST_X" % name, X[mte], "float"))
    h.append(c_arr("%s_TFL" % name, M["outs"], "int8_t"))
    h.append(c_arr("%s_QIN" % name, M["qin"], "int8_t"))
    h.append("#endif\n")
h.append("#ifdef ML_HOST\n" + c_arr("TEST_Y", yt, "uint8_t") + "#endif\n")
open(OUT + "/model119.h", "w", encoding="utf-8", newline="\n").write("".join(h))
open(OUT + "/summary119.txt", "w", encoding="utf-8", newline="\n").write("\n".join(lines) + "\n")
print("\n".join(lines))
infer119.c — модели A и B в int8 на ядрах CMSIS-NN.
/* Раздел 119: модели A и B в int8 на ядрах CMSIS-NN 7.0.0.
 * С -DML_HOST main() сверяет выходы int8 с интерпретатором TFLite бит в бит. */
#include <math.h>
#include "arm_nnfunctions.h"
#include "model119.h"

/* Вход: нормировка во float, затем квантование масштабом и нулевой точкой входного тензора. */
static void quantize_in(const float *x, const float *mu, const float *sd, int n, float s, int zp, int8_t *q)
{
    int i;
    for (i = 0; i < n; i++) {
        float z = (x[i] - mu[i]) / sd[i];
        int v = (int)floorf(z / s + 0.5f) + zp;
        q[i] = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
    }
}

/* Полносвязный слой: int8 вход и веса, int32 сдвиг, выход int8 после пересчёта масштаба по каждому выходу. */
static void dense(const int8_t *in, int n_in, const int8_t *w, const int32_t *b, int n_out,
                  int za, int zo, const int32_t *mult, const int32_t *shift, int relu, int8_t *out)
{
    cmsis_nn_context ctx = { 0, 0 };
    cmsis_nn_fc_params fp = { -za, 0, zo, { relu ? zo : -128, 127 } };
    cmsis_nn_per_channel_quant_params qp = { (int32_t *)mult, (int32_t *)shift };   /* свой масштаб у каждого выхода */
    cmsis_nn_dims id = { 1, 1, 1, n_in }, fd = { n_in, 1, 1, n_out };
    cmsis_nn_dims bd = { 1, 1, 1, n_out }, od = { 1, 1, 1, n_out };
    arm_fully_connected_per_channel_s8(&ctx, &fp, &qp, &id, in, &fd, w, &bd, b, &od, out);
}

static int argmax3(const int8_t *o)
{
    int best = 0, j;
    for (j = 1; j < 3; j++)
        if (o[j] > o[best])
            best = j;
    return best;
}

int classify_a(const float *f, int8_t out[3])
{
    int8_t q[A_IN], h[A_HID];
    quantize_in(f, A_MU, A_SD, A_IN, A_S_IN, A_ZP_IN, q);
    dense(q, A_IN, A_W1, A_B1, A_HID, A_ZA1, A_ZO1, A_M1, A_SH1, 1, h);
    dense(h, A_HID, A_W2, A_B2, 3, A_ZA2, A_ZO2, A_M2, A_SH2, 0, out);
    return argmax3(out);
}

int classify_b(const float *spec, int8_t out[3])
{
    int8_t q[B_IN], h[B_HID];
    quantize_in(spec, B_MU, B_SD, B_IN, B_S_IN, B_ZP_IN, q);
    dense(q, B_IN, B_W1, B_B1, B_HID, B_ZA1, B_ZO1, B_M1, B_SH1, 1, h);
    dense(h, B_HID, B_W2, B_B2, 3, B_ZA2, B_ZO2, B_M2, B_SH2, 0, out);
    return argmax3(out);
}

#ifdef ML_HOST
#include <stdio.h>
int main(void)
{
    int n, j, same_a = 0, same_b = 0, right_a = 0, right_b = 0;
    for (n = 0; n < N_TEST; n++) {
        int8_t oa[3], ob[3];
        int ca = classify_a(&A_TEST_X[n * A_IN], oa), cb = classify_b(&B_TEST_X[n * B_IN], ob), ea = 1, eb = 1;
        for (j = 0; j < 3; j++) {
            ea &= oa[j] == A_TFL[n * 3 + j];
            eb &= ob[j] == B_TFL[n * 3 + j];
        }
        same_a += ea;
        same_b += eb;
        right_a += ca == TEST_Y[n];
        right_b += cb == TEST_Y[n];
    }
    printf("same_a=%d,%d\nsame_b=%d,%d\nright_a=%d\nright_b=%d\n", same_a, N_TEST, same_b, N_TEST, right_a, right_b);
    for (n = 0, same_a = same_b = 0; n < N_TEST; n++) {       /* вход: квантование C против Python */
        int8_t qa[A_IN], qb[B_IN];
        quantize_in(&A_TEST_X[n * A_IN], A_MU, A_SD, A_IN, A_S_IN, A_ZP_IN, qa);
        quantize_in(&B_TEST_X[n * B_IN], B_MU, B_SD, B_IN, B_S_IN, B_ZP_IN, qb);
        for (j = 0; j < A_IN; j++)
            same_a += qa[j] == A_QIN[n * A_IN + j];
        for (j = 0; j < B_IN; j++)
            same_b += qb[j] == B_QIN[n * B_IN + j];
    }
    printf("qin_a=%d,%d\nqin_b=%d,%d\n", same_a, N_TEST * A_IN, same_b, N_TEST * B_IN);
    return 0;
}
#else
volatile float g_in[B_IN];
volatile int g_class;
void SystemInit(void) {}
int main(void)
{
    for (;;) {
        float x[B_IN];
        int8_t o[3];
        int i;
        for (i = 0; i < B_IN; i++)
            x[i] = g_in[i];
        g_class = classify_b(x, o) + classify_a(x, o);
    }
}
#endif
Дальше: раздел 120 «Обнаружение аномалий» — когда дефектных записей нет вовсе и модель учится только на норме.