 Embedded HandbookПриложения
118. Обучение маленькой модели в контейнере
В разделе 116 модели учились на аккуратных точках, в разделе 117 признаки считались из окон сигнала. Здесь всё сведено вместе и приближено к тому, что бывает на заводе: данные приходят записями — прогон одного мотора с одним креплением датчика, — из записи нарезаны десятки похожих окон, классов не поровну, у каждого датчика своя чувствительность. Раздел показывает, как такие данные разбить, чтобы оценка не врала, как выбрать размер модели, что делать с редким классом и как довезти веса до прошивки так, чтобы C отвечал ровно как Python.
Обучение идёт в образе stm-ml:1 — numpy 2.3.3 и scikit-learn 1.7.2 —
и повторяется дословно: те же веса, те же числа до последнего знака.
Подходы — раздел 116, признаки — раздел 117.
Как это называется в документации
Оригинал Перевод recording, session запись: один прогон одного объекта labeling, annotation разметка: какой класс у записи train / validation / test split разбиение на обучение, подбор и проверку data leakage утечка: сведения о проверке попали в обучение group k-fold кросс-проверка по группам (записям) hyperparameter гиперпараметр: размер модели, глубина дерева confusion matrix матрица ошибок class imbalance дисбаланс классов: одних примеров мало class weight вес класса в обучении recall / precision полнота / точность false alarm ложная тревога calibration калибровка датчика на месте reproducible build воспроизводимая сборка literal pool пул литералов: константы рядом с кодом
118.1 Записи, а не точки
Набор раздела — 1800 окон из 90 записей: по 30 записей на состояние (норма, дисбаланс, подшипник), по 20 окон на запись. У записи свои частота вращения, амплитуды и чувствительность крепления датчика; окна одной записи различаются только фазой и шумом. Признаки окна — четыре числа из раздела 117: СКЗ, частота пика, пик-фактор и доля энергии в полосе 100–248 Гц.
Главное свойство таких данных: окна одной записи почти одинаковы. Модель, которая видела 14 окон записи, узнает пятнадцатое не потому, что поняла дисбаланс, а потому, что запомнила этот мотор. На приборе же ей встретится мотор, которого в обучении не было.
118.2 Разметка
Метку ставят записи целиком: мотор с дисбалансом, подшипник под замену, мотор после ремонта — норма. Надёжнее всего размечать по тому, что установлено вне сигнала: акт ремонта, осмотр, стенд с заведомым дефектом. Разметка «на глаз по спектру» учит модель повторять глаз разметчика, а не видеть дефект.
Записи хранят вместе с метаданными: какой мотор, какой датчик, как закреплён, какая частота выборки и версия прошивки, снявшей запись. Без них не разобраться, почему модель ошибается, и не разбить данные по записям.
118.3 Разбиение: утечка между окнами одной записи
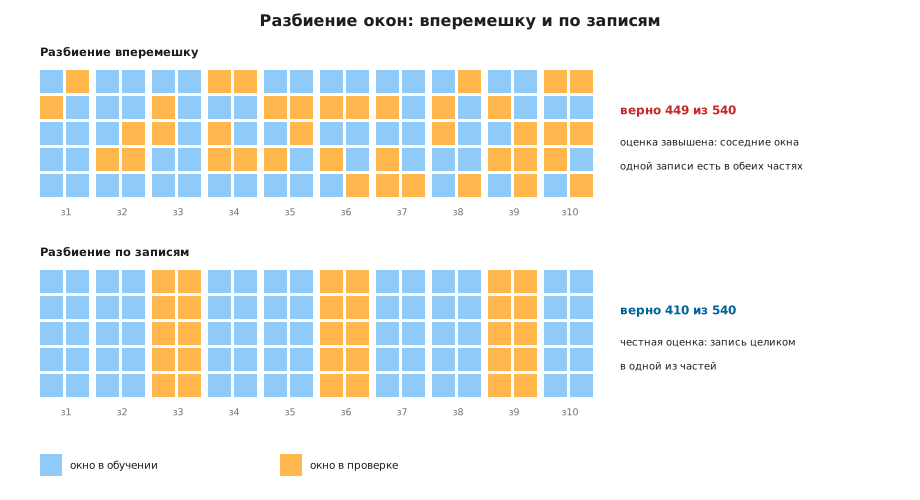
Два способа отложить 30 % данных на проверку. Вперемешку — окна выбираются случайно, и почти у каждой записи часть окон в обучении, часть в проверке:
tr, te = train_test_split(np.arange(len(y)), test_size=0.3, random_state=118, stratify=y)
По записям — в проверку уходят записи целиком:
rtr, rte = train_test_split(recs, test_size=0.3, random_state=118, stratify=recs // 1000)
mtr, mte = np.isin(g, rtr), np.isin(g, rte)
Одна и та же модель — перцептрон 4 → 4 → 3 — в первом случае верно 449 из 540 (83,1 %), во втором — верно 410 из 540 (75,9 %). Разница — то, что модель выучила о конкретных моторах. Ещё заметнее это у модели, которая только помнит: ближайший сосед: 460 при случайном разбиении и 444 при разбиении по записям. Правило простое: в проверке не должно быть ни одного окна записи, окна которой были в обучении. То же касается перекрывающихся окон из раздела 117: соседние окна с перекрытием — почти копии.
118.4 Нормировка — часть модели
Перцептрон учится на признаках, приведённых к нулевому среднему и единичному разбросу. Среднее и разброс считаются только по обучающим записям — иначе проверка протекает в обучение и здесь:
m, s = X[mtr].mean(axis=0), X[mtr].std(axis=0)
mlp = mk().fit((X[mtr] - m) / s, y[mtr])
Эти восемь чисел — такая же часть модели, как веса. Они уезжают
в прошивку вместе с весами (массивы MU и SD), и прибор нормирует
признаки ими, а не своими. Забыть их — самая частая причина, по которой
модель, отлично работавшая в Python, на плате отвечает одно и то же.
118.5 Размер модели: кросс-проверка по записям
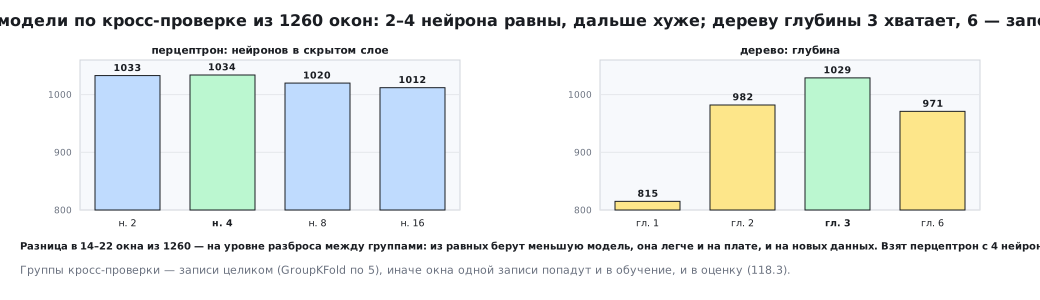
Сколько нейронов в скрытом слое и какой глубины дерево — решает не проверочная часть, её трогают один раз в конце. Обучающие записи делятся на 5 групп; модель учится на четырёх и отвечает на пятой, по кругу. Группы — записи целиком:
gkf = GroupKFold(n_splits=5)
for a, b in gkf.split(X[mtr], y[mtr], g[mtr]):
| Нейронов в скрытом слое | 2 | 4 | 8 | 16 |
|---|---|---|---|---|
| Верно из 1260 | 1033 | 1034 | 1020 | 1012 |
| Глубина дерева | 1 | 2 | 3 | 6 |
|---|---|---|---|---|
| Верно из 1260 | 815 | 982 | 1029 | 971 |
У перцептрона 2 и 4 нейрона не различить, дальше становится хуже: лишние нейроны учат особенности обучающих моторов. У дерева глубина 1 не справляется — одним вопросом три класса не разделить, — а глубина 6 уже запоминает. Взят перцептрон с 4 нейронами. Разница в 14–22 окна из 1260 — на уровне разброса между группами, поэтому из равных выбирают меньшую модель: она легче и на плате, и на новых данных.
118.6 Матрица ошибок итоговой модели
Итоговый перцептрон обучен на всех обучающих записях и один раз проверен на отложенных — 27 записей, 540 окон:
| Верно / ответ модели | норма | дисбаланс | подшипник |
|---|---|---|---|
| Норма | 70 | 110 | 0 |
| Дисбаланс | 20 | 160 | 0 |
| Подшипник | 0 | 0 | 180 |
Подшипник безошибочен: его выдаёт энергия в полосе, признак из раздела 117. Норма же в большинстве окон принята за дисбаланс. Причина не в модели: норма и дисбаланс различаются только силой вибрации, а сила, которую видит датчик, зависит от крепления. Тугое крепление нормального мотора даёт то же СКЗ, что слабое крепление мотора с дисбалансом. Никакой размер модели этого не исправит — нужны другие данные.
118.7 Калибровка крепления
Чувствительность крепления измеряют при установке датчика: известный толчок или эталонный вибростенд, и СКЗ делится на найденный коэффициент. В опыте это одна строка:
Xc[:, 0] /= gain_w
Тот же перцептрон после калибровки — 481 из 540: норма узнана в 168 окнах из 180 вместо 70. Дисбаланс узнан реже — в 133 окнах из 180 вместо 160, — потому что сами дисбалансы бывают разной силы и слабые заходят на территорию нормы; это уже вопрос порога тревоги, а не данных. Урок раздела 116 повторяется: хороший признак и честные данные дают больше, чем выбор модели.
118.8 Редкий класс и веса классов
На заводе исправных моторов много, дефектных мало. В опыте у подшипника оставлено каждое двадцатое окно: окон подшипника в обучении — 21 из 861. Дерево глубиной 2 считает ошибки поровну, и ему выгоднее почти всегда отвечать «не подшипник»: без весов нашло 60 подшипников из 180, с весами классов — 180, и ложных тревог — 0. Вес класса обратно пропорционален его доле, и каждая ошибка на редком классе обходится дороже:
q = DecisionTreeClassifier(max_depth=2, random_state=118, class_weight=cw).fit(X[thin], y[thin]).predict(X[mte])
Для прибора важны две величины по отдельности: полнота — какую долю дефектов он нашёл, и точность — какая доля тревог настоящая. Здесь «точность» — строгий термин, precision; в разделах 116 и 119 этим словом для краткости звали долю верных ответов (accuracy). Одна общая доля верных ответов обе величины прячет: модель, пропускающая все подшипники, здесь всё равно была бы права в двух случаях из трёх.
118.9 В прошивку: заголовок, сверка, воспроизводимость
Обучение пишет model118.h: нормировку, веса и отложенные окна
с ответами scikit-learn. Вывод на C — 43 числа, 28 умножений; скрытый слой:
for (i = 0; i < N_FEAT; i++)
    z[i] = (f[i] - MU[i]) / SD[i];
for (j = 0; j < N_HIDDEN; j++) {
    float s = B1[j];
    for (i = 0; i < N_FEAT; i++)
        s += z[i] * W1[i * N_HIDDEN + j];
    h[j] = s > 0.0f ? s : 0.0f;                 /* ReLU */
}
Собранный с -DML_HOST на компьютере, тот же файл прогоняет все
отложенные окна: ответы C и scikit-learn совпали во всех 540 окнах.
Такая сверка — обязательный шаг: перепутанный порядок весов (у
scikit-learn матрица «вход × нейрон»), забытая нормировка или
не тот тип числа видны сразу, а не на объекте.
armclang собрал вывод в 548 байт кода на F407 и 882 на F103 — у F103 нет FPU, и сложение с умножением плавающих чисел вызывают библиотеку. Компилятор развернул оба цикла целиком: 172 байта весов стали литералами, и литералов в коде 352 байта — веса и константы, которые компилятор вывел из них. Для модели в десятки чисел так быстрее всего; для тысяч весов циклы остаются, и веса лежат массивом во флеш-памяти.
Воспроизводимость: образ с закреплёнными версиями, зерно генератора
у каждого случайного шага (random_state=118), и повторное обучение
обязано дать тот же model118.h байт в байт. Если веса изменились,
а данные нет — поменялась библиотека, и это надо заметить до прошивки.
118.10 Грабли
В Python 99 %, на объекте — ерунда. Окна одной записи были и в обучении, и в проверке. Разбивать по записям, группы — в кросс-проверке тоже.
На плате модель отвечает одно и то же. Не перенесены среднее и разброс нормировки, или признаки на плате считаются иначе, чем при обучении. Нормировку — в заголовок, признаки — одним кодом (раздел 117).
Доля верных ответов высокая, а дефекты пропущены. Редкий класс: модели выгоднее его не замечать. Веса классов и полнота по каждому классу.
Один мотор норма, соседний — дисбаланс, хотя оба исправны. Разная чувствительность крепления. Калибровка при установке.
Переобучили — веса другие. Не закреплены версии или зерно.
Контейнер с версиями, random_state, сравнение заголовка с прошлым.
Выбрали модель по проверочной части. После этого она уже не проверочная. Подбор — кросс-проверкой, проверка — один раз в конце.
118.11 Итоги
- 1800 окон из 90 записей: разбиение вперемешку дало 83,1 %, по записям — 75,9 %; честная цифра — вторая.
- Размер модели выбирает кросс-проверка по записям: 4 нейрона, дерево глубиной 3.
- Нормировка — часть модели и едет в прошивку вместе с весами.
- Норму от дисбаланса отличает не модель, а калибровка крепления: 410 → 481 из 540.
- Редкий класс — веса классов: подшипников найдено 180 из 180 вместо 60.
- Вывод на C сверяется с Python на всех отложенных окнах; перцептрон 4 → 4 → 3 — 548 байт кода на F407.
Полные исходники
train118.py — обучение перцептрона от записей до весов в заголовке для прошивки.
# -*- coding: utf-8 -*-
"""Раздел 118: обучение маленькой модели — от записей к весам в прошивке.

Запуск — в образе stm-ml:1:  python train118.py <каталог_вывода>

Данные устроены как настоящие: запись — один прогон одного мотора, у неё свои
амплитуда и частота; из записи нарезано 20 окон, похожих друг на друга.
Признаки окна те же, что в разделе 117 (СКЗ, частота пика, пик-фактор, доля
энергии в полосе 100–248 Гц), посчитаны теми же формулами (117 сверил их
с CMSIS-DSP). Опыты:
  • утечка: случайное разбиение окон против разбиения по записям;
  • подбор гиперпараметров кросс-проверкой по группам записей;
  • редкий класс: подшипников в 20 раз меньше — точность против полноты;
  • выгрузка перцептрона 4 → 4 → 3 в model118.h для infer118.c и сверка с C.
Сводка — в summary118.txt."""
import sys

import numpy as np
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import GroupKFold, train_test_split
from sklearn.neural_network import MLPClassifier
from sklearn.tree import DecisionTreeClassifier

OUT = sys.argv[1] if len(sys.argv) > 1 else "."
rng = np.random.RandomState(118)
N, FS, WPR = 256, 1024.0, 20                      # отсчётов в окне, Гц, окон на запись
t = np.arange(N) / FS
hann = 0.5 * (1 - np.cos(2 * np.pi * np.arange(N) / N))


def feats(x):
    y = x - x.mean()
    rms = np.sqrt((y ** 2).mean())
    crest = np.abs(y).max() / rms
    m = np.abs(np.fft.rfft(y * hann))[:N // 2]
    m[0] = 0
    k = int(m.argmax())
    a, b, c = m[k - 1], m[k], m[k + 1]
    peak = (k + 0.5 * (a - c) / (a - 2 * b + c)) * FS / N
    band = (m[25:63] ** 2).sum() / (m[1:] ** 2).sum()
    return [rms, peak, crest, band]


def recording(c):
    """Одна запись: свои амплитуды и частоты на все её окна, между окнами — малый разброс и шум."""
    f1 = 25.0 + rng.uniform(-1.5, 1.5)
    if c == 0:
        a1, a2 = 0.45 * rng.uniform(0.6, 1.4), 0.0
    elif c == 1:
        a1, a2 = 0.74 * rng.uniform(0.6, 1.4), 0.0
    else:
        a1, a2 = 0.35 * rng.uniform(0.6, 1.4), 0.45 * rng.uniform(0.08, 1.3)
    f2 = 160.0 + rng.uniform(-20, 20)
    gain = rng.uniform(0.75, 1.3)                 # крепление датчика: своя чувствительность у записи
    a1, a2 = a1 * gain, a2 * gain
    GAINS.append(gain)
    X = []
    for _ in range(WPR):
        ph1, ph2 = rng.uniform(0, 2 * np.pi, 2)
        x = (1.65 + a1 * rng.uniform(0.95, 1.05) * np.sin(2 * np.pi * f1 * t + ph1)
             + a2 * rng.uniform(0.95, 1.05) * np.sin(2 * np.pi * f2 * t + ph2) + rng.uniform(-0.05, 0.05, N))
        X.append(feats(x))
    return X


GAINS = []
REC = {0: 30, 1: 30, 2: 30}
X, y, g = [], [], []
for c, n in REC.items():
    for r in range(n):
        for f in recording(c):
            X.append(f)
            y.append(c)
            g.append(c * 1000 + r)
X, y, g = np.array(X), np.array(y), np.array(g)
lines = ["windows=%d" % len(y), "recordings=%d" % len(set(g))]


def fit_eval(Xa, ya, Xb, yb, model):
    m, s = Xa.mean(axis=0), Xa.std(axis=0)
    p = model.fit((Xa - m) / s, ya).predict((Xb - m) / s)
    return int((p == yb).sum()), len(yb), p


# 1. утечка: случайное разбиение окон против разбиения по записям (одинаковая доля — 30 % на проверку)
mk = lambda: MLPClassifier(hidden_layer_sizes=(4,), max_iter=3000, random_state=118)
tr, te = train_test_split(np.arange(len(y)), test_size=0.3, random_state=118, stratify=y)
ok_rand, n_rand, _ = fit_eval(X[tr], y[tr], X[te], y[te], mk())
from sklearn.neighbors import KNeighborsClassifier
knn_r = fit_eval(X[tr], y[tr], X[te], y[te], KNeighborsClassifier(1))[0]
recs = np.array(sorted(set(g)))
rtr, rte = train_test_split(recs, test_size=0.3, random_state=118, stratify=recs // 1000)
mtr, mte = np.isin(g, rtr), np.isin(g, rte)
ok_grp, n_grp, p_grp = fit_eval(X[mtr], y[mtr], X[mte], y[mte], mk())
knn_g = fit_eval(X[mtr], y[mtr], X[mte], y[mte], KNeighborsClassifier(1))[0]
lines += ["leak_random=%d,%d" % (ok_rand, n_rand), "leak_group=%d,%d" % (ok_grp, n_grp),
          "leak_knn=%d,%d" % (knn_r, knn_g)]

# 2. подбор числа нейронов кросс-проверкой по группам записей (обучающие записи)
gkf = GroupKFold(n_splits=5)
for h in (2, 4, 8, 16):
    tot = 0
    for a, b in gkf.split(X[mtr], y[mtr], g[mtr]):
        tot += fit_eval(X[mtr][a], y[mtr][a], X[mtr][b], y[mtr][b],
                        MLPClassifier(hidden_layer_sizes=(h,), max_iter=3000, random_state=118))[0]
    lines.append("cv_h%d=%d,%d" % (h, tot, int(mtr.sum())))
for d in (1, 2, 3, 6):
    tot = 0
    for a, b in gkf.split(X[mtr], y[mtr], g[mtr]):
        tot += int((DecisionTreeClassifier(max_depth=d, random_state=118).fit(X[mtr][a], y[mtr][a])
                    .predict(X[mtr][b]) == y[mtr][b]).sum())
    lines.append("cv_d%d=%d,%d" % (d, tot, int(mtr.sum())))

# 3. итоговая модель — перцептрон 4 → 4 → 3 (4 нейрона выбрала кросс-проверка) на обучающих записях, проверка — на отложенных
m, s = X[mtr].mean(axis=0), X[mtr].std(axis=0)
mlp = mk().fit((X[mtr] - m) / s, y[mtr])
p = mlp.predict((X[mte] - m) / s)
cm = confusion_matrix(y[mte], p, labels=[0, 1, 2])
lines.append("final=%d,%d" % (int((p == y[mte]).sum()), int(mte.sum())))
lines.append("final_cm=%s" % ",".join(str(int(v)) for v in cm.ravel()))

# 3б. калибровка: СКЗ делится на чувствительность крепления, известную после поверки на месте
gain_w = np.repeat(np.array(GAINS), WPR)
Xc = X.copy()
Xc[:, 0] /= gain_w
okc, nc, pc = fit_eval(Xc[mtr], y[mtr], Xc[mte], y[mte], mk())
cmc = confusion_matrix(y[mte], pc, labels=[0, 1, 2])
lines.append("calib=%d,%d" % (okc, nc))
lines.append("calib_cm=%s" % ",".join(str(int(v)) for v in cmc.ravel()))

# 4. редкий класс: в обучении у подшипников оставить каждое двадцатое окно (1 к 20),
#    проверка — на тех же отложенных записях, где подшипников 180 окон
thin = mtr & ((y != 2) | (np.arange(len(y)) % 20 == 0))
lines.append("rare_train=%d,%d" % (int((y[thin] == 2).sum()), int(thin.sum())))
for name, cw in (("plain", None), ("balanced", "balanced")):
    q = DecisionTreeClassifier(max_depth=2, random_state=118, class_weight=cw).fit(X[thin], y[thin]).predict(X[mte])
    hit = int(((q == 2) & (y[mte] == 2)).sum())
    lines.append("rare_%s=%d,%d,%d" % (name, hit, int((q == 2).sum()), int((y[mte] == 2).sum())))


def c_float(v):
    s_ = "%.9g" % v
    return (s_ if any(ch in s_ for ch in ".en") else s_ + ".0") + "f"


def c_arr(name, a, typ="float"):
    flat = np.asarray(a).ravel()
    body = ", ".join(c_float(v) if typ == "float" else str(int(v)) for v in flat)
    return "static const %s %s[%d] = { %s };\n" % (typ, name, len(flat), body)


Xt = X[mte]
h = ["/* Раздел 118: перцептрон 4 → 4 → 3 и отложенные окна — сгенерировано train118.py, не править */\n",
     "#define N_FEAT 4\n#define N_HIDDEN %d\n#define N_TEST %d\n" % (mlp.coefs_[0].shape[1], len(Xt)),
     c_arr("MU", m), c_arr("SD", s), c_arr("W1", mlp.coefs_[0]), c_arr("B1", mlp.intercepts_[0]),
     c_arr("W2", mlp.coefs_[1]), c_arr("B2", mlp.intercepts_[1]), c_arr("TEST_X", Xt),
     c_arr("TEST_Y", y[mte], "unsigned char"), c_arr("SK", p, "unsigned char")]
open(OUT + "/model118.h", "w", encoding="utf-8", newline="\n").write("".join(h))
lines.append("params=%d" % (sum(w.size for w in mlp.coefs_ + mlp.intercepts_) + 8))
open(OUT + "/summary118.txt", "w", encoding="utf-8", newline="\n").write("\n".join(lines) + "\n")
print("\n".join(lines))
infer118.c — перцептрон 4 → 4 → 3 на Cortex-M и на ПК.
/* Раздел 118: перцептрон 4 → 4 → 3 из model118.h на Cortex-M и на ПК.
 * С -DML_HOST main() сверяет ответы C с ответами sklearn на отложенных окнах. */
#include "model118.h"

int classify118(const float f[N_FEAT])
{
    float z[N_FEAT], h[N_HIDDEN], o[3];
    int i, j, best = 0;

    for (i = 0; i < N_FEAT; i++)
        z[i] = (f[i] - MU[i]) / SD[i];
    for (j = 0; j < N_HIDDEN; j++) {
        float s = B1[j];
        for (i = 0; i < N_FEAT; i++)
            s += z[i] * W1[i * N_HIDDEN + j];
        h[j] = s > 0.0f ? s : 0.0f;                 /* ReLU */
    }
    for (j = 0; j < 3; j++) {
        float s = B2[j];
        for (i = 0; i < N_HIDDEN; i++)
            s += h[i] * W2[i * 3 + j];
        o[j] = s;                                   /* softmax не нужен: номер максимума тот же */
    }
    for (j = 1; j < 3; j++)
        if (o[j] > o[best])
            best = j;
    return best;
}

#ifdef ML_HOST
#include <stdio.h>
int main(void)
{
    int n, agree = 0, right = 0;
    for (n = 0; n < N_TEST; n++) {
        int c = classify118(&TEST_X[n * N_FEAT]);
        agree += c == SK[n];
        right += c == TEST_Y[n];
    }
    printf("agree=%d,%d\nright=%d,%d\n", agree, N_TEST, right, N_TEST);
    return 0;
}
#else
volatile float g_feat[N_FEAT];
volatile int g_class;
void SystemInit(void) {}
int main(void)
{
    for (;;) {
        float f[N_FEAT];
        int i;
        for (i = 0; i < N_FEAT; i++)
            f[i] = g_feat[i];
        g_class = classify118(f);
    }
}
#endif
Дальше: раздел 119 «Квантование int8» — те же веса в целых числах, CMSIS-NN и TensorFlow Lite Micro.