 Embedded HandbookПриложения
119б. Модель на плате: TensorFlow Lite Micro изнутри — MicroInterpreter, резолвер операторов, тензорная арена, входной буфер и поток отсчётов
В разделе 118а сеть научилась узнавать пять жестов по окну трёхосевого
акселерометра, в разделе 119 — как модель переводят в int8 и сверяют
с эталоном бит в бит. Здесь последний шаг: файл .tflite уезжает
в прошивку и работает под TensorFlow Lite Micro (TFLM). Раздел разбирает,
из чего состоит это развёртывание: модель массивом во флеш-памяти, набор
ядер операторов, интерпретатор и его рабочая память — тензорная арена,
вход и выход в int8, поток отсчётов от DMA до окна, время по операторам,
ошибки и сборка библиотеки без make.
Модель — сеть C раздела 118а (1317 параметров, 23 408 умножений
с накоплением на окно), тем же зерном и на тех же данных, в int8 —
9424 байта; в int8 она верна в 475 из 480 отложенных окон, как и во float. Библиотека — пак Keil tensorflow-lite-micro 1.23.2 вместе
с паками flatbuffers 2.0.6, gemmlowp, ruy и CMSIS-NN 4.1.0. Прошивка для
Cortex-M4F собрана xPack arm-none-eabi-gcc 14.2.1 и выполнена в QEMU
netduinoplus2 (STM32F405 — то же ядро, что у F407); тот же код собран
g++ 12 на компьютере и сверен с эталонным интерпретатором TensorFlow Lite
из Python. Цитаты из нынешнего TFLM — по клону репозитория
(коммит 85c6999 от 3 ноября 2026 года), пути — от tensorflow/lite/micro/.
Опоры: тензорная арена и место TinyML — раздел 85; модель и её операторы — 118а; квантование, масштаб и нулевая точка — 119; DMA в кольцевом режиме и прерывания половины буфера — раздел 9; поток со скользящим окном для звука — 121б.6.
Как это называется в документации
Оригинал Перевод MicroInterpreter интерпретатор: обходит граф и вызывает ядра op resolver, MicroMutableOpResolver набор ядер операторов, который собирает программист AllOpsResolver набор из всех ядер библиотеки tensor arena тензорная арена: один массив под всю рабочую память модели persistent / non-persistent (tail / head) постоянная часть арены и часть, которую планировщик делит между тензорами AllocateTensors разметка арены: кто, где и когда живёт schema version версия схемы файла .tfliteflatbuffer формат файла модели: читается на месте, без разбора Invoke один прогон модели MicroProfiler журнал времени по операторам DebugLog, MicroPrintf вывод сообщений библиотеки — его даёт платформа half transfer / transfer complete (HT/TC) прерывания DMA: заполнена половина / весь буфер ring buffer кольцевой буфер
119б.1 Путь отсчёта и карта памяти
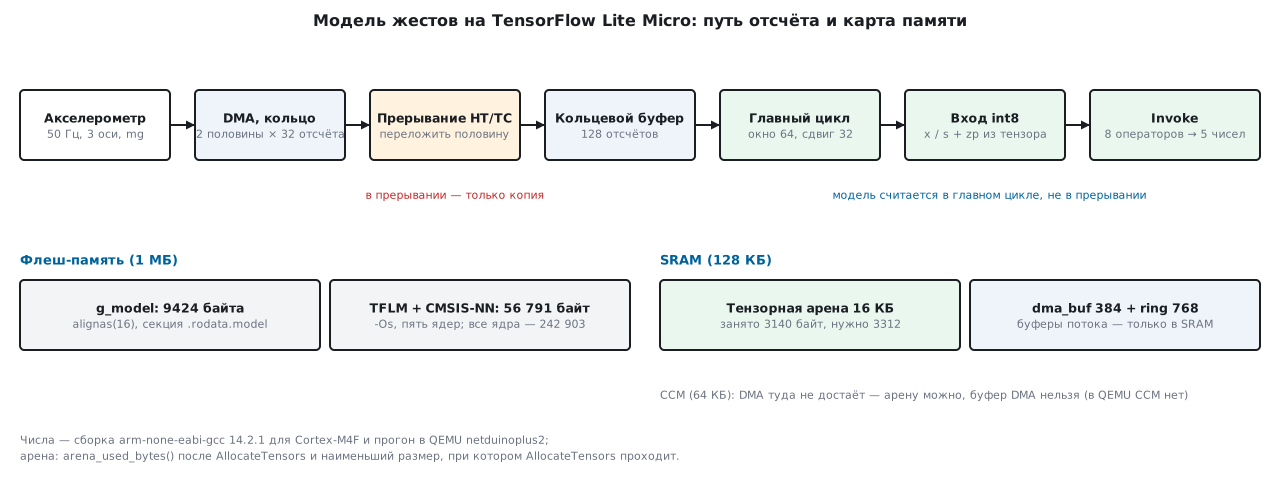
У развёртывания две половины. Неизменная живёт во флеш-памяти: модель
массивом байтов и код библиотеки — интерпретатор и ядра. Изменяемая живёт
в ОЗУ: тензорная арена, где лежат все промежуточные результаты, и буферы
потока. Интерпретатор ничего не выделяет сам — нет ни malloc, ни new
в куче: всё, что ему нужно, он берёт из арены, а арену даёт программист.
Модель в прошивку кладут массивом. Так делает xxd -i model.tflite;
здесь массив пишет сам train119c.py в том же виде и добавляет две вещи:
alignas(16) static uint8_t tensor_arena[ARENA_SIZE] __attribute__((section(ARENA_SECTION)));
это для арены, а для модели в model119c_data.cc стоит
alignas(16) __attribute__((section(".rodata.model"))) и const.
const — чтобы массив остался во флеш-памяти, а не копировался
в ОЗУ при старте. Своя секция — чтобы скрипт компоновки мог положить
модель отдельно, например в конец флеш-памяти, и менять её без кода.
Выравнивание 16 нужно потому, что flatbuffer читается на месте: числа
внутри файла лежат выровненными относительно его начала, и ядра читают
веса как слова. В прошивке модель встала по адресу 0x0800d1d0 — кратно 16.
Читать модель не надо — GetModel лишь приводит указатель к типу.
Проверить её надо самому:
const tflite::Model *model = tflite::GetModel(g_model);
if (model->version() != TFLITE_SCHEMA_VERSION) {
Константа равна 3 и в паке 1.23.2, и в нынешнем TFLM
(micro_interpreter.h:40: #define TFLITE_SCHEMA_VERSION (3)). Опыт:
поле версии в копии модели переписано на 4 — и AllocateTensors всё равно
вернул успех. Библиотека версию не смотрит, проверка в прошивке — единственная.
119б.2 Набор ядер: только нужные операторы
Интерпретатор знает граф, но не знает, как считать: ядра ему дают набором.
MicroMutableOpResolver<N> — набор на N операторов, куда кладут ровно
те, что есть в модели. В модели восемь узлов и пять разных операторов —
их список печатает конвертер (раздел 118а.6):
using Resolver = tflite::MicroMutableOpResolver<5>;
TF_LITE_ENSURE_STATUS(r.AddReshape());
TF_LITE_ENSURE_STATUS(r.AddConv2D());
TF_LITE_ENSURE_STATUS(r.AddDepthwiseConv2D());
TF_LITE_ENSURE_STATUS(r.AddFullyConnected());
плюс AddAveragePool2D (почему не AddMean — в 119б.4). Набор из всех
ядер — AllOpsResolver — удобен для первой пробы, но компоновщик уже не
может выбросить ни одного ядра. Сборка -Os для Cortex-M4F: библиотека
с пятью ядрами и CMSIS-NN заняла 56 791 байт флеш-памяти, с
AllOpsResolver — 242 903 байта, вчетверо больше. В нынешнем TFLM
AllOpsResolver уже нет — только набор, собранный руками.
Если ядра не хватает, AllocateTensors откажет и скажет, какого:
Didn't find op for builtin opcode 'AVERAGE_POOL_2D' version '2'. An older version of this builtin might be supported. Are you using an old TFLite binary with a newer model?
Failed to get registration from op code AVERAGE_POOL_2D
Слово «version» здесь — версия оператора, а не схемы: конвертер ставит её по тому, какие возможности ядра нужны модели, и старая библиотека может не знать новую версию того же оператора.
119б.3 Тензорная арена: сколько и где
Арена — один массив. AllocateTensors раскладывает в нём с одного конца
постоянные данные (описания тензоров, параметры ядер, буферы CMSIS-NN),
с другого — тензоры, которые живут не весь прогон: планировщик кладёт
в одно место те, что не нужны одновременно. Сколько занято, говорит
arena_used_bytes() (micro_interpreter.h:148:
size_t arena_used_bytes() const { return allocator_.used_bytes(); }).
На Cortex-M4F с ядрами CMSIS-NN занято 3140 байт: 1056 — тензоры
(head), 2180 — постоянная часть (tail), так раскладывает
RecordingMicroAllocator. Но самая маленькая арена, при которой
AllocateTensors проходит, — 3312 байт: при разметке нужно временное
место, которое потом отдаётся. С эталонными ядрами — 2932 байта
и 2960 байт: CMSIS-NN просит рабочие буферы под свёртки. На компьютере
та же модель занимает 3744 байта — указатели там по 8 байт, поэтому
арену подбирают на той архитектуре, где она будет работать.
Как подобрать размер: дать с запасом (здесь 16 КБ), запустить на плате,
напечатать arena_used_bytes(), затем уменьшать, пока AllocateTensors
проходит, и оставить запас на версию библиотеки и модели. Арену на 16
меньше нужной TFLM отверг с сообщением Too many buffers (max is 12)
и кодом ошибки. Хуже с ареной вдвое меньше: в паке 1.23.2 разметка
дошла до временного тензора, напечатала
Failed to allocate temp memory. Requested: 64, available 16, missing: 48
и упала в abort() — программа на компьютере завершилась с кодом 134.
Поэтому размер ищут шагами вверх, а не делением пополам.
Начало арены выравнивается на 16 (micro_arena_constants.h:25:
constexpr int MicroArenaBufferAlignment() { return 16; }); у массива
без alignas(16) до 15 байт пропадут. Место — обычная SRAM. CCM на F407
быстрая и недоступна DMA (раздел 2), а арену DMA не трогает, так что
на плате её можно перенести туда и освободить SRAM под буферы обмена.
В QEMU 7.2 у netduinoplus2 памяти CCM нет: прошивка с ареной по адресу
0x10000000 упала на первом обращении — на плате это не проверено.
Внешняя SDRAM годится только для больших моделей: она медленнее, а арена
трогается на каждом операторе.
119б.4 Вход, выход и сверка с Python
Масштаб и нулевую точку входа берут из тензора, а не переписывают руками:
const float s = in->params.scale;
const int zp = in->params.zero_point;
float g = (float)x[a] / 1000.0f;                 // mg → g, как при обучении
int v = (int)floorf(g / s + 0.5f) + zp;
*q++ = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
Вход — тензор int8 1 × 64 × 3, 192 байта, нулевая точка −42; выход — 1 × 5, нулевая точка −6. Классу нужен только номер наибольшего выхода, переводить его обратно в вещественное число незачем.
Сверка — все 480 отложенных окон, выходы int8 сравниваются с эталонным интерпретатором TensorFlow Lite 2.21 (не XNNPACK) число в число:
| Модель и сборка | Окон бит в бит | Наибольшая разница | Класс совпал |
|---|---|---|---|
| AVERAGE_POOL_2D, TFLM по умолчанию | 478 из 480 | 1 | 480 |
| то же, ключ TFLITE_SINGLE_ROUNDING | 231 из 480 | 3 | 480 |
| MEAN (как в разделе 118а), по умолчанию | 355 из 480 | 1 | 480 |
| Dense с масштабом на каждый выход | 0 из 480 | 13 | 479 |
Отсюда три вывода. Первый: эталонные ядра и CMSIS-NN дали одни и те же выходы, а прошивка в QEMU — те же, что программа на компьютере: хэш выходов на всех 95 окнах потока совпал. Значит, эталон для прибора — тот же TFLM на компьютере, и сверять с ним можно бит в бит.
Второй: настольный TensorFlow и TFLM 1.23.2 — разные реализации.
Глобальное среднее Keras превращается в оператор MEAN, и его ядра
у них считают по-разному: 355 окон из 480. Та же сеть, где среднее
взято слоем AveragePooling2D на всё окно, во float не отличается
(разница меньше 2·10⁻⁶), а оператор AVERAGE_POOL_2D совпадает
в 478 окнах. Поэтому развёрнута именно она. Ключ
TFLITE_SINGLE_ROUNDING здесь только мешает — какое округление совпадёт
с эталоном, решают ядра, и узнают это сравнением.
Третий — самый опасный. TensorFlow 2.21 по умолчанию даёт слою Dense
свой масштаб на каждый выход, а TFLM 1.23.2 такого FULLY_CONNECTED не
знает и берёт один масштаб на всех — без единого предупреждения. Выходы
расходятся до 13 уровней, а модель всё ещё «почти работает»: верно
474 вместо 475. В нынешнем TFLM это ядро масштаб на выход понимает
(kernels/fully_connected_common.cc:75:
is_per_channel = affine_quantization->scale->size > 1;); для старой
библиотеки конвертеру ставят
_experimental_disable_per_channel_quantization_for_dense_layers = True.
119б.5 Поток: DMA, кольцо и окно с перекрытием
Окно — 64 отсчёта (1,28 с при 50 Гц), сдвиг — 32: каждое окно наполовину перекрывает предыдущее, и жест, попавший на стык, целиком виден в следующем окне. DMA в кольцевом режиме пишет отсчёты в буфер из двух половин по 32 отсчёта: пока процессор берёт одну половину, DMA пишет другую — это и есть двойная буферизация. Прерывание половины (HT) или конца (TC) только перекладывает готовую половину в кольцевой буфер на 128 отсчётов:
extern "C" void dma_half_done(int half)
memcpy(&ring[((h + i) & (RING - 1)) * AXES], &src[i * AXES], AXES * sizeof(int16_t));
head = h + HOP;
Модель в прерывании не считают: Invoke длится сотни тысяч команд
(119б.6), и всё это время стояли бы прерывания того же и более низкого
приоритета — UART, таймеры, следующий же блок DMA. Главный цикл
(или задача RTOS) смотрит на счётчик head и, если готово новое окно,
собирает его из кольца, квантует и вызывает Invoke. Счётчик пишет
только прерывание, читает только главный цикл, поэтому хватает одного
volatile 32-битного слова без запрета прерываний.
Если главный цикл отстал так, что прерывание уже затирает начало окна, окно пропускается целиком:
if (h - next_end > RING - WIN - HOP) {
uint32_t lag = (h - next_end) / HOP;
st.dropped += (int)lag;
Лучше пропуск, чем окно из кусков двух разных моментов. В опыте поток из 48 отложенных окон подряд — 3072 отсчёта, 95 окон: при опросе после каждого блока посчитаны все 95, без пропусков, и выходы 93 из 95 бит в бит совпали с Python. Когда главный цикл заглядывал только после каждого третьего блока, успел 32 окна из 95, а 63 пропустил — и честно это посчитал. В QEMU «прерывание DMA» — настоящее: обработчик DMA2_Stream0 вызывается через NVIC, программа ставит его в ожидание после каждого блока.
119б.6 Время по операторам и сборка
Время одного Invoke и каждого оператора даёт MicroProfiler: интерпретатор
отмечает начало и конец каждого узла, часы — функция платформы
GetCurrentTimeTicks(). На кристалле это счётчик тактов DWT->CYCCNT;
в QEMU с -icount время идёт по числу команд, и SysTick считает их
же (калибровка: 2 000 000 команд — 336 002 отсчёта SysTick). Команд на
один Invoke:
| Сборка | Команд | CONV_2D | DEPTHWISE_CONV_2D |
|---|---|---|---|
| CMSIS-NN, -O2 | 191 142 | 54 % | 43 % |
| CMSIS-NN, -Os | 228 647 | 55 % | 42 % |
| эталонные ядра, -O2 | 2 047 791 | 78 % | 21 % |
Итого: с ядрами CMSIS-NN 191 142 команды (с -Os — 228 647 команд) — около 8 на умножение с накоплением; эталонные ядра — 2 047 791 команда, в 10,7 раза больше. По операторам (CMSIS-NN, -O2): CONV_2D — 54 %, DEPTHWISE_CONV_2D — 43 %, остальное — среднее, Reshape и Dense. Это команды, не такты: на плате тактов больше. Но сдвиг окна — 0,64 с, это 107 миллионов тактов на 168 МГц, так что запас на порядки.
Журнал профилировщика — массив в самом объекте: в паке 1.23.2 он на
1024 события, sizeof(MicroProfiler) на M4 — 20 488 байт, больше арены.
В нынешнем TFLM событий 4096 (micro_profiler.h:73:
static constexpr int kMaxEvents = 4096;), и при переполнении он не
начинает сначала, как 1.23.2, а останавливает программу. Поэтому
ClearEvents() — перед каждым Invoke, а в выпускной прошивке
профилировщик не подключают. Сам MicroInterpreter — 176 байт.
Сообщения библиотеки идут через MicroPrintf в функцию DebugLog,
которую даёт платформа: здесь на M4 это semihosting, на плате — UART
или SWO (раздел 21). Ключ TF_LITE_STRIP_ERROR_STRINGS выкидывает
тексты ошибок: библиотека -Os уменьшилась до 37 870 байт, но
AllocateTensors будет отказывать молча.
Сборка без make. Makefile нынешнего TFLM скачивает зависимости сам:
flatbuffers v25.9.23, kissfft, printf, для Cortex-M — CMSIS_6 и CMSIS-NN
с GitHub, и без сети не собирается. Пак Keil 1.23.2 содержит всё нужное
на диске, а файлов немного: 137 файлов .cpp TFLM (ядра, интерпретатор,
планировщик, разбор flatbuffer, kernels/internal) и 72 файла .c
CMSIS-NN. Для варианта с CMSIS-NN восемь ядер — add, conv,
depthwise_conv, fully_connected, mul, pooling, softmax, svdf —
берутся из kernels/cmsis_nn/ вместо одноимённых эталонных:
sed -i "s#^tensorflow/lite/micro/kernels/$k.cpp\$#tensorflow/lite/micro/kernels/cmsis_nn/$k.cpp#" "$OUT/srcs.txt"
Ключи: -DTF_LITE_STATIC_MEMORY (без кучи), -DCMSIS_NN,
-fno-rtti -fno-exceptions -fno-threadsafe-statics,
-ffunction-sections -fdata-sections и --gc-sections при компоновке —
без последних пары компоновщик не выбросит неиспользуемые ядра.
Тестовые файлы, Ethos-U и cortex_m_generic не нужны: DebugLog
и часы своя платформа даёт сама (port_m4_119c.cc ниже). Нужна и
стандартная библиотека C++ для arm-none-eabi: у gcc из образа stm-arm:1
нет даже <new>, поэтому сборка шла xPack GCC 14.2.1.
119б.7 Грабли
Модель «почти работает», но выходы на плате не те, что в Python.
Dense с масштабом на каждый выход, а TFLM старый (здесь 1.23.2): ядро
берёт один масштаб, не говоря ни слова. Конвертеру —
_experimental_disable_per_channel_quantization_for_dense_layers = True,
или новая библиотека. Сравнивать выходы, а не долю верных: 474 против 475
такую ошибку не выдаёт.
Выходы расходятся на единицу в сотнях окон. Ядро оператора в TFLM и в настольном TensorFlow считает иначе — здесь MEAN, 355 из 480. Эталон для прибора — тот же TFLM, собранный на компьютере; заменить оператор (AveragePooling2D вместо глобального среднего) — 478 из 480.
Плата падает в AllocateTensors. Арена сильно меньше нужной —
в TFLM 1.23.2 это abort(), а не ошибка. Размер подбирать на целевой
архитектуре по arena_used_bytes() и пробам вверх.
Арена посчитана на компьютере, а на плате не хватает или наоборот. Указатели 8 байт против 4: 3744 байта на x86-64 против 3140 на M4.
Через несколько минут работы программа останавливается. Подключён
MicroProfiler, а ClearEvents() не вызывается: в нынешнем TFLM после
4096 событий это abort, в 1.23.2 журнал молча идёт по кругу.
Чужая модель прошита, всё «работает». TFLM версию схемы не проверяет —
опыт с версией 4 прошёл AllocateTensors. Проверять model->version()
самому, и операторы набора — тоже.
Окно из двух кусков. Главный цикл отстал, прерывание затёрло начало окна, а прошивка всё равно его посчитала. Держать счётчик отсчётов и пропускать такое окно целиком.
Буфер DMA в CCM. DMA до CCM не достаёт (раздел 2). В CCM можно
арену, но не dma_buf.
119б.8 Итоги
- Модель —
const-массив во флеш-памяти,alignas(16), своя секция: 9424 байта;GetModelничего не разбирает, версию схемы проверяет прошивка. - Набор ядер — только нужные:
-Os56 791 байт против 242 903 байта сAllOpsResolver; без строк ошибок — 37 870 байт. - Арена на Cortex-M4F: занято 3140 байт (1056 — тензоры, 2180 — постоянное), нужно 3312 байт; на компьютере 3744 — подбирать на цели.
- Выходы TFLM против Python: 478 из 480 бит в бит; с MEAN — 355, с Dense по каналам на старом TFLM — 0 и разница до 13. Прошивка в QEMU и программа на компьютере совпали бит в бит.
- Поток: DMA из двух половин, прерывание только копирует, окно 64 со сдвигом 32 считается в главном цикле; отставание — пропуск целых окон, 32 окна из 95 при опросе раз в три блока.
- Invoke: 191 142 команды с CMSIS-NN, 2 047 791 — с эталонными ядрами; свёртки — 97 % времени.
Полные исходники
app119c.cc — приложение: модель, набор ядер, арена, поток через кольцо DMA, сверка и опыты с ошибками.
// app119c.cc — раздел 119б: модель жестов (раздел 118а, int8) на TensorFlow Lite Micro.
// Один исходник для компьютера (-DML_HOST, файл test119c.bin в argv[1]) и для Cortex-M4
// (QEMU netduinoplus2). Поток акселерометра идёт через кольцо DMA из двух половин,
// прерывание только перекладывает половину в кольцевой буфер, окно 64 отсчёта со сдвигом 32
// собирается и считается в главном цикле. Выходы int8 сверяются с эталонным интерпретатором
// TensorFlow Lite из Python (stream119c.h, test119c.bin).
#include <math.h>
#include <new>
#include <stdint.h>
#include <string.h>

#include "tensorflow/lite/micro/micro_interpreter.h"
#include "tensorflow/lite/micro/micro_log.h"
#include "tensorflow/lite/micro/micro_mutable_op_resolver.h"
#include "tensorflow/lite/micro/micro_profiler.h"
#include "tensorflow/lite/micro/micro_time.h"
#include "tensorflow/lite/micro/recording_micro_interpreter.h"
#include "tensorflow/lite/schema/schema_generated.h"
#ifdef ALL_OPS
#include "tensorflow/lite/micro/all_ops_resolver.h"
#endif
#if defined(MODEL_MEAN)                // та же сеть с оператором MEAN — опыт раздела 119б.7
#include "model119c_mean_data.h"
#define POOL_OP AddMean
#define POOL_NAME "MEAN"
#elif defined(MODEL_PC)                // Dense с масштабом на каждый выход — опыт 119б.7
#include "model119c_pc_data.h"
#define POOL_OP AddAveragePool2D
#define POOL_NAME "AVERAGE_POOL_2D"
#else
#include "model119c_data.h"
#define POOL_OP AddAveragePool2D
#define POOL_NAME "AVERAGE_POOL_2D"
#endif
#include "stream119c.h"
#if defined(MODEL_MEAN)
#define S_REF S_OUT_MEAN
#elif defined(MODEL_PC)
#define S_REF S_OUT_PC
#else
#define S_REF S_OUT
#endif

#ifndef ARENA_SIZE
#define ARENA_SIZE (16 * 1024)
#endif
#ifndef ARENA_SECTION
#define ARENA_SECTION ".bss.arena"
#endif
#define RING 128                       // кольцевой буфер отсчётов: 4 сдвига, степень двойки

alignas(16) static uint8_t tensor_arena[ARENA_SIZE] __attribute__((section(ARENA_SECTION)));
int g_quiet;                           // 1 — DebugLog молчит (подбор арены)
static tflite::MicroProfiler profiler; // события по операторам; чистить перед каждым Invoke
extern "C" void dma_half_done(int half);
void port_init(void);
void port_kick_dma(int half);          // «DMA заполнил половину»: вызвать прерывание
void port_exit(int code);

// ── операторы модели: ровно те, что в model119c.tflite ──
using Resolver = tflite::MicroMutableOpResolver<5>;
static TfLiteStatus register_ops(Resolver &r, bool with_pool)
{
    TF_LITE_ENSURE_STATUS(r.AddReshape());
    TF_LITE_ENSURE_STATUS(r.AddConv2D());
    TF_LITE_ENSURE_STATUS(r.AddDepthwiseConv2D());
    if (with_pool)
        TF_LITE_ENSURE_STATUS(r.POOL_OP());
    TF_LITE_ENSURE_STATUS(r.AddFullyConnected());
    return kTfLiteOk;
}

// ── поток: кольцо DMA из двух половин и кольцевой буфер окон ──
static int16_t dma_buf[2 * HOP * AXES];    // DMA в кольцевом режиме пишет сюда АЦП/датчик
static int16_t ring[RING * AXES];
static volatile uint32_t head;             // отсчётов в кольце всего; пишет только прерывание

/* Прерывание DMA (половина HT или конец TC): переложить половину в кольцо — и всё. */
extern "C" void dma_half_done(int half)
{
    const int16_t *src = &dma_buf[half * HOP * AXES];
    uint32_t h = head;
    for (int i = 0; i < HOP; i++)
        memcpy(&ring[((h + i) & (RING - 1)) * AXES], &src[i * AXES], AXES * sizeof(int16_t));
    head = h + HOP;
}

/* Окно [end − WIN, end) из кольца → входной тензор int8: масштаб и нулевая точка — из тензора. */
static void window_to_input(uint32_t end, const TfLiteTensor *in)
{
    const float s = in->params.scale;
    const int zp = in->params.zero_point;
    int8_t *q = in->data.int8;
    for (int i = 0; i < WIN; i++) {
        const int16_t *x = &ring[((end - WIN + i) & (RING - 1)) * AXES];
        for (int a = 0; a < AXES; a++) {
            float g = (float)x[a] / 1000.0f;                 // mg → g, как при обучении
            int v = (int)floorf(g / s + 0.5f) + zp;
            *q++ = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
        }
    }
}

static int argmax(const int8_t *o)
{
    int b = 0;
    for (int j = 1; j < NCLS; j++)
        if (o[j] > o[b])
            b = j;
    return b;
}

struct StreamStat {
    int done, same, dropped, cls_same;
    uint32_t ticks_max, hash;
};

/* Главный цикл: если в кольце есть новое окно — посчитать его. Окно, которое прерывание
 * успело затереть, пропускается целиком: лучше пропуск, чем окно из двух разных кусков. */
static uint32_t next_end;
static int poll_window(tflite::MicroInterpreter &ip, StreamStat &st)
{
    uint32_t h = head;
    if (h < next_end)
        return 0;
    if (h - next_end > RING - WIN - HOP) {
        uint32_t lag = (h - next_end) / HOP;
        st.dropped += (int)lag;
        next_end += lag * HOP;
    }
    window_to_input(next_end, ip.input(0));
    profiler.ClearEvents();              // иначе журнал переполнится: в TFLM 1.23.2 — по кругу, в новой — abort
    uint32_t t0 = tflite::GetCurrentTimeTicks();
    if (ip.Invoke() != kTfLiteOk)
        return -1;
    uint32_t dt = tflite::GetCurrentTimeTicks() - t0;
    if (dt > st.ticks_max)
        st.ticks_max = dt;
    const int8_t *o = ip.output(0)->data.int8;
    int k = (int)((next_end - WIN) / HOP);           // номер окна потока
    st.same += memcmp(o, &S_REF[k * NCLS], NCLS) == 0;
    st.cls_same += argmax(o) == argmax(&S_REF[k * NCLS]);
    for (int j = 0; j < NCLS; j++)                   // FNV-1a по выходам: сверка прибора с компьютером
        st.hash = (st.hash ^ (uint8_t)o[j]) * 16777619u;
    st.done++;
    next_end += HOP;
    return 1;
}

/* Поток из stream119c.h блоками по HOP отсчётов; главный цикл заглядывает в кольцо
 * после каждого блока (every = 1) или реже, будто занят чем-то ещё (every > 1). */
static StreamStat run_stream(tflite::MicroInterpreter &ip, int every)
{
    StreamStat st = {0, 0, 0, 0, 0, 2166136261u};
    head = 0;
    next_end = WIN;
    for (int b = 0; b < N_STREAM / HOP; b++) {
        int half = b & 1;
        memcpy(&dma_buf[half * HOP * AXES], &S_X[b * HOP * AXES], sizeof(int16_t) * HOP * AXES);
        port_kick_dma(half);
        if ((b + 1) % every == 0 || b == N_STREAM / HOP - 1)
            if (poll_window(ip, st) < 0)
                break;
    }
    while (poll_window(ip, st) > 0) {
    }
    return st;
}

/* Пробный интерпретатор для опытов: создаётся в своём буфере и не разрушается —
 * деструктор MicroInterpreter после неудачного AllocateTensors в TFLM 1.23.2 падает. */
alignas(16) static uint8_t probe_buf[sizeof(tflite::MicroInterpreter)];
static TfLiteStatus try_alloc(const tflite::Model *m, const tflite::MicroOpResolver &r, size_t n)
{
    tflite::MicroInterpreter *ip = new (probe_buf) tflite::MicroInterpreter(m, r, tensor_arena, n);
    return ip->AllocateTensors();
}

/* Наименьшая арена, при которой AllocateTensors проходит: вверх шагами по 16 от arena_used_bytes().
 * Не двоичный поиск: арена вдвое меньше нужной роняет TFLM 1.23.2 в abort(), а не в ошибку. */
static size_t min_arena(const tflite::Model *m, const tflite::MicroOpResolver &r, size_t used)
{
    size_t n = used / 16 * 16;
    g_quiet = 1;
    while (n < ARENA_SIZE && try_alloc(m, r, n) != kTfLiteOk)
        n += 16;
    g_quiet = 0;
    return n;
}

alignas(16) static uint8_t model_copy[MODEL_LEN];   // опыт «неверная версия схемы»

#ifdef ML_HOST
#include <stdio.h>
static int16_t T_X[N_TEST * WIN * AXES];
static uint8_t T_Y[N_TEST];
static int8_t T_OUT[N_TEST * NCLS];
#endif

int main(int argc, char **argv)
{
    (void)argc;
    (void)argv;
    port_init();
    // 1. Модель: указатель на массив во флеше, разбор не нужен — только проверка версии
    const tflite::Model *model = tflite::GetModel(g_model);
    if (model->version() != TFLITE_SCHEMA_VERSION) {
        MicroPrintf("model schema %d, library %d", model->version(), TFLITE_SCHEMA_VERSION);
        port_exit(1);
    }
    MicroPrintf("model_len=%d align16=%d schema=%d", (int)g_model_len, (int)((uintptr_t)g_model % 16 == 0),
                (int)model->version());
    MicroPrintf("model_addr=%x arena_addr=%x", (unsigned)(uintptr_t)g_model, (unsigned)(uintptr_t)tensor_arena);

    // 2. Набор ядер, интерпретатор, арена
#ifdef ALL_OPS
    static tflite::AllOpsResolver resolver;
#else
    static Resolver resolver;
    if (register_ops(resolver, true) != kTfLiteOk)
        port_exit(1);
#endif
    static tflite::MicroInterpreter interpreter(model, resolver, tensor_arena, ARENA_SIZE, nullptr, &profiler);
    if (interpreter.AllocateTensors() != kTfLiteOk) {
        MicroPrintf("AllocateTensors failed");
        port_exit(1);
    }
    TfLiteTensor *in = interpreter.input(0), *out = interpreter.output(0);
    MicroPrintf("arena_size=%d arena_used=%d", ARENA_SIZE, (int)interpreter.arena_used_bytes());
    MicroPrintf("in=%s,%d,%d,%d,%d bytes=%d zp=%d", TfLiteTypeGetName(in->type), in->dims->size, in->dims->data[0],
                in->dims->data[1], in->dims->data[2], (int)in->bytes, (int)in->params.zero_point);
    MicroPrintf("out=%s,%d,%d,%d bytes=%d zp=%d", TfLiteTypeGetName(out->type), out->dims->size, out->dims->data[0],
                out->dims->data[1], (int)out->bytes, (int)out->params.zero_point);
    MicroPrintf("scale_ok=%d,%d", (int)(in->params.scale == IN_SCALE), (int)(out->params.scale == OUT_SCALE));
    const tflite::SubGraph *sg = model->subgraphs()->Get(0);
    MicroPrintf("ops=%d tensors=%d profiler_bytes=%d interpreter_bytes=%d", (int)sg->operators()->size(),
                (int)sg->tensors()->size(), (int)sizeof(profiler), (int)sizeof(interpreter));

#ifdef ML_HOST
    if (argc > 2) {                     // опыт: арена вдвое меньше нужной
        size_t half = interpreter.arena_used_bytes() / 2 / 16 * 16;
        MicroPrintf("--- arena %d", (int)half);
        MicroPrintf("status=%d", (int)try_alloc(model, resolver, half));
        port_exit(0);
    }
#endif
    // 3. Поток: 95 окон через кольцо DMA, сверка с Python
    StreamStat st = run_stream(interpreter, 1);
    MicroPrintf("stream windows=%d same=%d class_same=%d dropped=%d ticks_max=%u hash=%x", st.done, st.same,
                st.cls_same, st.dropped, (unsigned)st.ticks_max, (unsigned)st.hash);
    StreamStat sl = run_stream(interpreter, 3);
    MicroPrintf("slow windows=%d same=%d dropped=%d", sl.done, sl.same, sl.dropped);

    // 4. Время по операторам: одно окно, MicroProfiler
    profiler.ClearEvents();
    window_to_input(WIN, in);
    interpreter.Invoke();
    MicroPrintf("profile_total=%u", (unsigned)profiler.GetTotalTicks());
    profiler.LogTicksPerTagCsv();

#ifdef ML_HOST
    // 5. Все 480 отложенных окон: выходы int8 против интерпретатора TFLite
    FILE *f = fopen(argv[1], "rb");
    if (!f || fread(T_X, sizeof T_X, 1, f) != 1 || fread(T_Y, sizeof T_Y, 1, f) != 1 ||
        fread(T_OUT, sizeof T_OUT, 1, f) != 1)
        port_exit(1);
#if defined(MODEL_MEAN) || defined(MODEL_PC)
    if (fread(T_OUT, sizeof T_OUT, 1, f) != 1)      // вторые в файле — выходы модели с MEAN
        port_exit(1);
#endif
#ifdef MODEL_PC
    if (fread(T_OUT, sizeof T_OUT, 1, f) != 1)      // третьи — Dense с масштабом на выход
        port_exit(1);
#endif
    fclose(f);
    int same = 0, right = 0, maxd = 0, cls = 0;
    for (int n = 0; n < N_TEST; n++) {
        memcpy(ring, &T_X[n * WIN * AXES], sizeof(int16_t) * WIN * AXES);
        window_to_input(WIN, in);
        interpreter.Invoke();
        const int8_t *o = out->data.int8;
        int eq = 1;
        for (int j = 0; j < NCLS; j++) {
            int d = o[j] - T_OUT[n * NCLS + j];
            d = d < 0 ? -d : d;
            maxd = d > maxd ? d : maxd;
            eq &= d == 0;
        }
        same += eq;
        right += argmax(o) == T_Y[n];
        cls += argmax(o) == argmax(&T_OUT[n * NCLS]);
    }
    MicroPrintf("test windows=%d same=%d class_same=%d right=%d maxdiff=%d", N_TEST, same, cls, right, maxd);
#endif

    // 6. Сколько арены нужно на самом деле и куда она уходит
    size_t need = min_arena(model, resolver, interpreter.arena_used_bytes());
    MicroPrintf("arena_min=%d", (int)need);
    {
        static tflite::RecordingMicroAllocator *ra = tflite::RecordingMicroAllocator::Create(tensor_arena, ARENA_SIZE);
        tflite::RecordingMicroInterpreter rip(model, resolver, ra);
        if (rip.AllocateTensors() == kTfLiteOk)
            rip.GetMicroAllocator().PrintAllocations();
    }

    // 7. Ошибки: мало арены, нет оператора, чужая версия схемы
    MicroPrintf("--- arena %d", (int)(need - 16));
    MicroPrintf("status=%d", (int)try_alloc(model, resolver, need - 16));
    MicroPrintf("--- no " POOL_NAME);
    {
        static Resolver r4;
        register_ops(r4, false);
        MicroPrintf("status=%d", (int)try_alloc(model, r4, ARENA_SIZE));
    }
    MicroPrintf("--- schema 4");
    {
        memcpy(model_copy, g_model, MODEL_LEN);
        uint32_t v4 = 4;
        memcpy(&model_copy[VERSION_OFFSET], &v4, 4);
        const tflite::Model *m4 = tflite::GetModel(model_copy);
        MicroPrintf("version=%d status=%d", (int)m4->version(), (int)try_alloc(m4, resolver, ARENA_SIZE));
    }
    MicroPrintf("done");
    port_exit(0);
    return 0;
}
port_m4_119c.cc — платформа Cortex-M4F: DebugLog через semihosting, часы на SysTick, прерывание DMA, запуск.
// port_m4_119c.cc — раздел 119б: платформа Cortex-M4F (QEMU netduinoplus2, STM32F405).
// DebugLog — semihosting, время — SysTick (в QEMU с -icount он идёт по числу команд;
// на кристалле вместо него берут DWT->CYCCNT), «DMA» — настоящее прерывание
// DMA2_Stream0 (IRQ 56), которое поднимается программно через NVIC.
#include <stdint.h>
#include <string.h>

#include "tensorflow/lite/micro/debug_log.h"
#include "tensorflow/lite/micro/micro_log.h"
#include "tensorflow/lite/micro/micro_time.h"

extern int g_quiet;
extern "C" void dma_half_done(int half);
int main(int argc, char **argv);

#define SYST_CSR (*(volatile uint32_t *)0xE000E010u)
#define SYST_RVR (*(volatile uint32_t *)0xE000E014u)
#define SYST_CVR (*(volatile uint32_t *)0xE000E018u)
#define NVIC_ISER1 (*(volatile uint32_t *)0xE000E104u)
#define NVIC_ISPR1 (*(volatile uint32_t *)0xE000E204u)
#define DMA2_S0_BIT (1u << (56 - 32))

static volatile uint32_t wraps;
static volatile int dma_half;

extern "C" void SysTick_Handler(void) { wraps++; }
extern "C" void DMA2_Stream0_IRQHandler(void) { dma_half_done(dma_half); }

static void sh_call(uint32_t op, const void *arg)
{
    register uint32_t r0 __asm("r0") = op;
    register const void *r1 __asm("r1") = arg;
    __asm volatile("bkpt 0xAB" : "+r"(r0) : "r"(r1) : "memory");
}

extern "C" void DebugLog(const char *s)
{
    if (!g_quiet)
        sh_call(0x04u, s);                     // SYS_WRITE0
}

namespace tflite {
uint32_t ticks_per_second() { return 0; }
uint32_t GetCurrentTimeTicks()
{
    uint32_t w, v;
    do {
        w = wraps;
        v = SYST_CVR;
    } while (w != wraps);
    return w * 0x1000000u + (0xFFFFFFu - v);
}
}  // namespace tflite

void port_init(void)
{
    uint32_t n = 1000000u;
    SYST_RVR = 0xFFFFFFu;
    SYST_CVR = 0u;
    SYST_CSR = 7u;
    while (SYST_CVR == 0u) {
    }
    NVIC_ISER1 = DMA2_S0_BIT;
    uint32_t t0 = tflite::GetCurrentTimeTicks();
    __asm volatile("1: subs %0, %0, #1\n"
                   "   bne 1b\n"
                   : "+r"(n));
    uint32_t t1 = tflite::GetCurrentTimeTicks();
    MicroPrintf("cal insn=2000000 ticks=%u", (unsigned)(t1 - t0));
}

void port_kick_dma(int half)
{
    dma_half = half;
    NVIC_ISPR1 = DMA2_S0_BIT;                  // прерывание DMA «пришло»
    __asm volatile("dsb\n isb" ::: "memory");
}

void port_exit(int code)
{
    static const uint32_t blk[2] = {0x20026u, 0u};   // ADP_Stopped_ApplicationExit
    (void)code;
    sh_call(0x18u, blk);
    for (;;) {
    }
}

// C++ без кучи: delete не нужен, но виртуальные деструкторы на него ссылаются
void operator delete(void *) noexcept {}
void operator delete(void *, unsigned int) noexcept {}
extern "C" void __cxa_pure_virtual(void) { for (;;) {} }
// статические объекты живут до выключения: регистрировать их деструкторы незачем
extern "C" int __cxa_atexit(void (*)(void *), void *, void *) { return 0; }
extern "C" {
void *__dso_handle = nullptr;
}
extern "C" void _init(void) {}

extern uint32_t _estack, _sidata, _sdata, _edata, _sbss, _ebss;
extern "C" void __libc_init_array(void);

extern "C" void Reset_Handler(void)
{
    uint32_t *s = &_sidata, *d = &_sdata;
    (*(volatile uint32_t *)0xE000ED88u) |= 0xFu << 20;    // CPACR: FPU
    __asm volatile("dsb\n isb");
    while (d < &_edata)
        *d++ = *s++;
    for (d = &_sbss; d < &_ebss;)
        *d++ = 0u;
    __libc_init_array();
    main(0, 0);
    port_exit(0);
}

extern "C" void Default_Handler(void)
{
    MicroPrintf("fault");
    port_exit(1);
}
lib119c.sh — сборка библиотеки TFLM из пака без make: список файлов, замена ядер на CMSIS-NN, архив.
# lib119c.sh — раздел 119б: библиотека TensorFlow Lite Micro из пака Keil 1.23.2 без make и без загрузок.
#   sh lib119c.sh <каталог> <ref|nn> <c++> <cc> <флаги…>
# Пак смонтирован в /tf, flatbuffers 2.0.6 — /fb, gemmlowp — /gl, ruy — /ruy, CMSIS-NN 4.1.0 — /nn.
# ref — эталонные ядра; nn — восемь ядер заменены файлами kernels/cmsis_nn/ (как OPTIMIZED_KERNEL_DIR=cmsis_nn
# в make) и добавлена CMSIS-NN. Тесты, Ethos-U и cortex_m_generic не берутся: DebugLog и часы — свои.
set -eu
OUT=$1; KERN=$2; CXX=$3; CC=$4; shift 4
rm -rf "$OUT/o"
mkdir -p "$OUT/o"
: > "$OUT/warn.txt"
INC="-I/tf -I/fb -I/gl -I/ruy -I/nn/Include"
NNK="add conv depthwise_conv fully_connected mul pooling softmax svdf"
cd /tf
find tensorflow -name '*.cpp' | grep -v -e '/ethos_u/' -e '/cmsis_nn/' -e '/cortex_m_generic/' \
    -e 'test_helper' -e 'fake_micro_context' -e 'mock_micro_graph' -e 'kernel_runner' | sort > "$OUT/srcs.txt"
if [ "$KERN" = nn ]; then
    for k in $NNK; do
        sed -i "s#^tensorflow/lite/micro/kernels/$k.cpp\$#tensorflow/lite/micro/kernels/cmsis_nn/$k.cpp#" "$OUT/srcs.txt"
    done
fi
n=0
while read -r f; do
    n=$((n + 1))
    echo "$CXX -std=c++17 -fno-rtti -fno-exceptions -fno-threadsafe-statics $INC $* -c $f -o $OUT/o/$(echo "$f" | tr / _).o"
done < "$OUT/srcs.txt" > "$OUT/cmds.txt"
if [ "$KERN" = nn ]; then
    find /nn/Source -name '*.c' | sort | while read -r f; do
        echo "$CC -std=c11 -include stdint.h $INC $* -c $f -o $OUT/o/nn_$(basename "$f" .c).o"
    done >> "$OUT/cmds.txt"
fi
xargs -P "$(nproc)" -I{} sh -c '{} 2>>'"$OUT"'/warn.txt' < "$OUT/cmds.txt"
rm -f "$OUT/libtflm.a"
${AR:-ar} rcs "$OUT/libtflm.a" "$OUT"/o/*.o
echo "lib_$KERN tflm_files=$n objects=$(ls "$OUT"/o | wc -l)"
Дальше: раздел 120 «Обнаружение аномалий» — когда дефектных записей нет вовсе и модель учится только на норме.