 Embedded HandbookПриложения
116а. Регрессия, опорные векторы и ансамбли: линейная регрессия, SVM, случайный лес и градиентный бустинг — обучение и вывод на C
Раздел 116 решал одну задачу пятью подходами — порог, логистическая регрессия, одно дерево, k ближайших соседей и маленькая сеть — и сравнивал их матрицей ошибок и кросс-проверкой. Здесь — следующие по частоте инструменты. Линейная регрессия отвечает не классом, а числом: температурой обмотки по току и оборотам. Метод опорных векторов и ансамбли деревьев — лес и бустинг — решают бинарную задачу «исправен или износ подшипника» там, где граница между классами кривая. Для каждой модели — обучение в контейнере, выгрузка в C, сверка ответов C с Python и цена на F407: байты флеша и такты на ответ.
Опоры: scikit-learn 1.7.2 и numpy 2.3.3 в образе stm-ml:1 (как в разделах
116 и 118); armclang из Keil MDK — размеры кода и таблиц для Cortex-M4F;
симулятор µVision — такты; справочное руководство RM0090 из пака Keil —
задержки флеш-памяти F407. Данные синтетические, с фиксированным зерном.
Как это называется в документации
Оригинал Перевод linear regression линейная регрессия: число — взвешенная сумма признаков least squares, normal equations метод наименьших квадратов, нормальные уравнения gradient descent, learning rate градиентный спуск, шаг обучения ridge regression, L2 penalty гребневая регрессия, штраф за квадрат весов MAE, RMSE, R² средняя ошибка по модулю, корень из среднего квадрата, доля объяснённого разброса precision, recall, F1 точность, полнота, их среднее гармоническое ROC curve, AUC кривая ошибок при сдвиге порога, площадь под ней support vector machine (SVM) метод опорных векторов margin, soft margin, C зазор, мягкий зазор, цена нарушения зазора kernel, RBF, gamma ядро, радиальное ядро, его ширина bagging, random forest бэггинг, случайный лес gradient boosting градиентный бустинг hyperparameter tuning подбор гиперпараметров
116а.1 Линейная регрессия: число по признакам датчика
Задача: прибор на моторе меряет температуру воздуха, ток фазы и обороты, а датчика в обмотке нет. Нагрев — потери в меди, пропорциональные I², делённые на обдув вентилятора на валу, который растёт с оборотами. Данные: 200 примеров для обучения и 200 для проверки, температура обмотки — с шумом датчика 1 °C.
Модель — взвешенная сумма признаков плюс сдвиг. Метод наименьших квадратов (МНК) подбирает веса так, чтобы сумма квадратов ошибок на обучении была наименьшей, и решается в замкнутом виде — одной системой уравнений:
w_ls = np.linalg.solve(Z1.T @ Z1, Z1.T @ yr)
Здесь Z1 — признаки, приведённые к масштабу, со столбцом единиц для сдвига.
Решение совпало с LinearRegression из scikit-learn до 1,4·10⁻¹³.
Три меры качества. MAE — средняя ошибка по модулю, в градусах. RMSE — корень из среднего квадрата ошибки, тоже в градусах, но сильнее наказывает редкие большие промахи. R² — какую долю разброса температуры модель объяснила: 1 — всю, 0 — не лучше среднего.
| Признаки | MAE, °C | RMSE, °C | R² |
|---|---|---|---|
| воздух, ток, обороты | 1,98 | 2,48 | 0,944 |
| те же и q = I²/(1 + n/1000) | 0,80 | 1,00 | 0,991 |
На сырых признаках модель промахивается на 2,48 °C: нагрев зависит от тока не линейно. Признак q, записанный по физике нагрева, сводит RMSE к 1,00 °C — это шум самого датчика, лучше эти данные не дадут. Модель линейна по весам, а не по физике: нелинейность уходит в признаки.
Тот же ответ даёт градиентный спуск — шаг против градиента среднего квадрата ошибки:
w -= lr * 2 / len(y) * M.T @ (M @ w - y)
С шагом 0,1 на признаках, приведённых к масштабу, веса подходят к решению МНК ближе чем на 0,001 за 865 шагов. Без приведения к масштабу обороты в тысячах и q в единицах делают задачу плохо обусловленной: отношение наибольшего собственного числа к наименьшему — 87281598 против 41,8. Наибольший устойчивый шаг падает до 1,4·10⁻⁷, и после 10 000 шагов RMSE — всё ещё 7,86 °C. Спуск нужен, когда признаков тысячи или модель учится на самом приборе; для нескольких признаков проще замкнутый вид.
Вывод на C — четыре умножения на веса после приведения к масштабу:
    const float f[4] = { x[0], x[1], x[2], x[1] * x[1] / (1.0f + x[2] / 1000.0f) };
    for (int i = 0; i < 4; i++)
        y += REG_W[i] * (f[i] - REG_MU[i]) * REG_INV_SD[i];
Ответы C отличаются от scikit-learn не больше чем на 0,000008 °C. Функция — 212 байт на F407, 39 тактов на ответ.
116а.2 L2-регуляризация: когда признаки дублируют друг друга
У прибора два датчика одного тока — шунт и датчик Холла, — а обучающих примеров всего 12. МНК не знает, как поделить вес между почти одинаковыми признаками, и ставит огромные веса с разными знаками: малый шум в разнице датчиков он принимает за сигнал. Ridge (гребневая регрессия) добавляет к сумме квадратов ошибок штраф λ·Σw², и решение остаётся замкнутым:
w_r = np.linalg.solve(Sd1.T @ Sd1 + 1.0 * I0, Sd1.T @ ys)
I0 — единичная матрица с нулём на месте сдвига: сдвиг не штрафуют. Решение
совпало с Ridge(alpha=1.0) до 2,7·10⁻¹⁵. Проверка — на 200 новых примерах:
| λ | Вес шунта | Вес датчика Холла | RMSE, °C |
|---|---|---|---|
| 0 (МНК) | −10,84 | 6,62 | 2,47 |
| 0,1 | −1,09 | 0,08 | 1,16 |
| 1 | 1,39 | 1,55 | 2,68 |
| 10 | 1,50 | 1,49 | 6,26 |
Малый штраф убирает качели весов и вдвое снижает ошибку. Большой штраф
делит вес поровну, но уже давит и полезный признак q — модель
недообучается. λ — гиперпараметр, его выбирают кросс-проверкой на обучающих
примерах: RidgeCV выбрал 0,03, и RMSE на проверке — 1,98 °C. На 12 примерах
и сама кросс-проверка шумит: лучшее λ из таблицы она не нашла.
116а.3 Бинарная классификация и её метрики
Вторая задача — по окну вибрации решить, исправен подшипник или изношен. Шесть признаков окна, как в разделе 117: СКЗ, частота пика, пик-фактор, доля энергии в полосе, эксцесс и температура корпуса. Износ слегка поднимает пик-фактор, эксцесс и энергию в полосе. Но у исправного мотора энергия в полосе тоже растёт горбом, когда обороты проходят резонанс корпуса, — граница между классами кривая:
band = 0.06 + 0.25 * np.exp(-((v - 0.55) / 0.12) ** 2) + 0.14 * s + rc.normal(0, 0.02, n)
Выборки: 600 окон для обучения (200 с износом), 400 для проверки (100 с износом) и ещё 4000 «новых моторов» для опытов, по которым ничего не выбирают.
Износ — редкий и дорогой класс, и доля верных ответов о нём молчит. Ответы раскладывают на четыре числа: нашли износ верно (TP), подняли ложную тревогу (FP), пропустили износ (FN), верно сказали «исправен» (TN). Из них:
- полнота = TP / (TP + FN) — какую долю изношенных подшипников нашли;
- точность (precision) = TP / (TP + FP) — какая доля тревог настоящая;
- F1 = 2·TP / (2·TP + FP + FN) — одно число, которое падает, если плоха любая из двух.
| Модель | TP | FP | FN | Полнота | Точность | F1 | AUC |
|---|---|---|---|---|---|---|---|
| Линейный SVM | 65 | 15 | 35 | 65 % | 81,3 % | 0,72 | 0,888 |
| SVM с ядром RBF | 65 | 9 | 35 | 65 % | 87,8 % | 0,75 | 0,902 |
| Дерево глубиной 4 | 72 | 20 | 28 | 72 % | 78,3 % | 0,75 | 0,900 |
| Случайный лес | 76 | 17 | 24 | 76 % | 81,7 % | 0,79 | 0,938 |
| Градиентный бустинг | 80 | 20 | 20 | 80 % | 80,0 % | 0,80 | 0,943 |
Каждая модель выдаёт не только класс, но и число — расстояние до границы у SVM, долю голосов у леса, сумму у бустинга, — а класс получается сравнением с порогом. Сдвиг порога меняет полноту на точность. Кривая ROC — доля найденных износов против доли ложных тревог при всех порогах сразу, AUC — площадь под ней: 1 — модель всегда ставит изношенный подшипник выше исправного, 0,5 — гадает. AUC не зависит от выбранного порога и удобна для сравнения моделей. У бустинга порог −1 вместо 0 находит 89 износов из 100 вместо 80, но ложных тревог — 55 вместо 20, и точность падает до 61,8 %. Где ставить порог, решает цена ошибок, как в разделе 116.7.
116а.4 Метод опорных векторов
Линейный SVM ищет такую плоскость w·z + b = 0, чтобы между ней и ближайшими примерами обоих классов был наибольший зазор. Примеры на краю зазора и внутри него — опорные векторы: только они и определяют плоскость. Классы перекрываются, поэтому зазор мягкий: примеру разрешено зайти за край ценой, пропорциональной C. Малое C — широкий зазор и много опорных векторов, большое — узкий зазор, плотно подогнанный к обучению:
| C | 0,01 | 0,1 | 1 | 10 |
|---|---|---|---|---|
| Опорных векторов из 600 | 330 | 276 | 266 | 266 |
| Верно из 400 | 348 | 350 | 349 | 349 |
Кросс-проверка выбрала C = 0,1. Для линейного ядра опорные векторы на плату не нужны: они сворачиваются в 6 весов, и вывод — скалярное произведение:
    for (int i = 0; i < N_FEAT; i++)
        d += LIN_W[i] * z[i];
    return d > 0.0f;
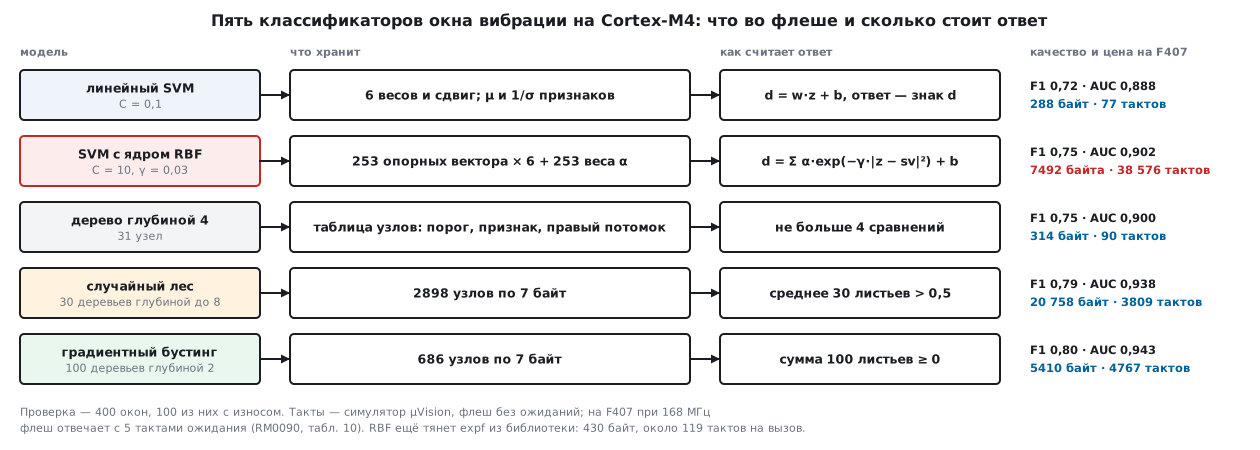
288 байт и 77 тактов, верно 350 из 400. Но плоскость не повторяет горб энергии в полосе, и полнота — 65 %.
Ядро RBF заменяет скалярное произведение мерой близости exp(−γ·|z − sv|²): граница становится кривой, но опорные векторы больше не сворачиваются. Ответ — сумма по всем ним:
    for (int k = 0; k < N_SV; k++) {
        const float *sv = &SV[k * N_FEAT];
        float r2 = 0.0f;
        for (int i = 0; i < N_FEAT; i++) {
            float t = z[i] - sv[i];
            r2 += t * t;
        }
        d += SV_ALPHA[k] * expf(-RBF_GAMMA * r2);
    }
Кросс-проверка выбрала C = 10 и γ = 0,03; опорных векторов — 253 из 600. Модель тащит во флеш почти половину обучающей выборки: 6072 байта векторов, 1012 байт весов α и ещё expf из библиотеки — 430 байт. Ответ стоит 38 576 тактов, около 150 тактов на опорный вектор, а одна expf в отдельном цикле — около 119 тактов. При 168 МГц это около 230 мкс без учёта ожиданий флеша — в 500 раз дороже линейного SVM ради 6 верных ответов из 400 и F1 0,75 вместо 0,72. Число опорных векторов растёт вместе с обучающей выборкой, как память у k ближайших соседей в разделе 116.5.
116а.5 Ансамбли: лес и бустинг
Одно глубокое дерево запоминает обучающую выборку: дерево без ограничения выросло до глубины 16 и 157 узлов, верно 600 из 600 на обучении и только 344 из 400 на проверке. Дерево глубиной 4, выбранное кросс-проверкой, — 352 из 400. Глубокое дерево не плохое, а нестабильное: другая обучающая выборка — другие пороги и другие ошибки.
Бэггинг пользуется этим. Каждое дерево учится на своей случайной выборке с возвращением из обучающей, а в случайном лесу ещё и в каждом узле выбирает порог среди случайной части признаков. Ошибки деревьев становятся разными, и при усреднении часть их гасится. scikit-learn усредняет не голоса, а доли классов в листьях — «мягкое» голосование. Лес из полных деревьев на 4000 новых окнах:
| Деревьев | 1 | 3 | 10 | 30 | 100 |
|---|---|---|---|---|---|
| Верно из 4000 | 3139 | 3299 | 3435 | 3482 | 3487 |
| Узлов всего | 141 | 423 | 1486 | 4250 | 14088 |
Одно дерево леса хуже одиночного полного дерева (3212 из 4000): оно видело не все примеры. С 30 деревьев рост почти кончается, а память растёт дальше: 100 полных деревьев — 14088 узлов, при 7 байтах на узел это 98 616 байт флеша ради 5 верных ответов из 4000. В прошивку взят лес из 30 деревьев глубиной до 8 (глубину выбрала кросс-проверка): 2898 узлов, верно 359 из 400 и 3510 из 4000.
Бустинг строит деревья не независимо, а по очереди: каждое следующее — маленькое, глубиной 2, — учится исправлять ошибки суммы предыдущих, и его вклад умножается на шаг 0,1. Ответ — знак суммы:
    float s = GB_INIT;
    for (int t = 0; t < N_TREES_GB; t++)
        s += walk(GB_THR, GB_FEAT, GB_RIGHT, GB_ROOT[t], x);
    return s >= 0.0f;
100 деревьев по 2 сравнения — 686 узлов, верно 360 из 400 и 3536 из 4000: лучше леса при почти вчетверо меньшей таблице. Лес гасит разброс глубоких деревьев, бустинг складывает много слабых — и тот и другой повторяют горб энергии в полосе ступеньками, которых не может плоскость.
116а.6 Экспорт в C и сводная таблица
Веса линейных моделей и опорные векторы уходят в заголовок массивами float.
Деревья — таблицей узлов: порог, номер признака и номер правого потомка;
левый потомок — всегда следующий узел, потому что scikit-learn нумерует узлы
обходом в глубину. У листа номер признака −1, а в поле порога лежит его
значение — доля износа у дерева и леса, вклад у бустинга. Узел — 7 байт:
    while (feat[n] >= 0)
        n = x[feat[n]] <= thr[n] ? n + 1 : right[n];
    return thr[n];                      /* у листа в thr лежит его значение */
Порог при выгрузке округляется до наибольшего float, не большего порога
scikit-learn: тогда x <= thr[n] для любого float x даёт ту же ветку.
При округлении до ближайшего 504 порога из 1742 стали бы больше настоящих;
на 400 и 4000 окнах это не изменило ни одного ответа, но окно, попавшее ровно
на такое значение, ушло бы в другую ветку.
Сверка: тот же infer116b.c, собранный gcc на компьютере и armclang для
F407 в симуляторе µVision, ответил как scikit-learn во всех 400 окнах у всех
пяти классификаторов. Флеш — функция и её таблицы из объектного файла
armclang -O2; такты — счётчик симулятора на всех 400 окнах, за вычетом
пустого прохода цикла:
| Модель | Верно из 400 | F1 | AUC | Флеш, байт | Тактов на ответ |
|---|---|---|---|---|---|
| Линейный SVM | 350 | 0,72 | 0,888 | 288 | 77 |
| SVM с ядром RBF | 356 | 0,75 | 0,902 | 7492 + expf 430 | 38 576 |
| Дерево глубиной 4 | 352 | 0,75 | 0,900 | 314 | 90 |
| Случайный лес, 30 деревьев | 359 | 0,79 | 0,938 | 20 758 | 3809 |
| Бустинг, 100 деревьев глубиной 2 | 360 | 0,80 | 0,943 | 5410 | 4767 |
Регрессия температуры обмотки — RMSE 1,00 °C, 212 байт, 39 тактов. Симулятор считает флеш без ожиданий. На F407 при 168 МГц флеш отвечает с 5 тактами ожидания (RM0090, табл. 10). Ускоритель ART — очередь предвыборки команд и кэш ветвлений — по CoreMark даёт скорость как без ожиданий (RM0090, 3.5.2), но таблицы узлов и опорные векторы читаются как данные и вразброс; насколько вырастут такты на плате, не мерилось.
116а.7 Грабли
SVM на сырых признаках отвечает хуже линейного. Ядро RBF меряет расстояние, и температура в десятках градусов глушит долю энергии в десятых. Без приведения к масштабу тот же SVM верен в 329 случаях из 400 вместо 356 и находит 55 износов из 100 вместо 65. Среднее и разброс считают по обучающей выборке — внутри каждой части кросс-проверки свои, — и увозят в прошивку.
Дерево верно на обучении во всех случаях. Глубина без ограничения: 600 из 600 на обучении и 344 из 400 на проверке. Глубину ограничивают кросс-проверкой или берут лес.
Гиперпараметры подобраны по проверочной выборке. Опыт повторён на 50 проверочных выборках по 400 окон: SVM с лучшими по проверке C и γ показывает на ней в среднем 88,34 %, а на 10 000 окнах, которых никто не видел, — 87,57 %. Выбранный кросс-проверкой — 86,74 % на проверке и 86,95 % на новых: его оценка честная. Завышение невелико — 0,77 пункта против разброса 1,96 пункта от выборки к выборке, — но всегда в одну сторону. Подбор — кросс-проверкой на обучающей выборке, проверка — один раз в конце.
Лес не помещается во флеш. Узлы растут с числом и глубиной деревьев: 100 полных деревьев — 98 616 байт. Глубину ограничивают, число деревьев берут там, где кривая качества вышла на плато.
RBF не успевает за окном. 38 576 тактов на ответ и число опорных векторов, растущее с данными. Сначала пробуют признак, который выпрямляет границу, — как q в 116а.1, — и линейную модель.
Градиентный спуск не сходится. Признаки разного масштаба: шаг, устойчивый для оборотов в тысячах, ничего не делает с остальными.
116а.8 Итоги
- Линейная регрессия: МНК в замкнутом виде, RMSE 2,48 °C на сырых признаках и 1,00 °C с признаком q — до шума датчика; на C — 212 байт и 39 тактов.
- Градиентный спуск: 865 шагов на признаках в масштабе; без масштаба обусловленность 87281598 и 7,86 °C после 10 000 шагов.
- Ridge на 12 примерах с двумя датчиками тока: λ = 0,1 — веса −1,09 и 0,08 вместо −10,84 и 6,62, RMSE 1,16 °C вместо 2,47.
- Метрики редкого класса — полнота, точность и F1; AUC сравнивает модели без выбора порога.
- Линейный SVM — 288 байт и 77 тактов, F1 0,72; RBF — 253 опорных вектора, 7492 байта и 38 576 тактов, F1 0,75.
- Лес из 30 деревьев — F1 0,79, 20 758 байт; бустинг из 100 деревьев глубиной 2 — F1 0,80, 5410 байт и 4767 тактов.
- Ответы C совпали с scikit-learn во всех 400 окнах у всех пяти моделей.
- Масштаб признаков для SVM, ограничение глубины деревьев, подбор гиперпараметров только кросс-проверкой.
Полные исходники
infer116b.c — вывод регрессии и пяти классификаторов на C во float с параметрами из model116b.h.
/* Раздел 116а: регрессия, SVM, дерево, лес и бустинг — вывод на Cortex-M4F во float.
* Параметры — из model116b.h (выгрузил train116b.py). Регрессия берёт воздух, °C,
* ток, А, и обороты, об/мин, и отвечает температурой обмотки, °C. Классификаторы
* берут шесть признаков окна вибрации и отвечают: 0 — исправен, 1 — износ.
* На компьютере main сверяет ответы с scikit-learn (-DML_HOST).
* Проверка — _verify/ml116b_check.py. */
#include <math.h>
#include "model116b.h"
/* 1. Линейная регрессия: признак q = I²/(1 + n/1000), затем скалярное произведение */
float reg_predict(const float x[3])
{
const float f[4] = { x[0], x[1], x[2], x[1] * x[1] / (1.0f + x[2] / 1000.0f) };
float y = REG_B;
for (int i = 0; i < 4; i++)
y += REG_W[i] * (f[i] - REG_MU[i]) * REG_INV_SD[i];
return y;
}
static void standardize(const float x[N_FEAT], float z[N_FEAT])
{
for (int i = 0; i < N_FEAT; i++)
z[i] = (x[i] - MU[i]) * INV_SD[i];
}
/* 2. Линейный SVM: знак скалярного произведения */
int svm_lin_predict(const float x[N_FEAT])
{
float z[N_FEAT], d = LIN_B;
standardize(x, z);
for (int i = 0; i < N_FEAT; i++)
d += LIN_W[i] * z[i];
return d > 0.0f;
}
/* 3. SVM с ядром RBF: сумма по всем опорным векторам */
int svm_rbf_predict(const float x[N_FEAT])
{
float z[N_FEAT], d = RBF_B;
standardize(x, z);
for (int k = 0; k < N_SV; k++) {
const float *sv = &SV[k * N_FEAT];
float r2 = 0.0f;
for (int i = 0; i < N_FEAT; i++) {
float t = z[i] - sv[i];
r2 += t * t;
}
d += SV_ALPHA[k] * expf(-RBF_GAMMA * r2);
}
return d > 0.0f;
}
/* Спуск по таблице узлов: левый потомок — следующий узел, правый — по номеру */
static float walk(const float *thr, const signed char *feat, const unsigned short *right,
unsigned n, const float x[N_FEAT])
{
while (feat[n] >= 0)
n = x[feat[n]] <= thr[n] ? n + 1 : right[n];
return thr[n]; /* у листа в thr лежит его значение */
}
/* 4. Дерево: в листе — доля износа среди обучающих примеров */
int tree_predict(const float x[N_FEAT])
{
return walk(TREE_THR, TREE_FEAT, TREE_RIGHT, 0, x) > 0.5f;
}
/* 5. Случайный лес: средняя доля по деревьям */
int forest_predict(const float x[N_FEAT])
{
float s = 0.0f;
for (int t = 0; t < N_TREES_RF; t++)
s += walk(RF_THR, RF_FEAT, RF_RIGHT, RF_ROOT[t], x);
return s > 0.5f * N_TREES_RF;
}
/* 6. Градиентный бустинг: сумма маленьких деревьев, знак — ответ */
int boost_predict(const float x[N_FEAT])
{
float s = GB_INIT;
for (int t = 0; t < N_TREES_GB; t++)
s += walk(GB_THR, GB_FEAT, GB_RIGHT, GB_ROOT[t], x);
return s >= 0.0f;
}
#ifdef ML_HOST
#include <stdio.h>
int main(void)
{
static const struct {
const char *name;
int (*fn)(const float *);
const unsigned char *sk;
} m[5] = {
{ "lin", svm_lin_predict, SK_LIN }, { "rbf", svm_rbf_predict, SK_RBF }, { "tree", tree_predict, SK_TREE },
{ "rf", forest_predict, SK_RF }, { "gb", boost_predict, SK_GB },
};
double worst = 0.0;
for (int i = 0; i < N_REG_TEST; i++) {
double e = fabs((double)reg_predict(®_TEST_X[3 * i]) - REG_SK[i]);
worst = e > worst ? e : worst;
}
printf("c_reg=%.6f\n", worst);
for (int k = 0; k < 5; k++) {
int same = 0, right = 0;
for (int i = 0; i < N_TEST; i++) {
int p = m[k].fn(&TEST_X[N_FEAT * i]);
same += p == m[k].sk[i];
right += p == TEST_Y[i];
}
printf("c_%s=%d,%d\n", m[k].name, same, right);
}
printf("done=1\n");
return 0;
}
#endif
Дальше: раздел 116б «Как учится нейросеть: нейрон, функции активации, функция потерь, обратное распространение, градиентный спуск, SGD, момент и Adam» — что внутри строки «обучить сеть»: правило цепочки вручную, шаг обучения, Adam и переобучение на numpy с нуля.