 Embedded HandbookПриложения
116б. Как учится нейросеть: нейрон, функции активации, функция потерь, обратное распространение, градиентный спуск, SGD, момент и Adam
В 116.6 перцептрон обучил scikit-learn одной строкой, в 118 — так же, в 119 — TensorFlow. Здесь та строка разобрана изнутри: что считает нейрон, чем меряют ошибку, как правило цепочки даёт градиент каждого веса, чем спуск с моментом и Adam лучше простого шага и почему сеть переобучается. Всё написано на numpy с нуля, без фреймворка, на задаче с двух датчиков насоса. Обученная сеть 2 → 16 → 3 затем уходит в C: байты на F407, команды на ответ в QEMU и сверка ответов C с numpy.
Опоры: numpy 2.3.3 в образе stm-ml:1, скрипт train116c.py —
каждое число раздела из его прогона, повторный прогон даёт те же файлы.
Вывод на C собран gcc 12.2.0 (stm-sys:1) для сверки, armclang 6.24 для
F407 — размеры, arm-none-eabi-gcc 12.2.1 и QEMU 7.2 (stm-arm:1, плата
netduinoplus2 со STM32F405) — счёт команд.
Как это называется в документации
Оригинал Перевод neuron, weight, bias нейрон, вес, смещение activation function функция активации sigmoid, tanh, ReLU сигмоида, гиперболический тангенс, «выпрямитель» max(0, x) forward pass прямой проход: от входа к ответу logits логиты: выходы сети до softmax loss function функция потерь: число «насколько плохо» mean squared error (MSE) средний квадрат ошибки cross-entropy перекрёстная энтропия backpropagation обратное распространение ошибки gradient check проверка градиента конечными разностями learning rate шаг обучения epoch, mini-batch эпоха — проход по всей выборке; пакет — её часть на один шаг stochastic gradient descent (SGD) стохастический градиентный спуск: шаг по пакету momentum момент: шаг копит скорость Adam спуск с моментом и своим масштабом шага у каждого веса Xavier (Glorot), He initialization начальные веса с разбросом по числу входов vanishing gradient затухающий градиент overfitting, regularization переобучение, регуляризация weight decay (L2), dropout, early stopping штраф за большие веса, выключение нейронов, ранняя остановка
116б.1 Нейрон, слой, прямой проход
Задача: центробежный насос, датчик давления на выходе (бар) и расходомер (л/мин). Исправный насос лежит на паспортной кривой P = 4,0 · (1 − (Q/60)²); изношенное колесо при том же расходе даёт меньший напор. Три класса: норма — 92…104 % паспортного напора, износ — 74…88 %, сильный износ или подсос воздуха — 50…66 %. Шум датчика давления — 0,05 бар, расходомера — 0,6 л/мин. Данные синтетические, с фиксированным зерном: 600 примеров для обучения, 300 для подбора и 300 для проверки, по трети на класс. Граница между классами — кривая, прямой её не провести.
Нейрон — взвешенная сумма входов плюс смещение, пропущенная через функцию активации: h = f(w₁x₁ + w₂x₂ + b). Слой из 16 нейронов — это матрица весов 2 × 16: a = W·z + b одним умножением на все нейроны сразу. Прямой проход — слой за слоем от входа к логитам:
    for (int j = 0; j < N_HID; j++) {
        float a = NN_B1[j];
        for (int i = 0; i < N_IN; i++)
            a += z[i] * NN_W1[i * N_HID + j];          /* a = W·z + b */
        h[j] = a > 0.0f ? a : 0.0f;                    /* ReLU */
    }
Сеть 2 → 16 → 3 — 99 параметров и 80 умножений на ответ. Без функции активации два слоя схлопываются в один: произведение матриц — снова матрица, и сеть остаётся прямой границей.
Функции активации. Ступенька (0 или 1) — самое прямое «сработал или нет», но её производная везде равна нулю — градиента нет, учить нечем. Сигмоида 1/(1 + e⁻ˣ) гладкая, но её производная не больше 0,25, а при x = 4 уже 0,0177. У tanh наибольшая производная 1, при x = 4 — 0,0013. ReLU = max(0, x): производная 1 при любом x > 0 и одно сравнение на приборе. Та же сеть 2 → 16 → 3, Adam, 60 эпох, разные активации в скрытом слое:
| Скрытый слой | Потери на обучении | Верно из 300 |
|---|---|---|
| нет (сразу выход, прямые границы) | 0,4123 | 260 |
| сигмоида | 0,1900 | 276 |
| tanh | 0,0837 | 287 |
| ReLU | 0,0605 | 290 |
116б.2 Функция потерь: MSE для числа, перекрёстная энтропия для классов
Чтобы спускаться, нужно одно число «насколько плохо» и её производная по каждому выходу.
Число — средний квадрат ошибки. L = среднее (ŷ − y)², производная по выходу — 2(ŷ − y)/N. Пример: оценить, сколько процентов паспортного напора даёт насос. Линейная модель 2 → 1 ошибается на проверке в среднем (корень из среднего квадрата) на 6,85 %, в худшей точке — на 22,38 %; сеть 2 → 16 → 1 — на 3,04 % и 12,13 %: кривую паспортной характеристики прямая не повторит.
Класс — softmax и перекрёстная энтропия. Три логита переводятся в вероятности pᵢ = e^sᵢ / Σ e^sⱼ, потери — минус логарифм вероятности верного класса. Логиты (2; 1; 0,1) дают вероятности 0,659; 0,242; 0,099: если верен первый класс, потери 0,417, если третий — 2,317. Сеть, которая отвечает «все три равны», имеет потери ln 3 = 1,0986; наша сеть со случайными начальными весами — 1,4452. Производная по логитам у пары softmax + перекрёстная энтропия простая — p − y:
def ce_loss(s, y):
    """Перекрёстная энтропия после softmax и её градиент по логитам: (p − y) / N."""
    lp = log_softmax(s)
    n = len(y)
    g = np.exp(lp)
    g[np.arange(n), y] -= 1.0
    return -lp[np.arange(n), y].mean(), g / n
116б.3 Обратное распространение: правило цепочки вручную
Для двухслойной сети a₁ = W₁z + b₁, h = f(a₁), s = W₂h + b₂ производные идут от выхода к входу; каждое звено — одна производная:
- по логитам: δ₂ = (p − y)/N;
- по весам выходного слоя: ∂L/∂W₂ = hᵀ·δ₂, по смещению — сумма δ₂;
- в скрытый слой: ∂L/∂h = δ₂·W₂ᵀ;
- через активацию: δ₁ = ∂L/∂h ⊙ f′(a₁) — у ReLU это просто обнулить там, где a₁ ≤ 0;
- по весам первого слоя: ∂L/∂W₁ = zᵀ·δ₁.
    for i in range(len(P) - 1, -1, -1):
        h_in, a, hn, mask = cache[i]
        if i < len(P) - 1:                        # через активацию: dL/da = dL/dh · f'(a)
            if mask is not None:
                g = g * mask
            if not bug:
                g = g * df(a, hn if mask is None else ACT[act][0](a))
        W = P[i][0]
        grads[i] = [h_in.T @ g + 2.0 * l2 * W, g.sum(axis=0)]
        g = g @ W.T                               # в предыдущий слой
Свой обратный проход надо проверять. Конечные разности: сдвинуть один вес на ±10⁻⁵, посчитать потери дважды, разность поделить на 2·10⁻⁵ — и так для каждого веса. На 5 примерах у сети 2 → 4 → 3 (27 параметров) наибольшая относительная разница с формулами — 2,4·10⁻¹⁰, у сети 2 → 4 → 1 с MSE (17 параметров) — 7,1·10⁻¹¹. Нарочно забытая производная ReLU даёт 1,0: проверка ловит ошибку сразу. На приборе обратного прохода нет — он нужен только при обучении.
116б.4 Градиентный спуск: шаг, SGD, момент и Adam
Шаг спуска: w ← w − η·∂L/∂w. Главное здесь — шаг обучения η. Спуск по всей выборке (один шаг на эпоху), 300 эпох, одна и та же начальная точка:
| Шаг η | Потери после 300 эпох | Верно из 300 | Наибольшие потери по пути |
|---|---|---|---|
| 0,01 | 0,6497 | 230 | 1,5437 |
| 0,1 | 0,2108 | 288 | 1,3793 |
| 1 | 0,0707 | 289 | 1,1649 |
| 3 | 0,0744 | 282 | 2,7296 |
| 10 | 1,3947 | 100 | 2,2 млн |
Мал — медленно: при 0,01 сеть за 300 эпох не дошла и до 0,6. Велик — скачки: при 3 потери по пути выросли до 2,73, при 10 — до миллионов, и сеть свалилась в один класс (100 из 300 — ровно треть).
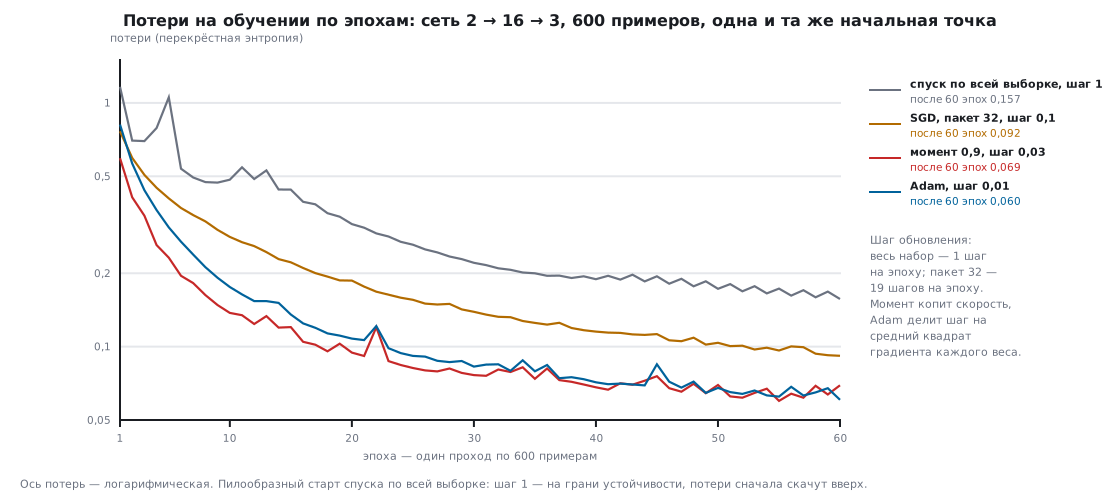
SGD. Градиент по пакету из 32 примеров — шумная, но дешёвая оценка полного: шагов на эпоху 19 вместо 1. Момент копит скорость: v ← 0,9·v + g, w ← w − η·v — в устойчивом направлении шаг растёт, поперёк колебаний гасится. Adam ведёт два средних — градиента и его квадрата — и делит одно на корень другого: у каждого веса свой масштаб шага.
                    elif opt == "momentum":
                        st[li][q] = 0.9 * st[li][q] + G[li][q]
                        step = lr * st[li][q]
                    else:                                       # Adam: β1 0,9, β2 0,999
                        st[li][q] = 0.9 * st[li][q] + 0.1 * G[li][q]
                        st2[li][q] = 0.999 * st2[li][q] + 0.001 * G[li][q] ** 2
                        mh = st[li][q] / (1 - 0.9 ** t)
                        vh = st2[li][q] / (1 - 0.999 ** t)
                        step = lr * mh / (np.sqrt(vh) + 1e-8)
| Способ | Шаг | Потери после 10 эпох | После 60 эпох | Эпох до потерь < 0,2 | Верно из 300 |
|---|---|---|---|---|---|
| спуск по всей выборке | 1 | 0,4840 | 0,1569 | 35 | 286 |
| SGD, пакет 32 | 0,1 | 0,2819 | 0,0917 | 18 | 289 |
| момент 0,9, пакет 32 | 0,03 | 0,1375 | 0,0694 | 6 | 288 |
| Adam, пакет 32 | 0,01 | 0,1757 | 0,0605 | 9 | 290 |
Adam дал наименьшие потери за 60 эпох и лучший ответ на проверке; тот же Adam с шагом 0,01 обучает сеть в 119, а в разделе 118а та же механика спрятана в Keras.
116б.5 Инициализация, затухающий градиент, переобучение
Не нулями. Все веса нули — у ReLU нет ни выхода, ни градиента: потери остаются 1,0986 = ln 3, сеть отвечает одним классом (100 из 300). Все веса одинаковые (0,5) — 16 нейронов получают одинаковый градиент и остаются копиями одного: после обучения различных нейронов 1, верно 256 из 300. Случайность ломает эту симметрию, а разброс подбирают по числу входов: Xavier — σ = √(2/(n_вх + n_вых)) для сигмоиды и tanh, He — σ = √(2/n_вх) для ReLU.
Глубокая сеть. Десять скрытых слоёв по 32 нейрона, начальные веса, одна оценка градиента на 600 примерах:
| Сеть | Разброс сигнала: 1-й слой / 10-й | Градиент весов: 1-й слой / выходной |
|---|---|---|
| сигмоида, Xavier | 7,55·10⁻² / 1,28·10⁻¹ | 8,43·10⁻⁸ / 7,30·10⁻¹ |
| tanh, Xavier | 2,74·10⁻¹ / 1,54·10⁻¹ | 1,07·10⁻¹ / 2,61·10⁻¹ |
| ReLU, He | 7,92·10⁻¹ / 1,34 | 5,04·10⁻¹ / 3,48 |
| ReLU, σ = 1 | 7,92·10⁻¹ / 3,51·10⁵ | 5,21·10⁵ / 1,61·10⁶ |
| ReLU, σ = 0,01 | 7,92·10⁻³ / 3,51·10⁻¹⁵ | 2,62·10⁻¹⁵ / 2,67·10⁻¹⁵ |
У сигмоиды градиент первого слоя в миллионы раз меньше выходного: на каждом слое он умножается на производную сигмоиды, а она не больше 0,25. Это затухающий градиент. SGD, шаг 0,1, 30 эпох: сеть на сигмоидах сдвинула потери с 1,1215 только до 1,1017 и отвечает одним классом (100 из 300), та же сеть на ReLU с He — с 0,8048 до 0,1448, верно 279. Слишком крупные веса раздувают сигнал, слишком мелкие — гасят до нуля.
Переобучение. Мало данных и большая сеть: 60 примеров (по 20 на класс), сеть 2 → 64 → 64 → 3 (4547 параметров), Adam, 1500 эпох. Сеть выучивает все 60 примеров, потери на них — ноль, а на проверке хуже, чем у маленькой сети на 600 примерах (292, 116б.6):
| Способ | Верно на обучении из 60 | Верно на проверке из 300 | Потери обучения | Потери проверки |
|---|---|---|---|---|
| без регуляризации | 60 | 278 | 0,0000 | 0,3618 |
| L2, λ = 0,003 | 60 | 283 | 0,0459 | 0,1449 |
| dropout 0,3 | 60 | 276 | 0,0005 | 0,3606 |
| ранняя остановка (эпоха 95) | 60 | 276 | 0,0367 | 0,1567 |
L2 штрафует большие веса и даёт лучший результат. Ранняя остановка берёт веса той эпохи, где потери на подборочной выборке (300 примеров, в обучении не участвуют) были наименьшими: потери проверки упали с 0,3618 до 0,1567. Dropout здесь не помог (276 против 278): приём регуляризации проверяют на подборочной выборке, как любой другой. Лучшее лекарство — больше данных.
116б.6 На Cortex-M4: вывод на C, байты и команды
Итоговая сеть 2 → 16 → 3: Adam, шаг 0,01, пакет 32, до 200 эпох, ранняя остановка выбрала эпоху 171. Верно 594 из 600 на обучении, 294 из 300 на подборе и 292 из 300 на проверке. Сильный износ узнан во всех 100 случаях; норму сеть 6 раз приняла за износ, износ — один раз за норму и один раз за сильный износ.
На приборе softmax для решения не нужен: номер наибольшего логита тот же. Вероятности считают, только когда нужна уверенность, и тогда сначала вычитают наибольший логит:
    for (int c = 0; c < N_OUT; c++) {
        p[c] = expf(s[c] - m);
        sum += p[c];
    }
Сверка. Веса, среднее и разброс входов выгружены в model116c.h
как float. Тот же infer116c.c, собранный gcc на компьютере, дал на
300 проверочных примерах те же классы, что numpy, в 300 случаях из 300;
логиты разошлись не больше чем на 1,1·10⁻⁵ (C считает во float,
numpy — в double), вероятности — на 1,9·10⁻⁶. В QEMU на Cortex-M4F —
тоже 300 из 300.
Байты на F407 (armclang, -mcpu=cortex-m4 -mfpu=fpv4-sp-d16):
-O2 |
-Os |
|
|---|---|---|
nn_forward |
1196 байт | 228 байт |
nn_classify |
56 байт | 54 байта |
nn_probs |
132 байта | 116 байт |
| код объекта с литералами | 1588 байт | 498 байт |
| таблицы констант | 216 байт | 344 байта |
Весов и чисел нормировки 103, это 412 байт флеш-памяти. С -O2
компилятор развернул циклы — в nn_forward 64 команды VMUL.F32
подряд, часть весов ушла в пул литералов внутри кода; с -Os циклы
остались циклами. ОЗУ — только массивы на стеке: z, h и s, 21 число.
Команды на ответ — QEMU netduinoplus2 с -icount, отсчёты SysTick,
код arm-none-eabi-gcc -O2: nn_classify — 677 команд на вызов вместе
с циклом опыта, nn_probs с expf — 903. Это команды, не такты: тактов
на кристалле больше, так что время ниже — нижняя граница. При 168 МГц —
не меньше 4,0 мкс на ответ.
Какие ещё бывают сети — коротко, подробности в своих разделах:
| Архитектура | Что делает | На микроконтроллере | Где в справочнике |
|---|---|---|---|
| плотная (полносвязная) | каждый вход связан с каждым нейроном | признаки с датчиков: единицы и десятки входов | 116.6, 118, этот раздел; Keras — раздел 118а; int8 — 119 |
| свёрточная | один маленький фильтр скользит по сигналу или картинке | спектрограммы звука, изображения | 121б (звук), 121в (камера с NPU) |
| рекуррентная | хранит состояние между шагами ряда | длинные ряды; в этой части их заменяет окно с признаками (117) | — |
| автокодировщик | сжимает и восстанавливает вход; ошибка восстановления — мера «не такой» | поиск аномалий, учится только на норме | 120 (64 → 8 → 64) |
| трансформер | каждый шаг ряда смотрит на все остальные | большие модели; в этой части не используется | — |
116б.7 Грабли
Сеть не учится: потери застыли около 1. Вход не нормирован: расход в десятках л/мин, давление в единицах бар. Без нормировки SGD за 60 эпох: шаг 0,1 — потери 1,0295 и 125 верных из 300, шаг 0,01 — 0,9996 и 146, шаг 0,001 — 2,0561 и 100. С нормировкой тот же SGD доходит до 0,0917 и 289. Среднее и разброс — часть модели, их везут в прошивку вместе с весами.
В вероятностях NaN. expf во float переполняется уже на 89
(e⁸⁸ ещё конечна). Логиты (1000; 999; 0) в лоб дают два NaN из трёх,
после вычитания наибольшего — 0,7311; 0,2689; 0,0000. В numpy так же:
log_softmax начинается с s - s.max(...).
Потери скачут вверх, потом NaN. Шаг обучения велик: при 10 — миллионы (116б.4). Уменьшать шаг, пока кривая не станет гладкой, или взять Adam с 0,01.
SGD учится хуже, чем спуск по всей выборке. Данные не перемешаны: примеры лежат по классам, и пакеты подряд тянут сеть то к одному классу, то к другому. Без перемешивания за 60 эпох — потери 0,1475 и 272 верных, с перемешиванием каждую эпоху — 0,0917 и 289.
Свой обратный проход «почти работает». Ошибку в формуле градиента на глаз не видно: потери считает прямой проход, а он верен. Проверка конечными разностями показывает 1,0 вместо 10⁻¹⁰ — делать её на каждой новой формуле.
Все нейроны одинаковые. Веса начаты нулями или одной константой — симметрию ломает только случайная инициализация (116б.5).
116б.8 Итоги
- Нейрон — взвешенная сумма плюс смещение и активация; слой — умножение на матрицу. Сеть 2 → 16 → 3 — 99 параметров, 80 умножений.
- ReLU: производная 1 на всей положительной половине; у сигмоиды не больше 0,25. На задаче насоса ReLU — 290 верных из 300, сигмоида — 276, без скрытого слоя — 260.
- Потери: MSE для числа (сеть 3,04 % против 6,85 % у прямой), перекрёстная энтропия с softmax для классов, градиент по логитам — p − y.
- Обратное распространение — правило цепочки от выхода к входу; конечные разности сходятся с формулами до 2,4·10⁻¹⁰, забытая производная даёт 1,0.
- Шаг 0,01 — медленно, 10 — расходимость. За 60 эпох: спуск по всей выборке — 0,1569, SGD — 0,0917, момент — 0,0694, Adam — 0,0605.
- Нули в весах — сеть не учится; сигмоида в 10 слоях гасит градиент первого слоя до 8,43·10⁻⁸.
- 60 примеров на сеть с 4547 параметрами — переобучение; L2 подняло проверку с 278 до 283, лучшее — 600 примеров и маленькая сеть: 292.
- На F407: 412 байт весов,
nn_forward— 228 байт с-Os; 677 команд на ответ, не меньше 4,0 мкс при 168 МГц; ответы C совпали с numpy в 300 случаях из 300.
Полные исходники
infer116c.c — вывод сети на C во float с весами из model116c.h.
/* Раздел 116б: обученная на numpy сеть 2 → 16 → 3 — вывод на Cortex-M4F во float.
 * Веса — из model116c.h (выгрузил train116c.py). Вход — расход, л/мин, и давление, бар,
 * ответ — класс: 0 — норма, 1 — износ колеса, 2 — сильный износ или подсос воздуха.
 * На компьютере (-DML_HOST) main сверяет классы, логиты и вероятности с numpy
 * на проверочной выборке. Проверка — _verify/ml116c_check.py. */
#include <math.h>
#include <stdint.h>

#if defined(ML_HOST) && !defined(ML_DATA)
#define ML_DATA
#endif
#include "model116c.h"

/* Прямой проход: нормировка, скрытый слой с ReLU, выходной слой — логиты */
void nn_forward(const float x[N_IN], float s[N_OUT])
{
    float z[N_IN], h[N_HID];
    for (int i = 0; i < N_IN; i++)
        z[i] = (x[i] - NN_MU[i]) / NN_SD[i];           /* среднее и разброс — часть модели */
    for (int j = 0; j < N_HID; j++) {
        float a = NN_B1[j];
        for (int i = 0; i < N_IN; i++)
            a += z[i] * NN_W1[i * N_HID + j];          /* a = W·z + b */
        h[j] = a > 0.0f ? a : 0.0f;                    /* ReLU */
    }
    for (int c = 0; c < N_OUT; c++) {
        float a = NN_B2[c];
        for (int j = 0; j < N_HID; j++)
            a += h[j] * NN_W2[j * N_OUT + c];
        s[c] = a;
    }
}

/* Класс — номер наибольшего логита: softmax его не меняет и на приборе не нужен */
int nn_classify(const float x[N_IN])
{
    float s[N_OUT];
    nn_forward(x, s);
    int k = 0;
    for (int c = 1; c < N_OUT; c++)
        if (s[c] > s[k])
            k = c;
    return k;
}

/* Вероятности — когда нужна уверенность: сначала вычесть наибольший логит, иначе expf переполнится */
void nn_probs(const float x[N_IN], float p[N_OUT])
{
    float s[N_OUT], m, sum = 0.0f;
    nn_forward(x, s);
    m = s[0];
    for (int c = 1; c < N_OUT; c++)
        m = s[c] > m ? s[c] : m;
    for (int c = 0; c < N_OUT; c++) {
        p[c] = expf(s[c] - m);
        sum += p[c];
    }
    for (int c = 0; c < N_OUT; c++)
        p[c] /= sum;
}

#ifdef ML_HOST
#include <stdio.h>

int main(void)
{
    int same = 0, right = 0;
    float dl = 0.0f, dp = 0.0f;
    for (int i = 0; i < N_TEST; i++) {
        float s[N_OUT], p[N_OUT];
        int k = nn_classify(&TEST_X[N_IN * i]);
        nn_forward(&TEST_X[N_IN * i], s);
        nn_probs(&TEST_X[N_IN * i], p);
        same += k == NP_CLASS[i];
        right += k == TEST_Y[i];
        for (int c = 0; c < N_OUT; c++) {
            float e = fabsf(s[c] - NP_LOGIT[N_OUT * i + c]), f = fabsf(p[c] - NP_PROB[N_OUT * i + c]);
            dl = e > dl ? e : dl;
            dp = f > dp ? f : dp;
        }
    }
    printf("agree=%d,%d\nright=%d\n", same, N_TEST, right);
    printf("max_dlogit=%.1e\nmax_dprob=%.1e\n", (double)dl, (double)dp);
    return 0;
}
#endif
Дальше: раздел 117 «Данные с датчика: окна, признаки, CMSIS-DSP» — откуда берутся СКЗ и частота пика.