 Embedded HandbookПриложения
116. Типовые подходы и алгоритмы: от порога до маленькой нейросети
На микроконтроллере «машинное обучение» почти всегда значит одно: по
нескольким числам с датчика решить, в каком состоянии объект. Для этого
есть пять типовых подходов — порог, логистическая регрессия, дерево
решений, k ближайших соседей и маленькая нейросеть. Раздел решает ими одну
задачу — состояние мотора по вибрации — и сравнивает их по точности,
памяти, числу умножений и размеру кода на F407. Обучение — scikit-learn
в образе stm-ml:1, вывод — свой код на C, и его ответы совпадают
с scikit-learn на всей проверочной выборке.
TinyML в целом — раздел 85, признаки из сигнала — раздел 117, обучение — раздел 118.
Как это называется в документации
Оригинал Перевод feature признак: число, по которому решают class, label класс, метка training set, test set обучающая и проверочная выборки accuracy доля верных ответов inference вывод: ответ обученной модели threshold rule порог, правило logistic regression логистическая регрессия decision tree дерево решений k-nearest neighbours (k-NN) k ближайших соседей multilayer perceptron (MLP) многослойный перцептрон ReLU «выпрямитель»: max(0, x) standardization приведение признака к среднему 0 и разбросу 1 multiply-accumulate (MAC) умножение со сложением
116.1 Задача и данные
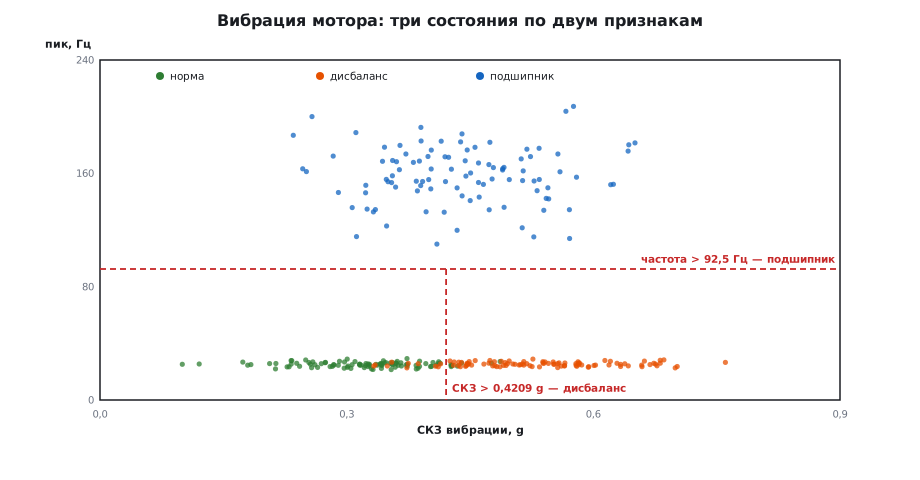
Два признака: СКЗ вибрации, g, и частота пика спектра, Гц. Три класса: норма, дисбаланс — пик на частоте вращения 25 Гц при вибрации сильнее нормы, — и износ подшипника с пиком около 160 Гц. Данные синтетические, с фиксированным зерном: 600 примеров для обучения и 300 для проверки, по трети на класс. Норма и дисбаланс перекрываются по СКЗ — ошибаться будут все пять подходов, вопрос в том, насколько.
116.2 Порог: два сравнения
int rule_predict(const float x[2])
{
    if (x[1] > F_CUT)
        return 2;
    return x[0] > R_CUT ? 1 : 0;
}
Частота пика выше 92,5 Гц — подшипник; иначе СКЗ выше 0,4209 g — дисбаланс. Порог по СКЗ — середина между средними нормы и дисбаланса на обучающей выборке. Правило верно в 282 случаях из 300 — лучше всех остальных подходов, — хранит 2 числа и не умножает ни разу.
116.3 Логистическая регрессия
int logreg_predict(const float x[2])
{
    float z[2], s[3];
    standardize(x, z);
    for (int c = 0; c < 3; c++)
        s[c] = LR_W[c * 2] * z[0] + LR_W[c * 2 + 1] * z[1] + LR_B[c];
    return argmax3(s);
}
Каждому классу — взвешенная сумма признаков, ответ — наибольшая. Признаки сначала приводят к одному масштабу: иначе частота в сотни герц задавила бы СКЗ в доли g. 13 чисел, 6 умножений, 281 верный ответ из 300.
116.4 Дерево решений
int tree_predict(const float x[2])
{
    int n = 0;
    while (TREE_LEFT[n] >= 0)
        n = x[TREE_FEAT[n]] <= TREE_THR[n] ? TREE_LEFT[n] : TREE_RIGHT[n];
    return TREE_CLASS[n];
}
Дерево глубиной 3 — 9 узлов: не больше трёх сравнений, ни одного умножения. Порог из 116.2 — то же дерево, только построенное головой. Обученное дерево верно в 279 случаях из 300: оно подогнало пороги под обучающую выборку чуть точнее, чем нужно.
116.5 k ближайших соседей
k-NN не обучается вовсе: он помнит всю обучающую выборку и отвечает голосованием пяти ближайших примеров. Отсюда цена — 1204 числа в памяти и 1200 умножений на каждый ответ, а верных ответов — 278 из 300.
    for (int i = 0; i < N_TRAIN; i++) {
        float dx = z[0] - KNN_X[2 * i], dy = z[1] - KNN_X[2 * i + 1];
        float d = dx * dx + dy * dy;
116.6 Маленькая нейросеть
Перцептрон 2 → 8 → 3: скрытый слой из 8 нейронов с ReLU и выходной слой.
    for (int j = 0; j < N_HIDDEN; j++) {
        float a = MLP_B1[j] + z[0] * MLP_W1[j] + z[1] * MLP_W1[N_HIDDEN + j];
        h[j] = a > 0 ? a : 0;
    }
55 чисел, 40 умножений, 281 верный ответ из 300 — столько же, сколько у логистической регрессии. Нейросеть выигрывает, когда граница между классами кривая и признаков много; здесь граница — две прямые, и сети нечего добавить.
116.7 Где ошибаются: матрица ошибок
Одно число «верно из 300» прячет главное — какие классы модель путает. Матрица ошибок раскладывает ответы по парам «было — сказала модель». Здесь у всех пяти подходов картина одна: подшипник все пять узнают в 100 случаях из 100 — его выдаёт частота пика, — а все ошибки приходятся на пару «норма — дисбаланс», которые перекрываются по СКЗ.
| Подход | Норму приняли за дисбаланс | Дисбаланс приняли за норму |
|---|---|---|
| Порог | 8 | 10 |
| Логистическая регрессия | 11 | 8 |
| Дерево глубиной 3 | 2 | 19 |
| k ближайших | 10 | 12 |
| Перцептрон | 11 | 8 |
Дерево ошибается несимметрично: почти не поднимает ложную тревогу, зато пропускает 19 дисбалансов из 100. Для прибора это разные ошибки: ложная тревога стоит вызова мастера, пропущенный дисбаланс — подшипника через месяц. Какую ошибку терпеть, решает задача, а не точность; порог сдвигают в нужную сторону.
116.8 Кросс-проверка: разница в пределах случайности
Проверочная выборка — одна из многих возможных, и 282 против 278 может оказаться везением. Кросс-проверка делит обучающую выборку на 5 частей по 120 примеров, по очереди проверяет на каждой, обучаясь на остальных. Сумма по пяти частям: регрессия — 547 из 600, k ближайших и перцептрон — по 546, дерево и порог — по 541. А внутри одной модели точность гуляет от части к части: у регрессии от 105 до 113 из 120. Разница между подходами на проверочной выборке — от 1 до 4 примеров из 300, то есть меньше этого разброса. Вывод честный: на этой задаче все пять подходов равны, и выбирают по цене, а не по точности.
116.9 Сколько нужно данных
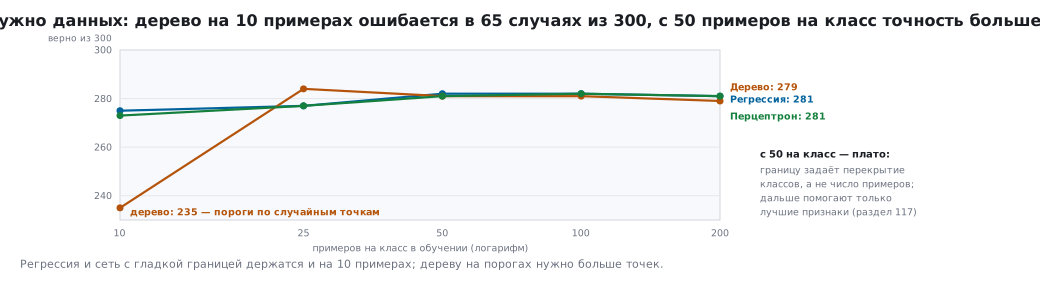
Те же модели, обученные на первых 10, 25, 50, 100 и 200 примерах каждого класса, и та же проверочная выборка из 300:
| Примеров на класс | Регрессия | Дерево | Перцептрон |
|---|---|---|---|
| 10 | 275 | 235 | 273 |
| 25 | 277 | 284 | 277 |
| 50 | 282 | 281 | 281 |
| 100 | 282 | 281 | 282 |
| 200 | 281 | 279 | 281 |
На 10 примерах дерево ставит пороги по случайным точкам и ошибается в 65 случаях, а регрессия и сеть, у которых граница гладкая, держатся. С 50 примеров на класс точность больше не растёт: границу между нормой и дисбалансом определяет перекрытие классов, а не число примеров. Больше данных помогает, пока модель не упёрлась в сами данные; дальше помогают только лучшие признаки — раздел 117.
116.10 Сводка
| Подход | Верно из 300 | Параметров | Умножений | Код на F407 |
|---|---|---|---|---|
| Порог | 282 | 2 | 0 | 48 байт |
| Логистическая регрессия | 281 | 13 | 6 | 176 байт |
| Дерево глубиной 3 | 279 | 9 узлов | 0 | 88 байт |
| k ближайших, k = 5 | 278 | 1204 | 1200 | 808 байт |
| Перцептрон 2 → 8 → 3 | 281 | 55 | 40 | 760 байт |
Ответы функций на C совпали с ответами scikit-learn во всех 300 случаях у каждой из пяти моделей. Выбирать начинают с порога или дерева: они понятны, их можно проверить глазами, и они почти ничего не стоят. К нейросети переходят, когда признаков много и простая граница не находится. k-NN на микроконтроллере почти всегда плох: память и время растут вместе с обучающей выборкой.
116.11 Грабли
Точность на обучающей выборке 100 %, на проверочной — хуже порога. Модель запомнила обучающие примеры. Точность считают только на данных, которых модель не видела.
Модель на плате отвечает не так, как на компьютере. Признаки не приведены к масштабу обучения: среднее и разброс надо увезти в прошивку вместе с весами.
k-NN не помещается в ОЗУ. Он хранит всю обучающую выборку.
Нейросеть «лучше», а в поле ошибается. Синтетика и лабораторные данные не похожи на настоящий мотор; сначала собирают данные с объекта (раздел 117).
116.12 Итоги
- Пять подходов на одной задаче: порог — 282 верных из 300, регрессия и перцептрон — 281, дерево — 279, k-NN — 278.
- Все ошибки — пара «норма — дисбаланс»; подшипник узнают в 100 случаях из 100. Дерево пропускает 19 дисбалансов из 100.
- Кросс-проверка: разброс от части к части больше разницы между подходами — выбирать по цене.
- С 50 примеров на класс точность не растёт; на 10 дерево падает до 235.
- Цена разная на порядки: порог — 2 числа и 48 байт кода, k-NN — 1204 числа и 1200 умножений на ответ.
- Начинать с порога и дерева, нейросеть — когда признаков много.
- Среднее и разброс признаков — часть модели.
Полные исходники
infer116.c — вывод пяти моделей на C во float с параметрами из model116.h.
/* Раздел 116: пять моделей — одна задача, вывод на Cortex-M4F во float.
 * Параметры — из model116.h (выгрузил train116.py). На плате каждая функция
 * берёт два признака — СКЗ, g, и частоту пика, Гц — и отвечает классом:
 * 0 — норма, 1 — дисбаланс, 2 — подшипник. На компьютере main сверяет
 * ответы с scikit-learn на проверочной выборке (-DML_HOST).
 * Проверка — _verify/ml116_check.py. */
#include <stdint.h>

#include "model116.h"

/* 1. Порог: два сравнения, ни одного умножения */
int rule_predict(const float x[2])
{
    if (x[1] > F_CUT)
        return 2;
    return x[0] > R_CUT ? 1 : 0;
}

static void standardize(const float x[2], float z[2])
{
    z[0] = (x[0] - MU[0]) / SD[0];
    z[1] = (x[1] - MU[1]) / SD[1];
}

static int argmax3(const float s[3])
{
    int k = 0;
    for (int i = 1; i < 3; i++)
        if (s[i] > s[k])
            k = i;
    return k;
}

/* 2. Логистическая регрессия: три взвешенные суммы, класс — наибольшая */
int logreg_predict(const float x[2])
{
    float z[2], s[3];
    standardize(x, z);
    for (int c = 0; c < 3; c++)
        s[c] = LR_W[c * 2] * z[0] + LR_W[c * 2 + 1] * z[1] + LR_B[c];
    return argmax3(s);
}

/* 3. Дерево решений: спуск по узлам, одно сравнение на уровень */
int tree_predict(const float x[2])
{
    int n = 0;
    while (TREE_LEFT[n] >= 0)
        n = x[TREE_FEAT[n]] <= TREE_THR[n] ? TREE_LEFT[n] : TREE_RIGHT[n];
    return TREE_CLASS[n];
}

/* 4. k ближайших соседей, k = 5: расстояние до каждого обучающего примера */
int knn_predict(const float x[2])
{
    float z[2], best_d[5];
    int best_y[5];
    standardize(x, z);
    for (int i = 0; i < 5; i++) {
        best_d[i] = 3.4e38f;
        best_y[i] = 0;
    }
    for (int i = 0; i < N_TRAIN; i++) {
        float dx = z[0] - KNN_X[2 * i], dy = z[1] - KNN_X[2 * i + 1];
        float d = dx * dx + dy * dy;
        if (d >= best_d[4])
            continue;
        int j = 4;                      /* вставка в отсортированные пять лучших */
        while (j > 0 && best_d[j - 1] > d) {
            best_d[j] = best_d[j - 1];
            best_y[j] = best_y[j - 1];
            j--;
        }
        best_d[j] = d;
        best_y[j] = KNN_Y[i];
    }
    float votes[3] = { 0, 0, 0 };
    for (int i = 0; i < 5; i++)
        votes[best_y[i]] += 1.0f;
    return argmax3(votes);
}

/* 5. Перцептрон 2 → 8 → 3: скрытый слой с ReLU и выходной слой */
int mlp_predict(const float x[2])
{
    float z[2], h[N_HIDDEN], s[3];
    standardize(x, z);
    for (int j = 0; j < N_HIDDEN; j++) {
        float a = MLP_B1[j] + z[0] * MLP_W1[j] + z[1] * MLP_W1[N_HIDDEN + j];
        h[j] = a > 0 ? a : 0;
    }
    for (int c = 0; c < 3; c++) {
        float a = MLP_B2[c];
        for (int j = 0; j < N_HIDDEN; j++)
            a += h[j] * MLP_W2[j * 3 + c];
        s[c] = a;
    }
    return argmax3(s);
}

#ifdef ML_HOST
#include <stdio.h>

int main(void)
{
    static const struct {
        const char *name;
        int (*fn)(const float *);
        const unsigned char *sk;
    } m[5] = {
        { "rule", rule_predict, SK_RULE }, { "logreg", logreg_predict, SK_LOGREG },
        { "tree", tree_predict, SK_TREE }, { "knn", knn_predict, SK_KNN }, { "mlp", mlp_predict, SK_MLP },
    };
    for (int k = 0; k < 5; k++) {
        int same = 0, right = 0;
        for (int i = 0; i < N_TEST; i++) {
            int p = m[k].fn(&TEST_X[2 * i]);
            same += p == m[k].sk[i];
            right += p == TEST_Y[i];
        }
        printf("c_%s=%d,%d\n", m[k].name, same, right);
    }
    printf("done=1\n");
    return 0;
}
#endif
Дальше: раздел 117 «Данные с датчика: окна, признаки, CMSIS-DSP» — откуда берутся СКЗ и частота пика.