 Embedded HandbookПриложения
118а. Keras для TinyML: архитектуры под микроконтроллер — плотная, 1D-свёртка, depthwise-separable, маленькая CNN — обучение, метрики и экспорт в .tflite
В разделе 118 модель училась в scikit-learn на четырёх признаках, которые
посчитал человек. Здесь сеть получает само окно с датчика и признаки ищет
сама, а учится она в Keras — части TensorFlow, на которой обучают
большинство моделей для TensorFlow Lite. Раздел проходит путь от массива
отсчётов до файла .tflite: как собрать модель из слоёв, как её учить
и когда остановиться, чем мерить качество, сколько она займёт во
флеш-памяти и ОЗУ и сколько команд потратит Cortex-M4 на один ответ.
Задача одна на все модели — пять жестов с трёхосевого акселерометра, —
и четыре архитектуры решают её по-разному: плотная сеть, одна
1D-свёртка, depthwise-separable и маленькая свёрточная сеть. Обучение
идёт в образе stm-tf:1 — TensorFlow 2.21.0, Keras 3.15.1, numpy 2.3.3 —
и повторяется байт в байт. Вывод тех же моделей написан на C и сверен
с Keras на всех отложенных окнах.
Опоры: что такое TinyML и тензорная арена — раздел 85; подходы от порога до перцептрона — раздел 116; как нейросеть учится (градиент, шаг, эпоха) — раздел 116б; окна и признаки — раздел 117; разбиение по записям — 118.3; квантование в int8, TensorFlow Lite Micro и CMSIS-NN — раздел 119.
Как это называется в документации
Оригинал Перевод layer слой Sequential / functional API последовательная модель / модель из вызовов слоёв Dense (fully connected) полносвязный слой Conv1D, Conv2D свёртка по одной оси (времени) и по двум depthwise separable convolution свёртка по каналам отдельно, затем 1 × 1 pointwise convolution свёртка 1 × 1: смешивает каналы pooling, global average pooling прореживание: максимум или среднее по окну, по всей длине BatchNormalization нормировка по пакету: сдвиг и масштаб каналов Dropout выключение части нейронов при обучении epoch, batch эпоха: один проход по данным; пакет: примеров за шаг loss, optimizer функция потерь, оптимизатор logits выходы до softmax callback обратный вызов: код, который fit зовёт после эпохи early stopping, checkpoint ранняя остановка, сохранение лучших весов learning curve кривая обучения F1 score F1: среднее гармоническое полноты и точности MAC (multiply-accumulate) умножение с накоплением tensor arena тензорная арена: ОЗУ под промежуточные тензоры operator (op) оператор: операция в файле .tflite SavedModel формат сохранения модели TensorFlow seed зерно генератора случайных чисел
118а.1 Задача и данные
Прибор в руке, акселерометр на три оси, 50 отсчётов в секунду. Окно — 64 отсчёта, 1,28 с; отсчёт — в mg, целое, как отдаёт датчик. Пять классов: покой, встряхивание, круг, двойное касание и подъём. Покой — трудный класс: в двух случаях из трёх это не неподвижность, а одиночное касание или лёгкое покачивание в руке, то есть «почти жест».
Данные синтетические. Запись — один участник: свой темп (от 0,8 до 1,25 обычного), своя сила, свой наклон прибора в руке, своё смещение нуля осей до 40 mg и свой шум. 40 участников повторили каждый жест 8 раз — 1600 окон. Разбиение — по участникам, как в 118.3: 22 участника на обучение (880 окон), 6 на подбор (240 окон) и 12 на проверку (480 окон). На проверке — люди, которых модель не видела.
На вход Keras принимает массивы numpy формы «окна × время × оси»:
X = (Xi.astype(np.float32) / np.float32(1000.0))  # вход модели — g
parts = rng.permutation(NPART)
p_tr, p_va, p_te = parts[:22], parts[22:28], parts[28:]
mtr, mva, mte = np.isin(g, p_tr), np.isin(g, p_va), np.isin(g, p_te)
Все 1600 окон во float — 1,2 МБ, и массивов хватает. Когда данные не
помещаются в память, тот же fit принимает tf.data.Dataset, который
читает их с диска пакетами; модель и обучение от этого не меняются.
118а.2 Четыре архитектуры
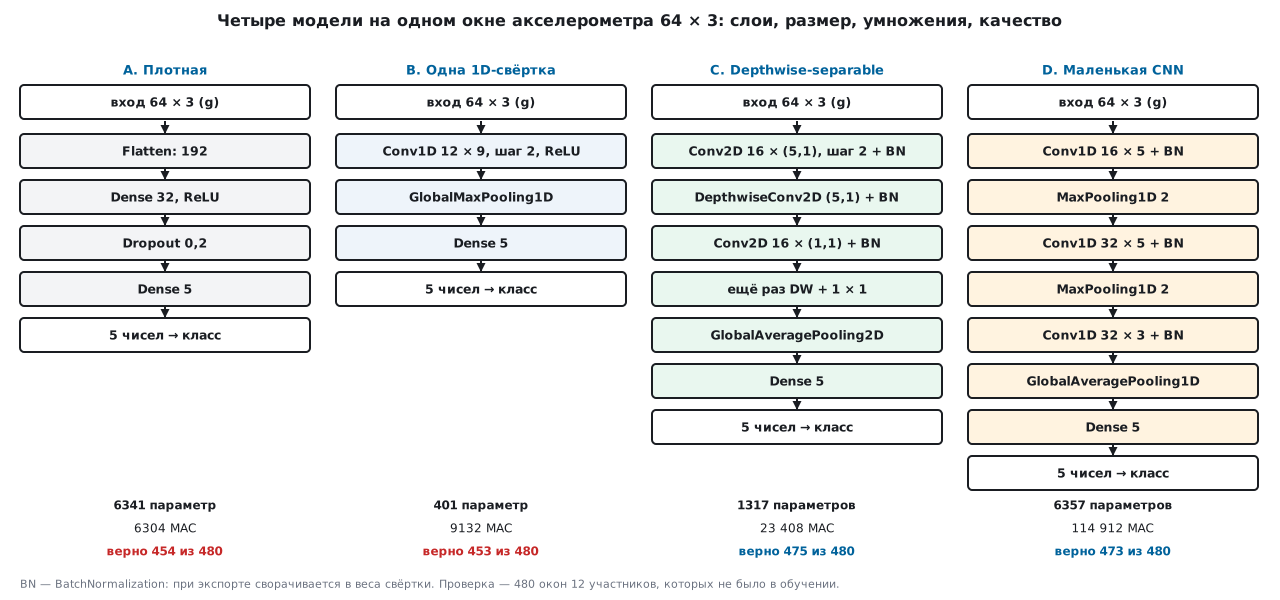
A. Плотная. Окно 64 × 3 вытягивается в строку из 192 чисел, дальше
два полносвязных слоя. Модель собрана последовательно — Sequential,
слой за слоем:
def model_A():
    return tf.keras.Sequential([
        tf.keras.Input((N, 3)),
        L.Flatten(),
        L.Dense(32, activation="relu"),
        L.Dropout(0.2),
        L.Dense(NCLS),
    ], name="A_dense")
Слабость видна из устройства: у каждого из 192 входов свой вес, и касание в начале окна для неё — другой рисунок, чем то же касание в середине.
B. Одна 1D-свёртка. Conv1D(12, 9, strides=2) — 12 фильтров по
9 отсчётов на все три оси, шаг 2. Фильтр ищет свой рисунок в любом
месте окна, а GlobalMaxPooling1D оставляет от каждого фильтра
наибольший отклик: где был рисунок, уже неважно.
C. Depthwise-separable. Обычная свёртка 5 × 16 → 16 каналов —
5 · 16 · 16 = 1280 весов. Разделённая делает то же в два шага:
DepthwiseConv2D — у каждого канала своё ядро из 5 весов, каналы
не смешиваются (80 весов), затем свёртка 1 × 1 смешивает 16 каналов
в 16 (256 весов). Вместе 336 весов — в 3,8 раза меньше. Модель собрана
функциональным API: слой вызывается на выходе предыдущего, и так
можно строить ветвления, которых Sequential не умеет:
def model_C():
    inp = tf.keras.Input((N, 3))
    x = L.Reshape((N, 1, 3))(inp)                 # время × 1 × оси: свёртки 2D с ядром (k, 1)
    x = L.Conv2D(16, (5, 1), strides=(2, 1), use_bias=False)(x)
    x = L.BatchNormalization()(x)
    x = L.ReLU()(x)
    for _ in range(2):
        x = L.DepthwiseConv2D((5, 1), use_bias=False)(x)
        x = L.BatchNormalization()(x)
        x = L.ReLU()(x)
        x = L.Conv2D(16, (1, 1), use_bias=False)(x)
        x = L.BatchNormalization()(x)
        x = L.ReLU()(x)
    x = L.GlobalAveragePooling2D()(x)
    out = L.Dense(NCLS)(x)
    return tf.keras.Model(inp, out, name="C_dscnn")
Свёртки идут без сдвига (use_bias=False): сразу за ними
BatchNormalization, у которой сдвиг свой.
Окно здесь — картинка высотой 64 и шириной 1, оси — каналы. Ядро (5, 1) идёт только по времени, и свёртка 2D считает ровно то же, что 1D. Зачем так — видно в 118а.6: такие слои превращаются в операторы TensorFlow Lite один к одному.
D. Маленькая CNN. Три Conv1D (16, 32 и 32 фильтра) с
MaxPooling1D(2) между ними — каждый пулинг вдвое укорачивает время,
— затем GlobalAveragePooling1D и Dense(5). Самая «тяжёлая» по счёту
модель раздела.
После каждой свёртки в C и D стоит BatchNormalization: при обучении она
приводит выход канала к нулевому среднему и единичному разбросу по
пакету, и сеть учится быстрее и ровнее. При выводе это просто сдвиг
и масштаб канала — их сворачивают в веса свёртки (118а.6). Dropout при
обучении случайно выключает часть нейронов, чтобы сеть не полагалась
на один из них; при выводе он не делает ничего.
118а.3 Обучение: compile, fit и когда остановиться
Все четыре модели учатся одной функцией:
model.compile(optimizer=tf.keras.optimizers.Adam(0.003),
              loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics=["accuracy"])
cb = [tf.keras.callbacks.EarlyStopping(monitor="val_loss", patience=20, restore_best_weights=True),
      tf.keras.callbacks.ModelCheckpoint(TMP + "/best_%s.keras" % tag, monitor="val_loss", save_best_only=True)]
kw = dict(validation_data=val) if isinstance(val, tuple) else dict(validation_split=val)
h = model.fit(Xtr, ytr, epochs=300, batch_size=32, verbose=0, callbacks=cb, shuffle=True, **kw)
Оптимизатор Adam с шагом 0,003; функция потерь — перекрёстная
энтропия для меток-номеров. from_logits=True значит, что последний слой
выдаёт числа до softmax: softmax нужен только для обучения, номер
наибольшего выхода от него не меняется, и в прошивке его не считают.
Пакет — 32 окна, 28 шагов на эпоху.
Обратные вызовы решают, когда остановиться. EarlyStopping следит за
потерями на подборе и останавливает обучение, если они 20 эпох не
улучшались, а restore_best_weights возвращает веса лучшей эпохи.
ModelCheckpoint пишет лучшие веса в файл — если обучение упадёт
или его прервут, они не пропадут. Модель C остановилась на эпохе 181,
лучшая — 161; D — на 45-й, лучшая 25-я.
Кривая обучения модели C — потери и доля верных по эпохам:
| Эпоха | Потери, обучение | Потери, подбор | Верно, обучение | Верно, подбор |
|---|---|---|---|---|
| 1 | 1,304 | 1,608 | 0,545 | 0,200 |
| 5 | 0,308 | 1,990 | 0,959 | 0,200 |
| 10 | 0,093 | 2,055 | 0,986 | 0,287 |
| 20 | 0,025 | 0,120 | 0,998 | 0,962 |
| 40 | 0,004 | 0,029 | 1,000 | 0,992 |
| 160 | 0,000 | 0,014 | 1,000 | 0,992 |
Первые эпохи на подборе 0,200 — ровно один класс из пяти, хотя на
обучении уже 0,959. Так ведёт себя BatchNormalization: на подборе
она работает по накопленным средним, а они в первые сотни шагов ещё не
догнали настоящие. С 20-й эпохи кривые сходятся. После 40-й обучение
знает данные наизусть (потери около нуля), а подбор почти не меняется —
дальше учить незачем.
Подбор — по участникам. У Keras есть короткий путь —
validation_split=0.2: он откладывает на подбор последние 20 % массива.
Последние — значит, до перемешивания. Если окна сложены по классам, как
из пяти файлов подряд, в подбор ушли только окна подъёма — 224 из 224, —
и модель их ни разу не видела: верно 96 из 480, ранняя остановка
сработала на 21-й эпохе, лучшей была первая. Если окна перемешать, в
подборе окажутся те же люди, что в обучении: у плотной модели в подборе
верно 203 из 224, а на новых участниках — 426 из 480; у модели C подбор
показал 224 из 224. Здесь разрыв невелик — повторы одного жеста
различаются больше, чем окна одной записи в 118.3, — но число на подборе
уже не говорит о новых людях. Подбор отделяют так же, как проверку: по
участникам, и передают в validation_data.
Зерно. Начальные веса, порядок примеров и Dropout случайны. Без зерна каждый запуск даёт другую модель:
tf.keras.utils.set_random_seed(seed)
tf.config.experimental.enable_op_determinism()
Первая строка задаёт зерно Python, numpy и TensorFlow, вторая запрещает TensorFlow быстрые, но неповторяемые пути счёта. С ними повторное обучение дало те же веса до бита. Насколько велик разброс, видно на других зёрнах: зёрна 1, 2 и 3 дали 438, 458, 448 верных у A и 477, 478, 479 у C. Разница плотной модели в 20 окон — больше, чем её отрыв от модели B на основном зерне. Сравнивая архитектуры, смотрят на несколько зёрен, а не на один запуск.
118а.4 Метрики: доля верных, матрица ошибок, F1
Проверка — 480 окон 12 участников, один раз в конце:
| Модель | Параметров | MAC | Верно из 480 | % | F1 среднее по классам |
|---|---|---|---|---|---|
| A. Плотная | 6341 | 6304 | 454 | 94,6 | 0,946 |
| B. Одна Conv1D | 401 | 9132 | 453 | 94,4 | 0,944 |
| C. Depthwise-separable | 1317 | 23 408 | 475 | 99,0 | 0,990 |
| D. Маленькая CNN | 6357 | 114 912 | 473 | 98,5 | 0,985 |
Ответ модели — номер наибольшего из пяти выходов:
logit = m.predict(X[mte], verbose=0).astype(np.float32)
p = logit.argmax(1)
Доля верных скрывает, где ошибки. Матрица ошибок модели C (строки — правильный класс, столбцы — ответ):
| Верно / ответ | покой | встряхивание | круг | двойное касание | подъём |
|---|---|---|---|---|---|
| Покой | 96 | 0 | 0 | 0 | 0 |
| Встряхивание | 0 | 96 | 0 | 0 | 0 |
| Круг | 5 | 0 | 91 | 0 | 0 |
| Двойное касание | 0 | 0 | 0 | 96 | 0 |
| Подъём | 0 | 0 | 0 | 0 | 96 |
F1 по классам: 0,975; 1,000; 0,973; 1,000; 1,000. F1 — среднее гармоническое полноты и точности класса (118.8): оно падает и от пропусков, и от ложных ответов. Здесь пять кругов приняты за покой — у круга упала полнота, у покоя точность, — и F1 просел у обоих.
Модели A и B ошибаются в другом месте. Плотная путает покой с двойным касанием: покой за двойное касание в 9 окнах, двойное касание за покой — в 13. У B то же, сильнее: 17 окон покоя ушли в двойное касание. Причина у B — в глобальном максимуме: от фильтра остаётся наибольший отклик, а одно касание и два дают его одинаковым. Сосчитать касания такая модель не может. У C и D до глобального среднего стоят несколько свёрток, и двойное касание обе узнали в 96 окнах из 96.
Если один класс важнее остальных — пропущенный жест хуже ложного или наоборот, — смотрят F1 и полноту этого класса, а не среднее.
118а.5 Параметры и MAC: во флеш, ОЗУ и команды
model.summary() печатает слои, формы выходов и параметры. Для модели C
(начало и конец):
Model: "C_dscnn"
│ conv2d (Conv2D)                   │ (None, 30, 1, 16)        │           240 │
│ batch_normalization               │ (None, 30, 1, 16)        │            64 │
│ depthwise_conv2d                  │ (None, 26, 1, 16)        │            80 │
│ dense_3 (Dense)                   │ (None, 5)                │            85 │
Total params: 3,633 (14.20 KB)
Trainable params: 1,157 (4.52 KB)
Non-trainable params: 160 (640.00 B)
Optimizer params: 2,316 (9.05 KB)
Total params: 3,633 — не размер модели. Keras 3 после fit добавляет
к нему состояние оптимизатора: Adam хранит два числа на каждый обучаемый
вес и счётчик шагов, 2 · 1157 + 2 = 2316. Самой модели — 1317 чисел.
Из них 320 — пять слоёв BatchNormalization по 64: 160 обучаемых
(масштаб и сдвиг) и 160 накопленных средних и разбросов. После свёртки
BN в модели 1077 чисел: 997 весов и 80 сдвигов — по 16 у каждой из пяти
свёрток.
Вручную, слой за слоем (L — длина по времени, C — каналы):
| Слой | Выход | Параметры | MAC |
|---|---|---|---|
| Conv2D 16 × (5, 1), шаг 2 | 30 × 16 | 5 · 3 · 16 = 240 | 30 · 16 · 5 · 3 = 7200 |
| DepthwiseConv2D (5, 1) | 26 × 16 | 5 · 16 = 80 | 26 · 16 · 5 = 2080 |
| Conv2D 1 × 1 | 26 × 16 | 16 · 16 = 256 | 26 · 16 · 16 = 6656 |
| DepthwiseConv2D (5, 1) | 22 × 16 | 80 | 22 · 16 · 5 = 1760 |
| Conv2D 1 × 1 | 22 × 16 | 256 | 22 · 16 · 16 = 5632 |
| GlobalAveragePooling2D | 16 | 0 | — |
| Dense 5 | 5 | 16 · 5 + 5 = 85 | 80 |
| BatchNormalization × 5 | — | 5 · 64 = 320 | 0 после свёртки |
| Всего | 1317 | 23 408 |
Без дополнения краёв (padding="valid", так по умолчанию) свёртка
с ядром k укорачивает время на k − 1, а шаг 2 ещё и делит его пополам:
64 → 30, дальше 30 → 26 → 22. MAC свёртки — длина выхода ×
каналы выхода × ядро × каналы входа; у depthwise каналы входа не
перемножаются. Параметры определяют флеш-память, MAC — время, а размер
тензоров между слоями — ОЗУ, и это три разных числа: у D параметров
столько же, сколько у A, а умножений в 18 раз больше.
Во что это превращается на микроконтроллере, измерено на выводе на C
(infer118b.c: один цикл на все слои, веса во float, BN свёрнута)
и на файле .tflite:
| A | B | C | D | |
|---|---|---|---|---|
| Веса после свёртки BN, байт | 25 364 | 1604 | 4308 | 24 468 |
| .tflite, байт | 27 068 | 4212 | 9700 | 29 932 |
| Буферы слоёв на C, байт | 1536 | 2688 | 3840 | 7680 |
| Пик живых тензоров .tflite, байт | 1536 | 2688 | 3584 | 5760 |
| Команд на вывод, M4 | 33 500 | 56 000 | 164 700 | 626 300 |
| Команд на один MAC | 5,3 | 6,1 | 7,0 | 5,5 |
Флеш-память. Веса — 4 байта на параметр. Код, который их считает,
общий для всех моделей: функция run_model — 1074 байт кода с -Os и 4634 с -O2
(armclang, Cortex-M4); на Cortex-M7 — 1040 и 2270.
ОЗУ. Вывод на C держит два буфера: вход слоя и выход, по очереди. Их
размер задаёт самый большой тензор модели. У D это выход первой свёртки
60 × 16 = 960 чисел: свёртка без шага, пулинг только после неё. У C
первая свёртка идёт с шагом 2, и самый большой тензор — 30 × 16. Ещё
768 байт — окно во float на стеке. Для .tflite посчитана сумма тензоров,
живых одновременно, — от операции, которая тензор пишет, до последней,
которая его читает. Это только оценка арены: TensorFlow Lite Micro
раскладывает тензоры по своему плану и добавляет служебные данные, а
точное число на плате сообщает arena_used_bytes() интерпретатора.
Команды. Тот же C собран arm-none-eabi-gcc -O2 и запущен в QEMU:
netduinoplus2 — Cortex-M4F, как у STM32F405; mps2-an500 — Cortex-M7.
QEMU с -icount ведёт время по числу команд. На Cortex-M7 команд
столько же — для C 164 740 против 164 736, — код тот же. Внутренний
цикл свёртки и Dense — пять команд на умножение: две загрузки vldmia,
vfma, сравнение и переход; у depthwise — восемь, адреса входа и веса
сдвигаются на число каналов отдельными сложениями. С обвязкой циклов
выходит 5,3–7,0 команды на MAC. При 168 МГц 164 700 команд — около 0,98 мс, если бы
каждая команда занимала один такт; у D — 3,73 мс. Окно приходит раз
в 1,28 с, так что любая из моделей укладывается с запасом. Это команды,
а не такты: на кристалле добавятся ожидания флеш-памяти и переходы,
а Cortex-M7 умеет выполнять пары команд одновременно (dual issue,
DUI0646B), и у него тактов может быть меньше, чем команд.
118а.6 Экспорт: SavedModel → .tflite и список операторов
Модель сохраняется как SavedModel, и из него конвертер TensorFlow Lite делает файл. Здесь он во float — квантование в int8 разобрано в 119:
model.export(sm, verbose=False, input_signature=[tf.TensorSpec((batch, N, 3), tf.float32)])
blob = tf.lite.TFLiteConverter.from_saved_model(sm).convert()
Интерпретатор TensorFlow Lite на этих файлах ответил тем же классом,
что Keras, во всех 480 окнах у всех четырёх моделей. В .tflite попали
операторы:
| Модель | Операторы |
|---|---|
| A | RESHAPE, FULLY_CONNECTED × 2 |
| B | RESHAPE, CONV_2D, RESHAPE, REDUCE_MAX, FULLY_CONNECTED |
| C | RESHAPE, CONV_2D, (DEPTHWISE_CONV_2D, CONV_2D) × 2, MEAN, FULLY_CONNECTED |
| D | RESHAPE, (CONV_2D, MAX_POOL_2D) × 2, CONV_2D, RESHAPE, MEAN, FULLY_CONNECTED |
Что видно в этом списке:
- BatchNormalization нет. Конвертер свернул её в свёртку:
w′ = w · γ / √(σ² + ε), b′ = (b − μ) · γ / √(σ² + ε) + β, где γ и β —
масштаб и сдвиг слоя, μ и σ² — накопленные среднее и разброс. Так же
она свёрнута для вывода на C — функция
foldвtrain118b.py, — и C совпал с Keras во всех окнах: разница логитов не больше 1,5e-05. - Conv1D стала CONV_2D. В TensorFlow Lite нет одномерной свёртки: Conv1D, MaxPooling1D и GlobalAveragePooling — это CONV_2D, MAX_POOL_2D и MEAN над тензором высотой 1.
- Пакет надо закрепить. По умолчанию сигнатура SavedModel принимает
пакет любого размера. Тогда конвертер не может свернуть формы заранее:
у A и C появляются SHAPE, STRIDED_SLICE и PACK — вычислить форму для
Flatten и Reshape во время работы, — у D каждая Conv1D и MaxPooling1D
обрастает парой EXPAND_DIMS и RESHAPE, и операторов 17 вместо 9.
Файлы при этом больше: A — 27 868 байт вместо 27 068, D — 32 440 вместо
29 932. В строке выше пакет задан:
batch= 1. - Размер файла — веса плюс описание. У B 1604 байта весов, а файл — 4212: остальное — описание тензоров, операторов и формы. На маленьких моделях эта доля велика.
Важнее всего — кто эти операторы выполнит. В паке TensorFlow Lite Micro
1.23.2 (Keil) все операторы из таблицы есть в списке
MicroMutableOpResolver. Ускоренные ядра CMSIS-NN в том же паке — только
для add, conv, depthwise_conv, fully_connected, mul, pooling, softmax
и svdf. MEAN модели C и D и REDUCE_MAX модели B пойдут простыми ядрами
TFLM — для глобального пулинга это немного: один проход по 22 × 16
числам. Но правило общее: прежде чем выбирать слой, проверить, во что он
превратится и есть ли для этого ядро. Как модель квантуется и
запускается в TFLM, — раздел 119.
118а.7 Грабли
На подборе всё хорошо, а на новых людях хуже — или один класс модель не видела вовсе. validation_split
берёт хвост массива до перемешивания: окна по классам — в подборе один
класс, окна вперемешку — в подборе те же люди. Подбор отделять по
участникам и передавать в validation_data.
model.summary() показывает в три раза больше параметров. После
fit в Keras 3 Total params включает состояние оптимизатора: 3633 у
модели из 1317 чисел. Размер модели — сумма обучаемых и необучаемых
параметров, а после свёртки BN — ещё меньше.
Первые эпохи подбор застыл на одном классе. Накопленные средние
BatchNormalization ещё не догнали данные. Не останавливать обучение
раньше, чем они догонят: patience в десятки эпох.
Каждый запуск — другие веса и другое качество. Не задано зерно или
не включён детерминизм. set_random_seed и enable_op_determinism;
сравнивать архитектуры по нескольким зёрнам — у A разброс 20 окон из 480.
Flatten перед Dense раздувает веса. У A 6176 из 6341 параметра — первый Dense после Flatten, и модель привязана к месту жеста в окне. У D замена глобального пулинга на Flatten дала 7957 параметров вместо 6357, верно 454 вместо 473. Глобальный пулинг — и меньше, и не зависит от сдвига.
Лишние операторы в .tflite. Пакет любого размера: SHAPE, STRIDED_SLICE, PACK, EXPAND_DIMS. Задать пакет 1 в сигнатуре экспорта.
Оператор, которого нет в TFLM или в CMSIS-NN. Слой Keras не равен
оператору: проверять список операторов .tflite по
MicroMutableOpResolver и по ядрам CMSIS-NN до того, как модель обучена.
Глобальный максимум к тому же не умеет считать события — двойное касание
B путал с одиночным.
Большая арена. ОЗУ решает самый большой тензор между слоями, а не веса: у D он вдвое больше, чем у C, из-за первой свёртки без шага. Шаг или пулинг в первом слое режет память сразу.
118а.8 Итоги
- Одна задача — 1600 окон 40 участников, проверка на 480 окнах 12 новых участников; разбиение и подбор — по участникам.
- Depthwise-separable C: 1317 параметров, 23 408 MAC, верно 475 из 480, F1 0,990. Маленькая CNN D: 6357 параметров, 114 912 MAC, 473. Плотная A и одна свёртка B — 454 и 453.
- Обратные вызовы: EarlyStopping с
restore_best_weightsи ModelCheckpoint; кривая обучения показывает, когда учить дальше бесполезно. validation_splitна окнах по классам — подбор из одного класса и 96 верных из 480.- Зерно и детерминизм: повторное обучение дало те же веса до бита; без них у A разброс 438–458.
Total paramsпослеfitвключает оптимизатор: 3633 вместо 1317.- Флеш — 4 байта на параметр после свёртки BN, ОЗУ — самый большой тензор, время — MAC: у C 4308 байт весов, 3840 байт буферов, 164 700 команд на ответ.
- Экспорт: SavedModel → TFLiteConverter, пакет 1; BN сворачивается, Conv1D становится CONV_2D; все операторы есть в TFLM 1.23.2, MEAN и REDUCE_MAX — без ядер CMSIS-NN.
Полные исходники
train118b.py — данные, четыре модели, обучение, метрики, экспорт в .tflite и заголовок для C.
# -*- coding: utf-8 -*-
"""Раздел 118а: Keras для TinyML — четыре архитектуры на одной задаче с акселерометра.

Запуск — в образе stm-tf:1:  python train118b.py <каталог_вывода>

Данные — синтетические жесты с трёхосевого акселерометра: 50 Гц, окно 64 отсчёта
(1,28 с), единицы — g, отсчёт округлён до 1 mg, как у датчика с 16-битным выходом.
Пять классов: покой (с дрожанием руки, одиночным касанием и лёгким покачиванием —
это трудные «не жесты»), встряхивание, круг, двойное касание, подъём. Запись — один
участник: свой темп, своя сила, свой наклон прибора в руке, своё смещение нуля осей.
40 участников по 8 повторов каждого жеста; разбиение — по участникам (раздел 118.3):
22 на обучение, 6 на подбор (валидацию), 12 на проверку.

Модели: A — плотная (Flatten → Dense), B — одна 1D-свёртка, C — depthwise-separable
(слои Conv2D/DepthwiseConv2D, функциональный API), D — маленькая CNN из трёх Conv1D
с BatchNormalization. Каждая учится с EarlyStopping и ModelCheckpoint, затем
SavedModel → TFLiteConverter (float) → .tflite: размер и список операторов.
BatchNormalization сворачивается в свёртку, веса уезжают в model118b.h для infer118b.c;
отложенные окна — в test118b.bin (int16, mg). Сводка — summary118b.txt."""
import os
import sys

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "3"
os.environ["TF_ENABLE_ONEDNN_OPTS"] = "0"
import numpy as np
import tensorflow as tf
from sklearn.metrics import confusion_matrix, f1_score

OUT = sys.argv[1] if len(sys.argv) > 1 else "."
TMP = "/tmp/m118b"
os.makedirs(TMP, exist_ok=True)
SEED = 118
FS, N = 50.0, 64                                  # Гц, отсчётов в окне
NPART, REPS, NCLS = 40, 8, 5
NAMES = ["покой", "встряхивание", "круг", "двойное касание", "подъём"]
rng = np.random.RandomState(SEED)
t = np.arange(N) / FS


def rot(roll, pitch, yaw):
    cr, sr, cp, sp, cy, sy = np.cos(roll), np.sin(roll), np.cos(pitch), np.sin(pitch), np.cos(yaw), np.sin(yaw)
    rx = np.array([[1, 0, 0], [0, cr, -sr], [0, sr, cr]])
    ry = np.array([[cp, 0, sp], [0, 1, 0], [-sp, 0, cp]])
    rz = np.array([[cy, -sy, 0], [sy, cy, 0], [0, 0, 1]])
    return rz @ ry @ rx


def envelope(c, width):
    """Огибающая жеста: половина периода синуса шириной width секунд с центром c."""
    u = (t - c) / width + 0.5
    return np.where((u > 0) & (u < 1), np.sin(np.pi * np.clip(u, 0, 1)), 0.0)


def pulse(c, w):
    return np.exp(-0.5 * ((t - c) / w) ** 2)


def gesture(c, P):
    """Ускорение в системе «мира» (g) без тяжести, 3 × N, и наклон прибора по времени."""
    k, a = P["tempo"], P["amp"]
    d = np.zeros((3, N))
    tilt = np.zeros(N)
    t0 = rng.uniform(0.45, 0.83)                  # где в окне центр жеста, с
    if c == 0:                                    # покой: дрожание руки, медленный наклон
        for _ in range(2):
            f = rng.uniform(7, 12)
            d += rng.uniform(0.005, 0.02) * np.sin(2 * np.pi * f * t + rng.uniform(0, 6.3))[None, :] \
                 * rng.uniform(-1, 1, (3, 1))
        tilt = rng.uniform(-0.15, 0.15) * (t - t.mean())
        kind = rng.randint(3)
        if kind == 1:                             # одиночное касание по столу или корпусу
            d[2] += rng.uniform(1.0, 2.5) * a * (pulse(t0, 0.012) - 0.3 * pulse(t0 + 0.03, 0.02))
        elif kind == 2:                           # лёгкое покачивание в руке
            f = rng.uniform(1.5, 3.0)
            d[rng.randint(2)] += rng.uniform(0.1, 0.3) * a * np.sin(2 * np.pi * f * t) * envelope(t0, 0.8)
    elif c == 1:                                  # встряхивание вдоль оси x мира
        f = rng.uniform(3.2, 4.5) * k
        d[0] = rng.uniform(0.8, 1.6) * a * np.sin(2 * np.pi * f * (t - t0)) * envelope(t0, rng.uniform(0.6, 0.9) / k)
        d[1] = 0.15 * d[0] * rng.uniform(-1, 1)
    elif c == 2:                                  # круг в плоскости xy, по или против часовой
        f = rng.uniform(1.0, 1.5) * k
        s = rng.choice([-1, 1])
        e = envelope(t0, rng.uniform(0.9, 1.1) / k)
        A = rng.uniform(0.35, 0.7) * a
        ph = rng.uniform(0, 6.3)
        d[0] = A * np.cos(2 * np.pi * f * t + ph) * e
        d[1] = s * A * np.sin(2 * np.pi * f * t + ph) * e
    elif c == 3:                                  # двойное касание: два удара по z
        gap = rng.uniform(0.18, 0.32) / k
        for c0 in (t0 - gap / 2, t0 + gap / 2):
            d[2] += rng.uniform(1.0, 2.5) * a * (pulse(c0, 0.012) - 0.3 * pulse(c0 + 0.03, 0.02))
    else:                                         # подъём: разгон вверх, торможение, наклон к себе
        w = rng.uniform(0.12, 0.2) / k
        A = rng.uniform(0.25, 0.5) * a
        d[2] = A * (pulse(t0 - w, w) - pulse(t0 + w, w))
        tilt = rng.uniform(0.25, 0.6) / (1 + np.exp(-(t - t0) / (0.08 / k)))
    for ax in range(3):
        d[ax] += rng.normal(0, 0.004, N)          # мелкая дрожь руки
    return d, tilt


def window(c, P):
    d, tilt = gesture(c, P)
    x = np.zeros((N, 3))
    for i in range(N):
        g = np.array([0.0, np.sin(tilt[i]), np.cos(tilt[i])])     # тяжесть: наклон вокруг оси x
        x[i] = P["R"] @ (g + d[:, i])
    x += P["bias"] + rng.normal(0, P["noise"], (N, 3))
    return np.clip(np.round(x * 1000.0), -32768, 32767).astype(np.int16)   # mg, как отдаёт датчик


Xi, y, g = [], [], []
for p in range(NPART):
    P = dict(tempo=rng.uniform(0.8, 1.25), amp=rng.uniform(0.7, 1.3),
             R=rot(*rng.uniform(-0.45, 0.45, 2), rng.uniform(-0.6, 0.6)),
             bias=rng.uniform(-0.04, 0.04, 3), noise=rng.uniform(0.004, 0.012))
    for c in range(NCLS):
        for _ in range(REPS):
            Xi.append(window(c, P))
            y.append(c)
            g.append(p)
Xi, y, g = np.array(Xi), np.array(y), np.array(g)
X = (Xi.astype(np.float32) / np.float32(1000.0))  # вход модели — g
parts = rng.permutation(NPART)
p_tr, p_va, p_te = parts[:22], parts[22:28], parts[28:]
mtr, mva, mte = np.isin(g, p_tr), np.isin(g, p_va), np.isin(g, p_te)
lines = ["versions=%s,%s,%s" % (tf.__version__, tf.keras.__version__, np.__version__),
         "windows=%d,%d,%d,%d" % (len(y), mtr.sum(), mva.sum(), mte.sum())]
L = tf.keras.layers


def model_A():
    return tf.keras.Sequential([
        tf.keras.Input((N, 3)),
        L.Flatten(),
        L.Dense(32, activation="relu"),
        L.Dropout(0.2),
        L.Dense(NCLS),
    ], name="A_dense")


def model_B():
    return tf.keras.Sequential([
        tf.keras.Input((N, 3)),
        L.Conv1D(12, 9, strides=2, activation="relu"),
        L.GlobalMaxPooling1D(),
        L.Dense(NCLS),
    ], name="B_conv1d")


def model_C():
    inp = tf.keras.Input((N, 3))
    x = L.Reshape((N, 1, 3))(inp)                 # время × 1 × оси: свёртки 2D с ядром (k, 1)
    x = L.Conv2D(16, (5, 1), strides=(2, 1), use_bias=False)(x)
    x = L.BatchNormalization()(x)
    x = L.ReLU()(x)
    for _ in range(2):
        x = L.DepthwiseConv2D((5, 1), use_bias=False)(x)
        x = L.BatchNormalization()(x)
        x = L.ReLU()(x)
        x = L.Conv2D(16, (1, 1), use_bias=False)(x)
        x = L.BatchNormalization()(x)
        x = L.ReLU()(x)
    x = L.GlobalAveragePooling2D()(x)
    out = L.Dense(NCLS)(x)
    return tf.keras.Model(inp, out, name="C_dscnn")


def model_D(flatten=False):
    return tf.keras.Sequential([
        tf.keras.Input((N, 3)),
        L.Conv1D(16, 5, use_bias=False), L.BatchNormalization(), L.ReLU(),
        L.MaxPooling1D(2),
        L.Conv1D(32, 5, use_bias=False), L.BatchNormalization(), L.ReLU(),
        L.MaxPooling1D(2),
        L.Conv1D(32, 3, use_bias=False), L.BatchNormalization(), L.ReLU(),
        L.Flatten() if flatten else L.GlobalAveragePooling1D(),
        L.Dropout(0.2),
        L.Dense(NCLS),
    ], name="D_cnn_flat" if flatten else "D_cnn")


def fit(make, seed, Xtr, ytr, val, tag):
    tf.keras.utils.set_random_seed(seed)
    tf.config.experimental.enable_op_determinism()
    model = make()
    model.compile(optimizer=tf.keras.optimizers.Adam(0.003),
                  loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
                  metrics=["accuracy"])
    cb = [tf.keras.callbacks.EarlyStopping(monitor="val_loss", patience=20, restore_best_weights=True),
          tf.keras.callbacks.ModelCheckpoint(TMP + "/best_%s.keras" % tag, monitor="val_loss", save_best_only=True)]
    kw = dict(validation_data=val) if isinstance(val, tuple) else dict(validation_split=val)
    h = model.fit(Xtr, ytr, epochs=300, batch_size=32, verbose=0, callbacks=cb, shuffle=True, **kw)
    return model, h.history


# ── слои Keras → описание для infer118b.c, BatchNormalization свёрнута в свёртку ──
def fold(model):
    """Цепочка слоёв для C. BN после свёртки уходит в её веса и сдвиг:
    w' = w·γ/√(σ²+ε), b' = (b − μ)·γ/√(σ²+ε) + β."""
    out, lin, cin = [], N, 3
    for ly in model.layers:
        if isinstance(ly, L.BatchNormalization):
            gam, bet, mu, var = [v.numpy() for v in ly.weights]
            sc = gam / np.sqrt(var + ly.epsilon)
            last = out[-1]
            last["w"] = last["w"] * (sc[:, None, None] if last["op"] == "conv" else sc[None, :])
            last["b"] = (last["b"] - mu) * sc + bet
        elif isinstance(ly, L.ReLU):
            out[-1]["relu"] = 1
        elif isinstance(ly, L.DepthwiseConv2D):
            kk, s = ly.kernel_size[0], ly.strides[0]
            w = ly.kernel.numpy()[:, 0, :, 0]          # (k, 1, c, 1) → [k][c]
            b = ly.bias.numpy() if ly.use_bias else np.zeros(cin, np.float32)
            lout = (lin - kk) // s + 1
            out.append(dict(op="dw", k=kk, s=s, cin=cin, cout=cin, lout=lout, w=w, b=b, relu=0))
            lin = lout
        elif isinstance(ly, (L.Conv1D, L.Conv2D)):
            k = ly.kernel.numpy()
            if k.ndim == 4:
                k = k[:, 0]                            # (k, 1, cin, cout) → (k, cin, cout)
            kk, s, co = k.shape[0], ly.strides[0], k.shape[2]
            w = np.transpose(k, (2, 0, 1))             # [cout][k][cin]: веса выхода лежат подряд, как окно входа
            b = ly.bias.numpy() if ly.use_bias else np.zeros(co, np.float32)
            lout = (lin - kk) // s + 1
            relu = 1 if ly.get_config().get("activation") == "relu" else 0
            out.append(dict(op="conv", k=kk, s=s, cin=cin, cout=co, lout=lout, w=w, b=b, relu=relu))
            lin, cin = lout, co
        elif isinstance(ly, L.Dense):
            w = ly.kernel.numpy().T                    # [выход][вход]
            relu = 1 if ly.get_config().get("activation") == "relu" else 0
            out.append(dict(op="dense", k=1, s=1, cin=w.shape[1], cout=w.shape[0], lout=1, w=w,
                            b=ly.bias.numpy(), relu=relu))
            lin, cin = 1, w.shape[0]
        elif isinstance(ly, L.MaxPooling1D):
            p = ly.pool_size[0]
            out.append(dict(op="maxpool", k=p, s=p, cin=cin, cout=cin, lout=lin // p, w=None, b=None, relu=0))
            lin //= p
        elif isinstance(ly, (L.GlobalAveragePooling1D, L.GlobalAveragePooling2D, L.GlobalMaxPooling1D)):
            op = "gmp" if isinstance(ly, L.GlobalMaxPooling1D) else "gap"
            out.append(dict(op=op, k=lin, s=1, cin=cin, cout=cin, lout=1, w=None, b=None, relu=0))
            lin = 1
        elif isinstance(ly, L.Flatten):
            cin, lin = cin * lin, 1                    # раскладка [время][канал] уже плоская
        elif isinstance(ly, (L.Dropout, L.Reshape, L.InputLayer)):
            pass                                       # при выводе Dropout ничего не делает, Reshape — та же память
        else:
            raise ValueError(ly.name)
    return out


def macs(ly):
    if ly["op"] == "conv":
        return ly["lout"] * ly["cout"] * ly["k"] * ly["cin"]
    if ly["op"] == "dw":
        return ly["lout"] * ly["cout"] * ly["k"]
    if ly["op"] == "dense":
        return ly["cin"] * ly["cout"]
    return 0


def act_floats(chain):
    """Самый большой тензор цепочки: под него два буфера C, вход и выход слоя по очереди."""
    return max([N * 3] + [ly["lout"] * ly["cout"] for ly in chain])


def tflite_export(model, tag, batch=1):
    """SavedModel → TFLiteConverter (float) → .tflite: размер, операторы, пик живых тензоров.
    batch=1 — размер пакета закреплён в сигнатуре; None — как по умолчанию, пакет любой."""
    sm = TMP + "/sm_%s_%s" % (tag, batch)
    model.export(sm, verbose=False, input_signature=[tf.TensorSpec((batch, N, 3), tf.float32)])
    blob = tf.lite.TFLiteConverter.from_saved_model(sm).convert()
    open(TMP + "/%s.tflite" % tag, "wb").write(blob)
    it = tf.lite.Interpreter(model_content=blob,
                             experimental_op_resolver_type=tf.lite.experimental.OpResolverType.BUILTIN_REF)
    it.allocate_tensors()
    ops = it._get_ops_details()
    td = {d["index"]: d for d in it.get_tensor_details()}
    din, dout = it.get_input_details()[0], it.get_output_details()[0]
    made = {i for op in ops for i in op["outputs"]} | {din["index"]}
    const = {i for op in ops for i in op["inputs"] if i >= 0 and i not in made}
    nbytes = lambda i: int(np.prod(td[i]["shape"])) * 4
    first, last = {din["index"]: 0}, {dout["index"]: len(ops) - 1}
    for n, op in enumerate(ops):
        for i in op["outputs"]:
            first.setdefault(i, n)
        for i in op["inputs"]:
            if i in made:
                last[i] = n
    peak = max(sum(nbytes(i) for i in first if first[i] <= n <= last.get(i, first[i])) for n in range(len(ops)))
    res = []
    for row in X[mte]:
        it.set_tensor(din["index"], row[None])
        it.invoke()
        res.append(it.get_tensor(dout["index"])[0].copy())
    return dict(size=len(blob), ops=[op["op_name"] for op in ops], peak=peak,
                wconst=sum(nbytes(i) for i in const), out=np.array(res, np.float32))


ARCH = (("A", model_A), ("B", model_B), ("C", model_C), ("D", model_D))
R = {}
for name, make in ARCH:
    m, hist = fit(make, SEED, X[mtr], y[mtr], (X[mva], y[mva]), name)
    logit = m.predict(X[mte], verbose=0).astype(np.float32)
    p = logit.argmax(1)
    vl = np.array(hist["val_loss"])
    ch = fold(m)
    tfl = tflite_export(m, name)
    dyn = tflite_export(m, name, batch=None)
    R[name] = dict(model=m, hist=hist, logit=logit, chain=ch)
    nw = sum(ly["w"].size + ly["b"].size for ly in ch if ly["w"] is not None)
    be = int(vl.argmin())
    lines += ["%s_params=%d" % (name, m.count_params()),
              "%s_trainable=%d" % (name, sum(int(np.prod(v.shape)) for v in m.trainable_weights)),
              "%s_folded=%d" % (name, nw),
              "%s_layer_macs=%s" % (name, ",".join("%s:%d" % (ly["op"], macs(ly)) for ly in ch)),
              "%s_mac=%d" % (name, sum(macs(ly) for ly in ch)),
              "%s_act=%d" % (name, act_floats(ch)),
              "%s_epochs=%d,%d" % (name, len(vl), be + 1),
              "%s_val=%d,%d" % (name, int(round(hist["val_accuracy"][be] * mva.sum())), mva.sum()),
              "%s_test=%d,%d" % (name, int((p == y[mte]).sum()), mte.sum()),
              "%s_f1=%s" % (name, ",".join("%.3f" % v for v in f1_score(y[mte], p, average=None))),
              "%s_f1macro=%.3f" % (name, f1_score(y[mte], p, average="macro")),
              "%s_cm=%s" % (name, ",".join(str(v) for v in confusion_matrix(y[mte], p).ravel())),
              "%s_tflite=%d" % (name, tfl["size"]),
              "%s_tflite_w=%d" % (name, tfl["wconst"]),
              "%s_tflite_peak=%d" % (name, tfl["peak"]),
              "%s_ops=%s" % (name, ",".join(tfl["ops"])),
              "%s_ops_anybatch=%s;%d" % (name, ",".join(dyn["ops"]), dyn["size"]),
              "%s_tflite_same=%d,%.1e" % (name, int((tfl["out"].argmax(1) == p).sum()),
                                          float(np.abs(tfl["out"] - logit).max()))]

# кривая обучения модели C: потери и доля верных на обучении и подборе
hC = R["C"]["hist"]
for e in (1, 5, 10, 20, 40, 80, 120, 160, len(hC["loss"])):
    if e <= len(hC["loss"]):
        lines.append("C_curve%d=%.3f,%.3f,%.3f,%.3f" % (e, hC["loss"][e - 1], hC["val_loss"][e - 1],
                                                       hC["accuracy"][e - 1], hC["val_accuracy"][e - 1]))

# ── зерно: та же архитектура, другие начальные веса и порядок примеров ──
for name, make in ARCH:
    acc = []
    for sd in (1, 2, 3):
        m, _ = fit(make, sd, X[mtr], y[mtr], (X[mva], y[mva]), name + "s")
        acc.append(int((m.predict(X[mte], verbose=0).argmax(1) == y[mte]).sum()))
    lines.append("%s_seeds=%s" % (name, ",".join(str(a) for a in acc)))

# ── validation_split: Keras берёт последние 20 % массива, и берёт их ДО перемешивания ──
pool = mtr | mva
order = np.argsort(y[pool], kind="stable")       # окна сложены по классам, как из пяти файлов подряд
Xs, ys = X[pool][order], y[pool][order]
nval = int(len(ys) * 0.2)
m, hist = fit(model_C, SEED, Xs, ys, 0.2, "vs_sorted")
lines.append("vsplit_sorted=%s;%d;%d;%d,%d" % ("+".join(str(c) for c in sorted(set(ys[-nval:]))), nval,
                                               int((m.predict(X[mte], verbose=0).argmax(1) == y[mte]).sum()),
                                               len(hist["loss"]), int(np.argmin(hist["val_loss"])) + 1))
sh = np.random.RandomState(SEED).permutation(len(ys))   # окна перемешаны: в подборе — те же участники
for name, make in (("A", model_A), ("C", model_C)):
    Xs, ys = X[pool][sh], y[pool][sh]
    m, hist = fit(make, SEED, Xs, ys, 0.2, "vs_shuffled")
    vl = np.array(hist["val_loss"])
    lines.append("%s_vsplit_shuffled=%d,%d;%d" % (name, int(round(hist["val_accuracy"][int(vl.argmin())] * nval)), nval,
                                                  int((m.predict(X[mte], verbose=0).argmax(1) == y[mte]).sum())))

# ── Flatten вместо глобального пулинга в модели D ──
m, _ = fit(lambda: model_D(flatten=True), SEED, X[mtr], y[mtr], (X[mva], y[mva]), "Dflat")
lines.append("Dflat=%d,%d" % (m.count_params(), int((m.predict(X[mte], verbose=0).argmax(1) == y[mte]).sum())))

# ── model.summary() модели C ──
txt = []
R["C"]["model"].summary(print_fn=lambda s, **k: txt.append(s), line_length=80)
open(OUT + "/summaryC118b.txt", "w", encoding="utf-8", newline="\n").write("\n".join(txt) + "\n")


# ── заголовок для C и отложенные окна ──
def c_float(v):
    s_ = "%.9g" % v
    return (s_ if any(ch in s_ for ch in ".en") else s_ + ".0") + "f"


def c_arr(nm, a, typ):
    flat = np.asarray(a).ravel()
    body = ", ".join(c_float(v) if typ == "float" else str(int(v)) for v in flat)
    return "static const %s %s[%d] = { %s };\n" % (typ, nm, len(flat), body)


h = ["/* Раздел 118а: четыре модели Keras, BatchNormalization свёрнута — сгенерировано train118b.py, не править */\n",
     "#include \"layer118b.h\"\n",
     "#define N_IN %d\n#define N_CH 3\n#define N_CLS %d\n#define N_TEST %d\n" % (N, NCLS, int(mte.sum()))]
for name, _ in ARCH:
    ch = R[name]["chain"]
    for i, ly in enumerate(ch):
        if ly["w"] is not None:
            h.append(c_arr("%s_W%d" % (name, i), ly["w"].astype(np.float32), "float"))
            h.append(c_arr("%s_B%d" % (name, i), ly["b"].astype(np.float32), "float"))
    h.append("static const layer_t %s_L[%d] = {\n" % (name, len(ch)))
    for i, ly in enumerate(ch):
        wb = ("%s_W%d, %s_B%d" % (name, i, name, i)) if ly["w"] is not None else "0, 0"
        h.append("    { OP_%s, %d, %d, %d, %d, %d, %s },\n" % (ly["op"].upper(), ly["k"], ly["s"], ly["cin"],
                                                              ly["cout"], ly["relu"], wb))
    h.append("};\n#define %s_NL %d\n#define %s_ACT %d\n" % (name, len(ch), name, act_floats(ch)))
xte = Xi[mte]
h.append("#ifdef ML_BENCH\n" + c_arr("BENCH_X", xte[0], "int16_t") + "#endif\n")
open(OUT + "/model118b.h", "w", encoding="utf-8", newline="\n").write("".join(h))
with open(OUT + "/test118b.bin", "wb") as fb:
    fb.write(xte.astype("<i2").tobytes())
    fb.write(y[mte].astype(np.uint8).tobytes())
    for name, _ in ARCH:
        fb.write(R[name]["logit"].astype("<f4").tobytes())
open(OUT + "/summary118b.txt", "w", encoding="utf-8", newline="\n").write("\n".join(lines) + "\n")
print("\n".join(lines))
layer118b.h — описание слоя для вывода на C.
/* Раздел 118а: слой модели для infer118b.c — что делать, размеры и веса. */
#ifndef LAYER118B_H
#define LAYER118B_H
#include <stdint.h>

enum { OP_CONV, OP_DW, OP_DENSE, OP_MAXPOOL, OP_GAP, OP_GMP };

typedef struct {
    uint8_t op;         /* OP_... */
    uint8_t k, s;       /* ядро (или окно пулинга) и шаг по времени */
    uint16_t cin, cout; /* каналов на входе и выходе; у Dense — длина входа и выхода */
    uint8_t relu;       /* 1 — ReLU после слоя */
    const float *w, *b; /* веса и сдвиги, BatchNormalization уже внутри */
} layer_t;

#endif
infer118b.c — вывод четырёх моделей во float: один цикл на все слои, сверка с Keras на компьютере.
/* Раздел 118а: вывод четырёх моделей Keras во float на C — один цикл на все слои.
 * Вход — окно акселерометра [64 отсчёта][3 оси] в mg, как отдаёт датчик.
 * Раскладка тензоров — [время][канал], как в Keras (channels_last): Flatten ничего не двигает.
 * Сборка на компьютере с -DML_HOST сверяет ответы с Keras на всех отложенных окнах. */
#include "model118b.h"

#define MAX2(a, b) ((a) > (b) ? (a) : (b))
#define ACT_MAX MAX2(MAX2(A_ACT, B_ACT), MAX2(C_ACT, D_ACT))

static float buf[2][ACT_MAX]; /* вход и выход слоя по очереди */

static const struct {
    const layer_t *l;
    int n;
} MODELS[4] = { { A_L, A_NL }, { B_L, B_NL }, { C_L, C_NL }, { D_L, D_NL } };

/* Один проход модели m: x — [N_IN][N_CH] во float (g), ответ — N_CLS чисел до softmax */
void run_model(int m, const float *x, float *logit)
{
    const layer_t *ly = MODELS[m].l;
    const float *in = x;
    int nl = MODELS[m].n, len = N_IN, ch = N_CH, cur = 0;

    for (int n = 0; n < nl; n++, ly++) {
        float *out = (n == nl - 1) ? logit : buf[cur];
        int lout = 1;
        switch (ly->op) {
        case OP_CONV: {                       /* свёртка: окно k отсчётов × cin каналов подряд в памяти */
            int span = ly->k * ly->cin;
            lout = (len - ly->k) / ly->s + 1;
            for (int t = 0; t < lout; t++) {
                const float *win = in + t * ly->s * ly->cin;
                for (int o = 0; o < ly->cout; o++) {
                    const float *w = ly->w + o * span;
                    float acc = ly->b[o];
                    for (int j = 0; j < span; j++)
                        acc += win[j] * w[j];
                    out[t * ly->cout + o] = (ly->relu && acc < 0.0f) ? 0.0f : acc;
                }
            }
            ch = ly->cout;
            break;
        }
        case OP_DW:                           /* depthwise: у каждого канала своё ядро, каналы не смешиваются */
            lout = (len - ly->k) / ly->s + 1;
            for (int t = 0; t < lout; t++)
                for (int c = 0; c < ch; c++) {
                    float acc = ly->b[c];
                    for (int j = 0; j < ly->k; j++)
                        acc += in[(t * ly->s + j) * ch + c] * ly->w[j * ch + c];
                    out[t * ch + c] = (ly->relu && acc < 0.0f) ? 0.0f : acc;
                }
            break;
        case OP_DENSE:                        /* полносвязный: вход — весь предыдущий тензор подряд */
            for (int o = 0; o < ly->cout; o++) {
                const float *w = ly->w + o * ly->cin;
                float acc = ly->b[o];
                for (int i = 0; i < ly->cin; i++)
                    acc += in[i] * w[i];
                out[o] = (ly->relu && acc < 0.0f) ? 0.0f : acc;
            }
            ch = ly->cout;
            break;
        case OP_MAXPOOL:
            lout = len / ly->k;
            for (int t = 0; t < lout; t++)
                for (int c = 0; c < ch; c++) {
                    float v = in[t * ly->k * ch + c];
                    for (int j = 1; j < ly->k; j++)
                        v = MAX2(v, in[(t * ly->k + j) * ch + c]);
                    out[t * ch + c] = v;
                }
            break;
        case OP_GAP:                          /* среднее по времени: длина входа больше не важна */
        case OP_GMP:                          /* максимум по времени */
            for (int c = 0; c < ch; c++) {
                float v = in[c];
                for (int t = 1; t < len; t++)
                    v = ly->op == OP_GAP ? v + in[t * ch + c] : MAX2(v, in[t * ch + c]);
                out[c] = ly->op == OP_GAP ? v / (float)len : v;
            }
            break;
        }
        in = out;
        len = lout;
        cur ^= 1;
    }
}

/* Окно в mg → вход модели в g → номер класса */
int classify118b(int m, const int16_t *raw)
{
    float x[N_IN * N_CH], logit[N_CLS];
    int best = 0;
    for (int i = 0; i < N_IN * N_CH; i++)
        x[i] = (float)raw[i] / 1000.0f;
    run_model(m, x, logit);
    for (int c = 1; c < N_CLS; c++)
        if (logit[c] > logit[best])
            best = c;
    return best;
}

#if defined(ML_HOST)
#include <math.h>
#include <stdio.h>
#include <stdlib.h>

int main(int argc, char **argv)
{
    static int16_t xr[N_TEST][N_IN * N_CH];
    static uint8_t yl[N_TEST];
    static float ref[4][N_TEST][N_CLS];
    FILE *f = fopen(argc > 1 ? argv[1] : "test118b.bin", "rb");
    if (!f || fread(xr, sizeof xr, 1, f) != 1 || fread(yl, sizeof yl, 1, f) != 1 || fread(ref, sizeof ref, 1, f) != 1) {
        printf("нет test118b.bin\n");
        return 1;
    }
    fclose(f);
    for (int m = 0; m < 4; m++) {
        int agree = 0, right = 0;
        double dmax = 0.0;
        for (int n = 0; n < N_TEST; n++) {
            float x[N_IN * N_CH], lg[N_CLS];
            int kc = 0, kp = 0;
            for (int i = 0; i < N_IN * N_CH; i++)
                x[i] = (float)xr[n][i] / 1000.0f;
            run_model(m, x, lg);
            for (int c = 0; c < N_CLS; c++) {
                dmax = fmax(dmax, fabs((double)lg[c] - ref[m][n][c]));
                if (lg[c] > lg[kc])
                    kc = c;
                if (ref[m][n][c] > ref[m][n][kp])
                    kp = c;
            }
            agree += kc == kp;
            right += kc == yl[n];
            if (classify118b(m, xr[n]) != kc)
                return 2;
        }
        printf("%c_agree=%d,%d\n%c_right=%d\n%c_maxdiff=%.1e\n", 'A' + m, agree, N_TEST, 'A' + m, right, 'A' + m, dmax);
    }
    printf("act_max=%d\n", ACT_MAX);
    return 0;
}
#elif !defined(ML_BENCH)
volatile int16_t g_raw[N_IN * N_CH];
volatile int g_model, g_class;
void SystemInit(void) {}
int main(void)
{
    for (;;) {
        int16_t raw[N_IN * N_CH];
        for (int i = 0; i < N_IN * N_CH; i++)
            raw[i] = g_raw[i];
        g_class = classify118b(g_model & 3, raw);
    }
}
#endif
Дальше: раздел 119 «Квантование int8» — те же веса в целых числах, CMSIS-NN и TensorFlow Lite Micro.