 Embedded HandbookПриложения
121г. Пайплайн TinyML-приложения: от задачи до прибора — этапы, контрольные точки и как это делает Edge Impulse
Разделы 116–121в разобрали части по одной: модели, признаки, данные, обучение, квантование, вывод на плате, аномалии, звук, камеру. Здесь они собраны в один конвейер — от технического задания до прибора на объекте и обратно. Главная мысль раздела: после каждого этапа стоит контрольная точка — число из прогона, которое сравнивается с бюджетом или порогом приёмки. Не прошла точка — назад, а не дальше.
Конвейер показан дважды. Сначала — как его устроил Edge Impulse:
понятия «импульс», блок обработки, блок обучения, EON Compiler и
библиотека C++ с run_classifier() — по открытому SDK. Саму студию
Edge Impulse раздел не использует: это облачный сервис, он требует
учётной записи. Затем — тот же конвейер своими силами, одним скриптом
на три основные задачи TinyML: ключевое слово, аномалии вибрации и
поиск объектов на кадре. Для каждой — бюджет, окно, признаки, модель,
байты, команды и метрика приёмки.
О данных — честно. Все записи синтетические: речь — гласные с формантами, вибрация — гармоники вращения и удары подшипника, кадры — светлые круги на неровном фоне. Зерно генератора фиксировано. Числа раздела проверяют конвейер — что каждая точка ловит свою поломку, что C отвечает как Python, что модель влезает в бюджет. О точности на настоящих датчиках они не говорят.
Опоры: подходы и метрики — раздел 116; признаки и CMSIS-DSP — 117;
сбор и разведка данных — 117а; разбиение по записям и нормировка — 118;
архитектуры и экспорт в .tflite — 118а; int8 и множитель Q31 — 119;
оптимизация модели — 119а; TensorFlow Lite Micro на плате — 119б;
аномалии и своя норма прибора — 120; кадр и OpenMV — 121а; звук и
MFCC — 121б; камера с нейроускорителем — 121в. Edge Impulse — пакет
CMSIS EdgeImpulse.EI-SDK версий 1.56.2 и 1.74.17. Ток STM32F407 —
даташит DS8626 Rev 9.
Как это называется в документации
Оригинал Перевод pipeline конвейер: этапы от задачи до прибора checkpoint, quality gate контрольная точка: проверка с порогом после этапа budget бюджет: флеш, ОЗУ, такты, энергия, задержка на ответ impulse импульс: окно, блок обработки и блок обучения вместе processing block (DSP block) блок обработки: признаки из сырого окна learning block блок обучения: классификатор, регрессия, аномалии, детектор window size, window increase окно и шаг окна MFE, MFCC, spectral analysis мел-энергии, мел-кепстр, спектральный анализ FOMO (faster objects, more objects) детектор центров объектов на сетке клеток EON Compiler компилятор модели в код без интерпретатора C++ library export выгрузка в виде библиотеки C++ label noise ошибки разметки data drift дрейф данных: в поле не то, что было при обучении acceptance criteria критерии приёмки
121г.1 Конвейер и контрольные точки
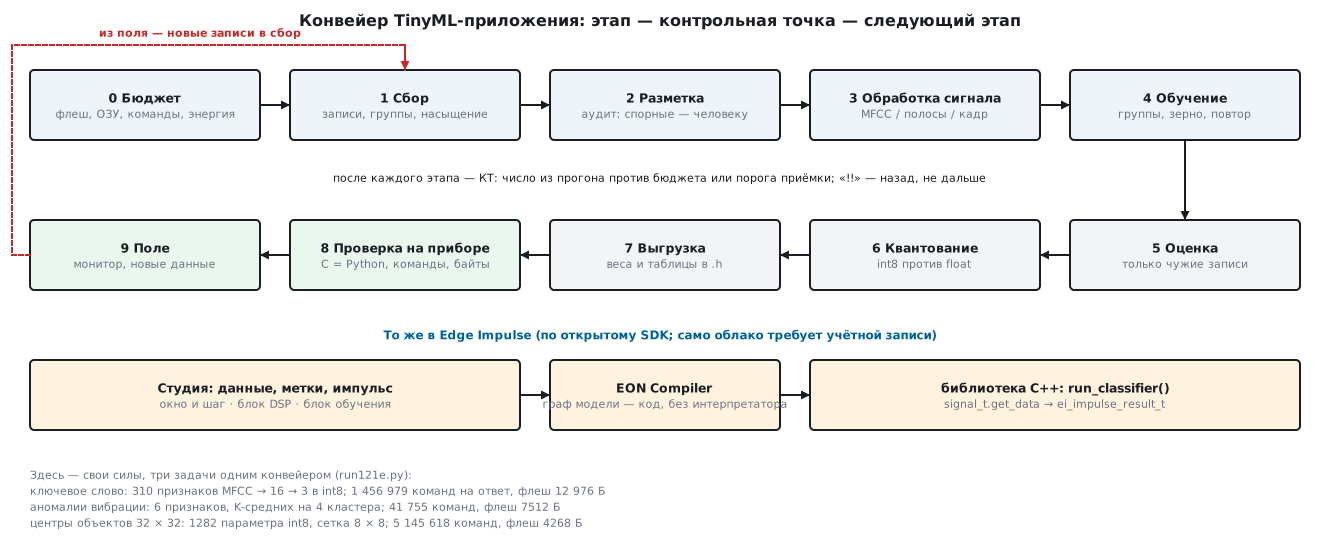
Этапы и что проверяет точка после каждого:
| Этап | Контрольная точка (КТ) |
|---|---|
| 0. Задача и бюджет | флеш, ОЗУ, команды на ответ, ответов в секунду, метрика приёмки — записаны до данных |
| 1. Сбор данных | сколько записей и от скольких групп (дикторов, машин, сеансов), нет ли насыщения АЦП, группы проверки не пересекаются с обучением |
| 2. Разметка | аудит: примеры, где модель кросс-проверки уверенно спорит с меткой, — человеку |
| 3. Обработка сигнала | число признаков, все конечны; выбор версии признаков — на стенде, не на отложенных |
| 4. Обучение | сошлось; повторный запуск — те же веса байт в байт |
| 5. Оценка | метрика приёмки на записях групп, которых обучение не видело |
| 6. Квантование | int8 против float на тех же записях |
| 7. Выгрузка | веса и таблицы в заголовок C, байты |
| 8. Проверка на приборе | C против Python на всех отложенных окнах, команды на ответ, флеш и ОЗУ собранного образа |
| 9. Поле | монитор в работе, новые записи, дообучение — и снова с этапа 1 |
Бюджет — часть технического задания, его пишут до данных. В разделе целевой камень — STM32F407: до 1 МБ флеш-памяти и 192 + 4 КБ ОЗУ, ядро до 168 МГц (DS8626 Rev 9, стр. 1). Энергия на ответ считается по току в режиме Run: 40 мА при 168 МГц с выключенной периферией, типовое значение при 25 °C и 3,3 В (DS8626 Rev 9, табл. 20). Это оценка снизу: время берётся как число команд, делённое на 168 МГц, а тактов на кристалле всегда не меньше, чем команд.
| Задача | Флеш | ОЗУ | Команд на ответ | Ответов в секунду | Приёмка |
|---|---|---|---|---|---|
| Ключевое слово | 65 536 Б | 24 576 Б | 4 200 000 | 4 | полнота ключа ≥ 0,95, ложные ≤ 0,02 |
| Аномалии вибрации | 16 384 Б | 8192 Б | 840 000 | 1 | ложные тревоги ≤ 0,01, каждый дефект ≥ 0,90 |
| Центры объектов | 32 768 Б | 24 576 Б | 8 400 000 | 1 | F1 центров ≥ 0,90 |
4 200 000 команд — это 25 мс при 168 МГц, десятая часть секунды на четыре ответа; 840 000 — 5 мс; 8 400 000 — 50 мс.
121г.2 Как это делает Edge Impulse
Edge Impulse — облачная студия: в ней собирают и размечают данные,
задают импульс, обучают и выгружают результат. Студия требует учётной
записи, поэтому здесь она не запускалась. Открыто другое — то, что
едет в прошивку: SDK для вывода на приборе. Он лежит пакетом CMSIS
EdgeImpulse.EI-SDK; описание ниже — по его исходникам, с файлом.
README пакета так и говорит: в нём реализация на C++ блоков обработки
и блоков обучения, а проект из студии добавляется выгрузкой «C++ Library».
Лицензия меняется от версии к версии. Версия 1.56.2 от 2024-08-06
целиком под Apache 2.0. В версии 1.74.17 от 2025-08-22 основной код —
под BSD 3-Clause Clear, но 32 файла каталога dsp/ — среди них
dsp/numpy_types.h с signal_t и dsp/spectral/feature.hpp — под
условиями обслуживания Edge Impulse: по их шапке файлы можно
использовать только при действующей платной подписке. Поэтому ниже
только пересказ со ссылками на файлы версии 1.56.2, код SDK не
копируется.
Импульс. Структура ei_impulse_t
(classifier/ei_model_types.h) описывает один импульс целиком:
частоту и шаг отсчётов (frequency, interval_ms), размер окна в
отсчётах (raw_sample_count, dsp_input_frame_size), массив блоков
обработки dsp_blocks и блоков обучения learning_blocks, число
классов label_count и признак аномалий has_anomaly. Окно — то, что
в студии задаётся в миллисекундах: комментарий к total_length в
dsp/numpy_types.h прямо называет его «window size in Studio, but in
samples». Для потока есть slice_size и slices_per_model_window:
run_classifier_continuous() считает признаки только нового куска
окна и сдвигает уже посчитанные — так в ОЗУ лежат признаки, а не
секунда сырого звука.
Блоки обработки — функции extract_*_features() в
classifier/ei_run_dsp.h: спектральный анализ, MFCC, MFE,
спектрограмма, изображение и сырые отсчёты. MFCC берёт из настроек
длину и шаг кадра, число фильтров и коэффициентов, длину БПФ, границы
частот и коэффициент предыскажения, а после MFCC вызывает cmvnw —
нормировку коэффициентов по окну. Настройки каждого блока лежат в
model-parameters/model_metadata.h, который генерирует студия; в
пакете его нет.
Блоки обучения. Классификатор и регрессия — нейросеть (регрессия —
случай одного выхода без аномалий, ei_run_classifier.h). Аномалии
K-средних — classifier/inferencing_engines/anomaly.h, и устроены они
просто: признаки нормируются (standard_scaler), для каждого кластера
считается расстояние до центра минус радиус кластера
(sqrt(dist) - cluster->max_error), оценка — наименьшее из них, начиная
с 1000. Детектор FOMO отдаёт сетку клеток; на клетку приходится
label_count + 1 чисел, нулевое — фон (classifier/ei_fill_result_struct.h).
Клетки выше порога сливаются с соседними того же класса, координаты
умножаются на отношение ширины кадра к ширине сетки.
EON Compiler. Обычный путь — интерпретатор TensorFlow Lite Micro:
classifier/inferencing_engines/tflite_micro.h строит MicroInterpreter
и, если не задан свой EI_TFLITE_RESOLVER, берёт AllOpsResolver —
все ядра сразу. В разделе 119б прошивка с AllOpsResolver заняла
242 903 байта против 56 791 со своим набором ядер. Путь EON — tflite_eon.h, при
EI_CLASSIFIER_COMPILED == 1: вместо разбора модели во время работы —
готовые функции model_init(), model_invoke(), model_reset(),
model_input(), model_output(). Граф модели становится кодом, а
интерпретатор с его таблицами не нужен. Вывод на C в этом разделе —
то же по сути: слои вызываются по порядку, веса — const-массивы.
Библиотека C++ и её вход. Вызов один:
run_classifier(signal_t *signal, ei_impulse_result_t *result, bool debug = false)—classifier/ei_run_classifier.h;signal_t— не буфер, а функцияget_data(offset, length, out_ptr)и длинаtotal_length: SDK сам просит окно кусками, и данные могут лежать где угодно — в кольце DMA, во внешней памяти, в int16;ei_impulse_result_t— массивclassification[]из пар «метка, вероятность»,anomaly, рамкиbounding_boxesс числомbounding_boxes_countи времяtiming:dsp,classification,anomalyв миллисекундах и они же в микросекундах.
Под свою плату пишут перенос: ei_read_timer_us(), ei_printf(),
ei_malloc(), ei_free() — porting/ei_classifier_porting.h. Время
timing.dsp и timing.classification — то самое разделение «обработка
против модели», которое раздел меряет ниже в QEMU.
121г.3 Один скрипт на три задачи
Конвейер своими силами — run121e.py. Он принимает имя задачи (kws,
anom, vision или all) и проходит все этапы:
stages121e.pyв образеstm-ml:1(numpy 2.3.3, scikit-learn 1.7.2) — этапы 0–7 и 9: данные, разметка, признаки, обучение, оценка, квантование, заголовокmodel_<задача>.h, поле;- этап 8 —
impulse121e.c: импульс целиком на C, без библиотек и интерпретатора. gcc 12.2.0 (stm-sys:1) собирает его на ПК, и он отвечает на все отложенные окна, а ответы сверяются с Python; arm-none-eabi-gcc 12.2.1 (stm-arm:1) собирает его для QEMU netduinoplus2 (STM32F405, Cortex-M4F), где считаются команды на блок обработки и на модель отдельно; armclang (MDK 5.43) с armlink связывает образ для Cortex-M4 вместе с библиотекой — это флеш и ОЗУ.
Каждая точка — одна строка отчёта:
def kt(n, name, ok, text):
Повторный прогон даёт те же model_<задача>.h и тот же отчёт байт в
байт — зерно у каждого случайного шага, версии в образе закреплены.
Квантование у сетей — своё, по схеме раздела 119: веса int8 с масштабом на тензор, поправки int32, активации int8 после ReLU, сдвиг с множителем Q31 и одним округлением — одинаковый в Python и в C:
return (acc * m0 + (1 << (30 + sh))) >> (31 + sh)
return (int32_t)(((int64_t)acc * m0 + ((int64_t)1 << (30 + sh))) >> (31 + sh));
Сводка трёх задач:
| Ключевое слово | Аномалии вибрации | Центры объектов | |
|---|---|---|---|
| Окно | 1 с, 8000 отсчётов, 8 кГц | 0,25 с, 256 отсчётов, 1024 Гц | кадр 32 × 32, 1024 яркости |
| Признаки | MFCC 31 × 10 = 310 | СКЗ + 5 полос = 6 | сам кадр |
| Модель | 310 → 16 → 3, int8 | K-средних, 4 кластера, float | 2 свёртки 3 × 3 и 1 × 1, int8 |
| Параметров | 5027 | 40 | 1282 |
| Метрика на отложенных | полнота 0,9833, ложные 0,0167 | ложные 0,0063, дефекты от 0,9458 | F1 0,9633 |
| C против Python | 360 из 360 | 1920 из 1920 | 800 из 800 |
| Команд: обработка + модель | 1 431 634 + 25 345 | 41 440 + 315 | 1286 + 5 144 332 |
| Не меньше, мс / мкДж на ответ | 8,67 / 1145 | 0,25 / 33 | 30,63 / 4043 |
| Флеш / ОЗУ + стек, Б | 12 976 / 3612 + 112 | 7512 / 2088 + 88 | 4268 / 11 336 + 196 |
Все три уложились в бюджет. Дальше — по задаче на подраздел.
121г.4 Ключевое слово
Подробно тракт звука и MFCC разобраны в разделе 121б; здесь — короче и
крупнее шаг. Окно 1 с на 8 кГц, кадр 256 отсчётов (32 мс) без
перекрытия — 31 кадр. С кадра: предыскажение 0,97, окно Хэмминга, БПФ
на 256 точек, 20 мел-полос от 50 до 4000 Гц, натуральный логарифм,
ДКП-II, 10 коэффициентов. В блоке MFCC Edge Impulse после MFCC идёт
нормировка cmvnw; здесь из каждого коэффициента вычитается только
его среднее по окну. Признаков 310.
Три класса: ключ «а-и», другое слово (пять вариантов из похожих гласных) и шум
(фон 50 Гц, шорох, щелчки, тишина).
КТ 1. 1440 окон от 48 дикторов; отложены 12 дикторов целиком — 360 окон; насыщений АЦП 0.
КТ 2. В обучение нарочно подложено 8 ошибок: ключ размечен как «другое слово». Кросс-проверка по дикторам на 5 частей поднимает окна, где вероятность метки меньше 0,05:
flag = np.where(tr & (p_lab < 0.05))[0]
Поднято 13 окон, ошибок среди них 7. Это обычная картина аудита: часть поднятых — трудные, но верные примеры, и решать должен человек, а одна ошибка ушла незамеченной.
КТ 4–6. Перцептрон 310 → 16 → 3 — 5027 параметров, сошёлся за 321 эпоху. На 12 новых дикторах полнота ключа 0,9833, ложные срабатывания 0,0167, верно 353 из 360. После int8 — те же 353, и ответы int8 и float совпали во всех 360 окнах.
КТ 7–8. Веса int8 с поправками — 5084 байта; таблицы обработки —
окно 256 чисел, поворотные множители БПФ 2 × 128, 238 мел-весов вместо
полной матрицы 20 × 129 и ДКП 200 чисел. C на ПК посчитал признаки сам,
из отсчётов: из 111 600 элементов int8 разошёлся 1, и на единицу —
float32 в C против float64 в Python у самой границы округления. Ответы — 360 из 360.
В QEMU обработка заняла 1 431 634 команды, модель — 25 345: признаки
в 56 раз дороже сети. Связанный образ — 12 976 байт флеш-памяти, из
них 552 — библиотека (logf, floorf); ОЗУ 3612 байт и стек 112.
КТ 9. Поле — цех с вентилятором: гул 120 Гц и шум, 12 новых дикторов. Меток в поле нет, поэтому монитор смотрит на то, что видно без них, — долю неуверенных ответов, где наибольшая вероятность меньше 0,8: 0,2083 против 0,0389 на отложенных записях. Записи потом разметили: полнота упала до 0,9333, ложные выросли до 0,0417 — приёмка не пройдена. Записи 6 дикторов цеха размечены и добавлены в обучение; на 6 других полнота 0,9500, ложные 0,0083, а на старых отложенных — 0,9917 и 0,0125: старое не забылось.
121г.5 Аномалии вибрации
Обнаружение аномалий подробно — раздел 120. Здесь — тот же блок, что у Edge Impulse: K-средних по норме, оценка — расстояние до ближайшего центра минус радиус кластера:
d = np.sqrt(((Z[:, None, :] - C[None]) ** 2).sum(axis=2)) - R[None]
d = sqrtf(d) - RAD[k];
Радиус кластера — расстояние до самого далёкого обучающего окна:
R = np.array([d[km.labels_ == k].max() for k in range(4)])
Окно 256 отсчётов оси Z при 1024 Гц (0,25 с), диапазон ±4 g. Машины — вращение 23–27 Гц, у каждой свои амплитуды, резонанс и чувствительность крепления. Дефекты: дисбаланс (растёт 1×), расцентровка (растёт 2×) и подшипник (удары с частотой в 3,58 раза выше частоты вращения возбуждают резонанс).
КТ 1. 4000 окон с 46 машин: 28 обучающих машин размечены как норма — 1120 окон; стенд из 6 машин с дефектами — 960 окон для выбора признаков; 12 машин отложены — норма и три дефекта, 1920 окон.
КТ 2. В «норму» попала машина с изношенным подшипником. Кросс- проверка по машинам: модель, обученная на остальных, оценивает каждую машину; медиана оценки её окон 27,0378, у прочих — не выше 0,3237. Машина исключена. Без этого шага модель считала бы удары подшипника нормой.
КТ 3 — назад к признакам. Версия 1 — СКЗ и 8 полос по 64 Гц, как в спектральном блоке «из коробки». На стенде расцентровка найдена лишь в 0,2292 окон: 1× и 2× попали в одну полосу 4–64 Гц. Версия 2 — СКЗ и 5 полос 4–32, 36–64, 68–128, 132–256 и 260–512 Гц, 6 признаков: на стенде дисбаланс, расцентровка и подшипник — 1,0000. Признаки выбраны на стенде; отложенные машины до этого не открывались.
КТ 4–5. 4 кластера, порог 0,3989 — 99,5 % оценок нормы на кросс- проверке по машинам. На 12 новых машинах ложные тревоги 0,0063, дисбаланс 0,9458, расцентровка и подшипник 1,0000.
КТ 6–8. Квантовать нечего: модель — 40 чисел float, 160 байт, и 24 вычитания с умножением на окно. C и Python согласны во всех 1920 окнах, оценка отличается не больше чем на 1,91e-05. Обработка — 41 440 команд, модель — 315; образ — 7512 байт флеш-памяти, ОЗУ 2088 и стек 88.
КТ 9. Новый участок, датчик на кронштейне — чувствительность в 1,5 раза выше. В первые сутки исправной работы тревога в 0,3550 окон: монитор здесь — сами тревоги на машинах, которые заведомо исправны. Первые сутки добавлены к норме: на участке ложные 0,0000, все три дефекта 1,0000. Но норма стала шире, и на старых отложенных машинах дисбаланс найден лишь в 0,6146 окон, расцентровка — в 0,5250. Вывод раздела 120 тот же: своя норма у каждого места установки лучше одной общей на всех.
121г.6 Центры объектов на кадре 32 × 32
Задача FOMO в миниатюре: камера над лентой, кадр 32 × 32 в оттенках серого, на нём от 0 до 3 светлых круглых деталей и светлые полосы — помехи, которые деталями не считаются. Ответ — сетка 8 × 8 клеток по 4 × 4 точки: в какой клетке центр детали. Кадр и OpenMV — раздел 121а, детектор на нейроускорителе — 121в.
Сеть: свёртка 3 × 3 из 1 в 8 каналов, ReLU, пул 2; свёртка 3 × 3 из 8 в 16, ReLU, пул 2; свёртка 1 × 1 из 16 в 2 класса на клетку. 1282 параметра, 370 688 умножений на кадр. Обучение — на numpy, своим обратным проходом, клетки с деталью весят в 6 раз больше фона: деталей мало. Соседние клетки с деталью сливаются в одну, как у FOMO, центр — среднее клеток; найденным считается центр не дальше 4 точек от метки.
КТ 1. 3000 кадров из 30 сеансов съёмки (свой фон, свет, шум и контраст), деталей 4519; обучение — 22 сеанса, 2200 кадров; отложено 8 сеансов, 800 кадров. Пикселей в насыщении 341 — меньше 0,1 %.
КТ 2. У 10 кадров разметчик пропустил деталь. Сеть, обученная на другой половине сеансов, поднимает кадры, где она уверена (вероятность больше 0,9) в детали дальше 4 точек от любой метки: поднято 42 кадра, пропуск в 6. Остальные 4 ошибки остались в обучении.
КТ 5–6. На 8 новых сеансах: найдено 1180, лишних 46, пропущено 39, F1 0,9652. В int8 — 1181, 52 и 38, F1 0,9633; сетка ответа int8 совпала с float в 766 кадрах из 800.
КТ 8. Вход int8 — яркость минус 128, дальше только целые числа, поэтому C повторяет Python бит в бит: 800 кадров из 800, ни одной разной клетки. Проверка «объект в клетке» в C — сравнение двух сумм:
g_mask[i] = a1 > a0;
Обработка — 1286 команд, сеть — 5 144 332: почти 14 команд на умножение. Свёртки здесь — простые циклы с проверкой края; ядра CMSIS-NN в разделе 119б дали в 10,7 раза меньше команд, чем эталонные (191 142 против 2 047 791). Образ — 4268 байт флеш-памяти, ОЗУ 11 336 байт: два буфера активаций, 8192 и 2048 байт, вход 1024 байта и сетка ответа 64.
КТ 9 — не пройдена. Другая линия: свет тусклее (контраст 0,6 от прежнего), шум камеры в 1,3 раза выше. F1 0,8794, пропущено 249 деталей. Дообучение на 4 сеансах линии, кадры которых взяты трижды, подняло F1 на 4 других сеансах лишь до 0,8961 — порог 0,90 не взят; на старых отложенных 0,9686. Точка честно показывает: данными не вылечить то, чего нет в кадре. Решение — на приборе: свет или выдержка, затем снова с этапа 1.
121г.7 Грабли
Где конвейер ломается чаще всего:
| Этап | Типичная поломка | Чем ловит точка |
|---|---|---|
| 0. Бюджет | ТЗ пишут после модели — и модель не влезает | бюджет записан до данных, КТ 8 сверяет с ним |
| 1. Сбор | все записи с одного стенда, одного диктора, одного света | группы; отложенные группы не встречаются в обучении |
| 2. Разметка | пропуски и перепутанные метки, «норма» с дефектом | аудит кросс-проверкой: 7 из 8, 6 из 10, 1 из 1 |
| 3. Обработка | признак не видит дефект; на приборе признак считается иначе | выбор версии на стенде; C против Python на признаках |
| 4. Обучение | веса меняются от запуска к запуску | зерно, закреплённые версии, сравнение заголовка |
| 5. Оценка | окна одной записи в обучении и в проверке (раздел 118) | разбиение по группам |
| 6. Квантование | масштаб по выборке без редкого класса, два округления (раздел 119) | int8 против float на тех же окнах |
| 7–8. Прибор | забытая нормировка, порядок весов, интерпретатор со всеми ядрами | C на всех отложенных окнах, байты образа |
| 9. Поле | новый шум, новое крепление, другой свет | монитор без меток, дообучение, повтор конвейера |
Модель хорошая, прибор — нет. Признаки на приборе посчитаны не тем кодом. Блок обработки — часть модели: тот же алгоритм, те же таблицы, сверка C с Python на всех отложенных окнах, а не на одном.
Признаки дороже сети. У ключевого слова обработка — 1 431 634
команды, сеть — 25 345. Оптимизировать сеть бесполезно, пока не
посчитан блок обработки; в потоке его считают кусками, как
run_classifier_continuous().
Признаки выбрали по отложенным машинам. После этого они уже не отложенные. Для выбора — стенд или кросс-проверка, отложенные — один раз в конце.
Аудит разметки поднял много лишнего. Так и должно быть: 13 окон на 8 ошибок, 42 кадра на 10. Аудит не правит метки сам — он даёт человеку короткий список.
В поле меток нет. Монитор — то, что видно без них: доля неуверенных ответов, тревоги на заведомо исправных машинах. Размеченная выборка из поля нужна для решения, а не для наблюдения.
Дообучили на новом месте — испортили старое. Общая норма стала шире, и дефекты на старых машинах прячутся. Своя норма у каждого места или проверка дообученной модели и на старых отложенных.
Данными не исправить физику. Тусклый кадр после дообучения — F1 0,8961 вместо 0,90. Свет, крепление датчика, микрофон — чинят на приборе.
121г.8 Итоги
- Конвейер — десять этапов с контрольной точкой после каждого: число из прогона против бюджета или порога приёмки; «!!» — назад, не дальше.
- Edge Impulse: импульс = окно + блоки обработки + блоки обучения;
EON Compiler превращает граф в код без интерпретатора; библиотека —
run_classifier(signal_t *, ei_impulse_result_t *). Студия требует учётной записи; в 1.74.17 часть файлов DSP — только по платной подписке, 1.56.2 — Apache 2.0. - Ключевое слово: 310 признаков MFCC, сеть 310 → 16 → 3 в int8 — полнота 0,9833, ложные 0,0167; 1 456 979 команд, 12 976 байт флеш-памяти, ОЗУ 3612 + 112.
- Аномалии: признаки переделаны на стенде — расцентровка 0,2292 → 1,0000; на новых машинах ложные 0,0063; 41 755 команд, 7512 байт.
- Центры объектов: 1282 параметра int8, F1 0,9633; C повторяет Python бит в бит; 5 145 618 команд, 4268 байт, ОЗУ 11 336 + 196.
- Аудит разметки нашёл 7 из 8, 6 из 10 и 1 из 1 подложенных ошибок.
- Поле: вентилятор — неуверенных ответов 0,2083 вместо 0,0389, дообучение вернуло ложные к 0,0083; кронштейн — 0,3550 тревог на исправных; тусклый свет — F1 0,8961, данными не лечится.
- Оценка снизу при 168 МГц и 40 мА: 8,67 мс и 1145 мкДж на ответ у ключевого слова, 0,25 мс и 33 мкДж у аномалий, 30,63 мс и 4043 мкДж у кадра.
Полные исходники
Генератор данных и этапы 0–7 и 9 (stages121e.py), сборки для ПК и
QEMU (host121e.sh, qemu121e.sh, bench121e.c, bench121e.ld) и
программа для armlink (main121e.c) лежат в _verify/ml121e/; ниже —
вывод на C и сам конвейер.
impulse121e.c — импульс целиком на C для трёх задач.
/* Раздел 121г: импульс целиком — блок обработки и блок обучения — на C, без интерпретатора.
 * TASK=1 — ключевое слово (MFCC + перцептрон int8), TASK=2 — аномалии вибрации (полосы + K-средних),
 * TASK=3 — центры объектов на кадре 32 × 32 (свёрточная сеть int8, сетка 8 × 8).
 * Таблицы и веса — model_<задача>.h из stages121e.py. С -DML_HOST main() читает test_<задача>.bin
 * и сверяет ответы с Python; с -DML_BENCH файл включает bench121e.c (QEMU). */
#include <math.h>
#include <stdint.h>

#if TASK == 1
#include "model_kws.h"
#elif TASK == 2
#include "model_anom.h"
#else
#include "model_vision.h"
#endif

#if TASK != 2
/* Сдвиг множителем Q31 с одним округлением — тот же, что requant() в stages121e.py. */
static int32_t requant(int32_t acc, int64_t m0, int sh)
{
    return (int32_t)(((int64_t)acc * m0 + ((int64_t)1 << (30 + sh))) >> (31 + sh));
}
#endif

#if TASK != 3
/* БПФ по основанию 2 на 256 точек на месте; TW_C/TW_S — cos и −sin угла 2πk/256. */
static void fft256(float *re, float *im)
{
    int i, j = 0, len, k;
    for (i = 1; i < 256; i++) {
        int bit = 128;
        for (; j & bit; bit >>= 1)
            j ^= bit;
        j ^= bit;
        if (i < j) {
            float t = re[i]; re[i] = re[j]; re[j] = t;
            t = im[i]; im[i] = im[j]; im[j] = t;
        }
    }
    for (len = 2; len <= 256; len <<= 1) {
        int step = 256 / len;
        for (i = 0; i < 256; i += len)
            for (k = 0; k < len / 2; k++) {
                float wr = TW_C[k * step], wi = TW_S[k * step];
                float *ar = &re[i + k], *ai = &im[i + k], *br = &re[i + k + len / 2], *bi = &im[i + k + len / 2];
                float xr = *br * wr - *bi * wi, xi = *br * wi + *bi * wr;
                *br = *ar - xr; *bi = *ai - xi;
                *ar += xr; *ai += xi;
            }
    }
}
static float g_re[256], g_im[256];
#endif

#if TASK == 1
static float g_cep[N_FEAT];
int8_t g_feat[N_FEAT];

/* Блок обработки: предыскажение, окно Хэмминга, БПФ, мел-полосы, ln, ДКП-II, вычитание среднего, int8. */
void dsp_run(const int16_t *x)
{
    int f, i, m, k, off;
    for (f = 0; f < N_FR; f++) {
        for (i = 0; i < FRAME; i++) {
            int n = f * FRAME + i;
            float prev = n ? (float)x[n - 1] : 0.0f;
            float v = n ? ((float)x[n] - 0.97f * prev) : (float)x[n];
            g_re[i] = v * (1.0f / 32768.0f) * HAM[i];
            g_im[i] = 0.0f;
        }
        fft256(g_re, g_im);
        for (i = 0; i <= FRAME / 2; i++)
            g_re[i] = g_re[i] * g_re[i] + g_im[i] * g_im[i];      /* мощность — на месте */
        for (m = 0, off = 0; m < N_MEL; m++) {
            float s = 0.0f;
            for (i = 0; i < MEL_LN[m]; i++)
                s += MEL_W[off + i] * g_re[MEL_ST[m] + i];
            off += MEL_LN[m];
            g_im[m] = logf(s + 1e-6f);
        }
        for (k = 0; k < N_CEP; k++) {
            float s = 0.0f;
            for (m = 0; m < N_MEL; m++)
                s += DCTM[k * N_MEL + m] * g_im[m];
            g_cep[f * N_CEP + k] = s;
        }
    }
    for (k = 0; k < N_CEP; k++) {
        float mean = 0.0f;
        for (f = 0; f < N_FR; f++)
            mean += g_cep[f * N_CEP + k];
        mean /= N_FR;
        for (f = 0; f < N_FR; f++) {
            float q = floorf((g_cep[f * N_CEP + k] - mean) * IN_SCALE_INV + 0.5f);
            g_feat[f * N_CEP + k] = (int8_t)(q > 127.0f ? 127 : q < -127.0f ? -127 : q);
        }
    }
}

/* Блок обучения: 310 → 16 (ReLU) → 3 в int8, ответ — номер наибольшего выхода. */
int nn_run(void)
{
    int8_t h[N_HID];
    int32_t o[N_CLS];
    int i, j, best = 0;
    for (j = 0; j < N_HID; j++) {
        int32_t acc = B1[j];
        for (i = 0; i < N_FEAT; i++)
            acc += g_feat[i] * W1[i * N_HID + j];
        acc = requant(acc, M1, SH1);
        h[j] = (int8_t)(acc < 0 ? 0 : acc > 127 ? 127 : acc);
    }
    for (j = 0; j < N_CLS; j++) {
        int32_t acc = B2[j];
        for (i = 0; i < N_HID; i++)
            acc += h[i] * W2[i * N_CLS + j];
        o[j] = acc;
    }
    for (j = 1; j < N_CLS; j++)
        if (o[j] > o[best])
            best = j;
    return best;
}

#elif TASK == 2
float g_feat[N_FEAT];
float g_score;

/* Блок обработки: СКЗ и log10 мощности в полосах спектра. */
void dsp_run(const int16_t *x)
{
    float mean = 0.0f, ss = 0.0f;
    int i, b;
    for (i = 0; i < N_WIN; i++)
        mean += x[i] * (1.0f / LSB_G);
    mean /= N_WIN;
    for (i = 0; i < N_WIN; i++) {
        float y = x[i] * (1.0f / LSB_G) - mean;
        ss += y * y;
        g_re[i] = y * HANN[i];
        g_im[i] = 0.0f;
    }
    g_feat[0] = sqrtf(ss / N_WIN);
    fft256(g_re, g_im);
    for (b = 0; b < N_BAND; b++) {
        float s = 0.0f;
        for (i = EDGE[b]; i < EDGE[b + 1]; i++)
            s += g_re[i] * g_re[i] + g_im[i] * g_im[i];
        g_feat[1 + b] = log10f(s + 1e-9f);
    }
}

/* Блок аномалий как в Edge Impulse: нормировка, расстояние до центра минус радиус кластера, минимум. */
int nn_run(void)
{
    float z[N_FEAT], best = 1000.0f;
    int i, k;
    for (i = 0; i < N_FEAT; i++)
        z[i] = (g_feat[i] - MU[i]) / SD[i];
    for (k = 0; k < N_CL; k++) {
        float d = 0.0f;
        for (i = 0; i < N_FEAT; i++) {
            float t = z[i] - CEN[k * N_FEAT + i];
            d += t * t;
        }
        d = sqrtf(d) - RAD[k];
        if (d < best)
            best = d;
    }
    g_score = best;
    return best > THR;
}

#else
static int8_t g_in[IM * IM];
static int8_t g_a[IM * IM * 8];       /* выход свёртки 1 (32×32×8), затем свёртки 2 (16×16×16) */
static int8_t g_b[16 * 16 * 8];       /* после пула 1 (16×16×8), затем после пула 2 (8×8×16) */
uint8_t g_mask[GRID * GRID];

/* Блок обработки: яркость 0…255 → int8 со смещением 128 (масштаб 1/128). */
void dsp_run(const uint8_t *p)
{
    int i;
    for (i = 0; i < IM * IM; i++)
        g_in[i] = (int8_t)(p[i] - 128);
}

/* Свёртка 3×3 с нулями по краю, HWC; веса [(dy·3+dx)·cin + c][cout], ReLU и сдвиг в int8. */
static void conv3(const int8_t *x, int n, int cin, int8_t *y, int cout, const int8_t *w, const int *b,
                  int64_t m0, int sh)
{
    int r, c, k, dy, dx, ch;
    for (r = 0; r < n; r++)
        for (c = 0; c < n; c++)
            for (k = 0; k < cout; k++) {
                int32_t acc = b[k];
                for (dy = 0; dy < 3; dy++)
                    for (dx = 0; dx < 3; dx++) {
                        int rr = r + dy - 1, cc = c + dx - 1;
                        if (rr < 0 || rr >= n || cc < 0 || cc >= n)
                            continue;
                        for (ch = 0; ch < cin; ch++)
                            acc += x[(rr * n + cc) * cin + ch] * w[((dy * 3 + dx) * cin + ch) * cout + k];
                    }
                acc = requant(acc, m0, sh);
                y[(r * n + c) * cout + k] = (int8_t)(acc < 0 ? 0 : acc > 127 ? 127 : acc);
            }
}

static void pool2(const int8_t *x, int n, int ch, int8_t *y)
{
    int r, c, k;
    for (r = 0; r < n / 2; r++)
        for (c = 0; c < n / 2; c++)
            for (k = 0; k < ch; k++) {
                int8_t m = x[((2 * r) * n + 2 * c) * ch + k], t;
                t = x[((2 * r) * n + 2 * c + 1) * ch + k]; m = t > m ? t : m;
                t = x[((2 * r + 1) * n + 2 * c) * ch + k]; m = t > m ? t : m;
                t = x[((2 * r + 1) * n + 2 * c + 1) * ch + k]; m = t > m ? t : m;
                y[(r * (n / 2) + c) * ch + k] = m;
            }
}

/* Блок обучения: две свёртки с пулом и свёртка 1×1 на 2 класса; объект в клетке, если выход 1 больше выхода 0. */
int nn_run(void)
{
    int i, c, found = 0;
    conv3(g_in, IM, 1, g_a, 8, W1, B1, M1, SH1);
    pool2(g_a, IM, 8, g_b);
    conv3(g_b, IM / 2, 8, g_a, 16, W2, B2, M2, SH2);
    pool2(g_a, IM / 2, 16, g_b);
    for (i = 0; i < GRID * GRID; i++) {
        int32_t a0 = B3[0], a1 = B3[1];
        for (c = 0; c < 16; c++) {
            a0 += g_b[i * 16 + c] * W3[c * 2];
            a1 += g_b[i * 16 + c] * W3[c * 2 + 1];
        }
        g_mask[i] = a1 > a0;
        found += g_mask[i];
    }
    return found;
}
#endif

#ifdef ML_HOST
#include <stdio.h>
#include <stdlib.h>
int main(int argc, char **argv)
{
    FILE *fp = fopen(argv[1], "rb");
    int32_t hd[4];
    int n, i, agree = 0;
    if (!fp || argc < 2 || fread(hd, 4, 4, fp) != 4)
        return 1;
    n = hd[0];
#if TASK == 1
    {
        int16_t *x = malloc(sizeof(int16_t) * N_WIN);
        int8_t *fq = malloc(N_FEAT), *cls = malloc(n);
        int *mine = malloc(sizeof(int) * n), diff = 0, maxd = 0, same_feat = 0;
        for (i = 0; i < n; i++) {
            int j, d0 = diff;
            if (fread(x, 2, N_WIN, fp) != N_WIN || fread(fq, 1, N_FEAT, fp) != N_FEAT)
                return 1;
            dsp_run(x);
            for (j = 0; j < N_FEAT; j++) {
                int d = abs(g_feat[j] - fq[j]);
                diff += d != 0;
                maxd = d > maxd ? d : maxd;
            }
            same_feat += diff == d0;
            mine[i] = nn_run();
        }
        if (fread(cls, 1, n, fp) != (size_t)n)
            return 1;
        for (i = 0; i < n; i++)
            agree += mine[i] == cls[i];
        printf("agree=%d,%d\nfeat_diff=%d,%d\nfeat_maxdiff=%d\nwindows_same_feat=%d\n", agree, n, diff, n * N_FEAT, maxd, same_feat);
    }
#elif TASK == 2
    {
        int16_t *x = malloc(sizeof(int16_t) * N_WIN);
        float *sc = malloc(sizeof(float) * n), *mys = malloc(sizeof(float) * n), maxd = 0.0f;
        int8_t *al = malloc(n);
        int *mine = malloc(sizeof(int) * n);
        for (i = 0; i < n; i++) {
            if (fread(x, 2, N_WIN, fp) != N_WIN)
                return 1;
            dsp_run(x);
            mine[i] = nn_run();
            mys[i] = g_score;
        }
        if (fread(sc, 4, n, fp) != (size_t)n || fread(al, 1, n, fp) != (size_t)n)
            return 1;
        for (i = 0; i < n; i++) {
            float d = fabsf(mys[i] - sc[i]);
            maxd = d > maxd ? d : maxd;
            agree += mine[i] == al[i];
        }
        printf("agree=%d,%d\nscore_maxdiff=%.2e\n", agree, n, (double)maxd);
    }
#else
    {
        uint8_t *x = malloc(IM * IM), *mk = malloc((size_t)n * GRID * GRID);
        uint8_t *mine = malloc((size_t)n * GRID * GRID);
        int cells = 0;
        for (i = 0; i < n; i++) {
            if (fread(x, 1, IM * IM, fp) != IM * IM)
                return 1;
            dsp_run(x);
            nn_run();
            for (int j = 0; j < GRID * GRID; j++)
                mine[i * GRID * GRID + j] = g_mask[j];
        }
        if (fread(mk, 1, (size_t)n * GRID * GRID, fp) != (size_t)n * GRID * GRID)
            return 1;
        for (i = 0; i < n; i++) {
            int same = 1;
            for (int j = 0; j < GRID * GRID; j++) {
                int d = mine[i * GRID * GRID + j] != mk[i * GRID * GRID + j];
                cells += d;
                same &= !d;
            }
            agree += same;
        }
        printf("agree=%d,%d\ncells_diff=%d,%d\n", agree, n, cells, n * GRID * GRID);
    }
#endif
    fclose(fp);
    return 0;
}
#elif defined(ML_BENCH)
#include "bench121e.c"
#endif
run121e.py — конвейер: этапы, прибор и отчёт контрольных точек.
# -*- coding: utf-8 -*-
"""Раздел 121г: конвейер TinyML целиком — для любой из трёх задач все этапы и отчёт контрольных точек.

python run121e.py <kws|anom|vision|all> [каталог_вывода]

1. stages121e.py в образе stm-ml:1 — КТ 0–7 и 9: бюджет, сбор, разметка, обработка сигнала, обучение,
   оценка на отложенных записях, квантование, выгрузка, поле;
2. КТ 8 — прибор: impulse121e.c, собранный gcc на ПК (stm-sys:1), против ответов Python на всех
   отложенных окнах; команды на ответ в QEMU netduinoplus2 (stm-arm:1, -icount: команды, не такты);
   флеш и ОЗУ — образ, связанный armclang/armlink для Cortex-M4 (с библиотекой: logf, sqrtf …);
   время и энергия — оценка снизу: команды / 168 МГц и 40 мА · 3,3 В (DS8626 Rev 9, табл. 20).
Каталог armclang — переменная ARMCLANG_BIN, иначе ищется в PATH."""
import os
import re
import shutil
import subprocess
import sys
import tempfile

sys.stdout.reconfigure(encoding="utf-8", errors="replace")
HERE = os.path.dirname(os.path.abspath(__file__))
H_ = HERE.replace("\\", "/")
BIN = os.environ.get("ARMCLANG_BIN") or os.path.dirname(shutil.which("armclang") or "")
TASKS = ["kws", "anom", "vision"]
NUM = {"kws": 1, "anom": 2, "vision": 3}
F_HZ, I_A, V_V = 168e6, 0.040, 3.3                                   # DS8626 Rev 9, табл. 20: 168 МГц, периферия выкл., тип.


def run(args, cwd=None, timeout=1800):
    r = subprocess.run(args, capture_output=True, text=True, encoding="utf-8", errors="replace", cwd=cwd, timeout=timeout)
    return r.returncode, (r.stdout + r.stderr).replace("\r\n", "\n")


def main():
    which = sys.argv[1] if len(sys.argv) > 1 else "all"
    tasks = TASKS if which == "all" else [which]
    out = sys.argv[2] if len(sys.argv) > 2 else tempfile.mkdtemp(prefix="p121e_")
    os.makedirs(out, exist_ok=True)
    O_ = os.path.abspath(out).replace("\\", "/")
    stages = {}
    for t in tasks:
        rc, o = run(["docker", "run", "--rm", "-v", H_ + ":/v:ro", "-v", O_ + ":/o", "-w", "/v", "stm-ml:1",
                     "python", "-I", "stages121e.py", t, "/o"])
        if rc:
            print("!! stages121e.py %s: %s" % (t, o[-800:]))
            return 1
        stages[t] = open(os.path.join(out, "stages_%s.txt" % t), encoding="utf-8").read()
    # прибор: C на ПК против Python
    _, host = run(["docker", "run", "--rm", "-v", H_ + ":/v:ro", "-v", O_ + ":/o", "stm-sys:1", "sh", "/v/host121e.sh"])
    # команды в QEMU
    _, qemu = run(["docker", "run", "--rm", "-v", H_ + ":/v:ro", "-v", O_ + ":/o", "stm-arm:1", "sh", "/v/qemu121e.sh"])
    # флеш и ОЗУ: armclang + armlink
    tmp = tempfile.mkdtemp(prefix="a121e_")
    shutil.copy(os.path.join(HERE, "main121e.c"), tmp)
    sizes = {}
    for t in tasks:
        cc = [BIN + "/armclang.exe", "--target=arm-arm-none-eabi", "-mcpu=cortex-m4", "-mfpu=fpv4-sp-d16", "-mfloat-abi=hard",
              "-O2", "-Wall", "-Wextra", "-ffunction-sections", "-fdata-sections", "-DTASK=%d" % NUM[t], "-I" + out]
        r1, o1 = run(cc + ["-c", "-o", os.path.join(tmp, t + ".o"), os.path.join(HERE, "impulse121e.c")])
        r2, o2 = run(cc + ["-c", "-o", os.path.join(tmp, "m_" + t + ".o"), os.path.join(tmp, "main121e.c")])
        r3, o3 = run([BIN + "/armlink.exe", "--cpu=Cortex-M4.fp.sp", "--ro-base=0x08000000", "--rw-base=0x20000000",
                      "--entry=main", "--no_startup", "--remove", "--info=sizes,totals", "-o", os.path.join(tmp, t + ".axf"),
                      os.path.join(tmp, t + ".o"), os.path.join(tmp, "m_" + t + ".o")])
        _, oz = run([BIN + "/fromelf.exe", "--text", "-z", os.path.join(tmp, t + ".o")])
        obj = re.search(r"^\s*(\d+)\s+(\d+)\s+(\d+)\s+(\d+)\s+(\d+)\s+\d+\s+\S+\.o\s*$", oz, re.M)
        lib = re.search(r"^\s*(\d+)\s+\d+\s+(\d+)\s+(\d+)\s+(\d+)\s+\d+\s+Library Totals", o3, re.M)
        rom = re.search(r"Total ROM Size \(Code \+ RO Data \+ RW Data\)\s+(\d+)", o3)
        ram = re.search(r"Total RW  Size \(RW Data \+ ZI Data\)\s+(\d+)", o3)
        warn = ("warning" in o1 + o2 + o3) or r1 or r2 or r3
        sizes[t] = dict(obj=[int(obj.group(i)) for i in (1, 3, 5)] if obj else None, lib=int(lib.group(1)) if lib else -1,
                        rom=int(rom.group(1)) if rom else -1, ram=int(ram.group(1)) if ram else -1, warn=bool(warn))
    shutil.rmtree(tmp, ignore_errors=True)
    _, ver = run([BIN + "/armclang.exe", "--version"])
    ver = ver.splitlines()[0] if ver else "?"

    for t in tasks:
        S = stages[t]
        kv = dict(ln.split("=", 1) for ln in S.splitlines() if re.match(r"^\w+=", ln))
        bud = [int(v) for v in kv["budget"].split(",")]
        hb = host.split("== %s build=" % t)[1].split("\n== ")[0].split("\ngcc ")[0]
        hk = dict(ln.split("=", 1) for ln in hb.splitlines() if re.match(r"^\w+=", ln))
        qb = qemu.split("== %s build=" % t)[1].split("\n== ")[0]
        cal = int(re.search(r"cal insn=2000000 ticks=(\d+)", qb).group(1))
        tk = lambda k: int(re.search(k + r" ticks=(\d+)", qb).group(1))
        ins = lambda v: int(round(v * 2000000.0 / cal))
        i_dsp, i_nn = ins(tk("dsp")), ins(tk("nn"))
        stack = int(re.search(r"stack bytes=(\d+)", qb).group(1))
        z = sizes[t]
        tot = i_dsp + i_nn
        t_ms = tot / F_HZ * 1e3
        e_uj = I_A * V_V * tot / F_HZ * 1e6
        load = tot * bud[3] / F_HZ
        ag = hk.get("agree", "0,1").split(",")
        ok_c = hb.startswith("0") and ag[0] == ag[1]
        ok8 = ok_c and z["rom"] <= bud[0] and z["ram"] + stack <= bud[1] and tot <= bud[2] and not z["warn"]
        extra = {"kws": "признаки int8: разных %s из %s элементов, не больше чем на %s" % (
                     *hk.get("feat_diff", "?,?").split(","), hk.get("feat_maxdiff", "?")),
                 "anom": "оценка отличается не больше чем на %s" % hk.get("score_maxdiff", "?"),
                 "vision": "клеток сетки разошлось %s" % hk.get("cells_diff", "?,?").split(",")[0]}[t]
        kt8 = ("КТ8 прибор: %s — C (gcc, ПК) и Python согласны в %s из %s ответов, %s; QEMU: обработка %d команд, "
               "модель %d, всего %d (бюджет %d); не меньше %.2f мс и %.0f мкДж на ответ при 168 МГц, загрузка ядра "
               "%.2f %%; armclang: флеш %d Б (бюджет %d), ОЗУ %d Б + стек %d Б (бюджет %d)"
               % ("ok" if ok8 else "!!", ag[0], ag[1], extra, i_dsp, i_nn, tot, bud[2], t_ms, e_uj, 100 * load,
                  z["rom"], bud[0], z["ram"], stack, bud[1])).replace(".", ",")
        rep = [ln for ln in S.splitlines() if ln.startswith("КТ")]
        rep.insert(next(i for i, ln in enumerate(rep) if ln.startswith("КТ9")), kt8)
        print("════ %s ════" % t)
        print("\n".join(rep))
        print("c_%s=%s" % (t, ",".join(ag)))
        print("insn_%s=%d,%d,%d" % (t, i_dsp, i_nn, tot))
        print("size_%s=%d,%d,%d,%d,%s" % (t, z["rom"], z["ram"], stack, z["lib"], ",".join(str(v) for v in z["obj"])))
        print("est_%s=%.3f,%.1f,%.4f" % (t, t_ms, e_uj, load))
    print("armclang=%s" % ver)
    print("qemu=%s" % (qemu.strip().splitlines()[-1] if qemu.strip() else "?"))
    print("gcc_host=%s" % (host.strip().splitlines()[-1] if host.strip() else "?"))
    return 0


if __name__ == "__main__":
    sys.exit(main())
Дальше: раздел 121д «Промышленные кейсы TinyML: состояние мотора, насоса и вентилятора, утечка по звуку, счёт и обнаружение объектов в кадре — что решали, чем и где ошиблись» — пять задач цеха от постановки до поля: что сломалось при смене оборотов, экземпляра, фона и света и чем это исправили.