 Embedded HandbookПриложения
121в. STM32N6 и камера с нейросетью на батарейке: YOLO на NPU Neural-ART, малое потребление, уличный прибор
Раздел 121а разобрал OpenMV на STM32H7: кадр, пятна, маленькая сеть через TensorFlow Lite Micro. YOLOv8n на 3,2 МБ туда уже не помещалась — в таблице плат осталась строка OPENMV_N6. Здесь — этот камень: STM32N6 с ускорителем нейросетей Neural-ART, и то, ради чего его ставят в уличный прибор: камера спит, по датчику движения просыпается, снимает, находит на кадре людей, животных или машины и отправляет короткое сообщение.
В разделе три части. Первая — сам STM32N6 и путь кадра до NPU по документации ST и исходникам OpenMV. Вторая — свой код постобработки YOLO для Cortex-M55: выход сети int8 превращается в рамки, лишние рамки снимает NMS. Код прогнан на ПК, на Cortex-M55 в QEMU с Helium и без и сверен с независимым расчётом на numpy — в том числе на настоящем выходе модели yolov8n_192 из OpenMV на снимке человека. Третья — энергобюджет на 18650 и техническое задание на прибор.
Чего здесь нет. Платы с STM32N6 под рукой у раздела не было: токи взяты из даташита, время фаз и токи NPU, датчика и радио — оценки, и они помечены. Модель на NPU не запускалась — её выход получен интерпретатором TensorFlow Lite на ПК.
Опоры: даташит STM32N6x5/x7 —
DS14791 Rev 11,
справочник
RM0486 Rev 4,
заголовок CMSIS stm32n657xx.h и описание SVD из пакета поддержки
STM32N6. Исходники OpenMV —
github.com/openmv/openmv, коммит
62369938a94b: файлы плат и примеры — MIT; модуль ml, обёртка NPU
lib/stai/stai_backend.c, постобработка ml.postprocessing и драйвер
камеры — под некоммерческой лицензией OpenMV, поэтому здесь только
пересказ со ссылкой на файл и строку; библиотека ST lib/stai/libstai —
SLA0044. Квантование int8 — раздел 119, OpenMV и пул памяти — 121а,
DCMI и DMA — 22б, кэш — 11б, режимы сна — 10 и 10а, Li-ion — 173б,
LoRa и время в эфире — 89, 93, 94, обновление прошивки — 48, 48а–48г.
Как это называется в документации
Оригинал Перевод NPU (neural processing unit), Neural-ART accelerator нейроускоритель, ускоритель нейросетей ST CA (convolutional accelerator) блок свёртки в NPU epoch эпоха: кусок сети, который NPU считает без процессора, до прерывания stream engine, stream switch потоковый DMA ускорителя и коммутатор потоков relocatable model перемещаемая модель: образ, который ставится по любому адресу DCMIPP (pixel pipeline), ISP (image signal processor) конвейер точек камеры, обработка сигнала датчика CSI-2 (camera serial interface) последовательный интерфейс камеры MIPI MVE (M-profile vector extension), Helium векторные команды Cortex-M55 anchor якорь: точка сетки (YOLOv8) или заготовка рамки (YOLOv2) objectness объектность: «здесь есть объект» NMS (non-maximum suppression) подавление пересекающихся рамок IoU (intersection over union) пересечение, делённое на объединение class-agnostic NMS NMS без учёта класса PIR (passive infrared) sensor пироэлектрический датчик движения duty cycle доля времени в эфире
121в.1 STM32N6 коротко
STM32N6 — Cortex-M55 на 800 МГц с векторными командами Helium (MVE) и
FPU половинной, одинарной и двойной точности. В линейке N6x7 рядом
стоит NPU Neural-ART: до 1 ГГц, по даташиту — 600 Gops и 288 умножений
с накоплением за такт (DS14791, с. 1). Наше «Gops» нигде не мерилось —
это цифра ST. Внутри NPU (RM0486, табл. 108): 4 блока свёртки, 2 блока
пулинга, 2 активации, 4 арифметических, 10 потоковых DMA со
встроенным шифрованием, 2 шины AXI по 64 бита. Те же числа — в
заголовке библиотеки ST, которую собирает OpenMV:
ATON_CONVACC_NUM 4, ATON_STRENG_NUM 10 (lib/stai/libstai/include/ATON.h).
Флеш-памяти нет. В расшифровке обозначения у N6 размер флеш-памяти
«0 = 0–1 Kbytes» (DS14791, с. 262). После сброса работает ПЗУ: по
выводам BOOT0, BOOT1 и слову OTP оно грузит прошивку с внешней памяти —
XSPI NOR, HyperFlash, e.MMC или SD-карты (RM0486, 9.1.1) — или по USB и
UART. Как это выглядит у OpenMV N6 (boards/OPENMV_N6/board_config.mk,
строки 8–10): начало флеш-памяти — 0x70000000, прошивка — с
0x70080000, загрузчик OpenMV — в ОЗУ с 0x34180400. Карта внешней
флеш-памяти на 32 МБ на XSPI2 при 200 МГц — в boot_config.h
(строки 47–49 и 76–79): загрузчик 512 КБ, прошивка, файловая система,
ROMFS с моделями с 0x800000. В пакете CMSIS для N6 «Flash» тоже
начинается с 0x34180400 — это ОЗУ, куда ПЗУ кладёт первый загрузчик.
Память. ОЗУ на AXI — две части по 1 МБ и четыре по 448 КБ
(SRAM1_AXI_SIZE … SRAM6_AXI_SIZE в stm32n657xx.h), плюс
TCM 64 + 128 КБ и 8 КБ резервного ОЗУ. Четыре блока по 448 КБ с
0x34200000 — ОЗУ, которое отдают NPU: у OpenMV это пул на 1792 КБ
(board_config.h, строки 172–174 и 187–188), у компилятора ST — пулы
npuRAM3…npuRAM6 (lib/stai/scripts/stm32n6.mpool). Кэш NPU для
внешней памяти (CACHEAXI) — 256 КБ (CACHEAXI_RAM_SIZE 0x40000UL).
Веса модели живут во внешней флеш-памяти и читаются на месте, кадры и
большие буферы у OpenMV — во внешней PSRAM на 64 МБ с 0x90000000
(строки 191–192, пул UMA на 31 МБ — строка 164).
Камера. У N6 две дороги для кадра (RM0486, 37.1): старый DCMI до
24 Мточек/с и DCMIPP — до 5 Мп при 30 кадрах/с, параллельно до 120 МГц
или по CSI-2 до 2,5 Гбит/с на линию по двум линиям, с ISP (дебайер,
экспозиция, баланс белого, контраст, битые точки) и двумя прикладными
конвейерами с обрезкой и уменьшением. Выход ISP может идти в NPU по DMA
(DS14791, с. 14). OpenMV N6 работает через DCMIPP: конвейер 1, такт
датчика 24 МГц от TIM1, для датчиков MIPI — путь CSI-2
(board_config.h, строки 134 и 307; ports/stm32/omv_csi.c).
Видео и JPEG. Аппаратный JPEG и кодер H.264 до 1080p при 15
кадрах/с (DS14791, с. 1). В SVD это блоки JPEG по 0x48023000 и
VENC («Video encoder») по 0x48005000; у OpenMV кодер подключён через
drivers/vc8000 (H264EncInit). Для прибора на батарейке видео не
нужно — нужна вырезка в JPEG.
| STM32H743 (121а) | STM32U585 (198х) | STM32N657 | |
|---|---|---|---|
| ядро | Cortex-M7, 480 МГц | Cortex-M33, 160 МГц | Cortex-M55, 800 МГц, Helium |
| нейросеть | на ядре | на ядре | NPU, 600 Gops по ST |
| флеш-память | 2 МБ внутри | 2 МБ внутри | нет, внешняя по XSPI |
| камера | DCMI | DCMI | DCMI и DCMIPP с ISP, CSI-2 |
| сон с часами | раздел 10 | Stop 2, Standby (10а) | Standby 90,4 мкА при 1,8 В |
121в.2 Кадр, NPU и выход YOLO
Как модель попадает в NPU. Модель .tflite прогоняет компилятор ST
Edge AI: настройки OpenMV — lib/stai/scripts/neuralart.json (профиль
с --enable-epoch-controller, пулы из stm32n6.mpool, на кристалле —
до 1024 КБ). Получается перемещаемый образ: код эпох и веса. Сеть
считается эпохами — кусками, которые NPU проходит сам, от настройки
процессором до прерывания (RM0486, 20.1). Что делает OpenMV
(lib/stai/stai_backend.c, пересказ):
- включает такт и сброс NPU и его кэша (
ml_backend_npu_init); - переносит образ модели во внешнюю память, если он лёг во внутреннюю:
перемещаемые пулы NPU должны быть во внешней памяти — граница
0x60000000(строки 53–58); - ставит модель в режиме XIP — код эпох исполняется прямо из образа (строка 183) — и чистит кэш данных: NPU ходит в память мимо кэша Cortex-M55 (раздел 11б);
- перед запуском сбрасывает входные буферы из кэша, крутит
LL_ATON_RT_RunEpochBlock, а пока NPU занят, ядро ждёт вWFE(строки 291–307); выходной буфер перед чтением делает недействительным в кэше (строка 351).
Выход YOLOv8. Модель yolov8n_192.tflite из lib/models OpenMV —
3 228 400 байт, вход 192×192×3 uint8. Внутри — int8, на выходе
интерпретатор переводит последний тензор в float. Если отрезать этот
перевод, NPU отдаёт тензор int8 формы [1, 5, 756] с масштабом
0,00507508637 и нулевой точкой −128. 756 — якоря трёх сеток
24×24 + 12×12 + 6×6 (шаги 8, 16, 32 точки). Строки 0–3 — центр и размер
рамки в долях входа, строка 4 — оценка класса person уже после
сигмоиды. Масштаб общий на все пять строк: порог 0,4 — это код −49,
оценка 0,9693 — код 63.
Вторая модель OpenMV, yolo_lc_192.tflite (339 448 байт), — вариант
YOLOv2: выход [1, 12, 12, 30] int8 с масштабом 0,176762134 и нулевой
точкой 73: сетка 12×12, 5 якорей по 6 чисел (tx, ty, tw, th,
объектность, класс). Здесь всё — логиты: нужны сигмоида и экспонента, и
нужны размеры якорей, с которыми модель учили.
Где считать постобработку. У OpenMV — на Python (ulab) в
ml.postprocessing.ultralytics.YoloV8: порог переводится в коды и
сравнивается с сырыми байтами (ultralytics.py, строки 108 и 116),
в float переводятся только прошедшие якоря. NMS у OpenMV — «мягкое»:
оценки соседей умножаются на exp(−IoU²/σ), классы не различаются
(ml-core/ml/utils.py, строки 91 и 119). В приборе без MicroPython эту
работу делает своя функция на C — она ниже.
121в.3 Постобработка на Cortex-M55
Задача: из 756 якорей (или 720 у YOLOv2) получить несколько рамок. Правила своего кода:
- порог — в кодах int8. Наименьший код, чья оценка не ниже порога, ищется один раз перебором 256 значений; дальше сравниваются байты;
- кандидатов не больше 64. Список держится по убыванию оценки; если он полон, новый вытесняет худшего — память постоянная при любом шуме на кадре;
- NMS жадное, по классам (или без них — флаг
agnostic), IoU — в целых:inter · den > union · num, без деления; - экспонента своя, без libm: только сложение и умножение float, поэтому ответ один и тот же на ПК и на M55;
- Helium в поиске кандидатов: 16 якорей за проход.
Порог в кодах:
/* Наименьший код q, у которого оценка уже не ниже порога. Сравнивать дальше можно
 * прямо байты выхода: перевод в float нужен только прошедшим. Недостижимый порог
 * даёт 127 — такой случай отсекает thr_reachable. */
int8_t yp_q_threshold(const yp_cfg_t *c, int logistic)
{
    for (int q = -128; q <= 127; q++) {
        float v = deq(c, q);
        if (logistic) v = sigm(v);
        if (v >= c->conf) return (int8_t)q;
    }
    return (int8_t)127;
}
Список кандидатов:
/* Кандидаты — по убыванию q; при равных раньше найденный выше. Полный список
 * вытесняет худшего: в памяти не больше YP_MAX_CAND рамок при любом шуме. */
static void put(yp_box_t *cand, int *cnt, const yp_box_t *b)
{
    int k = *cnt;
    if (k == YP_MAX_CAND) {
        if (b->q <= cand[k - 1].q) return;
        k--;
    }
    while (k > 0 && cand[k - 1].q < b->q) {
        cand[k] = cand[k - 1];
        k--;
    }
    cand[k] = *b;
    if (*cnt < YP_MAX_CAND) (*cnt)++;
}
Декодер YOLOv8. На M55 цикл идёт по 16 якорей: vld1q_s8 грузит 16
оценок класса, vmaxq_s8 берёт максимум по классам, vcmpgeq_n_s8
сравнивает с порогом и даёт маску — по биту на якорь; разбираются только
поднятые биты. Хвост (756 = 47 · 16 + 4) и сборка без MVE идут
обычным циклом в том же порядке, поэтому результат одинаков:
static int8_t v8_best(const int8_t *out, int n, int nc, int i, int *best)
{
    const int8_t *s = out + 4 * n + i;
    int8_t q = s[0];
    *best = 0;
    for (int k = 1; k < nc; k++)
        if (s[k * n] > q) {
            q = s[k * n];
            *best = k;
        }
    return q;
}

static void v8_take(const int8_t *out, int n, int nc, int i, const yp_cfg_t *c,
                    yp_box_t *cand, int *cnt)
{
    int best;
    yp_box_t b;
    int8_t q = v8_best(out, n, nc, i, &best);
    if (!make_box(deq(c, out[i]), deq(c, out[n + i]), deq(c, out[2 * n + i]),
                  deq(c, out[3 * n + i]), c, &b))
        return;
    b.q = q;
    b.cls = (uint8_t)best;
    put(cand, cnt, &b);
}

int yp_decode_v8(const int8_t *out, int n, int nc, const yp_cfg_t *c,
                 yp_box_t *cand, int *n_above)
{
    int8_t t = yp_q_threshold(c, 0);
    int cnt = 0, above = 0, i = 0;
    if (!thr_reachable(c, 0, t)) {
        *n_above = 0;
        return 0;
    }
#ifdef YP_USE_MVE
    for (; i + 16 <= n; i += 16) {                  /* 16 якорей за проход */
        int8x16_t m = vld1q_s8(out + 4 * n + i);
        for (int k = 1; k < nc; k++)
            m = vmaxq_s8(m, vld1q_s8(out + (4 + k) * n + i));
        uint32_t p = vcmpgeq_n_s8(m, t);            /* бит на каждый байт-якорь */
        while (p) {
            int lane = __builtin_ctz(p);
            p &= p - 1;
            above++;
            v8_take(out, n, nc, i + lane, c, cand, &cnt);
        }
    }
#endif
    for (; i < n; i++) {
        int best;
        if (v8_best(out, n, nc, i, &best) >= t) {
            above++;
            v8_take(out, n, nc, i, c, cand, &cnt);
        }
    }
    *n_above = above;
    return cnt;
}
Внутренний цикл по классам после arm-none-eabi-gcc 12.2.1
(-mcpu=cortex-m55 -O2), дизассемблер с -m armv8.1-m.main:
4a6:    ed93 7e00   vldrb.u8    q3, [r3, #0]
4aa:    dd0c        ble.n   4c6 <yp_decode_v8+0xc6>
4ac:    f10b 3eff   add.w   lr, fp, #4294967295 @ 0xffffffff
4b0:    f04e e001   dls lr, lr
4b4:    9b08        ldr r3, [sp, #32]
4b6:    4443        add r3, r8
4b8:    ed93 5e00   vldrb.u8    q2, [r3, #0]
4bc:    4453        add r3, sl
4be:    ef06 6644   vmax.s8 q3, q3, q2
4c2:    f00f c807   le  lr, 4b8 <yp_decode_v8+0xb8>
4c6:    9b05        ldr r3, [sp, #20]
4c8:    fe07 1f43   vcmp.s8 ge, q3, r3
4cc:    eefd 4a10   vmrs    r4, p0
dls/le — аппаратный цикл M55, vcmp.s8 пишет маску в p0, её
забирает vmrs.
NMS и IoU в целых:
/* Пересечение больше доли num/den от объединения — в целых, без деления. */
static int iou_above(const yp_box_t *a, const yp_box_t *b, const yp_cfg_t *c)
{
    int ax1 = a->x + a->w, bx1 = b->x + b->w, ay1 = a->y + a->h, by1 = b->y + b->h;
    int ix = (ax1 < bx1 ? ax1 : bx1) - (a->x > b->x ? a->x : b->x);
    int iy = (ay1 < by1 ? ay1 : by1) - (a->y > b->y ? a->y : b->y);
    if (ix <= 0 || iy <= 0) return 0;
    int64_t inter = (int64_t)ix * iy;
    int64_t uni = (int64_t)a->w * a->h + (int64_t)b->w * b->h - inter;
    return inter * c->iou_den > uni * c->iou_num;
}

int yp_nms(yp_box_t *b, int n, const yp_cfg_t *c)
{
    int kept = 0;
    for (int i = 0; i < n; i++) {
        int drop = 0;
        for (int j = 0; j < kept && !drop; j++)
            if ((c->agnostic || b[j].cls == b[i].cls) && iou_above(&b[j], &b[i], c))
                drop = 1;
        if (!drop) b[kept++] = b[i];
    }
    return kept;
}
Экспонента для YOLOv2 (сигмоида — 1 / (1 + exp(−x))):
/* exp(x) = 2^m * exp(r), r = x - m*ln2, |r| <= 0,35; ряд до r^6. Только + - * и сдвиг
 * порядка — результат одинаков на любом процессоре с IEEE-754 float. */
float yp_exp(float x)
{
    if (x > 88.0f) x = 88.0f;
    if (x < -87.0f) x = -87.0f;
    float k = x * 1.44269504f;
    int m = (int)(k + (k >= 0.0f ? 0.5f : -0.5f));
    float r = x - (float)m * 0.693145752f;          /* ln2, старшая часть */
    r = r - (float)m * 1.42860677e-06f;             /* ln2, младшая часть */
    float p = 1.0f + r * (1.0f + r * (0.5f + r * (0.166666672f + r * (0.0416666679f
              + r * (0.00833333377f + r * 0.00138888892f)))));
    union { float f; uint32_t u; } s;
    s.u = (uint32_t)(m + 127) << 23;                /* 2^m */
    return p * s.f;
}
Декодер YOLOv2 (yp_decode_v2) устроен так же: порог по объектности в
кодах, класс — argmax сырых логитов (softmax его не меняет), центр —
(клетка + сигмоида) / сетка, размер — якорь · exp(t) / сетка. Он
целиком — в конце раздела.
121в.4 Проверка: синтетика, настоящая модель, M55 в QEMU
Наборы — gen_tensors.py: синтетические выходы со своим генератором и
настоящий выход yolov8n_192. Настоящий получен так: снимок
scripts/unittest/data/person.bmp из OpenMV (400×400, RGB565) уменьшен
до 192×192 и прогнан интерпретатором TensorFlow Lite 2.21.0 со
справочными ядрами; взят тензор int8 перед переводом в float. Лучший
якорь — оценка 0,9693, рамка во весь кадр; выше порога 0,4 — 10 якорей.
Один и тот же main_post.c собран gcc 12.2.0 на ПК и
arm-none-eabi-gcc 12.2.1 для Cortex-M55 — с Helium и с -DYP_NO_MVE.
Обе сборки M55 запущены в QEMU 7.2 на машине mps3-an547 (Cortex-M55),
вывод — полухостингом. Вывод на ПК:
CASE s1_three kind=8 conf=40 agn=0 thr=-49 above=17 cand=17 kept=3
  BOX cls=0 q=45 x=44 y=58 w=29 h=79
  BOX cls=1 q=30 x=100 y=117 w=69 h=39
  BOX cls=2 q=10 x=93 y=48 w=22 h=19
CASE s2_overlap kind=8 conf=40 agn=0 thr=-49 above=11 cand=11 kept=2
  BOX cls=0 q=49 x=62 y=60 w=59 h=103
  BOX cls=1 q=20 x=67 y=55 w=57 h=90
CASE s2_overlap_agn kind=8 conf=40 agn=1 thr=-49 above=11 cand=11 kept=1
  BOX cls=0 q=49 x=62 y=60 w=59 h=103
CASE s3_flood kind=8 conf=40 agn=0 thr=-49 above=240 cand=64 kept=58
CASE s4_v2 kind=2 conf=50 agn=0 thr=73 above=6 cand=6 kept=2
  BOX cls=0 q=84 x=46 y=30 w=40 h=91
  BOX cls=1 q=81 x=104 y=109 w=79 h=48
CASE r1_person_40 kind=8 conf=40 agn=0 thr=-49 above=10 cand=10 kept=1
  BOX cls=0 q=63 x=0 y=0 w=190 h=190
CASE r1_person_25 kind=8 conf=25 agn=0 thr=-78 above=10 cand=10 kept=1
  BOX cls=0 q=63 x=0 y=0 w=190 h=190
DONE
s1_three— три объекта трёх классов, у каждого 6 соседних якорей выше порога: 17 кандидатов, после NMS — 3 рамки. Код 45 = оценка 0,88.s2_overlap— человек и машина почти в одной рамке: NMS по классам оставляет обе, без классов (agn=1, как у OpenMV) — только человека.s3_flood— 240 якорей выше порога: кандидатов 64, после NMS 58.s4_v2— YOLOv2 на сетке 12×12 с тремя своими якорями: 6 кандидатов, 2 рамки.r1_person_40иr1_person_25— настоящая модель: 10 кандидатов, одна рамка 190×190 с кодом 63 (0,9693) при пороге 0,4 и 0,25. Тест OpenMVscripts/unittest/tests/ml_yolov8.pyна этом снимке ждёт того же: ровно одну рамку с оценкой не ниже 0,9 (строки 16–20).
Сверка:
| Что | С чем | Итог |
|---|---|---|
| вывод C на ПК | yolo_post.py — та же логика, каждая операция округлена до float32 |
совпал построчно |
| вывод C на ПК | Cortex-M55 в QEMU, с Helium и без | совпал построчно, обе сборки |
| вывод C на ПК | numpy 2.3.3: тензор целиком в float, np.exp, IoU матрицей |
7 наборов из 7, рамки — расхождение 0 точек |
yp_exp |
math.exp на −20…20 с шагом 0,01 |
относительная ошибка до 1,15·10⁻⁶ |
Размер кода yolo_post.c для Cortex-M55 (-O2): 2488 байт с
Helium и 2328 без; данных и .bss нет. Из них
yp_decode_v8 — 404 и 414 байт, yp_decode_v2 — 684,
yp_nms — 374, yp_exp — 332. Команд с векторными
регистрами q в сборке без Helium — 0, с Helium — 4: две
vldrb.u8, vmax.s8 и vcmp.s8 из листинга выше. Сколько тактов это занимает на настоящем M55 — не мерилось:
QEMU такты не считает.
121в.5 Энергобюджет на 18650
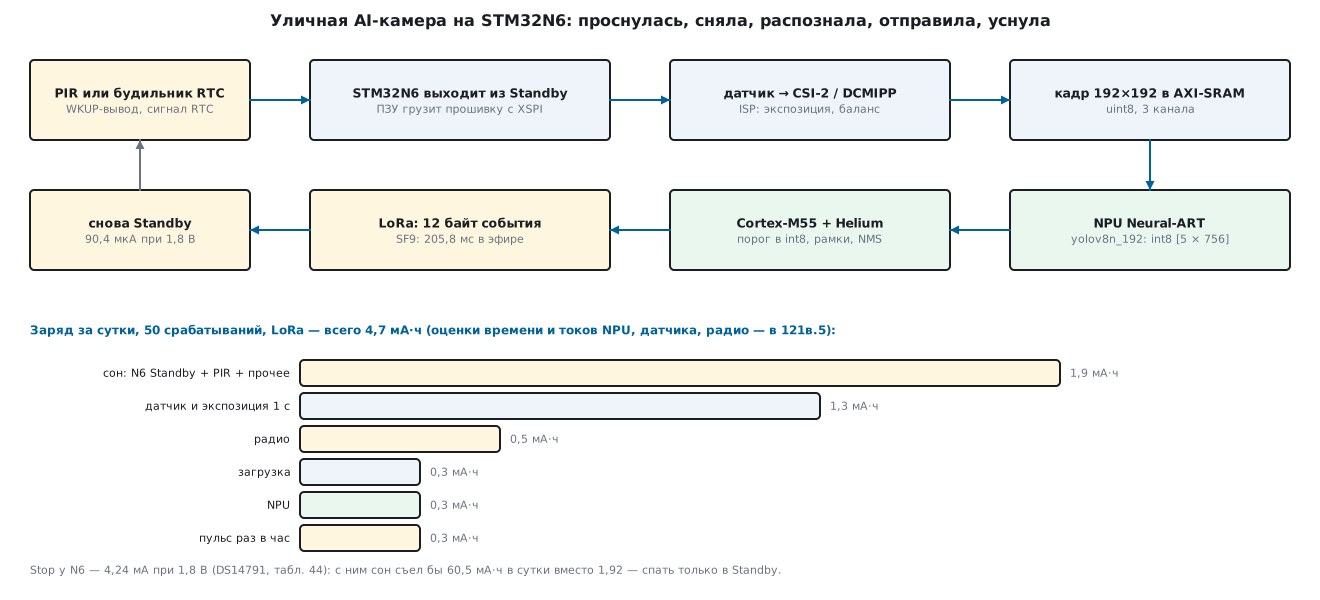
Цикл: Standby → пробуждение по PIR или будильнику RTC → загрузка с
внешней флеш-памяти → датчик и экспозиция → NPU → постобработка →
LoRa → Standby. Плюс раз в час «пульс» по таймеру без камеры. Модель —
energy121v.py; ток шины 1,8 В переводится в ток батареи через КПД
преобразователя: I_бат = I · 1,8 / (3,6 · 0,85).
Что из документации (DS14791, 25 °C, типовые, SMPS внутри):
| Режим | Ток при 1,8 В | Где |
|---|---|---|
| работа 800 МГц, все периферийные блоки тактируются | 99,93 мА (IDDSMPS) | табл. 40, с. 155 |
| Sleep, 800 МГц, всё тактируется | 80,9 мА | табл. 42, с. 157 |
| Stop, SVOS low | 3,60 мА + 273,4 мкА + 362,7 мкА = 4,24 мА | табл. 44, с. 158 |
| Standby, резервное ОЗУ и RTC с LSE | 48,4 + 42 = 90,4 мкА | табл. 45, с. 159 |
| то же при 85 °C | 69,0 + 80 = 149 мкА | табл. 45, с. 159 |
| из Standby до первой команды | 400 мкс | табл. 47, с. 160 |
Ядро на 800 МГц само берёт 85 мА от VDDCORE при выключенной периферии и 172 мА при включённой (табл. 34, с. 149). Тока NPU во время вычисления в даташите нет.
Что — оценка (мерить на своей плате): ток NPU 200 мА при 1,8 В,
загрузка 0,3 с, экспозиция 1,0 с (столько ждёт датчик пример OpenMV
time_lapse_photos.py, строка 55: snapshot(time=1000)), NPU 0,1 с,
постобработка 0,05 с, датчик изображения 150 мВт, внешняя память 20 мА,
LoRa — 45 мА на передаче и 12 мА на приёме 0,2 с, LTE-M — 120 мА 6 с,
Wi-Fi — 180 мА 2,5 с, PIR 15 мкА, прочее во сне 12 мкА, 18650 —
3000 мА·ч, доступно 90 % при +20 °C и 60 % при −20 °C, саморазряд 2 % в
месяц. Все допущения с источником печатает сам скрипт.
Сообщение LoRa — 12 байт события и 13 служебных LoRaWAN: на SF9 при 125 кГц это 205,8 мс в эфире. Формула — из раздела 89, и скрипт её проверяет: 23 байта на SF9 — 205,8 мс, как в таблице раздела 89; 63 байта на SF7 — 118,0 мс, как в 48в.
Результаты прогона:
| Значение | |
|---|---|
| сон всей платы в Standby | 80,2 мкА от батареи, 1,92 мА·ч в сутки |
| то же, если спать в Stop | 2518,8 мкА, 60,5 мА·ч в сутки |
| одно срабатывание с LoRa | 175,0 мА·с: датчик и экспозиция 96,6, радио 35,5, загрузка 21,2, NPU 18,8 |
| одно срабатывание с LTE-M / Wi-Fi | 1145,1 / 708,5 мА·с |
| от PIR до конца передачи | 1,66 с |
Сколько суток проживёт прибор:
| Связь, срабатываний в сутки | мА·ч в сутки | 1×18650, +20 °C | 1×18650, −20 °C | 2×18650, −20 °C |
|---|---|---|---|---|
| LoRa, 10 | 2,8 | 567 | 378 | 533 |
| LoRa, 50 | 4,7 | 403 | 268 | 414 |
| LoRa, 200 | 12,0 | 193 | 129 | 225 |
| LTE-M, 10 | 5,5 | 362 | 241 | 381 |
| LTE-M, 50 | 18,2 | 134 | 89 | 162 |
| LTE-M, 200 | 65,9 | 40 | 27 | 52 |
| Wi-Fi, 10 | 4,2 | 433 | 288 | 437 |
| Wi-Fi, 50 | 12,1 | 191 | 128 | 223 |
| Wi-Fi, 200 | 41,6 | 62 | 41 | 79 |
Выводы модели. Спать можно только в Standby: Stop у N6 стоит миллиамперы: на LoRa при 50 срабатываниях один 18650 при +20 °C продержится 41 сут. вместо 403. При 50 срабатываниях сон и экспозиция — две трети суточного заряда; NPU — малая доля, если сеть считает 0,1 с. Радио решает выбор связи: одно срабатывание по LTE-M в 6,5 раза дороже, чем по LoRa. На малой нагрузке срок упирается в саморазряд — 2,0 мА·ч в сутки на элемент.
Солнце. Панель 2 Вт, в декабре 0,5 ч полного солнца в сутки, в июне 5 ч, КПД 0,7 (оценки): приход 194 и 1944 мА·ч в сутки. Декабрьского прихода хватило бы на 3911 срабатываний LoRa в сутки — если его можно взять. На морозе нельзя: Li-ion заряжают только в разрешённом диапазоне температур (173б), и зимой днём энергия панели пропадает, пока элемент холодный. Поэтому зимний запас считают без солнца — столбец «−20 °C» таблицы.
121в.6 Техническое задание на прибор
Сокращённо, по структуре ГОСТ 15.016 (ТЗ на изделие). Числа требований — предложения автора; ссылки на модель 121в.5 — чтобы было видно, откуда запас.
1. Наименование и назначение. «Уличная AI-камера на STM32N6 с питанием от батареи». Обнаруживает людей, животных и машины в поле зрения, передаёт событие (класс, число объектов, рамку, время, заряд) и по запросу — вырезку в JPEG. Видео не ведёт, кадры не хранит.
2. Основание и стадии. По договору; стадии — в п. 11.
3. Состав.
| Узел | Требование |
|---|---|
| вычислитель | STM32N657 (линия N6x7 с NPU); внешняя флеш-память XSPI NOR от 32 МБ под прошивку, модели и журнал |
| датчик изображения | CSI-2 или параллельный, глобальный или скользящий затвор, ИК-подсветка по требованию заказчика |
| датчик движения | PIR на вывод WKUP; второй источник пробуждения — будильник RTC |
| связь | LoRaWAN (основная) и LTE-M или Wi-Fi (по исполнению) |
| питание | 1 или 2 элемента 18650 с защитой; контроллер заряда от панели с запретом заряда по температуре (173б) |
| корпус | уличный, со стеклом перед объективом и окном PIR |
4. Функциональные требования.
| № | Требование | Проверка |
|---|---|---|
| Ф1 | классы: человек, животное, машина; модель int8 на NPU | на испытаниях |
| Ф2 | доля обнаруженных людей в зоне до 10 м днём — не ниже 0,9; ложных событий — не больше 5 в сутки на объекте | полевые испытания |
| Ф3 | от срабатывания PIR до конца передачи — не больше 3 с (по модели — 1,66 с) | замер |
| Ф4 | порог оценки и порог NMS задаются удалённо; NMS по классам | проверка команд |
| Ф5 | пульс раз в час: заряд, температура, счётчики | журнал сервера |
| Ф6 | выход сети проверяется на всех порогах: не больше 64 кандидатов, без выделения памяти | модульные тесты (121в.4) |
5. Питание и автономность.
| № | Требование | Откуда запас |
|---|---|---|
| П1 | сон — только Standby; ток платы во сне не больше 100 мкА от батареи при +20 °C | по модели 80,2 мкА |
| П2 | не меньше 365 сут. на 2×18650 при 50 срабатываниях LoRa в сутки и −20 °C без солнца | по модели 414 сут. |
| П3 | исполнение с LTE-M: не меньше 90 сут. на 2×18650 при 50 срабатываниях и −20 °C | по модели 162 сут. |
| П4 | с панелью: работа без замены элементов при 50 срабатываниях в сутки круглый год | приход декабря 194 мА·ч при расходе 4,7 |
| П5 | измерение заряда, сообщение о разряде за 14 суток до отключения | испытания |
6. Условия эксплуатации. Температура воздуха от −40 до +50 °C при работе от элементов, допускающих этот диапазон; кристалл — промышленный диапазон −40…125 °C (DS14791, с. 262). Защита корпуса — IP66 по ГОСТ 14254. Без конденсата на стекле: клапан выравнивания давления.
7. Связь. LoRaWAN EU868 класса A, сообщение события — 12 байт; доля времени в эфире — не больше 1 % (89, 93). LTE-M — с режимом PSM. Сообщения подписаны ключами сети LoRaWAN (94) или TLS.
8. Обновление прошивки и моделей. Свой загрузчик или MCUboot с двумя слотами и откатом (48, 48б), подпись образа (48а), шифрование (48г). По LoRa — только разностные обновления прошивки (48в). Модель по LoRa не обновляется: 3 228 400 байт — 67259 кадров по 48 байт, на SF7 при 1 % эфира не быстрее 9,2 сут., на SF12 — 217,5 сут. Модели — по LTE-M, Wi-Fi или на месте.
9. Хранение данных и приватность. Кадр живёт только в ОЗУ до конца цикла. Наружу — метаданные; вырезка — только по запросу оператора. Изображения людей могут быть персональными данными (152-ФЗ): режим «только метаданные» — по умолчанию. Ключи — в OTP и защищённой области, отладка закрыта (DS14791: жизненный цикл с RDP и паролем отладки).
10. Испытания. Модульные: постобработка на ПК, в QEMU M55 и на плате — совпадение вывода (121в.4). Энергетические: ток сна, заряд срабатывания по фазам, сравнение с моделью 121в.5. Климатические: −40, −20, +50 °C, циклы. Защита корпуса IP66. Полевые: месяц на объекте с разметкой событий, доли обнаружений и ложных срабатываний.
11. Этапы.
| Этап | Результат |
|---|---|
| 1. Макет | отладочная плата N6, датчик, PIR, LoRa; замер токов всех фаз, уточнённая модель 121в.5 |
| 2. Модель | обучение и квантование своих классов, компиляция под NPU, время эпох |
| 3. Опытный образец | плата, корпус, прошивка с обновлением и журналом |
| 4. Испытания | пп. 10; протоколы |
| 5. Документация | руководство, методика испытаний, паспорт |
121в.7 Грабли
- Stop у N6 — не сон для батарейки. 4,24 мА при 1,8 В против 90,4 мкА в Standby (DS14791, табл. 44 и 45). Привычка с U5 спать в Stop 2 здесь съедает 18650 за 41 сут.
- Выход из Standby — это сброс. ПЗУ снова грузит прошивку с
внешней флеш-памяти; OpenMV после
machine.deepsleep()перезапускает сценарий целиком (onoff_wakeup.py, строки 11–13). Сократить можно: TCM 64 + 128 КБ сохраняются в Standby битомPWR_CR4_TCMRBSEN, а при выходе из Standby с сохранённым ОЗУ ПЗУ не запускается — ядро стартует с адреса из SYSCFG (RM0486, 9.2 и 13). Веса модели всё равно читаются с флеш-памяти. - Порог в float на каждом якоре. 756 переводов в float и сравнений ради десятка прошедших. Порог переводится в код один раз, дальше — сравнение байтов; на M55 — по 16 за команду.
- Неограниченный список кандидатов. На шумном кадре 240 якорей
выше порога (
s3_flood); без предела список растёт вместе с шумом. Предел 64 и вытеснение худшего держат память постоянной. - NMS без классов глотает соседей. Человек у машины: NMS без классов
оставил одну рамку из двух (
s2_overlap_agn). У OpenMV NMS как раз без классов. - Кэш и NPU. NPU читает память мимо кэша M55: входной буфер перед
запуском сбрасывают, выходной перед чтением делают недействительным —
как в
stai_backend.c(раздел 11б). - Модели — только во внешней памяти. Перемещаемые пулы NPU ниже
0x60000000библиотека ST не принимает (stai_backend.c, строки 53–58). - Якоря YOLOv2 — часть модели. Без размеров якорей, с которыми сеть учили, рамки выйдут не того размера. Их хранят вместе с моделью.
- Разный результат на ПК и на плате.
expfиз разных libm и слияние умножения со сложением в FMA меняют последние биты, а с ними — целые точки рамки. Своя экспонента и-ffp-contract=offдают совпадение строка в строку. - Заряд на морозе. Панель даёт энергию днём, а Li-ion на морозе заряжать нельзя (173б): зимний запас считают без солнца.
- Модель по LoRa. 67259 кадров и 9,2 сут. на SF7 — это не обновление. Модель меняют по LTE-M, Wi-Fi или на месте.
121в.8 Итоги
- STM32N6: Cortex-M55 на 800 МГц с Helium, NPU Neural-ART до 1 ГГц (600 Gops по ST; 4 блока свёртки, 10 потоковых DMA), флеш-памяти нет — прошивка с XSPI; ОЗУ 2 × 1 МБ + 4 × 448 КБ, DCMIPP с ISP, CSI-2 на 2 линии по 2,5 Гбит/с, H.264 и JPEG.
- yolov8n_192: 3 228 400 байт, выход int8 [5 × 756], масштаб 0,00507508637, нулевая точка −128; порог 0,4 — код −49.
- Своя постобработка: порог в кодах, до 64 кандидатов, NMS в целых, своя экспонента; 2488 байт кода для M55 с Helium, 2328 без.
- Проверка: 7 наборов, ПК, Python с float32 и M55 в QEMU с Helium и без — вывод совпал; numpy — 7 из 7, рамки без расхождений; на настоящем выходе модели — одна рамка с оценкой 0,9693, как ждёт тест OpenMV.
- Энергия: Standby 90,4 мкА при 1,8 В, Stop 4,24 мА; сон платы 80,2 мкА; срабатывание с LoRa — 175,0 мА·с; 50 срабатываний в сутки — 4,7 мА·ч, на 2×18650 при −20 °C — 414 сут. (оценка).
- ТЗ: Standby, LoRa для событий, модели — не по LoRa, кадры не хранить, запас автономности считать без зимнего солнца.
Полные исходники
Каталог _verify/n6cam121v/. Собрать на ПК:
gcc -std=c11 -O2 -ffp-contract=off main_post.c yolo_post.c, для M55 —
как в run.sh. tensors.h создаёт python gen_tensors.py tensors.h.
yolo_post.h — интерфейс постобработки.
/* Постобработка детектора YOLO на Cortex-M55: выход сети int8 -> рамки -> NMS.
 * Свой код раздела 121в. Без malloc и без libm: одинаковый результат на ПК и на M55. */
#ifndef YOLO_POST_H
#define YOLO_POST_H

#include <stdint.h>

#define YP_MAX_CAND 64          /* сколько кандидатов держим до NMS: лучшие по оценке */

typedef struct {
    int16_t x, y, w, h;         /* рамка в точках входа сети */
    int8_t  q;                  /* оценка в кодах int8 выходного тензора */
    uint8_t cls;                /* номер класса */
} yp_box_t;

typedef struct {
    float   scale;              /* квантование выхода: значение = (q - zp) * scale */
    int32_t zp;
    int     in_w, in_h;         /* размер входа сети, точек */
    float   conf;               /* порог оценки, 0..1 */
    int     iou_num, iou_den;   /* порог NMS дробью: 45/100 = 0,45 */
    int     agnostic;           /* 1 — одно NMS на все классы, 0 — своё на каждый */
} yp_cfg_t;

/* YOLOv8 (выгрузка Ultralytics): out[(4 + nc) * n], строки cx, cy, w, h (доли входа),
 * дальше nc строк оценок классов (уже после сигмоиды); n — число якорей. */
int yp_decode_v8(const int8_t *out, int n, int nc, const yp_cfg_t *c,
                 yp_box_t *cand, int *n_above);

/* YOLOv2 и YOLO-LC: out[gh][gw][na * (5 + nc)]: tx, ty, tw, th, объектность, nc логитов.
 * anchors[2 * na] — ширина и высота якоря в клетках сетки. */
int yp_decode_v2(const int8_t *out, int gh, int gw, int na, int nc, const float *anchors,
                 const yp_cfg_t *c, yp_box_t *cand, int *n_above);

/* Жадное NMS на месте: рамки уже по убыванию q; возвращает, сколько осталось. */
int yp_nms(yp_box_t *b, int n, const yp_cfg_t *c);

int8_t yp_q_threshold(const yp_cfg_t *c, int logistic); /* порог в кодах int8 */
float  yp_exp(float x);                                 /* своя экспонента, без libm */

#endif
yolo_post.c — декодеры YOLOv8 и YOLOv2, порог, кандидаты, NMS, экспонента.
/* Постобработка YOLO: декодирование выхода int8 в рамки и NMS. Раздел 121в.
 * Собирается gcc на ПК и arm-none-eabi-gcc -mcpu=cortex-m55; на M55 поиск
 * кандидатов YOLOv8 идёт по 16 якорей за команду Helium (MVE). */
#include "yolo_post.h"

#if defined(__ARM_FEATURE_MVE) && !defined(YP_NO_MVE)
#include <arm_mve.h>
#define YP_USE_MVE 1
#endif

static float deq(const yp_cfg_t *c, int q) { return (float)(q - c->zp) * c->scale; }

/* exp(x) = 2^m * exp(r), r = x - m*ln2, |r| <= 0,35; ряд до r^6. Только + - * и сдвиг
 * порядка — результат одинаков на любом процессоре с IEEE-754 float. */
float yp_exp(float x)
{
    if (x > 88.0f) x = 88.0f;
    if (x < -87.0f) x = -87.0f;
    float k = x * 1.44269504f;
    int m = (int)(k + (k >= 0.0f ? 0.5f : -0.5f));
    float r = x - (float)m * 0.693145752f;          /* ln2, старшая часть */
    r = r - (float)m * 1.42860677e-06f;             /* ln2, младшая часть */
    float p = 1.0f + r * (1.0f + r * (0.5f + r * (0.166666672f + r * (0.0416666679f
              + r * (0.00833333377f + r * 0.00138888892f)))));
    union { float f; uint32_t u; } s;
    s.u = (uint32_t)(m + 127) << 23;                /* 2^m */
    return p * s.f;
}

static float sigm(float x) { return 1.0f / (1.0f + yp_exp(-x)); }

/* Наименьший код q, у которого оценка уже не ниже порога. Сравнивать дальше можно
 * прямо байты выхода: перевод в float нужен только прошедшим. Недостижимый порог
 * даёт 127 — такой случай отсекает thr_reachable. */
int8_t yp_q_threshold(const yp_cfg_t *c, int logistic)
{
    for (int q = -128; q <= 127; q++) {
        float v = deq(c, q);
        if (logistic) v = sigm(v);
        if (v >= c->conf) return (int8_t)q;
    }
    return (int8_t)127;
}

static int thr_reachable(const yp_cfg_t *c, int logistic, int8_t t)
{
    float v = deq(c, t);
    return (logistic ? sigm(v) : v) >= c->conf;
}

static float clampf(float v, float hi) { return v < 0.0f ? 0.0f : (v > hi ? hi : v); }

/* Центр и размер в долях входа -> рамка в точках; пустая рамка не нужна. */
static int make_box(float cx, float cy, float w, float h, const yp_cfg_t *c, yp_box_t *b)
{
    float W = (float)c->in_w, H = (float)c->in_h;
    float x0 = clampf((cx - w * 0.5f) * W, W), x1 = clampf((cx + w * 0.5f) * W, W);
    float y0 = clampf((cy - h * 0.5f) * H, H), y1 = clampf((cy + h * 0.5f) * H, H);
    int bw = (int)(x1 - x0), bh = (int)(y1 - y0);
    if (bw <= 0 || bh <= 0) return 0;
    b->x = (int16_t)(int)x0;
    b->y = (int16_t)(int)y0;
    b->w = (int16_t)bw;
    b->h = (int16_t)bh;
    return 1;
}

/* Кандидаты — по убыванию q; при равных раньше найденный выше. Полный список
 * вытесняет худшего: в памяти не больше YP_MAX_CAND рамок при любом шуме. */
static void put(yp_box_t *cand, int *cnt, const yp_box_t *b)
{
    int k = *cnt;
    if (k == YP_MAX_CAND) {
        if (b->q <= cand[k - 1].q) return;
        k--;
    }
    while (k > 0 && cand[k - 1].q < b->q) {
        cand[k] = cand[k - 1];
        k--;
    }
    cand[k] = *b;
    if (*cnt < YP_MAX_CAND) (*cnt)++;
}

static int8_t v8_best(const int8_t *out, int n, int nc, int i, int *best)
{
    const int8_t *s = out + 4 * n + i;
    int8_t q = s[0];
    *best = 0;
    for (int k = 1; k < nc; k++)
        if (s[k * n] > q) {
            q = s[k * n];
            *best = k;
        }
    return q;
}

static void v8_take(const int8_t *out, int n, int nc, int i, const yp_cfg_t *c,
                    yp_box_t *cand, int *cnt)
{
    int best;
    yp_box_t b;
    int8_t q = v8_best(out, n, nc, i, &best);
    if (!make_box(deq(c, out[i]), deq(c, out[n + i]), deq(c, out[2 * n + i]),
                  deq(c, out[3 * n + i]), c, &b))
        return;
    b.q = q;
    b.cls = (uint8_t)best;
    put(cand, cnt, &b);
}

int yp_decode_v8(const int8_t *out, int n, int nc, const yp_cfg_t *c,
                 yp_box_t *cand, int *n_above)
{
    int8_t t = yp_q_threshold(c, 0);
    int cnt = 0, above = 0, i = 0;
    if (!thr_reachable(c, 0, t)) {
        *n_above = 0;
        return 0;
    }
#ifdef YP_USE_MVE
    for (; i + 16 <= n; i += 16) {                  /* 16 якорей за проход */
        int8x16_t m = vld1q_s8(out + 4 * n + i);
        for (int k = 1; k < nc; k++)
            m = vmaxq_s8(m, vld1q_s8(out + (4 + k) * n + i));
        uint32_t p = vcmpgeq_n_s8(m, t);            /* бит на каждый байт-якорь */
        while (p) {
            int lane = __builtin_ctz(p);
            p &= p - 1;
            above++;
            v8_take(out, n, nc, i + lane, c, cand, &cnt);
        }
    }
#endif
    for (; i < n; i++) {
        int best;
        if (v8_best(out, n, nc, i, &best) >= t) {
            above++;
            v8_take(out, n, nc, i, c, cand, &cnt);
        }
    }
    *n_above = above;
    return cnt;
}

int yp_decode_v2(const int8_t *out, int gh, int gw, int na, int nc, const float *anchors,
                 const yp_cfg_t *c, yp_box_t *cand, int *n_above)
{
    int8_t t = yp_q_threshold(c, 1);
    int cnt = 0, above = 0, st = 5 + nc;
    if (!thr_reachable(c, 1, t)) {
        *n_above = 0;
        return 0;
    }
    for (int r = 0; r < gh; r++)
        for (int col = 0; col < gw; col++)
            for (int a = 0; a < na; a++) {
                const int8_t *p = out + ((r * gw + col) * na + a) * st;
                if (p[4] < t) continue;              /* объектность ниже порога */
                above++;
                int best = 0;
                for (int k = 1; k < nc; k++)         /* softmax не нужен: argmax тот же */
                    if (p[5 + k] > p[5 + best]) best = k;
                float cx = ((float)col + sigm(deq(c, p[0]))) / (float)gw;
                float cy = ((float)r + sigm(deq(c, p[1]))) / (float)gh;
                float w = anchors[2 * a] * yp_exp(deq(c, p[2])) / (float)gw;
                float h = anchors[2 * a + 1] * yp_exp(deq(c, p[3])) / (float)gh;
                yp_box_t b;
                if (!make_box(cx, cy, w, h, c, &b)) continue;
                b.q = p[4];
                b.cls = (uint8_t)best;
                put(cand, &cnt, &b);
            }
    *n_above = above;
    return cnt;
}

/* Пересечение больше доли num/den от объединения — в целых, без деления. */
static int iou_above(const yp_box_t *a, const yp_box_t *b, const yp_cfg_t *c)
{
    int ax1 = a->x + a->w, bx1 = b->x + b->w, ay1 = a->y + a->h, by1 = b->y + b->h;
    int ix = (ax1 < bx1 ? ax1 : bx1) - (a->x > b->x ? a->x : b->x);
    int iy = (ay1 < by1 ? ay1 : by1) - (a->y > b->y ? a->y : b->y);
    if (ix <= 0 || iy <= 0) return 0;
    int64_t inter = (int64_t)ix * iy;
    int64_t uni = (int64_t)a->w * a->h + (int64_t)b->w * b->h - inter;
    return inter * c->iou_den > uni * c->iou_num;
}

int yp_nms(yp_box_t *b, int n, const yp_cfg_t *c)
{
    int kept = 0;
    for (int i = 0; i < n; i++) {
        int drop = 0;
        for (int j = 0; j < kept && !drop; j++)
            if ((c->agnostic || b[j].cls == b[i].cls) && iou_above(&b[j], &b[i], c))
                drop = 1;
        if (!drop) b[kept++] = b[i];
    }
    return kept;
}
main_post.c — прогон наборов на ПК и на M55.
/* Прогон постобработки на наборах из tensors.h. Один и тот же файл собирается
 * для ПК (вывод в stdout) и для Cortex-M55 в QEMU mps3-an547 (вывод полухостингом). */
#include <stdint.h>
#include "yolo_post.h"

typedef struct {
    const char *name;
    int kind;                   /* 8 — YOLOv8, 2 — YOLOv2/LC */
    const int8_t *data;
    int n, nc, gh, gw, na, conf_pct;
    yp_cfg_t cfg;
} tcase_t;

#include "tensors.h"

#ifdef __arm__
static void out(const char *s)
{
    register int r0 __asm__("r0") = 0x04;          /* SYS_WRITE0 */
    register const char *r1 __asm__("r1") = s;
    __asm__ volatile("bkpt 0xAB" : "+r"(r0) : "r"(r1) : "memory");
}
#else
#include <stdio.h>
static void out(const char *s) { fputs(s, stdout); }
#endif

static char line[160];
static int pos;

static void put_s(const char *s) { while (*s) line[pos++] = *s++; }

static void put_i(int v)
{
    char t[12];
    int k = 0;
    unsigned u = v < 0 ? (unsigned)(-v) : (unsigned)v;
    if (v < 0) line[pos++] = '-';
    do { t[k++] = (char)('0' + u % 10); u /= 10; } while (u);
    while (k) line[pos++] = t[--k];
}

static void kv(const char *k, int v) { put_s(" "); put_s(k); put_s("="); put_i(v); }
static void flush(void) { line[pos++] = '\n'; line[pos] = 0; out(line); pos = 0; }

int main(void)
{
    static yp_box_t cand[YP_MAX_CAND];
    for (unsigned i = 0; i < sizeof cases / sizeof cases[0]; i++) {
        const tcase_t *t = &cases[i];
        int above, n;
        if (t->kind == 8)
            n = yp_decode_v8(t->data, t->n, t->nc, &t->cfg, cand, &above);
        else
            n = yp_decode_v2(t->data, t->gh, t->gw, t->na, t->nc, anchors_v2, &t->cfg, cand, &above);
        int kept = yp_nms(cand, n, &t->cfg);
        put_s("CASE "); put_s(t->name); kv("kind", t->kind); kv("conf", t->conf_pct);
        kv("agn", t->cfg.agnostic); kv("thr", yp_q_threshold(&t->cfg, t->kind == 2));
        kv("above", above); kv("cand", n); kv("kept", kept);
        flush();
        for (int k = 0; k < kept; k++) {
            put_s("  BOX"); kv("cls", cand[k].cls); kv("q", cand[k].q); kv("x", cand[k].x);
            kv("y", cand[k].y); kv("w", cand[k].w); kv("h", cand[k].h);
            flush();
        }
    }
    put_s("DONE");
    flush();
    return 0;
}
m55_boot.c — запуск на Cortex-M55 в QEMU: векторы, FPU и Helium, выход.
/* Запуск на Cortex-M55 в QEMU mps3-an547: таблица векторов, FPU и MVE, .data/.bss, main, выход. */
#include <stdint.h>

extern int main(void);
extern uint32_t _sidata, _sdata, _edata, _sbss, _ebss, _estack;

static void semi_exit(void)
{
    register int r0 __asm__("r0") = 0x18;          /* SYS_EXIT */
    register int r1 __asm__("r1") = 0x20026;       /* ADP_Stopped_ApplicationExit */
    __asm__ volatile("bkpt 0xAB" : : "r"(r0), "r"(r1) : "memory");
    for (;;) {}
}

void Reset_Handler(void)
{
    *(volatile uint32_t *)0xE000ED88u |= 0xFu << 20; /* CPACR: CP10, CP11 — FPU и Helium */
    __asm__ volatile("dsb\n isb");
    for (uint32_t *s = &_sidata, *d = &_sdata; d < &_edata;) *d++ = *s++;
    for (uint32_t *d = &_sbss; d < &_ebss;) *d++ = 0;
    main();
    semi_exit();
}

static void Fault_Handler(void) { semi_exit(); }

__attribute__((section(".vectors"), used))
static const void *vectors[16] = {
    &_estack, Reset_Handler, Fault_Handler, Fault_Handler, Fault_Handler, Fault_Handler, Fault_Handler,
};
m55.ld — карта памяти mps3-an547.
/* QEMU mps3-an547: ITCM 512 КБ с 0x00000000 — код и константы, DTCM 512 КБ с 0x20000000 — данные и стек. */
MEMORY
{
  ITCM (rx)  : ORIGIN = 0x00000000, LENGTH = 512K
  DTCM (rwx) : ORIGIN = 0x20000000, LENGTH = 512K
}
ENTRY(Reset_Handler)
SECTIONS
{
  .text : { KEEP(*(.vectors)) *(.text*) *(.rodata*) . = ALIGN(4); } > ITCM
  .data : { _sdata = .; *(.data*) . = ALIGN(4); _edata = .; } > DTCM AT > ITCM
  _sidata = LOADADDR(.data);
  .bss (NOLOAD) : { _sbss = .; *(.bss*) *(COMMON) . = ALIGN(4); _ebss = .; } > DTCM
  _estack = ORIGIN(DTCM) + LENGTH(DTCM);
}
yolo_post.py — та же логика на Python с округлением до float32.
# -*- coding: utf-8 -*-
"""Та же постобработка YOLO, что в yolo_post.c, на Python: каждая операция с float
округляется до float32, поэтому вывод совпадает с C на ПК и на Cortex-M55 байт в байт.

python yolo_post.py   — печатает то же, что main_post.c"""
import struct
from gen_tensors import cases, ANCH_V2

MAX_CAND = 64


def f32(x):
    return struct.unpack("<f", struct.pack("<f", x))[0]


def s8(b):
    return b - 256 if b > 127 else b


def yp_exp(x):
    x = f32(x)
    x = 88.0 if x > 88.0 else (-87.0 if x < -87.0 else x)
    k = f32(x * f32(1.44269504))
    m = int(f32(k + (0.5 if k >= 0.0 else -0.5)))
    r = f32(x - f32(m * f32(0.693145752)))
    r = f32(r - f32(m * f32(1.42860677e-06)))
    p = f32(0.00138888892)
    for c in (0.00833333377, 0.0416666679, 0.166666672, 0.5, 1.0, 1.0):
        p = f32(f32(c) + f32(r * p))
    return f32(p * 2.0 ** m)


def sigm(x):
    return f32(1.0 / f32(1.0 + yp_exp(-x)))


def deq(c, q):
    return f32(f32(q - c["zp"]) * c["scale"])


def q_threshold(c, logistic):
    for q in range(-128, 128):
        v = deq(c, q)
        if logistic:
            v = sigm(v)
        if v >= c["conf"]:
            return q
    return 127


def reachable(c, logistic, t):
    v = deq(c, t)
    return (sigm(v) if logistic else v) >= c["conf"]


def make_box(cx, cy, w, h, c):
    W, H = f32(c["in_w"]), f32(c["in_h"])
    cl = lambda v, hi: 0.0 if v < 0.0 else (hi if v > hi else v)
    x0 = cl(f32(f32(cx - f32(w * 0.5)) * W), W)
    x1 = cl(f32(f32(cx + f32(w * 0.5)) * W), W)
    y0 = cl(f32(f32(cy - f32(h * 0.5)) * H), H)
    y1 = cl(f32(f32(cy + f32(h * 0.5)) * H), H)
    bw, bh = int(f32(x1 - x0)), int(f32(y1 - y0))
    if bw <= 0 or bh <= 0:
        return None
    return [int(x0), int(y0), bw, bh]


def put(cand, b):
    if len(cand) == MAX_CAND:
        if b["q"] <= cand[-1]["q"]:
            return
        cand.pop()
    k = len(cand)
    while k > 0 and cand[k - 1]["q"] < b["q"]:
        k -= 1
    cand.insert(k, b)


def decode_v8(d, n, nc, c):
    t = q_threshold(c, False)
    if not reachable(c, False, t):
        return [], 0
    cand, above = [], 0
    for i in range(n):
        q, best = s8(d[4 * n + i]), 0
        for k in range(1, nc):
            if s8(d[(4 + k) * n + i]) > q:
                q, best = s8(d[(4 + k) * n + i]), k
        if q < t:
            continue
        above += 1
        box = make_box(*(deq(c, s8(d[r * n + i])) for r in range(4)), c)
        if box:
            put(cand, dict(box=box, q=q, cls=best))
    return cand, above


def decode_v2(d, gh, gw, na, nc, anchors, c):
    t = q_threshold(c, True)
    if not reachable(c, True, t):
        return [], 0
    cand, above, st = [], 0, 5 + nc
    for r in range(gh):
        for col in range(gw):
            for a in range(na):
                p = [s8(v) for v in d[((r * gw + col) * na + a) * st:][:st]]
                if p[4] < t:
                    continue
                above += 1
                best = 0
                for k in range(1, nc):
                    if p[5 + k] > p[5 + best]:
                        best = k
                cx = f32(f32(col + sigm(deq(c, p[0]))) / gw)
                cy = f32(f32(r + sigm(deq(c, p[1]))) / gh)
                w = f32(f32(f32(anchors[2 * a]) * yp_exp(deq(c, p[2]))) / gw)
                h = f32(f32(f32(anchors[2 * a + 1]) * yp_exp(deq(c, p[3]))) / gh)
                box = make_box(cx, cy, w, h, c)
                if box:
                    put(cand, dict(box=box, q=p[4], cls=best))
    return cand, above


def iou_above(a, b, c):
    ix = min(a[0] + a[2], b[0] + b[2]) - max(a[0], b[0])
    iy = min(a[1] + a[3], b[1] + b[3]) - max(a[1], b[1])
    if ix <= 0 or iy <= 0:
        return False
    inter = ix * iy
    return inter * c["iou_den"] > (a[2] * a[3] + b[2] * b[3] - inter) * c["iou_num"]


def nms(cand, c):
    kept = []
    for b in cand:
        if not any((c["agnostic"] or k["cls"] == b["cls"]) and iou_above(k["box"], b["box"], c) for k in kept):
            kept.append(b)
    return kept


def run(cs):
    lines = []
    for t in cs:
        c = dict(t, scale=f32(t["scale"]), conf=f32(t["conf"] / 100.0))
        if t["kind"] == 8:
            cand, above = decode_v8(t["data"], t["n"], t["nc"], c)
        else:
            cand, above = decode_v2(t["data"], t["gh"], t["gw"], t["na"], t["nc"], ANCH_V2, c)
        kept = nms(cand, c)
        lines.append("CASE %s kind=%d conf=%d agn=%d thr=%d above=%d cand=%d kept=%d" % (
            t["name"], t["kind"], t["conf"], t["agnostic"], q_threshold(c, t["kind"] == 2), above, len(cand), len(kept)))
        for b in kept:
            lines.append("  BOX cls=%d q=%d x=%d y=%d w=%d h=%d" % ((b["cls"], b["q"]) + tuple(b["box"])))
    lines.append("DONE")
    return lines


if __name__ == "__main__":
    print("\n".join(run(cases())))
energy121v.py — модель энергобюджета.
# -*- coding: utf-8 -*-
"""Энергобюджет уличной AI-камеры на STM32N6 (раздел 121в). Только стандартная библиотека.

python energy121v.py

Цикл: Standby -> пробуждение по PIR или таймеру -> загрузка -> кадр -> NPU -> отправка -> Standby.
У каждого числа — источник: «DS» — даташит DS14791 Rev 11 (таблица, страница, условия),
«оценка» — числа в документах нет, взято допущение; его и надо мерить на своей плате."""

# ── Параметры: имя -> (значение, единица, источник) ─────────────────────────────────
P = {
    # STM32N6, токи при 1,8 В, 25 °C, типовые; SMPS внутренний
    "n6_run_ma":      (99.93, "мА", "DS табл. 40, с. 155: IDDSMPS, 800 МГц, все периферийные включены"),
    "n6_sleep_ma":    (80.9, "мА", "DS табл. 42, с. 157: IDDSMPS в Sleep, 800 МГц, все периферийные включены"),
    "n6_stop_ma":     (3.60 + 0.2734 + 0.3627, "мА", "DS табл. 44, с. 158: Stop SVOS low, IDDSMPS 3,60 мА + IDD 273,4 мкА + IDDA1V8 362,7 мкА"),
    "n6_stby_ua":     (48.4 + 42.0, "мкА", "DS табл. 45, с. 159: Standby, RAM резерва и RTC с LSE включены, IDD 48,4 + IDDA18ON 42"),
    "n6_stby85_ua":   (69.0 + 80.0, "мкА", "DS табл. 45, с. 159: то же при TJ = 85 °C: 69,0 + 80"),
    "n6_npu_ma":      (200.0, "мА", "оценка: тока NPU в вычислении в даташите нет"),
    "v_rail":         (1.8, "В", "DS табл. 25: VDD 1,8 В"),
    # фазы одного срабатывания
    "t_boot_s":       (0.30, "с", "оценка: ПЗУ грузит прошивку с внешней флеш-памяти (DS: из Standby до первой команды 400 мкс)"),
    "t_ae_s":         (1.0, "с", "пример OpenMV: snapshot(time=1000) — дать датчику подстроиться"),
    "t_npu_s":        (0.10, "с", "оценка: YOLOv8n 192×192 на NPU"),
    "t_post_s":       (0.05, "с", "оценка: постобработка, JPEG вырезки"),
    "sensor_mw":      (150.0, "мВт", "оценка: датчик изображения во время съёмки"),
    "flash_ma":       (20.0, "мА", "оценка: внешняя флеш-память и PSRAM при работе, 1,8 В"),
    # связь (токи от батареи)
    "lora_tx_ma":     (45.0, "мА", "оценка: модуль LoRa на передаче +14 дБм"),
    "lora_rx_ma":     (12.0, "мА", "оценка: модуль LoRa на приёме"),
    "lora_rx_s":      (0.2, "с", "оценка: окна приёма класса A"),
    "lte_ma":         (120.0, "мА", "оценка: модем LTE-M, средний ток сеанса"),
    "lte_s":          (6.0, "с", "оценка: выход из PSM, отправка вырезки 8 КБ"),
    "wifi_ma":        (180.0, "мА", "оценка: Wi-Fi, подключение и отправка"),
    "wifi_s":         (2.5, "с", "оценка: подключение к точке и отправка кадра"),
    # сон всей платы помимо N6 (от батареи)
    "pir_ua":         (15.0, "мкА", "оценка: пироэлектрический датчик движения"),
    "other_ua":       (12.0, "мкА", "оценка: стабилизатор, флеш в глубоком сне, LoRa во сне, делитель батареи"),
    # питание
    "eta":            (0.85, "", "оценка: КПД преобразователя батарея -> 1,8 В"),
    "v_bat":          (3.6, "В", "оценка: среднее напряжение Li-ion за разряд"),
    "cell_mah":       (3000.0, "мА·ч", "оценка: ёмкость одного 18650 по паспорту"),
    "self_pct_mon":   (2.0, "%/мес", "оценка: саморазряд элемента Li-ion"),
    "use_warm":       (0.90, "", "оценка: доступная доля ёмкости при +20 °C"),
    "use_cold":       (0.60, "", "оценка: доступная доля ёмкости при −20 °C"),
    "pv_w":           (2.0, "Вт", "оценка: солнечная панель"),
    "sun_h_dec":      (0.5, "ч/сут", "оценка: часов полного солнца в декабре"),
    "sun_h_jun":      (5.0, "ч/сут", "оценка: часов полного солнца в июне"),
    "pv_eta":         (0.70, "", "оценка: панель -> контроллер заряда -> элемент"),
    "hb_per_day":     (24, "раз/сут", "оценка: пульс по таймеру раз в час, без камеры"),
}
V = {k: v[0] for k, v in P.items()}


def lora_airtime_us(sf, bw, cr, payload):
    """Формула раздела 89: преамбула 8 символов, явный заголовок, CRC, DE при символе > 16 мс."""
    tsym = (1000000 << sf) // bw
    de = 1 if tsym > 16000 else 0
    num = 8 * payload - 4 * sf + 28 + 16
    den = 4 * (sf - 2 * de)
    blocks = (num + den - 1) // den if num > 0 else 0
    quarters = 4 * 8 + 17 + 4 * (8 + blocks * (cr + 4))
    return quarters * tsym // 4


def bat_ma(ma_rail):
    """Ток шины 1,8 В -> ток батареи через преобразователь."""
    return ma_rail * V["v_rail"] / (V["v_bat"] * V["eta"])


def event_mas(link):
    """Заряд одного срабатывания, мА·с от батареи, по фазам."""
    ph = {
        "загрузка": bat_ma(V["n6_run_ma"] + V["flash_ma"]) * V["t_boot_s"],
        "датчик и экспозиция": (bat_ma(V["n6_sleep_ma"]) + V["sensor_mw"] / (V["v_bat"] * V["eta"])) * V["t_ae_s"],
        "NPU": bat_ma(V["n6_run_ma"] + V["n6_npu_ma"] + V["flash_ma"]) * V["t_npu_s"],
        "постобработка": bat_ma(V["n6_run_ma"]) * V["t_post_s"],
    }
    if link == "lora":
        toa = lora_airtime_us(9, 125000, 1, 12 + 13) / 1e6
        ph["радио"] = V["lora_tx_ma"] * toa + V["lora_rx_ma"] * V["lora_rx_s"] + bat_ma(V["n6_run_ma"]) * (toa + V["lora_rx_s"])
    elif link == "lte":
        ph["радио"] = V["lte_ma"] * V["lte_s"] + bat_ma(V["n6_sleep_ma"]) * V["lte_s"]
    else:
        ph["радио"] = V["wifi_ma"] * V["wifi_s"] + bat_ma(V["n6_sleep_ma"]) * V["wifi_s"]
    return ph


def heartbeat_mas():
    toa = lora_airtime_us(9, 125000, 1, 4 + 13) / 1e6
    return bat_ma(V["n6_run_ma"] + V["flash_ma"]) * V["t_boot_s"] + V["lora_tx_ma"] * toa \
        + V["lora_rx_ma"] * V["lora_rx_s"] + bat_ma(V["n6_run_ma"]) * (toa + V["lora_rx_s"])


def sleep_ua(stop=False, hot=False):
    n6 = V["n6_stop_ma"] * 1000 if stop else (V["n6_stby85_ua"] if hot else V["n6_stby_ua"])
    return bat_ma(n6) + V["pir_ua"] + V["other_ua"]


def day_mah(events, link="lora", stop=False):
    ev = sum(event_mas(link).values())
    return (events * ev + V["hb_per_day"] * heartbeat_mas()) / 3600 + sleep_ua(stop) * 24 / 1000


def self_mah(n):
    """Саморазряд n элементов, мА·ч в сутки (месяц = 30 суток)."""
    return n * V["cell_mah"] * V["self_pct_mon"] / 100 / 30


def days(n, use, d):
    return n * V["cell_mah"] * V[use] / (d + self_mah(n))


def fmt(x, d=1):
    return ("%.*f" % (d, x)).replace(".", ",")


def main():
    print("== параметры")
    for k, (v, u, src) in P.items():
        print("PAR %s = %s %s | %s" % (k, fmt(v, 4).rstrip("0").rstrip(","), u, src))
    print("== радио")
    print("TOA sf9 23B = %s мс (раздел 89: 205,8)" % fmt(lora_airtime_us(9, 125000, 1, 23) / 1000))
    print("TOA sf7 63B = %s мс (раздел 48в: 118,0)" % fmt(lora_airtime_us(7, 125000, 1, 63) / 1000))
    print("TOA sf9 25B = %s мс — событие: 12 байт данных + 13 LoRaWAN" % fmt(lora_airtime_us(9, 125000, 1, 25) / 1000))
    model = 3228400
    frames = -(-model // 48)
    for sf in (7, 12):
        t = lora_airtime_us(sf, 125000, 1, 63) / 1e6 * frames
        print("MODEL sf%d frames=%d air=%s ч, при 1 %% эфира не быстрее %s сут" % (sf, frames, fmt(t / 3600), fmt(t * 100 / 86400)))
    react = V["t_boot_s"] + V["t_ae_s"] + V["t_npu_s"] + V["t_post_s"] + lora_airtime_us(9, 125000, 1, 25) / 1e6
    print("REACT от PIR до конца передачи %s с (загрузка + экспозиция + NPU + постобработка + эфир)" % fmt(react, 2))
    print("== сон")
    print("SLEEP standby = %s мкА от батареи (N6 %s мкА при 1,8 В -> %s мкА + PIR %s + прочее %s)" % (
        fmt(sleep_ua()), fmt(V["n6_stby_ua"]), fmt(bat_ma(V["n6_stby_ua"])), fmt(V["pir_ua"]), fmt(V["other_ua"])))
    print("SLEEP standby85 = %s мкА от батареи" % fmt(sleep_ua(hot=True)))
    print("SLEEP stop = %s мкА от батареи (N6 в Stop SVOS low: %s мА при 1,8 В)" % (fmt(sleep_ua(stop=True)), fmt(V["n6_stop_ma"], 3)))
    print("SELF 1x18650 %s мА·ч/сут, 2x18650 %s мА·ч/сут" % (fmt(self_mah(1), 1), fmt(self_mah(2), 1)))
    print("SLEEP day: standby %s мА·ч/сут, stop %s мА·ч/сут" % (fmt(sleep_ua() * 24 / 1000, 2), fmt(sleep_ua(stop=True) * 24 / 1000, 1)))
    print("== срабатывание")
    for link in ("lora", "lte", "wifi"):
        ph = event_mas(link)
        print("EVENT %s total=%s мА·с | %s" % (link, fmt(sum(ph.values())),
                                             "; ".join("%s %s" % (k, fmt(v)) for k, v in ph.items())))
    print("HEARTBEAT = %s мА·с" % fmt(heartbeat_mas()))
    print("== сутки и автономность")
    for link in ("lora", "lte", "wifi"):
        for ev in (10, 50, 200):
            d = day_mah(ev, link)
            cells = []
            for n in (1, 2):
                for tag, use in (("+20", "use_warm"), ("-20", "use_cold")):
                    cells.append("%dx18650 %s: %s сут" % (n, tag, fmt(days(n, use, d), 0)))
            print("DAY %s ev=%d %s мА·ч/сут | %s" % (link, ev, fmt(d, 1), "; ".join(cells)))
    d = day_mah(50, "lora", stop=True)
    print("DAY lora ev=50 STOP %s мА·ч/сут | 1x18650 +20: %s сут" % (fmt(d, 1), fmt(days(1, "use_warm", d), 0)))
    print("== солнце")
    for tag, h in (("dec", V["sun_h_dec"]), ("jun", V["sun_h_jun"])):
        gain = V["pv_w"] * h * V["pv_eta"] / V["v_bat"] * 1000
        print("PV %s приход %s мА·ч/сут; lora ev=50: баланс %s; lte ev=50: баланс %s" % (
            tag, fmt(gain, 0), fmt(gain - day_mah(50, "lora"), 0), fmt(gain - day_mah(50, "lte"), 0)))
    be = (V["pv_w"] * V["sun_h_dec"] * V["pv_eta"] / V["v_bat"] * 1000 - V["hb_per_day"] * heartbeat_mas() / 3600
          - sleep_ua() * 24 / 1000 - self_mah(1)) / (sum(event_mas("lora").values()) / 3600)
    print("PV dec breakeven lora 1x18650: %d срабатываний в сутки" % int(be))
    print("== рисунок")
    ph = event_mas("lora")
    day = {"сон": sleep_ua() * 24 / 1000, "пульс": V["hb_per_day"] * heartbeat_mas() / 3600}
    for k, v in ph.items():
        day[k] = 50 * v / 3600
    print("FIG " + "; ".join("%s=%s" % (k, fmt(v, 1)) for k, v in day.items()) + "; всего=%s" % fmt(sum(day.values()), 1))


if __name__ == "__main__":
    main()
Дальше: раздел 122 «Целые типы и преобразования: продвижение, знак, переполнение».