 Embedded HandbookПриложения
121б. Звук на микроконтроллере: от PDM-микрофона к MFCC и распознаванию команды
Разделы 116–120 распознавали вибрацию: окно отсчётов, спектр, несколько признаков, маленькая модель. Со звуком цепочка та же, но длиннее с обоих концов. В начале — цифровой микрофон, который отдаёт не отсчёты, а поток битов на частоте в мегагерцы. В конце — не один ответ на окно, а поток ответов 50 раз в секунду, из которого надо выбрать момент «команда сказана» и не сработать на посторонний звук.
Раздел проходит весь путь в целых числах: прореживание PDM фильтрами CIC и КИХ, признаки MFCC, сеть int8 и решение по потоку. Код — свой, на C, без библиотек; каждый этап сверен с независимым расчётом на numpy.
О данных — честно. Записей настоящей речи в разделе нет. «Команды» здесь — синтетические звуки: четыре класса (нарастающий тон, падающий тон, два коротких сигнала, гласная с двумя формантами) со случайной высотой, длительностью, громкостью и шумом и пятый класс «прочее» — шум, посторонние тоны, обрезанные команды. Числа раздела показывают, что тракт работает и что целые числа повторяют вещественные. О точности на настоящей речи они не говорят ничего.
Опоры: PDM-микрофон, DFSDM и фильтр Sinc — раздел 18б; БПФ, окно и утечка — раздел 117; фильтры КИХ и Q15 — раздел 81а; один бин без БПФ — раздел 81б; обучение — раздел 118; квантование int8, множитель Q31 и сдвиг — раздел 119. Блоки DFSDM, MDF и ADF по семействам — приложение H.
Как это называется в документации
Оригинал Перевод PDM (pulse density modulation) плотностно-импульсная модуляция: один бит на такт decimation прореживание: фильтр и понижение частоты отсчётов CIC (cascaded integrator-comb) каскад интеграторов и гребёнок — то же, что Sinc в DFSDM droop завал АЧХ в полосе пропускания frame, hop окно и шаг между окнами pre-emphasis предыскажение: подъём верхних частот mel scale, mel filterbank шкала мел, набор треугольных мел-фильтров MFCC (mel-frequency cepstral coefficients) мел-частотные кепстральные коэффициенты DCT-II дискретное косинусное преобразование второго типа (ДКП-II) block floating point нормировка блока: общий сдвиг на всё окно keyword spotting (KWS) распознавание коротких команд в потоке posterior smoothing сглаживание ответов сети по времени false trigger ложное срабатывание refractory period пауза после срабатывания
121б.1 Тракт целиком
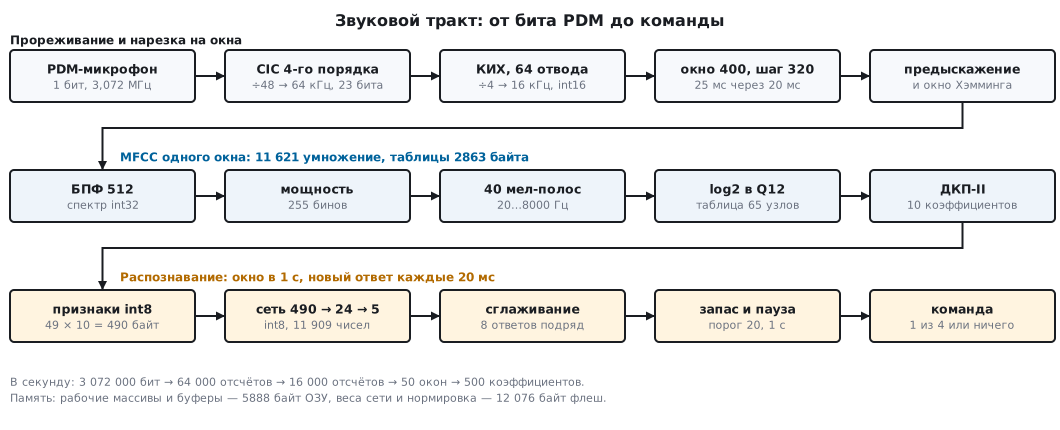
Числа тракта:
- Микрофон: 1 бит на такт 3,072 МГц. До 16 кГц — в 192 раза.
- Прореживание в два приёма: CIC на 48 (до 64 кГц) и КИХ на 4 (до 16 кГц).
- Окно — 400 отсчётов (25 мс), дополняется нулями до БПФ на 512 точек. Классический шаг для речи — 10 мс: 98 окон в секунду записи. Здесь шаг 20 мс (320 отсчётов): 49 окон на секунду, вдвое меньше счёта и памяти.
- С окна — 10 коэффициентов MFCC. Секунда звука — 49 × 10 = 490 чисел int8: это вход сети.
- Сеть 490 → 24 → 5 отвечает после каждого нового окна, 50 раз в секунду.
Где это считать. У STM32F407 блока DFSDM нет (в заголовке
stm32f407xx.h о нём ни строки) — биты микрофона принимают через I2S или SPI с
DMA как обычные байты и прореживают программой: это функция
pdm_decimate ниже. У STM32U585 (ядро Cortex-M33) есть блоки MDF1 с
шестью фильтрами и ADF1 с одним: CIC считает аппаратура, как DFSDM в
разделе 18б, а программе остаются отсчёты. Всё, что после 16 кГц, от
семейства не зависит.
121б.2 Из PDM в 16 кГц: CIC и КИХ
Раздел 18б ставил один фильтр Sinc сразу до нужной частоты. У него два недостатка: завал в верхней части полосы и слабое подавление того, что при прореживании складывается обратно в звук. Поэтому здесь два каскада.
CIC — четыре интегратора на частоте PDM и четыре гребёнки после прореживания на 48. Умножений в нём нет, только сложения. Размах выхода — 48⁴ = 5 308 416, меньше 2²³ = 8 388 608: счёт идёт в 32 битах с запасом. Интеграторы переполняются и заворачиваются — это штатно: гребёнки вычитают в той же арифметике по модулю 2³², и результат верен, пока размах выхода помещается в слово.
КИХ на 64 отвода работает уже на 64 кГц и оставляет каждый 4-й отсчёт. Это оконный sinc со срезом 8 кГц (окно Хэмминга, раздел 81а). Усиление CIC убирается в коэффициентах: 48⁴ = 81 · 2¹⁶, поэтому отводы умножены на 2²³ / 81 и результат сдвигается на 23. Сумма отводов — 103 560 (точное 2²³ / 81 — 103 563,1), наибольший — 25 264: помещаются в int16.
/* Байты PDM старшим битом вперёд; бит 1 = +1, бит 0 = -1.
   Возвращает число готовых отсчётов 16 кГц, записанных в pcm. */
uint32_t pdm_decimate(pdm_t *st, const uint8_t *pdm, uint32_t nbytes, int16_t *pcm)
{
    uint32_t nout = 0;
    for (uint32_t i = 0; i < nbytes; i++) {
        uint32_t byte = pdm[i];
        for (int b = 7; b >= 0; b--) {
            st->i1 += ((byte >> b) & 1u) ? 1u : 0xFFFFFFFFu;   /* четыре интегратора */
            st->i2 += st->i1;
            st->i3 += st->i2;
            st->i4 += st->i3;
            if (++st->nbit < CIC_R)
                continue;
            st->nbit = 0;
            uint32_t d1 = st->i4 - st->c1;                       /* четыре гребёнки */
            st->c1 = st->i4;
            uint32_t d2 = d1 - st->c2;
            st->c2 = d1;
            uint32_t d3 = d2 - st->c3;
            st->c3 = d2;
            uint32_t d4 = d3 - st->c4;
            st->c4 = d3;
            st->line[st->pos] = (int32_t)d4;                     /* |d4| <= 48^4 < 2^23 */
            st->pos = (uint8_t)((st->pos + 1) & (FIR_N - 1));
            if (++st->phase < FIR_DEC)
                continue;
            st->phase = 0;
            int64_t acc = 0;
            for (uint32_t k = 0; k < FIR_N; k++)                 /* line[pos] — самый старый */
                acc += (int64_t)fir_q[k] * st->line[(st->pos + k) & (FIR_N - 1)];
            OPS(FIR_N);
            int32_t v = (int32_t)((acc + (1 << 22)) >> 23);
            pcm[nout++] = (int16_t)(v > 32767 ? 32767 : v < -32768 ? -32768 : v);
        }
    }
    return nout;
}
АЧХ тракта по формулам (CIC — отношение синусов в четвёртой степени, КИХ — сумма отводов с поворотами):
| Частота | CIC | КИХ | Что это значит |
|---|---|---|---|
| 1 кГц | −0,01 дБ | 0,03 дБ | полоса |
| 4 кГц | −0,22 дБ | 0,00 дБ | полоса |
| 7 кГц | −0,69 дБ | −0,72 дБ | край полосы |
| 8 кГц | −0,90 дБ | −6,01 дБ | срез |
| 9 кГц | −1,14 дБ | −21,70 дБ | складывается в 7 кГц |
| 10 кГц | −1,41 дБ | −52,31 дБ | складывается в 6 кГц |
| 12 кГц | −2,03 дБ | −61,77 дБ | складывается в 4 кГц |
| 16 кГц | −3,65 дБ | −66,17 дБ | складывается в 0 |
Завал CIC на 8 кГц — всего 0,90 дБ: до 64 кГц его нули ещё далеко. Переходная полоса КИХ — от 7 до 10 кГц; то, что лежит между 8 и 9 кГц, подавлено слабо и складывается в верхний килогерц. Для распознавания команд это допустимо, для записи звука берут фильтр длиннее.
Прогон. Микрофона нет — его заменяет модель: сигма-дельта модулятор 2-го порядка, того же вида, что в разделе 18б, но в целых числах. Тон с амплитудой 0,45 шкалы модулятора, 768 000 бит, 4000 отсчётов на выходе:
| Тон | Усиление | По формуле | Сигнал/шум |
|---|---|---|---|
| 1000 Гц | 0,02 дБ | 0,02 дБ | 92,2 дБ |
| 4000 Гц | −0,22 дБ | −0,22 дБ | 91,4 дБ |
| 7000 Гц | −1,40 дБ | −1,40 дБ | 91,6 дБ |
Выход функции на C совпал с целочисленной моделью на numpy (свёртки вместо интеграторов и гребёнок) во всех 4000 отсчётах каждого тона. Наибольший модуль на выходе CIC — 2 386 140, в пределах 48⁴. Сигнал/шум здесь — свойство модели модулятора: у настоящего микрофона свой шум, и он хуже.
Цена. На 4 отсчёта 16 кГц функция сделала 3072 сложения в интеграторах, 64 вычитания в гребёнках и 256 умножений с накоплением. В секунду — 12 288 000 сложений, 256 000 вычитаний и 1 024 000 умножений. Интеграторы — главная нагрузка: четыре сложения на каждый бит микрофона. Это довод за аппаратный фильтр (DFSDM, MDF, ADF) или за меньшую частоту такта микрофона.
121б.3 MFCC: что делает каждый шаг
MFCC — способ сжать спектр окна до десятка чисел, которые описывают его форму, а не громкость и не высоту голоса. Шаги:
- Предыскажение y[n] = x[n] − 0,97 · x[n−1]. Речь спадает к верхним частотам; фильтр поднимает верх и убирает постоянную составляющую, чтобы нижние полосы не забивали остальные.
- Окно Хэмминга 0,54 − 0,46 · cos(2πn / 399) — против утечки (раздел 117; окно Ханна работает так же).
- БПФ на 512 точек: бин — 31,25 Гц, 257 бинов до 8 кГц.
- Мощность бина: re² + im². Фаза отброшена.
- Мел-фильтры. Ухо различает частоты неравномерно: внизу подробно, вверху грубо. Шкала мел это повторяет: mel = 2595 · lg(1 + f / 700). 20 Гц — 31,75 мел, 1000 Гц — 999,99 мел, 8000 Гц — 2840,02 мел. На шкале мел ставят поровну 42 точки (шаг 68,49 мел) — края и центры 40 треугольных фильтров. В герцах первые центры — 65,1, 113,1 и 164,0 Гц, последние — 7004,2 и 7487,0 Гц. Энергия полосы — сумма мощностей бинов с весами треугольника. Было 257 чисел — стало 40.
- Логарифм энергии: громкость воспринимается в децибелах, и умножение сигнала на число становится сдвигом на константу.
- ДКП-II по 40 логарифмам: c[i] = √(2/40) · Σ L[m] · cos(π · i · (m + 0,5) / 40). Соседние полосы сильно связаны; косинусное преобразование собирает форму спектра в первые коэффициенты. Берут первые 10: c[0] — общая громкость, дальше — всё более мелкие детали огибающей. Тонкая гребёнка гармоник голоса остаётся в отброшенных.
Веса мел-фильтров в таблицах считает такой фрагмент генератора
(gen_tables.py):
pts = [mel(FMIN) + (mel(FMAX) - mel(FMIN)) * i / (NMEL + 1) for i in range(NMEL + 2)]
first, band, wgt = None, [], []
for k in range(NFFT // 2 + 1):
    m = mel(k * FS / NFFT)
    if m < pts[0] or m >= pts[-1]:
        continue
    if first is None:
        first = k
    b = max(i for i in range(NMEL + 1) if pts[i] <= m)
    band.append(b)
    wgt.append(q15((m - pts[b]) / (pts[b + 1] - pts[b])))
Приём в нём главный для памяти: точки стоят по шкале мел поровну, поэтому бин между точками b и b + 1 входит ровно в два треугольника — с весом w на подъёме одного и 1 − w на спаде соседнего. Хватает одного веса и одного номера на бин: 255 бинов — 765 байт. Полная матрица 40 × 257 в int16 заняла бы 20 560 байт.
121б.4 Целые числа: спектр, логарифм, таблицы
Весь расчёт окна — один файл. БПФ по основанию 2, данные int32, повороты Q15 из таблицы синуса на 384 числа:
/* Данные int32, повороты Q15. div2 = 0: без деления, спектр до 23 бит.
   div2 = 1: каждый каскад делит на 2 — спектр / 512 помещается в 16 бит. */
static void fft512(int32_t *re, int32_t *im, int div2)
{
    for (uint32_t i = 1, j = 0; i < NFFT; i++) {             /* перестановка по обратным битам */
        uint32_t bit = NFFT >> 1;
        for (; j & bit; bit >>= 1)
            j ^= bit;
        j ^= bit;
        if (i < j) {
            int32_t t = re[i]; re[i] = re[j]; re[j] = t;
            t = im[i]; im[i] = im[j]; im[j] = t;
        }
    }
    for (uint32_t len = 2, step = NFFT / 2; len <= NFFT; len <<= 1, step >>= 1) {
        uint32_t half = len >> 1;
        for (uint32_t k = 0; k < half; k++) {
            int32_t wr = sin_q15[k * step + NFFT / 4];       /* cos */
            int32_t wi = -sin_q15[k * step];
            for (uint32_t i = k; i < NFFT; i += len) {
                uint32_t j = i + half;
                int32_t tr = (int32_t)(((int64_t)wr * re[j] - (int64_t)wi * im[j]) >> 15);
                int32_t ti = (int32_t)(((int64_t)wr * im[j] + (int64_t)wi * re[j]) >> 15);
                re[j] = (re[i] - tr) >> div2;
                im[j] = (im[i] - ti) >> div2;
                re[i] = (re[i] + tr) >> div2;
                im[i] = (im[i] + ti) >> div2;
            }
        }
    }
    OPS(4 * (NFFT / 2) * 9);
}
Логарифм — без logf: номер старшего бита даёт целую часть log2, а
шесть следующих битов — узел таблицы; между узлами — отрезок прямой.
/* log2(v) в Q12: целая часть — номер старшего бита, дробная — таблица из 65 узлов и отрезок между ними */
static int32_t log2_q12(uint64_t v)
{
    if (v == 0)
        return 0;
    int n = 63 - __builtin_clzll(v);
    uint32_t m = (uint32_t)((v << (63 - n)) >> 32);          /* 1.31: старший бит = 1 */
    uint32_t idx = (m >> 25) & 63u;
    uint32_t fr = (m >> 10) & 0x7FFFu;
    uint32_t a = log2_q15[idx], b = log2_q15[idx + 1];
    uint32_t l = a + (((b - a) * fr) >> 15);
    OPS(1);
    return (n << 12) + (int32_t)((l + 4) >> 3);
}
И само окно — от отсчётов до 10 коэффициентов:
/* y[n] = x[n] - 0,97·x[n-1] в Q15: без округления, до 31 бита */
static inline int32_t preemph(int32_t x, int32_t prev)
{
    return x * 32768 - PREEMPH_Q15 * prev;
}

/* x — 400 отсчётов окна, prev — отсчёт перед окном; cep — 10 коэффициентов */
void mfcc_q15(mfcc_q15_t *w, const int16_t *x, int16_t prev, int32_t *cep)
{
    /* 1. наибольший модуль после предыскажения и сдвиг, при котором он занимает 15 бит */
    int32_t peak = 0, p = prev;
    for (uint32_t n = 0; n < FRAME; n++) {
        int32_t y = preemph(x[n], p);
        p = x[n];
        if (y < 0)
            y = -y;
        if (y > peak)
            peak = y;
    }
    int sh = -1;                                             /* без нормировки: 17 бит -> 16 */
    if (!w->no_norm)
        sh = __builtin_clz((uint32_t)peak | 1u) - 2;         /* от -1 до 29 */
    w->shift = (int8_t)sh;
    /* 2. предыскажение, окно Хэмминга (в таблице половина окна) и нормировка одним сдвигом */
    p = prev;
    for (uint32_t n = 0; n < FRAME; n++) {
        int64_t y = (int64_t)preemph(x[n], p) * hamming_q15[n < FRAME / 2 ? n : FRAME - 1 - n];
        p = x[n];
        w->re[n] = (int32_t)((y + ((int64_t)1 << (29 - sh))) >> (30 - sh));
        w->im[n] = 0;
    }
    for (uint32_t n = FRAME; n < NFFT; n++)
        w->re[n] = w->im[n] = 0;
    OPS(3 * FRAME);
    /* 3. БПФ: сумма 400 отсчётов по 15 бит с окном — меньше 2^23 */
    fft512(w->re, w->im, w->fft16);
    /* 4. мощность бина и раскладка по двум соседним мел-полосам */
    for (uint32_t m = 0; m < NMEL; m++)
        w->e[m] = 0;
    for (uint32_t i = 0; i < MEL_BINS; i++) {
        uint32_t k = MEL_FIRST + i;
        uint64_t pw = (uint64_t)((int64_t)w->re[k] * w->re[k] + (int64_t)w->im[k] * w->im[k]);   /* < 2^46 */
        uint64_t up = (pw * (uint32_t)mel_w_q15[i]) >> 15;
        uint32_t b = mel_band[i];
        if (b < NMEL)
            w->e[b] += up;                                   /* подъём полосы b */
        if (b > 0)
            w->e[b - 1] += pw - up;                          /* спад полосы b - 1 */
    }
    OPS(3 * MEL_BINS);
    /* 5. логарифм; поправка возвращает сдвиг нормировки (и деление на 512 при fft16) */
    for (uint32_t m = 0; m < NMEL; m++) {
        int32_t l = log2_q12(w->e[m]) + ((w->fft16 ? 18 : 0) - 2 * sh) * 4096;
        w->logmel[m] = l < 0 ? 0 : l;
    }
    /* 6. ДКП-II: первые 10 коэффициентов */
    for (uint32_t i = 0; i < NCEP; i++) {
        int64_t acc = 0;
        for (uint32_t m = 0; m < NMEL; m++)
            acc += (int64_t)w->logmel[m] * dct_q15[i * NMEL + m];
        cep[i] = (int32_t)((acc + 16384) >> 15);
    }
    OPS(NCEP * NMEL);
}
Три решения здесь не очевидны, и каждое проверено прогоном.
Нормировка окна. Тихий звук занимает младшие биты, а дальше идут
умножения со сдвигом на 15 — младшие биты теряются. Поэтому перед окном
ищется наибольший модуль и всё окно сдвигается так, чтобы он занял 15
бит. Сдвиг sh потом возвращается в логарифме вычитанием 2 · sh — это и
есть польза шага 6: масштаб стал слагаемым.
Предыскажение без округления. Произведение 0,97 · x считается в Q15 и не округляется до целого отсчёта: разность занимает до 31 бита и приводится к 15 одним сдвигом вместе с окном. Если округлить раньше, на тихом звуке ошибка округления сравнима с самим сигналом.
Спектр в int32. Привычный приём для Q15 — делить на 2 в каждом каскаде БПФ, чтобы спектр остался в 16 битах. Переполнения так нет, но слабые бины рядом с сильными тонут в округлении: после деления на 512 от них остаются единицы. Здесь спектр растёт свободно: сумма 400 отсчётов по 15 бит с окном меньше 2²³, мощность бина — меньше 2⁴⁶, энергия полосы копится в 64 битах.
Сверка: 1200 записей по 49 окон — 58 800 окон; коэффициенты из C
переведены в натуральный логарифм и сравнены с numpy (float64,
np.fft.rfft, полная матрица фильтров). Для масштаба: разброс
коэффициентов по набору — 18,46 у c[0], 4,65 у c[1], 1,47 у c[9],
наименьший — 1,07.
| Что сравнивается | Ошибка |
|---|---|
| эталон float на C, энергии мел-полос | до 3,0 · 10⁻⁵ от величины |
| эталон float на C, MFCC | до 7,3 · 10⁻⁵ |
| Q15, логарифм энергии полос (980 окон) | СКЗ 0,0085, наибольшая 0,4253 |
| Q15, MFCC | СКЗ 0,0148, наибольшая 0,3428 |
И те же 50 записей на четырёх уровнях громкости, три варианта счёта. Ошибка MFCC, СКЗ и наибольшая:
| Уровень | Спектр int32, с нормировкой | Спектр 16 бит, с нормировкой | Спектр 16 бит, без нормировки |
|---|---|---|---|
| 0 дБ | 0,0157 и 0,1869 | 0,4948 и 5,6269 | 5,0053 и 39,7061 |
| −20 дБ | 0,0143 и 0,1454 | 0,5056 и 4,8150 | 12,1436 и 73,8945 |
| −40 дБ | 0,0130 и 0,1992 | 0,4699 и 5,5323 | 20,8939 и 95,9931 |
| −60 дБ | 0,0047 и 0,0945 | 0,2259 и 4,4139 | 28,6991 и 123,9914 |
Без нормировки ошибка больше самих коэффициентов уже на полной громкости. Нормировка с 16-битным спектром делает её одинаковой на всех уровнях, но СКЗ около 0,5 — это половина разброса младших коэффициентов. Спектр int32 даёт ошибку в десятки раз меньше разброса и не зависит от громкости. Цена — 2048 байт ОЗУ: массивы спектра 4096 байт вместо 2048.
Таблицы (все — const, во флеш): половина окна Хэмминга — 400 байт,
синус — 768, мел-фильтры — 765, логарифм — 130, ДКП — 800. Всего 2863
байта.
Счёт на окно: 11 621 умножение — 1200 на предыскажение, поиск наибольшего модуля и окно, 9216 на БПФ (2304 бабочки по 4), 765 на мощность и мел-полосы, 40 на логарифм, 400 на ДКП. БПФ — четыре пятых всего счёта; вещественный вход позволяет считать его вдвое короче, здесь это не сделано.
121б.5 Сеть int8 поверх признаков
Нормировка признаков. c[0] меняется в десятки раз сильнее, чем c[9], поэтому у каждого коэффициента своё среднее и свой множитель — они считаются по обучающим записям и уходят в прошивку вместе с весами (раздел 118: нормировка — часть модели). Признак — (c − среднее) / отклонение · 32 с насыщением на ±127: вход сети сразу int8 с масштабом 1/32 и нулевой точкой 0. Насыщенных признаков в обучении — 583 из 392 000.
Сеть — полносвязная 490 → 24 → 5 с ReLU. Обучена на numpy (Adam, 60
эпох, зерно задано) на признаках из той же функции mfcc_q15, что
работает на приборе: модель видит ровно те числа, которые получит.
Набор: 800 записей на обучение и 400 отложенных, по 160 и 80 на класс.
Квантование — по разделу 119: веса int8 с одним масштабом на слой, смещения int32, пересчёт суммы множителем Q31 и сдвигом с одним округлением. Множители вышли 1 882 415 126 со сдвигом на 41 и 1 468 209 255 со сдвигом на 39. Наибольшая сумма первого слоя — 294 014: int32 хватает с большим запасом.
/* нормировка: q = (c - среднее) / отклонение · 32, с насыщением; среднее и множитель — из обучения */
void kws_features(const int32_t *cep, int8_t *q)
{
    for (uint32_t i = 0; i < NCEP; i++) {
        int64_t v = ((int64_t)(cep[i] - kws_mu[i]) * kws_k[i] + (1 << 23)) >> 24;
        q[i] = (int8_t)(v > 127 ? 127 : v < -127 ? -127 : v);
    }
    OPS(NCEP);
}

/* пересчёт суммы в масштаб выхода: умножение на mult / 2^(31 + sh), одно округление */
static inline int32_t requant(int32_t acc, int32_t mult, int sh)
{
    return (int32_t)(((int64_t)acc * mult + ((int64_t)1 << (30 + sh))) >> (31 + sh));
}

void kws_infer(const int8_t *feat, int8_t *out)
{
    int8_t h[KWS_HID];
    for (uint32_t j = 0; j < KWS_HID; j++) {                 /* слой 1 с ReLU */
        const int8_t *w = &kws_w1[j * KWS_IN];
        int32_t acc = kws_b1[j];
        for (uint32_t i = 0; i < KWS_IN; i++)
            acc += w[i] * feat[i];                           /* нулевая точка входа 0 */
        int32_t v = requant(acc, KWS_M1, KWS_S1) + KWS_ZH;
        h[j] = (int8_t)(v < KWS_ZH ? KWS_ZH : v > 127 ? 127 : v);
    }
    for (uint32_t j = 0; j < KWS_OUT; j++) {                 /* слой 2 */
        const int8_t *w = &kws_w2[j * KWS_HID];
        int32_t acc = kws_b2[j];
        for (uint32_t i = 0; i < KWS_HID; i++)
            acc += w[i] * (h[i] - KWS_ZH);
        int32_t v = requant(acc, KWS_M2, KWS_S2);
        out[j] = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
    }
    OPS(KWS_HID * KWS_IN + KWS_OUT * KWS_HID + KWS_HID + KWS_OUT);
}
Результат на 400 отложенных записях:
| Верно | Совпало | |
|---|---|---|
| float (numpy) | 389 | — |
| int8, расчёт в целых на Python | 389 | класс совпал с float в 400 из 400 |
| int8 на C | 389 | признаки и выходы совпали с Python бит в бит в 400 из 400 |
Матрица ошибок сети int8 на C (строка — что было, столбец — ответ):
| прочее | вверх | вниз | два | гласная | |
|---|---|---|---|---|---|
| прочее | 76 | 1 | 1 | 1 | 1 |
| вверх | 1 | 79 | 0 | 0 | 0 |
| вниз | 1 | 1 | 78 | 0 | 0 |
| два | 3 | 0 | 1 | 76 | 0 |
| гласная | 0 | 0 | 0 | 0 | 80 |
Квантование не изменило ни одного ответа. Ошибки — в основном между «прочим» и командами: в «прочем» есть обрезанные команды, и граница между «видна половина команды» и «команда» размыта.
Размер. Параметров 11 909: веса — 11 880 байт, смещения — 116, нормировка — 80; всего 12 076 байт. Во float одни веса и смещения — 47 636 байт. Один ответ сети — 11 909 умножений: 11 880 с накоплением и 29 в пересчётах масштаба. Почти все веса — в первом слое, 490 × 24. Свёрточная сеть с раздельными свёртками по глубине (depthwise separable) на тех же признаках 49 × 10 обходится меньшим числом весов при большем счёте — это обычный выбор для настоящей речи; здесь она не обучалась.
Через микрофон. Первые 20 отложенных записей каждого класса
пропущены через весь тракт: модель микрофона, pdm_decimate, MFCC, сеть.
| Верно из 100 | |
|---|---|
| те же записи напрямую | 97 |
| через модулятор, CIC и КИХ | 87 |
Ответ совпал с прямым в 88 записях. Почти все потери — класс «два»: 9 верных из 20. Тракт меняет спектр — модель микрофона растягивает отсчёты линейной интерполяцией, а фильтр спадает к 8 кГц, — а сеть этого при обучении не видела. Вывод практический: учить надо на записях, прошедших тот же микрофон и те же фильтры, что и в приборе.
121б.6 Поток: скользящее окно, сглаживание, ложные срабатывания
На приборе записей нет — есть поток. Функция kws_push принимает
отсчёты как придут (хоть по 16 из обработчика DMA), собирает окно, после
каждого окна сдвигает буфер признаков на один кадр и запускает сеть:
/* Отсчёты 16 кГц по мере прихода. Возвращает число новых кадров; после каждого
   кадра признаки сдвинуты и k->out пересчитан. */
int kws_push(kws_t *k, const int16_t *pcm, uint32_t n)
{
    int frames = 0;
    for (uint32_t i = 0; i < n; i++) {
        k->buf[k->fill++] = pcm[i];
        if (k->fill < 1 + FRAME)
            continue;
        int32_t cep[NCEP];
        mfcc_q15(&k->w, &k->buf[1], k->buf[0], cep);
        memmove(k->feat, k->feat + NCEP, NFEAT - NCEP);      /* самый старый кадр уходит */
        kws_features(cep, &k->feat[NFEAT - NCEP]);
        kws_infer(k->feat, k->out);
        memmove(k->buf, k->buf + HOP, (1 + FRAME - HOP) * sizeof k->buf[0]);
        k->fill = 1 + FRAME - HOP;                           /* 80 отсчётов перекрытия и один перед окном */
        frames++;
    }
    return frames;
}
Сеть смотрит на последнюю секунду и отвечает каждые 20 мс. Пока команда въезжает в окно, сеть видит её кусок и отвечает что попало; когда команда целиком в окне, ответ верен много кадров подряд. Отсюда три приёма против ложных срабатываний:
- сглаживание — складывать выходы сети за несколько последних кадров;
- запас — срабатывать, только если лучший класс обгоняет второй не меньше чем на порог;
- пауза — после срабатывания молчать, пока команда не выйдет из окна.
/* Сглаживание и решение. smooth — сколько последних ответов сети усреднять (до 16),
   margin — на сколько сумма лучшего класса должна обгонять второй (в единицах выхода, на один ответ),
   hold — сколько кадров молчать после срабатывания. Возвращает номер команды 1…4 или 0. */
int kws_decide(kws_post_t *p, const int8_t *out, int smooth, int margin, int hold)
{
    for (uint32_t c = 0; c < NCLASS; c++) {
        if (p->fill == smooth)
            p->sum[c] = (int16_t)(p->sum[c] - p->hist[p->pos][c]);
        p->hist[p->pos][c] = out[c];
        p->sum[c] = (int16_t)(p->sum[c] + out[c]);
    }
    p->pos = (uint8_t)((p->pos + 1) % smooth);
    if (p->fill < smooth)
        p->fill++;
    if (p->hold) {
        p->hold--;
        return 0;
    }
    if (p->fill < smooth)
        return 0;
    int best = 0, second = -32768;
    for (int c = 1; c < NCLASS; c++)
        if (p->sum[c] > p->sum[best])
            best = c;
    for (int c = 0; c < NCLASS; c++)
        if (c != best && p->sum[c] > second)
            second = p->sum[c];
    if (best == 0 || p->sum[best] - second < margin * smooth)
        return 0;
    p->hold = (uint16_t)hold;
    return best;
}
Прогон: поток 180 с — шум на уровне −40 дБ, 41 команда и 26 посторонних звуков (тоны, всплески шума, гласная с другими формантами) через 1,6…3 с, 8999 кадров. Пауза — 50 кадров (1 с). Срабатывание засчитано, если пришлось на команду того же класса или на 1,5 с после неё.
| Сглаживание, кадров | Запас | Найдено из 41 | Ложных | Не та команда | Повтор | Без команды |
|---|---|---|---|---|---|---|
| 1 | 0 | 24 | 27 | 19 | 1 | 7 |
| 1 | 20 | 38 | 8 | 3 | 0 | 5 |
| 1 | 40 | 41 | 2 | 0 | 0 | 2 |
| 1 | 60 | 33 | 1 | 0 | 0 | 1 |
| 4 | 0 | 26 | 25 | 16 | 2 | 7 |
| 4 | 20 | 40 | 4 | 1 | 0 | 3 |
| 4 | 40 | 39 | 1 | 0 | 0 | 1 |
| 4 | 60 | 28 | 0 | 0 | 0 | 0 |
| 8 | 0 | 25 | 24 | 17 | 1 | 6 |
| 8 | 20 | 41 | 3 | 0 | 0 | 3 |
| 8 | 40 | 38 | 1 | 0 | 0 | 1 |
| 8 | 60 | 21 | 0 | 0 | 0 | 0 |
Что видно:
- Без запаса детектор бесполезен: 24–26 команд из 41 и столько же ложных. Он срабатывает на первый же кусок команды, называет не тот класс (16–19 раз), а паузой закрывает себе правильный ответ.
- Запас важнее сглаживания. Уже при запасе 40 без сглаживания — 41 из 41 и 2 ложных.
- Сглаживание позволяет снизить запас: 8 кадров и запас 20 — 41 из 41 и 3 ложных, все на посторонних звуках.
- Большой запас убирает ложные совсем, но теряет команды: при запасе 60 и 8 кадрах — 21 из 41 и ни одного ложного.
Порог выбирают по цене ошибки. Здесь он подобран на том же потоке, на котором измерен, — на другом потоке числа будут другими.
Сборка под Cortex-M. Весь тракт — одна функция на блок из 384 байт PDM (1 мс):
/* pdm — 384 байта: 3072 бита, 16 отсчётов 16 кГц (1 мс) */
int audio_block(const uint8_t *pdm)
{
    int16_t pcm[16];
    uint32_t n = pdm_decimate(&pdm_state, pdm, 384, pcm);
    if (!kws_push(&kws_state, pcm, n))
        return 0;
    return kws_decide(&post_state, kws_state.out, 8, 40, 50);
}
arm-none-eabi-gcc 12.2.1, размеры объектных файлов в байтах:
| MFCC: код | Сеть и поток: код | Прореживание: код | Таблицы и веса | |
|---|---|---|---|---|
Cortex-M4, -Os |
1128 | 736 | 260 | 2863 + 12 076 + 128 |
Cortex-M4, -O2 |
1028 | 788 | 340 | те же |
Cortex-M33, -Os |
1120 | 736 | 260 | те же |
Кода — около 2 КБ, данных — 15 КБ, и почти все они — веса первого слоя.
ОЗУ: состояние распознавания — 5888 байт (из них 4584 — рабочие массивы
MFCC, 802 — окно отсчётов, 490 — признаки), прореживание — 292,
сглаживание — 94. Стек функций — до 80 байт у каждой. Образ без
стартового файла, с memmove и memset из библиотеки: 17 964 байта
кода и констант, 6276 байт ОЗУ.
Время. На секунду потока — 1 176 869 умножений: 50 окон MFCC и 50 ответов сети. Плюс прореживание PDM из подраздела 121б.2, если оно программное. Такты не мерились: в умножениях БПФ 64-битные произведения, в сети — 8-битные с накоплением, и стоят они по-разному. Если счёта много, первым делом сеть запускают не на каждом кадре, а через один-три.
121б.7 Грабли
Тихую команду не слышит. Нет нормировки окна: в Q15 младшие биты теряются в умножениях. Без неё ошибка MFCC на уровне −40 дБ — 20,89 при разбросе самих коэффициентов от 1,07 до 18,46.
Признаки шумят, хотя переполнений нет. Спектр в 16 битах с делением на 2 в каждом каскаде БПФ: слабые бины тонут в округлении. Ошибка MFCC — около 0,5 против 0,015 у спектра int32.
Предыскажение округлено до отсчёта. На тихом сигнале ошибка округления 0,97 · x сравнима с разностью соседних отсчётов. Разность считают в Q15 и сдвигают один раз, вместе с окном.
На записях всё верно, с микрофона — нет. Сеть обучена на отсчётах, а работает после модулятора и фильтров: 87 верных из 100 вместо 97. В обучение — записи через тот же тракт.
Срабатывает на начало команды и не тем классом. Нет запаса: 19 неверных команд из 27 ложных. Нужен порог между лучшим и вторым классом и пауза после срабатывания.
Порог «на глаз» теряет команды. Запас 60 при сглаживании 8 — 21 команда из 41. Порог подбирают прогоном по потоку с известной разметкой.
Нормировка признаков не та, что при обучении. Среднее и множитель — часть модели: их считают по обучающим записям и кладут в тот же заголовок, что и веса.
Интеграторы CIC «переполняются». Так и должно быть: вычитания в гребёнках идут по тому же модулю. Нельзя только, чтобы размах выхода — 48⁴ при прореживании на 48 и 4-м порядке — вышел за слово. Насыщать интеграторы нельзя.
Матрица мел-фильтров съела флеш. Полная матрица 40 × 257 — 20 560 байт. Вес и номер полосы на бин — 765 байт, результат тот же.
Верх спектра после прореживания грязный. Переходная полоса КИХ: на 9 кГц подавление всего 21,70 дБ, и это складывается в 7 кГц. Либо фильтр длиннее, либо верхние мел-полосы не использовать.
121б.8 Итоги
- Тракт: 3,072 МГц → CIC 4-го порядка на 48 → КИХ 64 отвода на 4 → 16 кГц; размах CIC 48⁴ = 5 308 416 меньше 2²³; усиление на 1, 4 и 7 кГц — 0,02, −0,22 и −1,40 дБ, как по формуле; выход C совпал с numpy бит в бит.
- Программное прореживание — 12 288 000 сложений и 1 024 000 умножений в секунду; у F407 оно программное, у U585 CIC считают MDF и ADF.
- MFCC: окно 400, шаг 320, БПФ 512, 40 мел-полос 20…8000 Гц, log2 по таблице, ДКП-II, 10 коэффициентов; 11 621 умножение на окно, таблицы 2863 байта.
- Целые числа повторяют float, если окно нормировано, предыскажение не округлено, а спектр в int32: ошибка MFCC 0,0148 при разбросе от 1,07; со спектром в 16 битах — около 0,5, без нормировки — от 5 до 29.
- Сеть 490 → 24 → 5 в int8: 11 909 параметров, 12 076 байт; на 400 синтетических записях 389 верных и во float, и в int8; C совпал с расчётом Python бит в бит.
- Через модель микрофона — 87 из 100 вместо 97: учить на записях, прошедших тракт.
- Поток 180 с: сглаживание 8 кадров, запас 20, пауза 1 с — 41 команда из 41 и 3 ложных; без запаса — 25 из 41 и 24 ложных.
- Cortex-M4: код около 2 КБ, таблицы и веса 15 КБ, ОЗУ 5888 + 292 + 94 байта; 1 176 869 умножений на секунду потока.
- Команды синтетические: это проверка тракта, а не точность на речи.
Полные исходники
pdm.c — прореживание PDM: CIC 4-го порядка и КИХ-фильтр.
/* Прореживание PDM: CIC 4-го порядка на 48 и КИХ на 64 отвода с прореживанием на 4. */
#include "audio.h"
#include "mfcc_tables.h"

_Static_assert(CIC_R * CIC_R * CIC_R * CIC_R == 81 * 65536, "48^4 = 81 * 2^16: усиление CIC");
_Static_assert((FIR_N & (FIR_N - 1)) == 0, "длина КИХ — степень двойки");

/* Байты PDM старшим битом вперёд; бит 1 = +1, бит 0 = -1.
   Возвращает число готовых отсчётов 16 кГц, записанных в pcm. */
uint32_t pdm_decimate(pdm_t *st, const uint8_t *pdm, uint32_t nbytes, int16_t *pcm)
{
    uint32_t nout = 0;
    for (uint32_t i = 0; i < nbytes; i++) {
        uint32_t byte = pdm[i];
        for (int b = 7; b >= 0; b--) {
            st->i1 += ((byte >> b) & 1u) ? 1u : 0xFFFFFFFFu;   /* четыре интегратора */
            st->i2 += st->i1;
            st->i3 += st->i2;
            st->i4 += st->i3;
            if (++st->nbit < CIC_R)
                continue;
            st->nbit = 0;
            uint32_t d1 = st->i4 - st->c1;                       /* четыре гребёнки */
            st->c1 = st->i4;
            uint32_t d2 = d1 - st->c2;
            st->c2 = d1;
            uint32_t d3 = d2 - st->c3;
            st->c3 = d2;
            uint32_t d4 = d3 - st->c4;
            st->c4 = d3;
            st->line[st->pos] = (int32_t)d4;                     /* |d4| <= 48^4 < 2^23 */
            st->pos = (uint8_t)((st->pos + 1) & (FIR_N - 1));
            if (++st->phase < FIR_DEC)
                continue;
            st->phase = 0;
            int64_t acc = 0;
            for (uint32_t k = 0; k < FIR_N; k++)                 /* line[pos] — самый старый */
                acc += (int64_t)fir_q[k] * st->line[(st->pos + k) & (FIR_N - 1)];
            OPS(FIR_N);
            int32_t v = (int32_t)((acc + (1 << 22)) >> 23);
            pcm[nout++] = (int16_t)(v > 32767 ? 32767 : v < -32768 ? -32768 : v);
        }
    }
    return nout;
}
mfcc_q15.c — MFCC в целых числах: окно 400 отсчётов → 10 коэффициентов.
/* MFCC в целых числах: окно 400 отсчётов int16 -> 10 коэффициентов (log2 в Q12). */
#include "audio.h"
#include "mfcc_tables.h"

#define PREEMPH_Q15 31785            /* 0,97 */

/* Данные int32, повороты Q15. div2 = 0: без деления, спектр до 23 бит.
   div2 = 1: каждый каскад делит на 2 — спектр / 512 помещается в 16 бит. */
static void fft512(int32_t *re, int32_t *im, int div2)
{
    for (uint32_t i = 1, j = 0; i < NFFT; i++) {             /* перестановка по обратным битам */
        uint32_t bit = NFFT >> 1;
        for (; j & bit; bit >>= 1)
            j ^= bit;
        j ^= bit;
        if (i < j) {
            int32_t t = re[i]; re[i] = re[j]; re[j] = t;
            t = im[i]; im[i] = im[j]; im[j] = t;
        }
    }
    for (uint32_t len = 2, step = NFFT / 2; len <= NFFT; len <<= 1, step >>= 1) {
        uint32_t half = len >> 1;
        for (uint32_t k = 0; k < half; k++) {
            int32_t wr = sin_q15[k * step + NFFT / 4];       /* cos */
            int32_t wi = -sin_q15[k * step];
            for (uint32_t i = k; i < NFFT; i += len) {
                uint32_t j = i + half;
                int32_t tr = (int32_t)(((int64_t)wr * re[j] - (int64_t)wi * im[j]) >> 15);
                int32_t ti = (int32_t)(((int64_t)wr * im[j] + (int64_t)wi * re[j]) >> 15);
                re[j] = (re[i] - tr) >> div2;
                im[j] = (im[i] - ti) >> div2;
                re[i] = (re[i] + tr) >> div2;
                im[i] = (im[i] + ti) >> div2;
            }
        }
    }
    OPS(4 * (NFFT / 2) * 9);
}

/* log2(v) в Q12: целая часть — номер старшего бита, дробная — таблица из 65 узлов и отрезок между ними */
static int32_t log2_q12(uint64_t v)
{
    if (v == 0)
        return 0;
    int n = 63 - __builtin_clzll(v);
    uint32_t m = (uint32_t)((v << (63 - n)) >> 32);          /* 1.31: старший бит = 1 */
    uint32_t idx = (m >> 25) & 63u;
    uint32_t fr = (m >> 10) & 0x7FFFu;
    uint32_t a = log2_q15[idx], b = log2_q15[idx + 1];
    uint32_t l = a + (((b - a) * fr) >> 15);
    OPS(1);
    return (n << 12) + (int32_t)((l + 4) >> 3);
}

/* y[n] = x[n] - 0,97·x[n-1] в Q15: без округления, до 31 бита */
static inline int32_t preemph(int32_t x, int32_t prev)
{
    return x * 32768 - PREEMPH_Q15 * prev;
}

/* x — 400 отсчётов окна, prev — отсчёт перед окном; cep — 10 коэффициентов */
void mfcc_q15(mfcc_q15_t *w, const int16_t *x, int16_t prev, int32_t *cep)
{
    /* 1. наибольший модуль после предыскажения и сдвиг, при котором он занимает 15 бит */
    int32_t peak = 0, p = prev;
    for (uint32_t n = 0; n < FRAME; n++) {
        int32_t y = preemph(x[n], p);
        p = x[n];
        if (y < 0)
            y = -y;
        if (y > peak)
            peak = y;
    }
    int sh = -1;                                             /* без нормировки: 17 бит -> 16 */
    if (!w->no_norm)
        sh = __builtin_clz((uint32_t)peak | 1u) - 2;         /* от -1 до 29 */
    w->shift = (int8_t)sh;
    /* 2. предыскажение, окно Хэмминга (в таблице половина окна) и нормировка одним сдвигом */
    p = prev;
    for (uint32_t n = 0; n < FRAME; n++) {
        int64_t y = (int64_t)preemph(x[n], p) * hamming_q15[n < FRAME / 2 ? n : FRAME - 1 - n];
        p = x[n];
        w->re[n] = (int32_t)((y + ((int64_t)1 << (29 - sh))) >> (30 - sh));
        w->im[n] = 0;
    }
    for (uint32_t n = FRAME; n < NFFT; n++)
        w->re[n] = w->im[n] = 0;
    OPS(3 * FRAME);
    /* 3. БПФ: сумма 400 отсчётов по 15 бит с окном — меньше 2^23 */
    fft512(w->re, w->im, w->fft16);
    /* 4. мощность бина и раскладка по двум соседним мел-полосам */
    for (uint32_t m = 0; m < NMEL; m++)
        w->e[m] = 0;
    for (uint32_t i = 0; i < MEL_BINS; i++) {
        uint32_t k = MEL_FIRST + i;
        uint64_t pw = (uint64_t)((int64_t)w->re[k] * w->re[k] + (int64_t)w->im[k] * w->im[k]);   /* < 2^46 */
        uint64_t up = (pw * (uint32_t)mel_w_q15[i]) >> 15;
        uint32_t b = mel_band[i];
        if (b < NMEL)
            w->e[b] += up;                                   /* подъём полосы b */
        if (b > 0)
            w->e[b - 1] += pw - up;                          /* спад полосы b - 1 */
    }
    OPS(3 * MEL_BINS);
    /* 5. логарифм; поправка возвращает сдвиг нормировки (и деление на 512 при fft16) */
    for (uint32_t m = 0; m < NMEL; m++) {
        int32_t l = log2_q12(w->e[m]) + ((w->fft16 ? 18 : 0) - 2 * sh) * 4096;
        w->logmel[m] = l < 0 ? 0 : l;
    }
    /* 6. ДКП-II: первые 10 коэффициентов */
    for (uint32_t i = 0; i < NCEP; i++) {
        int64_t acc = 0;
        for (uint32_t m = 0; m < NMEL; m++)
            acc += (int64_t)w->logmel[m] * dct_q15[i * NMEL + m];
        cep[i] = (int32_t)((acc + 16384) >> 15);
    }
    OPS(NCEP * NMEL);
}
kws.c — распознавание команды: поток отсчётов → признаки int8 → сеть → решение.
/* Распознавание команды: поток отсчётов -> признаки int8 -> сеть 490 -> 24 -> 5 -> решение. */
#include <string.h>
#include "audio.h"
#include "kws_model.h"

_Static_assert(KWS_IN == NFEAT && KWS_OUT == NCLASS, "размеры сети и признаков");

void kws_init(kws_t *k)
{
    memset(k, 0, sizeof *k);
    k->fill = 1;                                   /* buf[0] = 0: перед первым окном тишина; */
                                                   /* признаки 0 — среднее по обучающим записям */
}

/* нормировка: q = (c - среднее) / отклонение · 32, с насыщением; среднее и множитель — из обучения */
void kws_features(const int32_t *cep, int8_t *q)
{
    for (uint32_t i = 0; i < NCEP; i++) {
        int64_t v = ((int64_t)(cep[i] - kws_mu[i]) * kws_k[i] + (1 << 23)) >> 24;
        q[i] = (int8_t)(v > 127 ? 127 : v < -127 ? -127 : v);
    }
    OPS(NCEP);
}

/* пересчёт суммы в масштаб выхода: умножение на mult / 2^(31 + sh), одно округление */
static inline int32_t requant(int32_t acc, int32_t mult, int sh)
{
    return (int32_t)(((int64_t)acc * mult + ((int64_t)1 << (30 + sh))) >> (31 + sh));
}

void kws_infer(const int8_t *feat, int8_t *out)
{
    int8_t h[KWS_HID];
    for (uint32_t j = 0; j < KWS_HID; j++) {                 /* слой 1 с ReLU */
        const int8_t *w = &kws_w1[j * KWS_IN];
        int32_t acc = kws_b1[j];
        for (uint32_t i = 0; i < KWS_IN; i++)
            acc += w[i] * feat[i];                           /* нулевая точка входа 0 */
        int32_t v = requant(acc, KWS_M1, KWS_S1) + KWS_ZH;
        h[j] = (int8_t)(v < KWS_ZH ? KWS_ZH : v > 127 ? 127 : v);
    }
    for (uint32_t j = 0; j < KWS_OUT; j++) {                 /* слой 2 */
        const int8_t *w = &kws_w2[j * KWS_HID];
        int32_t acc = kws_b2[j];
        for (uint32_t i = 0; i < KWS_HID; i++)
            acc += w[i] * (h[i] - KWS_ZH);
        int32_t v = requant(acc, KWS_M2, KWS_S2);
        out[j] = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
    }
    OPS(KWS_HID * KWS_IN + KWS_OUT * KWS_HID + KWS_HID + KWS_OUT);
}

/* Отсчёты 16 кГц по мере прихода. Возвращает число новых кадров; после каждого
   кадра признаки сдвинуты и k->out пересчитан. */
int kws_push(kws_t *k, const int16_t *pcm, uint32_t n)
{
    int frames = 0;
    for (uint32_t i = 0; i < n; i++) {
        k->buf[k->fill++] = pcm[i];
        if (k->fill < 1 + FRAME)
            continue;
        int32_t cep[NCEP];
        mfcc_q15(&k->w, &k->buf[1], k->buf[0], cep);
        memmove(k->feat, k->feat + NCEP, NFEAT - NCEP);      /* самый старый кадр уходит */
        kws_features(cep, &k->feat[NFEAT - NCEP]);
        kws_infer(k->feat, k->out);
        memmove(k->buf, k->buf + HOP, (1 + FRAME - HOP) * sizeof k->buf[0]);
        k->fill = 1 + FRAME - HOP;                           /* 80 отсчётов перекрытия и один перед окном */
        frames++;
    }
    return frames;
}

/* Сглаживание и решение. smooth — сколько последних ответов сети усреднять (до 16),
   margin — на сколько сумма лучшего класса должна обгонять второй (в единицах выхода, на один ответ),
   hold — сколько кадров молчать после срабатывания. Возвращает номер команды 1…4 или 0. */
int kws_decide(kws_post_t *p, const int8_t *out, int smooth, int margin, int hold)
{
    for (uint32_t c = 0; c < NCLASS; c++) {
        if (p->fill == smooth)
            p->sum[c] = (int16_t)(p->sum[c] - p->hist[p->pos][c]);
        p->hist[p->pos][c] = out[c];
        p->sum[c] = (int16_t)(p->sum[c] + out[c]);
    }
    p->pos = (uint8_t)((p->pos + 1) % smooth);
    if (p->fill < smooth)
        p->fill++;
    if (p->hold) {
        p->hold--;
        return 0;
    }
    if (p->fill < smooth)
        return 0;
    int best = 0, second = -32768;
    for (int c = 1; c < NCLASS; c++)
        if (p->sum[c] > p->sum[best])
            best = c;
    for (int c = 0; c < NCLASS; c++)
        if (c != best && p->sum[c] > second)
            second = p->sum[c];
    if (best == 0 || p->sum[best] - second < margin * smooth)
        return 0;
    p->hold = (uint16_t)hold;
    return best;
}
gen_tables.py — генератор таблиц MFCC в Q15 и фильтра прореживания.
# -*- coding: utf-8 -*-
"""Таблицы для MFCC в Q15 и фильтра прореживания: python3 gen_tables.py > mfcc_tables.h
Чистый Python, без numpy: результат одинаков на любой машине."""
import math
import sys

sys.stdout.reconfigure(encoding="utf-8", newline="\n")

FS, FRAME, NFFT, NMEL, NCEP = 16000, 400, 512, 40, 10
FMIN, FMAX = 20.0, 8000.0
FIR_N, FIR_FS, FIR_FC, FIR_S, CIC_GAIN = 64, 64000.0, 8000.0, 23, 81


def mel(f):
    return 2595.0 * math.log10(1.0 + f / 700.0)


def q15(v):
    return min(32767, int(math.floor(v * 32768.0 + 0.5)))


def emit(ctype, name, vals, per=10):
    print("static const %s %s[%d] = {" % (ctype, name, len(vals)))
    for i in range(0, len(vals), per):
        print("    " + ", ".join("%d" % v for v in vals[i:i + per]) + ",")
    print("};\n")


print("/* Создано gen_tables.py — не править руками. */")
print("#ifndef MFCC_TABLES_H\n#define MFCC_TABLES_H\n#include <stdint.h>\n")

# половина окна Хэмминга: w[n] = 0,54 − 0,46·cos(2πn/(N−1)), вторая половина зеркальна
emit("int16_t", "hamming_q15", [q15(0.54 - 0.46 * math.cos(2 * math.pi * n / (FRAME - 1))) for n in range(FRAME // 2)])

# синус на 3/4 периода: sin(2πk/512), k = 0…383; косинус — со сдвигом на 128
emit("int16_t", "sin_q15", [q15(math.sin(2 * math.pi * k / NFFT)) for k in range(3 * NFFT // 4)])

# мел-фильтры: 42 точки поровну по шкале мел; бин k лежит между точками band и band + 1
pts = [mel(FMIN) + (mel(FMAX) - mel(FMIN)) * i / (NMEL + 1) for i in range(NMEL + 2)]
first, band, wgt = None, [], []
for k in range(NFFT // 2 + 1):
    m = mel(k * FS / NFFT)
    if m < pts[0] or m >= pts[-1]:
        continue
    if first is None:
        first = k
    b = max(i for i in range(NMEL + 1) if pts[i] <= m)
    band.append(b)
    wgt.append(q15((m - pts[b]) / (pts[b + 1] - pts[b])))
print("#define MEL_FIRST %d   /* первый бин внутри 20…8000 Гц */" % first)
print("#define MEL_BINS  %d\n" % len(band))
emit("uint8_t", "mel_band", band, 16)
emit("int16_t", "mel_w_q15", wgt)

# log2(1 + i/64) в Q15, 65 узлов
emit("uint16_t", "log2_q15", [int(math.floor(math.log2(1.0 + i / 64.0) * 32768.0 + 0.5)) for i in range(65)])

# ДКП-II: sqrt(2/M)·cos(π·i·(m + 0,5)/M), i = 0…9, m = 0…39
emit("int16_t", "dct_q15", [int(math.floor(math.sqrt(2.0 / NMEL) * math.cos(math.pi * i * (m + 0.5) / NMEL) * 32768.0 + 0.5))
                             for i in range(NCEP) for m in range(NMEL)])

# КИХ после CIC: оконный sinc (Хэмминг), срез 8 кГц при 64 кГц; усиление 2^23/81 убирает 48^4/2^16 = 81
h = []
for n in range(FIR_N):
    t = n - (FIR_N - 1) / 2.0
    x = 2.0 * FIR_FC / FIR_FS * t
    s = 1.0 if x == 0 else math.sin(math.pi * x) / (math.pi * x)
    h.append(2.0 * FIR_FC / FIR_FS * s * (0.54 - 0.46 * math.cos(2 * math.pi * n / (FIR_N - 1))))
g = sum(h)
emit("int16_t", "fir_q", [int(math.floor(v / g * (1 << FIR_S) / CIC_GAIN + 0.5)) for v in h])
print("#endif")
Дальше: раздел 121в «STM32N6 и камера с нейросетью на батарейке: YOLO на NPU Neural-ART, малое потребление, уличный прибор» — камера на батарейке: NPU считает YOLO, ядро разбирает рамки, прибор спит в Standby; энергобюджет и техническое задание.