 Embedded HandbookПриложения
26. Задачи
Задача — единственное, ради чего берут операционную систему. Всё остальное — очереди, семафоры, таймеры — обслуживает их взаимодействие. Раздел о том, как задачи устроены, по каким правилам получают процессор и какие четыре ошибки делают с ними чаще всего.
Как это называется в документации
Оригинал Перевод task function функция задачи task handle описатель задачи stack depth глубина стека, в словах time slicing разделение времени между равными по приоритету round-robin поочерёдное выделение времени по кругу starvation голодание: задача не получает процессор вовсе blocked / suspended ожидает / приостановлена yield уступить процессор добровольно high water mark наименьший остаток стека за всё время task control block (TCB) блок управления задачей
26.1 Как выглядит задача
static void worker_task(void *arg)
{
    const uint32_t period = (uint32_t)arg;

    for (;;) {                      /* цикл обязателен */
        do_work();
        vTaskDelay(pdMS_TO_TICKS(period));
    }
}
Три обязательных свойства.
Возвращает void, принимает void *. Сигнатура фиксирована — ядро
вызывает функцию по указателю и ничего другого передать не может.
Аргумент часто используют, чтобы одной функцией обслужить несколько
задач: номер канала, период, адрес структуры настроек.
Бесконечный цикл внутри. Задача не завершается — она работает всё время, пока прибор включён.
⚠️ Выходить из функции задачи нельзя. Это не стилистическое пожелание, а требование: возвращаться некуда, адреса возврата в стеке задачи нет. Ядро ловит такой выход проверкой и останавливает программу. Если задача должна отработать один раз и исчезнуть, она обязана удалить себя явно:
c
static void one_shot(void *arg)
{
    do_the_thing();
    vTaskDelete(NULL);      /* NULL означает «удалить себя» */
}
Стек — свой. Все локальные переменные задачи живут в нём, и его размер задаётся при создании.
26.2 Приоритеты: главное недоразумение
Правило планировщика одно и уже звучало: выполняется готовая задача с наибольшим приоритетом. Из него следует вывод, который часто понимают наоборот.
Задачи разного приоритета не делят время между собой. Совсем. Старшая работает, пока не заблокируется; младшие не получают ничего.
Отсюда главная ошибка новичка:
static void high_task(void *arg)
{
    for (;;) {
        poll_sensor();          /* и никакого ожидания */
    }
}
Задача с высоким приоритетом и без единой блокирующей операции полностью останавливает всё, что ниже. Прибор выглядит зависшим, хотя формально работает: просто младшие задачи не выполняются никогда. Это называется голоданием, и лечится оно не понижением приоритета, а добавлением ожидания.
Задачи одного приоритета время делят — по одному тику каждой,
по кругу. Это и есть квантование, и включается оно макросом
configUSE_TIME_SLICING.
| Ситуация | Что происходит |
|---|---|
| задачи разных приоритетов | старшая работает, младшие ждут |
| задачи одного приоритета | по тику каждой, по кругу |
| старшая заблокировалась | процессор идёт следующей по старшинству |
| все ждут | работает задача простоя |
Сколько уровней и как их выбирать
Уровней столько, сколько задано в configMAX_PRIORITIES; нумерация
с нуля, нулевой занят задачей простоя.
⚠️ Приоритет выше максимального. Прежде чем урезать его, ядро проверяет
configASSERT(uxPriority < configMAX_PRIORITIES). С включённой проверкой — а CubeMX её включает — камень встанет прямо в ней, при создании задачи. Без проверки приоритет 10 при пяти уровнях молча превратится в 4: две задачи, которым дали 10 и 99, окажутся на одном уровне и начнут делить время, а в коде будет написано, что одна из них важнее (опыт — в 26.9).
Разумная схема приоритетов для прибора:
| Уровень | Кому |
|---|---|
| высокий | обработка того, что не терпит отлагательства |
| средний | основная логика прибора |
| низкий | вывод на экран, журнал, связь с компьютером |
| 0 | задача простоя, ваших задач здесь нет |
Много уровней не нужно. Три-четыре покрывают почти любой прибор; каждый лишний уровень — это ещё один список готовности в памяти ядра и ещё одно решение, которое придётся принимать при добавлении задачи.
Хватит ли процессора
Приоритеты решают, кто первым, но не отвечают, успеют ли все. Для
периодических задач это считается заранее. У каждой задачи — время работы
C и период T; приоритеты раздают по частоте: чем чаще задача, тем выше.
Загрузка — сумма C / T по всем задачам. Граница Лю–Лейланда:
если загрузка не больше n·(2^(1/n) − 1), все сроки гарантированы; для
трёх задач это 77,98 %. Граница достаточная, но не необходимая: выше неё
набор может успевать, а может и нет — тогда считают время отклика
каждой задачи: её собственное C плюс всё, что успеют вытеснить старшие,
R = C + Σ ⌈R / Tj⌉ · Cj, пока значение не перестанет меняться.
Три набора — датчик (1 мс каждые 5 мс), регулятор (3 мс каждые 20 мс) и экран с разной длиной перерисовки, период 50 мс:
| Экран | Загрузка | Граница 77,98 % | Отклик экрана | Срок 50 мс |
|---|---|---|---|---|
| 10 мс | 55 % | пройдена | 17 мс | успевает |
| 25 мс | 85 % | не пройдена | 39 мс | успевает |
| 32 мс | 99 % | не пройдена | 52 мс | опаздывает |
Прямая симуляция планировщика с вытеснением — все задачи стартуют одновременно, это худший случай — дала те же времена отклика и пропуск срока в третьем наборе. Датчик во всех трёх отвечает за 1 мс, регулятор — за 4 мс: младшая задача на старших никак не сказывается.
Тот же расчёт для своего набора задач делает вкладка «Задачи» в калькуляторах приложения: загрузка, граница и время отклика каждой задачи.
26.3 Блокировка: что считается ожиданием
Задача отдаёт процессор, только если вызвала функцию ядра, которая её блокирует. Всё остальное ожиданием не является.
| Блокирует | Не блокирует |
|---|---|
vTaskDelay, xTaskDelayUntil |
пустой цикл for |
xQueueReceive с ожиданием |
while (!flag) { } |
xSemaphoreTake с ожиданием |
опрос регистра периферии в цикле |
ulTaskNotifyTake с ожиданием |
цикл с __NOP() внутри |
Разница принципиальная. Первый столбец переводит задачу в состояние ожидания, и ядро вычёркивает её из списка готовых. Второй — оставляет задачу выполняющейся, она просто тратит своё время впустую и не даёт работать никому ниже.
Единственный способ уступить процессор без ожидания события:
taskYIELD(); /* отдать остаток кванта равным по приоритету */
Но и он не помогает против голодания: уступать можно только тем, кто того же приоритета или выше.
Пять состояний
| Состояние | Как попасть | Как выйти |
|---|---|---|
| выполняется | планировщик выбрал | вытеснена или заблокировалась |
| готова | создана или дождалась | планировщик выбрал |
| ожидает | вызвала блокирующую функцию | событие или истекло время |
| приостановлена | vTaskSuspend |
только vTaskResume |
| удалена | vTaskDelete |
никак |
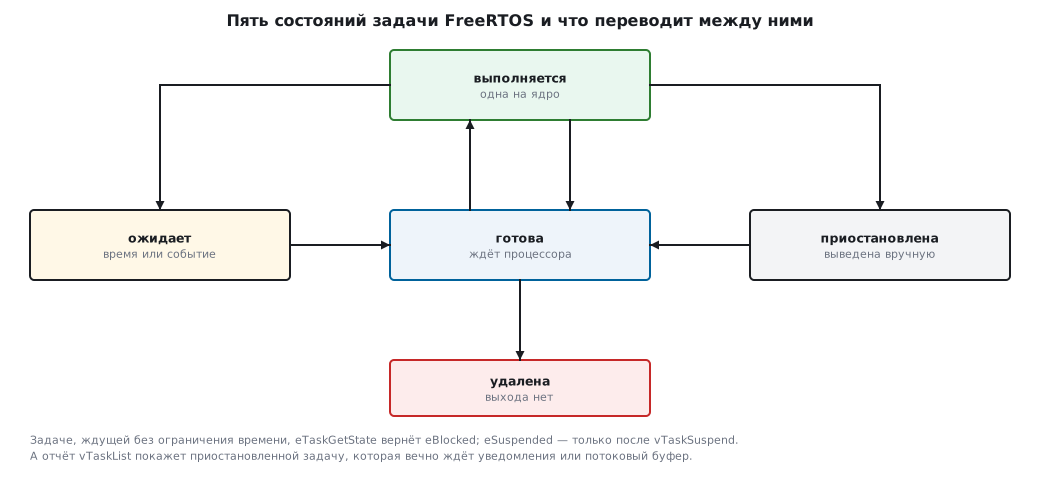
⚠️ Задача, ждущая без ограничения времени, лежит в том же списке ядра, что и приостановленные.
eTaskGetStateэто различает и вернёт для неёeBlocked;eSuspended— только послеvTaskSuspend. А вот отчётvTaskListиuxTaskGetSystemStateпокажут приостановленной задачу, которая вечно ждёт уведомления или потоковый буфер (он ждёт через уведомления), — это сбивает с толку при отладке. Вечное ожидание очереди или семафора отчёт показывает верно.
26.4 🔧 Периодическая задача: две версии
Самый распространённый вид задачи — делать что-то с постоянным периодом. Очевидное решение оказывается неверным.
/* Неверно: период уплывает */
for (;;) {
    do_work();                              /* занимает 3 мс */
    vTaskDelay(pdMS_TO_TICKS(10));
}
vTaskDelay отсчитывает от момента вызова. Значит период получается
не 10 мс, а 13: десять миллисекунд ожидания плюс три работы. И это ещё
оптимистично — стоит задаче быть вытесненной, и период вырастет ещё.
Насколько это важно, видно на числах. За минуту при периоде 10 мс должно пройти 6000 срабатываний. При фактическом периоде 13 мс их будет 4615. Потеряно 1385 срабатываний за одну минуту — почти четверть.
/* Верно: период точный */
TickType_t last = xTaskGetTickCount();

for (;;) {
    do_work();
    xTaskDelayUntil(&last, pdMS_TO_TICKS(10));
}
xTaskDelayUntil считает от прошлого пробуждения, а не от вызова.
Время работы задачи вычитается из ожидания автоматически, и период
держится ровно, сколько бы задача ни считала — лишь бы укладывалась
в период.
vTaskDelay |
xTaskDelayUntil |
|
|---|---|---|
| отсчёт от | момента вызова | прошлого пробуждения |
| период | задержка + работа | ровно заданный |
| накопление ошибки | есть | нет |
| для чего | паузы, повторные попытки | периодические измерения, опрос, управление |
⚠️ Переменную отсчёта нельзя трогать вручную.
xTaskDelayUntilсама обновляет её при каждом вызове. Инициализируется она один раз, до цикла, значениемxTaskGetTickCount(). Попытка присвоить ей что-то внутри цикла ломает весь смысл функции.
Есть и вторая тонкость: если работа заняла больше периода, функция не станет ждать вовсе и вернёт признак того, что задача не заснула. Прибор в таком режиме работает на пределе, и об этом стоит знать — проверка возвращаемого значения даёт бесплатный сигнал о перегрузке.
26.5 Задача простоя
Ядро создаёт её само при запуске планировщика. Приоритет — ноль, работает, когда все остальные ждут.
Три вещи, которые она делает:
Освобождает память задач, удаливших себя. Задача не может вернуть
стек, на котором сама выполняется, поэтому vTaskDelete(NULL) лишь ставит
её в очередь на удаление, а блок управления и стек возвращает в кучу
задача простоя. Чужую задачу vTaskDelete освобождает сразу.
Вызывает ловушку простоя, если та включена. В неё обычно ставят засыпание процессора (раздел 10) — прибор потребляет ток, только когда работает.
Не делает ничего, если ни то, ни другое не требуется.
⚠️ Если задача простоя не получает процессор, память задач, удаливших себя, не возвращается. Прибор, в котором задачи создаются и удаляются, а нижние уровни приоритета вечно заняты, будет медленно терять кучу. Симптом — исчерпание памяти через часы работы при внешне правильном коде.
Ловушка простоя обязана быть быстрой и не имеет права блокироваться. Задача простоя должна оставаться готовой всегда — на ней держится освобождение памяти.
Макрос configIDLE_SHOULD_YIELD управляет тем, уступает ли задача
простоя свой квант задачам того же — то есть нулевого — приоритета.
Значение имеет только если вы создали свои задачи с приоритетом ноль,
чего делать не стоит.
26.6 Режимы планировщика
Два макроса задают три поведения.
configUSE_PREEMPTION |
configUSE_TIME_SLICING |
Что получается |
|---|---|---|
| 1 | 1 | вытеснение с разделением времени — обычный режим |
| 1 | 0 | вытеснение без разделения: равные не чередуются |
| 0 | — | кооперативный: переключение только по taskYIELD или когда задача блокируется |
Обычный режим — первая строка, и менять его без причины не надо.
Кооперативный режим иногда берут ради предсказуемости: переключение происходит только там, где вы его разрешили, и гонок между задачами почти не бывает. Плата — любая задача способна остановить систему, забыв уступить процессор, а реакция на события ограничена длиной самого долгого непрерывного участка. По сути это суперцикл с более удобной записью.
26.7 Стек: сколько давать и как проверить
Вопрос, на который нет теоретического ответа. Стек задачи расходуют: локальные переменные, вложенные вызовы, а на Cortex‑M — ещё и кадр прерывания, который процессор укладывает в стек текущей задачи.
Практика такая: дать с запасом, потом измерить и урезать.
UBaseType_t words = uxTaskGetStackHighWaterMark(handle);
uint32_t    bytes = words * sizeof(StackType_t);
Функция возвращает наименьший остаток за всё время работы задачи, и возвращает его в словах.
⚠️ Значение в словах, а не в байтах. Остаток 20 означает 80 байт свободного стека, а не 20. Ошибка в четыре раза здесь особенно неприятна: кажется, что запас критический, хотя он приемлемый, — или наоборот.
Здоровым считается остаток не меньше четверти выделенного. Ноль означает, что стек был исчерпан, — и, скорее всего, уже с последствиями.
Ловушка переполнения ловит беду в момент, а не постфактум:
void vApplicationStackOverflowHook(TaskHandle_t task, char *name)
{
    (void)task;
    for (;;) { }        /* имя виновной задачи лежит в name */
}
Включается макросом configCHECK_FOR_STACK_OVERFLOW. Значение 1 сверяет
указатель стека с границей при переключении, значение 2 дополнительно
проверяет заполнение хвоста стека условным образцом. Второй способ
надёжнее и чуть медленнее; на этапе разработки берут его.
⚠️ Ни одна проверка не ловит переполнение мгновенно. Обе срабатывают при переключении задач, то есть уже после того, как чужая память испорчена. Ловушка называет виновника, но не отменяет порчу — поэтому запас важнее диагностики. Мгновенно ловит только железо: у Cortex-M33 (L5, U5, H5) порт FreeRTOS пишет границу стека задачи в регистр
PSPLIM, и выход за неё сразу даёт исключение; на M3/M4 то же делают защитной областью MPU под стеком.
Отдельная мина — printf и всё, что связано с плавающей запятой.
Одна безобидная строка форматированного вывода способна съесть
несколько сотен байт стека разом; задача с минимальным стеком
на ней и падает.
26.8 Статическое или динамическое
Возвращаясь к разделу 25 применительно к задачам:
/* динамически: память из кучи, может не получиться */
if (xTaskCreate(worker, "worker", 256, NULL, 2, &h) != pdPASS) {
    /* не хватило кучи */
}

/* статически: память ваша, не получиться не может */
static StaticTask_t tcb;
static StackType_t  stack[256];

h = xTaskCreateStatic(worker, "worker", 256, NULL, 2, stack, &tcb);
Для задач разница особенно ощутима: их стеки — самая крупная статья расхода памяти в приборе. При статическом размещении суммарный расход виден в карте памяти сразу после сборки, и вопрос «влезем ли» закрывается до первой прошивки.
26.9 🔧 Опыт: кому достаётся процессор
Всё сказанное о приоритетах легко проверить: дать задачам нагрузку и спросить
у ядра, сколько процессора досталось каждой. Для этого есть учёт времени
задач — configGENERATE_RUN_TIME_STATS: ядро само копит в блоке управления
каждой задачи, сколько та проработала.
/* работа без единого ожидания */
void busy_task(void *arg)
{
    volatile uint32_t *n = arg;
    for (;;)
        (*n)++;
}

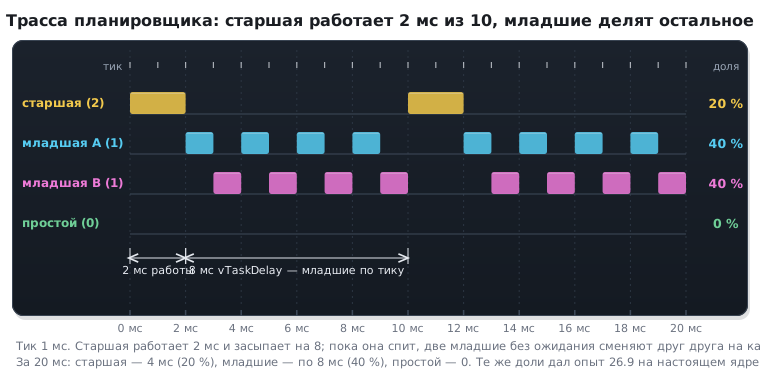
/* 2 мс работы, 8 мс ожидания — пятая часть процессора */
void duty_task(void *arg)
{
    volatile uint32_t *n = arg;
    for (;;) {
        TickType_t t0 = xTaskGetTickCount();
        while (xTaskGetTickCount() - t0 < pdMS_TO_TICKS(2))
            (*n)++;
        vTaskDelay(pdMS_TO_TICKS(8));
    }
}

/* сколько процессора задача получила с момента создания — по счётчику ядра */
configRUN_TIME_COUNTER_TYPE task_runtime(TaskHandle_t h)
{
    TaskStatus_t st;
    vTaskGetInfo(h, &st, pdFALSE, eRunning);
    return st.ulRunTimeCounter;
}
Счётчику нужен источник времени — макрос portGET_RUN_TIME_COUNTER_VALUE().
На камне это DWT->CYCCNT или свободный таймер (раздел 73), и тикать он должен
намного чаще системного тика: время раздаётся при каждом переключении задач,
и счётчик, который тикает реже переключений, раздаёт его случайно. Так и вышло
с собственным счётчиком порта для компьютера — он тикает раз в 10 мс, и доли
равных задач скакали от прогона к прогону. Опыт поэтому идёт со счётчиком
в микросекундах.
Счётчик ограничен и сверху. 32-битный CYCCNT при 72 МГц переполняется
каждые 59,7 с, а ядро копит время задач в 32 битах и переполнения не
замечает — через минуту работы доли становятся мусором. Поэтому берут
таймер на 10–100 кГц (при 100 кГц переполнение — через 11,9 ч) или копят
время в 64 битах: configRUN_TIME_COUNTER_TYPE = uint64_t, а старшую
половину к CYCCNT досчитывают в программе.
Опыт поставлен на настоящем ядре 10.5.1 с портом POSIX: задачи — потоки компьютера, тик — 1 мс. Распорядитель с высшим приоритетом создаёт задачи сценария, спит секунду, останавливает их и спрашивает у ядра счётчики.
| Сценарий | Приоритеты задач | Доли процессора |
|---|---|---|
| три равные без ожидания | 1, 1, 1 | 33, 33, 33 % |
| старшая без ожидания | 2, 1, 1 | 100, 0, 0 % |
| старшая работает 2 мс из 10 | 2, 1, 1 | 20, 40, 40 % |
| приоритеты 10 и 99 при пяти уровнях | 4, 4 после урезания | 50, 50 % |
Задача простоя во всех четырёх — 0 %: работы всегда хватало.
Выводов четыре. Равные делят время поровну — это квантование по тику.
Старшая без ожидания забирает всё: младшим и простою не достаётся ни одного
тика — голодание (26.2) в чистом виде. Стоит старшей ждать 8 мс из 10, как она
берёт свою пятую часть, а остальное младшие делят поровну. А приоритеты 10 и 99
оказались одним и тем же четвёртым: проверка configASSERT сработала на обоих
(здесь она лишь записывала срабатывание и отпускала), после чего ядро урезало
приоритеты, и задачи поделили время пополам.
Третий сценарий по тикам — в виде трассы, какую рисуют программы-трассировщики:
26.10 Грабли
Прибор зависает, но не совсем. Задача высокого приоритета не блокируется. Искать бесконечный цикл без ожидания.
Две задачи с разными приоритетами ведут себя как равные. Приоритеты
не меньше configMAX_PRIORITIES урезаны до максимума — так бывает, когда
configASSERT выключен.
Камень встаёт при создании задачи. Сработал configASSERT на приоритете
не меньше configMAX_PRIORITIES.
Период задачи не тот, что задан. Использован vTaskDelay вместо
xTaskDelayUntil; период равен задержке плюс времени работы.
Программа останавливается сразу после старта задачи. Задача вышла
из своей функции. Нужен бесконечный цикл или vTaskDelete(NULL).
Задача перестала выполняться после vTaskSuspend. Из приостановки
выводит только vTaskResume, никакое событие её не разбудит.
vTaskList показывает приостановленной рабочую задачу. Она вечно ждёт
уведомления или потоковый буфер, а отчёт узнаёт только ожидание очередей
и семафоров; eTaskGetState для неё вернёт eBlocked.
Память тает при создании и удалении задач. Задачи удаляют себя, а задача простоя не получает процессора и не может освободить их память.
Стек кончается на printf. Форматированный вывод стоит сотни байт
стека. Либо запас, либо отказ от него в задачах.
Запас стека кажется вчетверо меньше реального. Функция возвращает слова, а не байты.
Доли задач в статистике времени скачут. Счётчик тикает реже, чем переключаются задачи; нужен источник намного быстрее системного тика (26.9).
26.11 Итоги
- Функция задачи возвращает
void, принимаетvoid *и содержит бесконечный цикл; выходить из неё нельзя. - Задачи разного приоритета не делят время: старшая работает, пока не заблокируется. Отсюда голодание младших.
- Задачи одного приоритета делят время по тику, по кругу.
- Приоритет не меньше
configMAX_PRIORITIES: сconfigASSERT— остановка при создании задачи, без него — тихое урезание доconfigMAX_PRIORITIES − 1. - Блокирует только вызов функции ядра с ожиданием; пустой цикл и опрос регистра — не блокировка.
- Ожидание без ограничения времени
eTaskGetStateпоказывает какeBlocked;vTaskList— как приостановку, если задача ждёт уведомления. vTaskDelayдаёт период, равный задержке плюс времени работы; для точного периода нуженxTaskDelayUntil.- Задача простоя освобождает память задач, удаливших себя (чужую
vTaskDeleteвозвращает сразу), — она обязана получать процессор. uxTaskGetStackHighWaterMarkвозвращает наименьший остаток за всё время и возвращает его в словах.- Проверки переполнения стека срабатывают при переключении, то есть уже после порчи памяти; запас важнее диагностики.
- Учёт времени задач показывает всё это числами: у старшей без ожидания — весь процессор, у младших и простоя — ноль; счётчику нужен источник намного быстрее тика (26.9).
Дальше: раздел 27 «Очереди» — как задачи передают данные друг другу и почему очередь копирует, а не ссылается.