 Embedded HandbookПриложения
25. Управление памятью
Раздел, который в учебниках обычно пролистывают, а на приборе с двадцатью килобайтами он определяет всё. Речь о том, откуда ядро берёт память под задачи, очереди и семафоры, и почему выбор одной строки в проекте меняет поведение прибора через месяц непрерывной работы.
Как это называется в документации
Оригинал Перевод heap куча, область динамического выделения heap scheme / implementation схема работы с кучей fragmentation фрагментация, дробление свободного места coalescing слияние соседних свободных блоков block link заголовок блока thread safe безопасный при одновременном обращении high water mark худшее значение за всё время работы linker heap куча, отведённая компоновщиком region область памяти
25.1 Зачем ядру своя куча
Первый вопрос: почему нельзя обойтись обычным malloc из библиотеки C.
Три причины, каждой достаточно.
malloc не знает о задачах. Две задачи, вызвавшие его одновременно,
испортят внутренние структуры библиотеки. Некоторые реализации защищены
блокировками, но эти блокировки — операционной системы компьютера,
а не вашего ядра.
malloc живёт в куче компоновщика. Её размер задаётся в настройках
компоновки, а не в конфигурации ядра, и ядро ничего не знает о её
заполнении: худшего свободного объёма (25.4) для неё не спросить.
Выравнивание тут ни при чём: malloc обязан выдавать блоки, годные для
любого типа, и на ARM это те же восемь байт, что нужны ядру.
malloc непредсказуем по времени. Сколько займёт вызов, зависит
от истории выделений. Для системы реального времени это неприемлемо.
Поэтому у ядра своя пара функций — pvPortMalloc и vPortFree, —
и ровно один файл, который их реализует. Файлов на выбор пять.
25.2 Пять схем
| Схема | Освобождение | Слияние | Код | Когда брать |
|---|---|---|---|---|
heap_1 |
нет | — | 160 байт | всё создаётся один раз при старте |
heap_2 |
есть | нет | 430 байт | устаревшая, брать не надо |
heap_3 |
есть | зависит | 56 байт | обёртка над malloc библиотеки |
heap_4 |
есть | есть | 726 байт | выбор по умолчанию |
heap_5 |
есть | есть | 884 байта | память разбросана по нескольким областям |
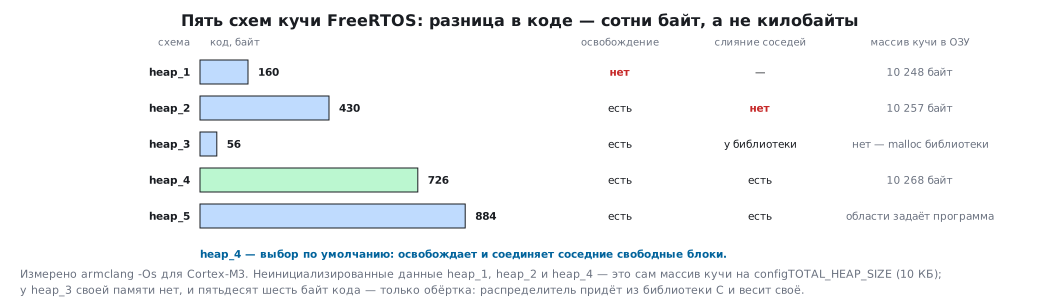
Размеры измерены сборкой под Cortex‑M3 с оптимизацией по размеру. Видно,
что разница между схемами — сотни байт, а не килобайты: выбирать heap_1
ради экономии прошивки бессмысленно, выбирают его ради предсказуемости.
Скромность heap_3 обманчива — пятьдесят шесть байт это только обёртка,
сам распределитель придёт из библиотеки C и весит своё.
heap_1 — выделение без возврата
Самая простая схема: указатель, который двигается вперёд. Освобождения нет вовсе.
void vPortFree(void *pv)
{
    (void)pv;
    configASSERT(pv == NULL);     /* вызывать эту функцию нельзя */
}
Функция существует ради совместимости, но вызов её с настоящим указателем останавливает программу на проверке. Это не недосмотр, а сознательное решение: лучше поймать ошибку сразу, чем делать вид, что память вернулась.
Схема выглядит примитивной, но у неё есть свойство, которого нет
ни у одной другой: она не может фрагментироваться и работает
за постоянное время. Для прибора, где все задачи и очереди создаются
при запуске и живут до выключения — а это огромное большинство приборов, —
heap_1 подходит идеально.
heap_2 — освобождение без слияния
Освобождать умеет, соединять соседние свободные блоки — нет.
Последствие: программа, которая берёт и отдаёт блоки разного размера, через некоторое время получает кучу, состоящую из множества мелких свободных кусков. Суммарно свободно много, а выделить сотню байт нельзя — непрерывного куска такого размера не осталось.
Схема считается устаревшей. Она сохранена для старых проектов;
в новых на её месте берут heap_4.
heap_3 — обёртка над библиотечным malloc
Полсотни байт своего кода, вся работа — у библиотеки C:
void *pvPortMalloc(size_t xWantedSize)
{
    void *pvReturn;

    vTaskSuspendAll();          /* остановить переключение задач */
    pvReturn = malloc(xWantedSize);
    xTaskResumeAll();

    return pvReturn;
}
Приостановка планировщика решает проблему одновременного обращения — и создаёт две новые.
Первая: configTOTAL_HEAP_SIZE здесь не работает вовсе. Размер кучи
задаётся не в конфигурации ядра, а в настройках компоновщика. Человек,
поставивший в конфигурации 20 килобайт и получивший отказ на пятом
выделении, ищет ошибку не там.
Вторая: время выделения непредсказуемо, потому что зависит от реализации библиотеки, а не от ядра.
Схему берут в одном случае: когда в проекте уже есть код, пользующийся
malloc напрямую, и разводить две кучи не хочется.
Побочное отличие, заметное в карте памяти: heap_1, heap_2 и heap_4
объявляют кучу собственным массивом и потому сразу занимают
configTOTAL_HEAP_SIZE байт неинициализированных данных. У heap_3
этого массива нет вовсе, а у heap_5 — только описатель областей
на два десятка байт: память ему отдаёт программа.
heap_4 — слияние соседей
То же, что heap_2, плюс главное: освобождённый блок сливается
с соседними свободными. Куча не рассыпается на осколки.
Это выбор по умолчанию и правильный ответ, когда нет причин выбрать другое.
Дополнительно heap_4 умеет то, чего нет в первых трёх, — рассказывать
о себе. Об этом ниже.
heap_5 — несколько областей
Тот же heap_4, но куча может состоять из нескольких несмежных кусков
памяти. Нужна, когда к микроконтроллеру подключена внешняя память
(раздел 41) или когда внутренняя разбита на области с разными свойствами.
Требует явной настройки до первого выделения:
static uint8_t heap_int[8 * 1024];          /* внутренняя память — массивом */

static const HeapRegion_t regions[] = {
    { heap_int, sizeof heap_int },          /* место ему выберет компоновщик */
    { (uint8_t *)0x68000000, 512 * 1024 },  /* внешняя SRAM на FSMC */
    { NULL, 0 }                             /* признак конца списка */
};

vPortDefineHeapRegions(regions);            /* до всего остального */
Всю внутреннюю память с её начала отдавать нельзя: там уже лежат .data,
.bss и стек, и первые же выделения затрут глобальные переменные.
Внутреннюю область отдают массивом или границами из скрипта компоновщика.
⚠️ Области обязаны идти по возрастанию адресов. Порядок в массиве не произвольный: алгоритм слияния опирается на то, что соседние по списку области соседние и в памяти. Перепутанный порядок даёт порчу кучи, которая проявится далеко от места ошибки.
25.3 Сколько на самом деле стоит один запрос
Место, где интуиция подводит.
Каждый блок в куче несёт заголовок из восьми байт: указатель на следующий свободный блок и размер. Логично предположить, что запрос на 512 байт займёт 520. В ядре 10.5.1, на котором построен справочник, — 528.
Причина в том, как записана формула размера. К запросу добавляется заголовок, а затем результат добивается до границы восьми байт — но добивается безусловно, полным шагом. Уже выровненный запрос получает целых восемь лишних байт сверх заголовка:
| Запрошено | Занято в куче | Накладные |
|---|---|---|
| 1 байт | 16 | 15 |
| 7 байт | 16 | 9 |
| 8 байт | 24 | 16 |
| 9 байт | 24 | 15 |
| 16 байт | 32 | 16 |
| 92 байта | 104 | 12 |
| 512 байт | 528 | 16 |
Накладные расходы — от 9 до 16 байт на каждый блок, и максимальны они как раз на «круглых» размерах, которые программист выбирает чаще всего.
В ядре 11 формулу исправили: добивка добавляется, только если размер
вместе с заголовком не кратен восьми. Там 512 байт занимают 520, 8 байт —
16, 92 байта — те же 104, а накладные — от 8 до 15 байт. Таблица выше
и цена задачи ниже — для 10.5.1; для другой версии ядра их пересчитывают
по её heap_4.c.
Отсюда цена задачи. Динамическое создание делает два отдельных запроса — под блок управления и под стек:
| Байт | |
|---|---|
| блок управления, 92 байта | 104 |
| стек, 512 байт | 528 |
| итого из кучи | 632 |
| та же задача статически | 604 |
В окне памяти отладчика куча после одного xTaskCreate выглядит так:
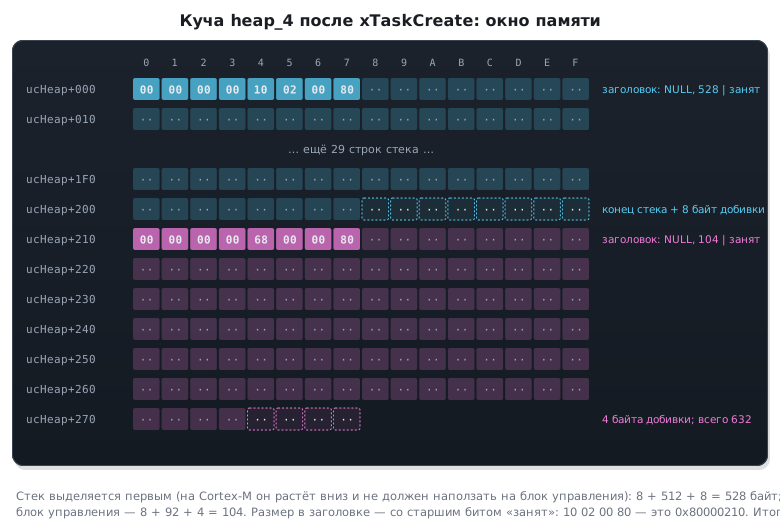
Двадцать восемь байт разницы кажутся пустяком, пока задач не стало десять. И главное — в кучу 10 КБ помещается всего шестнадцать таких задач, после чего она кончается.
⚠️ Куча занимает место всегда, сколько бы из неё ни взяли. Это обычный массив в области неинициализированных данных. Значение
configTOTAL_HEAP_SIZE= 10 КБ на F103C8 означает, что половина оперативной памяти занята с первого такта, независимо от того, создали вы одну задачу или пятнадцать. Размер кучи подбирают под прибор, а не оставляют как есть.
25.4 Наблюдение за кучей
heap_4 и heap_5 умеют отвечать на вопросы о своём состоянии.
size_t now   = xPortGetFreeHeapSize();
size_t worst = xPortGetMinimumEverFreeHeapSize();
Первая функция говорит, сколько свободно сейчас. Вторая — сколько оставалось свободным в худший момент за всё время работы.
Смотреть надо на вторую. Первая показывает состояние в момент опроса и легко вводит в заблуждение: свободно шесть килобайт, всё прекрасно, — а полчаса назад оставалось двести байт, и следующий всплеск нагрузки прибор не переживёт.
Разумный приём: выводить худшее значение при отладке и заводить порог,
ниже которого прибор сообщает о беде, — по светодиоду, в журнал или
через SWO (раздел 21).
⚠️
xPortGetMinimumEverFreeHeapSizeесть не во всех схемах. Вheap_1,heap_2иheap_3её нет, и ошибка компоновки на этой функции означает ровно одно: подключён не тот файл кучи.
Есть и подробный отчёт — vPortGetHeapStats заполняет структуру, где
помимо свободного объёма лежат размер наибольшего свободного блока
и число выполненных выделений. Наибольший свободный блок — прямая мера
фрагментации: если свободно шесть килобайт, а наибольший кусок
восемьсот байт, куча рассыпана.
25.5 Ловушка на исчерпание
Одна функция, которую пишут в каждом проекте:
void vApplicationMallocFailedHook(void)
{
    for (;;) { }        /* точка останова: сюда попадают, когда кончилась куча */
}
Ядро вызывает её, когда выделение не удалось, — при условии, что
в конфигурации стоит configUSE_MALLOC_FAILED_HOOK.
Без ловушки исчерпание кучи выглядит так: xTaskCreate вернула отказ,
результат никто не проверил, задача не создалась, и часть прибора просто
не работает. Разбираться в этом на живом устройстве — занятие на вечер.
С ловушкой отказ виден мгновенно.
25.6 Что выбрать
Правило простое, и оно почти всегда даёт верный ответ.
Если всё создаётся при старте и живёт до выключения — статическое
размещение, кучи нет вовсе. configSUPPORT_DYNAMIC_ALLOCATION в ноль,
файл кучи не подключается, configTOTAL_HEAP_SIZE не нужен. Расход памяти
виден в карте памяти сразу после сборки, отказ выделения невозможен
в принципе, целый класс ошибок исчезает. Для подавляющего большинства
приборов это правильный выбор.
Если создаётся при старте, но статически возиться не хочется —
heap_1. Фрагментации не бывает, время постоянно, кода 160 байт.
Если объекты появляются и исчезают по ходу работы — heap_4.
Если память разбросана по областям — heap_5.
heap_2 не брать никогда, heap_3 — только при готовом коде
на библиотечном malloc.
⚠️ Динамическое создание после запуска планировщика — решение, которое стоит отдельно обосновать. Оно означает, что прибор может оказаться без памяти в произвольный момент — например, на десятый день работы при редком сочетании событий. Если такой сценарий недопустим, вся память должна быть выделена до входа в рабочий режим.
25.7 Грабли
Ошибка компоновки на pvPortMalloc. Не подключён ни один файл кучи.
Ошибка компоновки на xPortGetMinimumEverFreeHeapSize. Подключены
heap_1, heap_2 или heap_3, где этой функции нет.
Программа останавливается в vPortFree. Используется heap_1,
где освобождать нельзя.
configTOTAL_HEAP_SIZE ни на что не влияет. Используется heap_3,
где размер кучи задаёт компоновщик.
Задачи создаются, а потом перестают. Кончилась куча. Смотреть
xPortGetMinimumEverFreeHeapSize и проверять результат xTaskCreate.
Свободно много, а выделить не получается. Фрагментация: heap_2
либо heap_4 с интенсивным созданием и удалением объектов разного
размера. Смотреть наибольший свободный блок через vPortGetHeapStats.
Памяти не хватает сразу после запуска. Куча в конфигурации справочника — 10 КБ, а на камне их всего 20. Уменьшить или перейти на статическое размещение.
Порча памяти при использовании heap_5. Области в массиве
перечислены не по возрастанию адресов.
Прибор падает через неделю. Классический признак утечки: где-то берётся память и не возвращается. Наблюдать за худшим значением свободного объёма — оно будет медленно ползти вниз.
25.8 Итоги
- Ядро не пользуется
mallocиз библиотеки C: та не знает о задачах, живёт в куче компоновщика, о которой ядро ничего не знает, и непредсказуема по времени; выравнивание у неё то же — восемь байт. - Схем пять, подключается ровно одна:
heap_1— без освобождения,heap_2— устаревшая,heap_3— обёртка надmalloc,heap_4— выбор по умолчанию,heap_5— для нескольких областей памяти. - Заголовок блока — восемь байт, но накладные расходы в ядре 10.5.1 составляют от 9 до 16 байт и максимальны на размерах, кратных восьми; в ядре 11 — от 8 до 15.
- Задача, созданная динамически, стоит 632 байта против 604 статически; в кучу 10 КБ помещается шестнадцать таких задач.
- Куча занимает место всегда: 10 КБ из конфигурации справочника — это половина памяти F103C8, занятая с первого такта.
- Смотреть надо на худшее значение свободного объёма, а не на текущее.
- Наибольший свободный блок — прямая мера фрагментации.
- Ловушка
vApplicationMallocFailedHookпревращает немой отказ в мгновенно заметный. - Если всё создаётся при старте — статическое размещение и никакой кучи: расход виден после сборки, отказ невозможен.
Дальше: раздел 26 «Задачи» — приоритеты, состояния, квант времени и то, что происходит, когда две задачи одного приоритета хотят процессор одновременно.