 Embedded HandbookПриложения
23. Зачем нужна операционная система
Двадцать два раздела программа была устроена одинаково: настройка, потом бесконечный цикл. Пока дело ограничивалось миганием светодиода, этого хватало с избытком. Дальше начинается арифметика, которая ломает такую схему, и часть IV — про инструмент, который приходит ей на смену.
Разговор стоит начать с честного признания: операционная система нужна далеко не всегда. Разделу 23.6 отведено ровно это — когда её брать не надо.
Как это называется в документации
Оригинал Перевод real-time operating system (RTOS) операционная система реального времени, ОСРВ superloop / bare metal суперцикл, программа без операционной системы kernel ядро task / thread задача, поток scheduler планировщик preemption вытеснение context switch переключение контекста tick системный тик, квант времени blocked state состояние ожидания idle task задача простоя determinism предсказуемость времени отклика latency задержка отклика port адаптация ядра под конкретное ядро процессора cooperative scheduler кооперативный планировщик: задача сама возвращает управление deadline срок запуска jitter дрожание момента запуска wraparound переполнение счётчика с переходом через ноль
23.1 Суперцикл и его пределы
Начнём с самой наивной формы — задержки занятым ожиданием:
for (;;) {
    led_on();
    delay_ms(500);
    led_off();
    delay_ms(500);
}
Мигает. Теперь добавьте опрос датчика раз в 100 мс — и выяснится, что
вставить его некуда: процессор полсекунды крутится внутри delay_ms
и в это время не способен ни на что.
Первый предел: блокирующая задержка съедает всё время. Реакция на любое событие ограничена длиной самой долгой задержки в цикле.
Лечится это отказом от delay_ms в пользу счётчика времени. Заводим тик
в SysTick (раздел 7.4) и превращаем цикл в конечный автомат:
volatile uint32_t g_ms;                 /* инкремент в обработчике SysTick */

for (;;) {
    uint32_t now = g_ms;

    if ((uint32_t)(now - led_at) >= 500u) {
        led_at = now;
        led_toggle();
    }
    if ((uint32_t)(now - sensor_at) >= 100u) {
        sensor_at = now;
        sensor_poll();
    }
}
Это уже рабочая схема, на которой держится огромное количество приборов.
Обратите внимание на вычитание внутри приведения к uint32_t — так
сравнение остаётся верным при переполнении счётчика (мина из раздела 3).
Но и у неё есть свои пределы, и проявляются они не сразу.
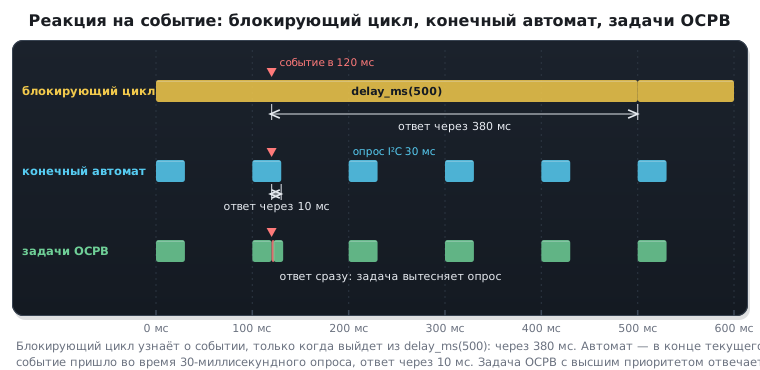
Второй предел: длинная операция задерживает всё остальное. Цикл проходится целиком, шаг за шагом. Если опрос датчика по I²C занял 30 мс, то на эти 30 мс встали все остальные ветки. Один медленный участок портит время отклика всей программе.
Третий предел: нет приоритетов. В суперцикле все дела равны. Нельзя сказать «управление двигателем важнее вывода на экран» — очередь одна и она общая. Единственный доступный способ расставить важность — прерывания, но их обработчики должны быть короткими, и логику в них не унесёшь.
Четвёртый предел — главный: сложность растёт быстрее числа задач. Каждое новое дело — это своя переменная времени, свой набор состояний и свои условия перехода. Три дела ещё держатся в голове. Восемь — уже нет: любая правка в одной ветке меняет тайминг остальных, и появляются ошибки, которые воспроизводятся раз в сутки.
| Блокирующий цикл | Конечный автомат | Задачи ОСРВ | |
|---|---|---|---|
| реакция на событие | до длины задержки | до длины прохода цикла | по приоритету |
| длинная операция | останавливает всё | останавливает всё | вытесняется |
| приоритеты | нет | нет | есть |
| читается как | последовательность | таблица состояний | последовательность |
| рост сложности | линейный | квадратичный | линейный |
Последняя строка объясняет, ради чего всё затевается. Автомат заставляет разорвать каждое дело на куски между проходами цикла — и связность кода теряется. Задача же пишется линейно, как будто она в приборе одна.
Как три подхода отвечают на одно и то же событие — на трассе:
23.2 Что такое операционная система реального времени
Три идеи, и все три просты по отдельности.
Задача — это функция с собственным стеком. Обычная функция на бесконечном цикле, но у неё есть личная область памяти под локальные переменные и адреса возврата. Именно поэтому её можно остановить на полуслове и вернуться позже: всё её состояние живёт в её стеке.
Планировщик решает, какая задача выполняется сейчас. У каждой задачи есть приоритет. Правило одно и оно жёсткое: выполняется готовая задача с наибольшим приоритетом. Не «по очереди», не «по справедливости» — по приоритету.
Ожидание отдаёт процессор. Вместо delay_ms, который крутит пустой
цикл, задача вызывает vTaskDelay и переходит в состояние ожидания.
Пока она ждёт, планировщик отдаёт процессор другим. Это ключевой момент,
переворачивающий всю картину: ожидание перестаёт быть тратой времени.
Тот же прибор на задачах:
static void led_task(void *arg)
{
    for (;;) {
        led_toggle();
        vTaskDelay(pdMS_TO_TICKS(500));   /* процессор свободен */
    }
}

static void sensor_task(void *arg)
{
    for (;;) {
        sensor_poll();
        vTaskDelay(pdMS_TO_TICKS(100));
    }
}

int main(void)
{
    xTaskCreate(led_task,    "led",    128, NULL, 1, NULL);
    xTaskCreate(sensor_task, "sensor", 128, NULL, 2, NULL);
    vTaskStartScheduler();                /* назад не возвращается */
    for (;;) { }
}
Каждая задача снова читается как простая последовательность действий. Ни счётчиков времени, ни состояний, ни оглядки на соседей. Добавить третье дело — значит дописать третью функцию, не трогая первые две.
⚠️
vTaskStartSchedulerне возвращает управление. Планировщик забирает процессор и раздаёт его задачам; строка после вызова не выполнится никогда — если только не кончилась память под задачу простоя. Пустой цикл после него ставят именно на этот случай.
Что здесь «реального времени»
Формулировка сбивает с толку чаще любой другой в этой области.
Реальное время — это не про скорость, а про предсказуемость. Система реального времени гарантирует, что событие будет обработано не позже известного срока. Насколько быстро — вопрос отдельный.
Разница видна на примере. Программа, которая обычно отвечает за 10 мкс, но раз в сутки задумывается на 300 мс, — не система реального времени. Программа, которая всегда отвечает за 5 мс и никогда за 6, — система реального времени, хотя и в шестьсот раз медленнее.
Отсюда практическое следствие: у ядра всё нормировано. Время переключения контекста известно, время передачи в очередь известно, и они не зависят ни от числа задач, ни от того, что происходило раньше. Именно за эту нормированность и платят.
Чем ОСРВ не является
Слово «операционная система» тянет за собой ассоциации, которые здесь не работают ни одна:
| Ожидание | Как на самом деле |
|---|---|
| «загружается при включении» | ядро — это просто набор .c-файлов, скомпонованных в вашу прошивку |
| «разграничивает память между задачами» | по умолчанию нет: любая задача видит всю память и способна испортить чужой стек |
| «даёт драйверы периферии» | нет: GPIO, UART, таймеры вы настраиваете ровно так же, как в частях II и III |
| «даёт файловую систему и сеть» | отдельные библиотеки, к ядру не относятся |
| «изолирует сбои» | ошибка в одной задаче кладёт прибор целиком |
Ядро даёт ровно три вещи: планировщик, средства ожидания и средства обмена между задачами. Всё остальное — по-прежнему на вас.
23.3 Как это работает внутри
Понимание механики избавляет от половины будущих вопросов.
Системный тик. Таймер (обычно SysTick) прерывает процессор
с постоянной частотой — в типовой настройке 1000 раз в секунду. В каждом
прерывании ядро проверяет, не истекло ли у кого-нибудь время ожидания,
и не пора ли передать процессор более приоритетной задаче.
Отсюда сразу два вывода. Первый: разрешение всех задержек равно одному
тику. При частоте 1 кГц попросить «подождать 200 мкс» через vTaskDelay
нельзя, минимум — миллисекунда. Второй: тик — это накладные расходы,
которые идут постоянно, даже когда прибор ничем не занят.
Переключение контекста. Когда решение принято, ядро сохраняет регистры
текущей задачи в её стек и восстанавливает регистры следующей. На Cortex‑M
это делает обработчик исключения PendSV, и весь он умещается
в девятнадцать инструкций:
PendSV_Handler PROC
    MRS   r0, PSP              ; указатель стека уходящей задачи
    ISB
    LDR   r3, pxCurrentTCBConst
    LDR   r2, [r3, #0]         ; её блок управления
    STMDB r0!, {r4-r11}        ; дописать в стек то, что не сохранил процессор
    STR   r0, [r2, #0]         ; запомнить вершину стека в блоке управления
    PUSH  {r3, lr}
    MOV   r0, #0x50            ; поднять порог маскирования прерываний
    MSR   BASEPRI, r0
    BL    vTaskSwitchContext   ; выбрать следующую задачу
    MOV   r0, #0
    MSR   BASEPRI, r0          ; вернуть порог обратно
    POP   {r3, lr}
    LDR   r1, [r3, #0]         ; блок управления пришедшей задачи
    LDR   r0, [r1, #0]         ; её вершина стека
    LDM   r0!, {r4-r11}        ; восстановить регистры
    MSR   PSP, r0
    ISB
    BX    lr                   ; выход из исключения довосстановит остальное
    ENDP
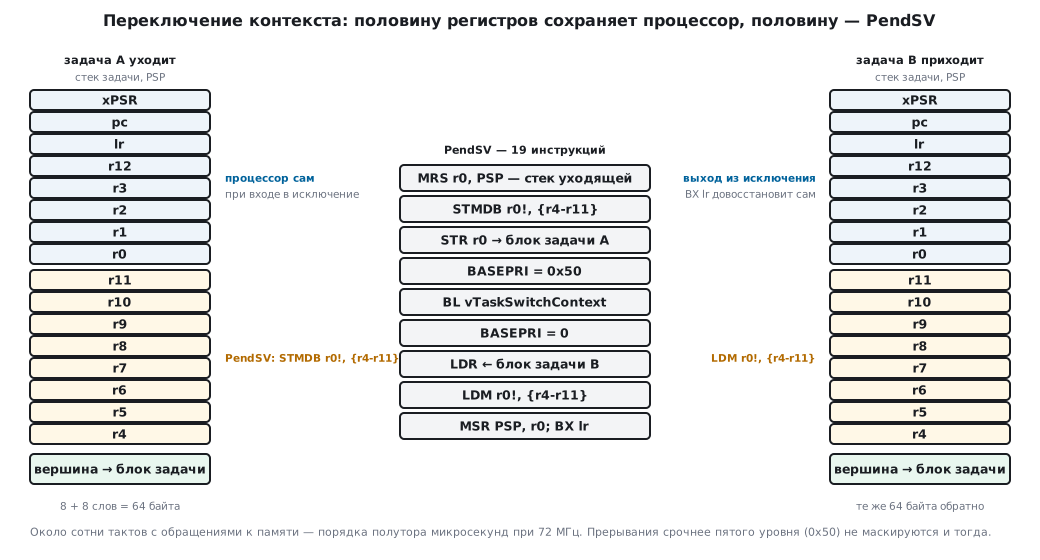
Тонкость, объясняющая краткость: сохраняются только r4–r11. Регистры
r0–r3, r12, lr, pc и xPSR процессор укладывает в стек сам при
входе в исключение и достаёт сам при выходе (раздел 7). Ядру остаётся
ровно та половина, о которой процессор не позаботился.
Заодно видна деталь, к которой мы вернёмся в разделе 28. Значение 0x50,
которое ядро кладёт в BASEPRI на время выбора следующей задачи, — это
не магия, а настроечный параметр: пятый уровень приоритета, сдвинутый
в старшие четыре бита, значащие у STM32. Прерывания с номерами приоритета
0…4 (у Cortex-M меньший номер — более срочное прерывание) этой маской не
затрагиваются и работают даже во время переключения контекста — но и
обращаться к ядру им запрещено.
Девятнадцать инструкций — лишь ассемблерная обёртка: следующую задачу
выбирает функция vTaskSwitchContext на Си, а восемь слов кадра процессор
кладёт и достаёт сам. Всё вместе — порядка сотни-полутора сотен тактов:
около полутора микросекунд при 72 МГц, а с проверкой стека и учётом
времени — больше. Немного, но если
переключаться тысячи раз в секунду, расход становится заметен.
Два указателя стека. Cortex‑M имеет отдельные указатели для основного
режима и для потоков. Ядро пользуется этим напрямую: задачи работают
на PSP, каждая на своём стеке, а обработчики прерываний — на общем MSP.
Аппаратура была спроектирована с расчётом именно на такую схему.
23.4 Цена
Всё, что ниже, измерено сборкой одного и того же прибора — мигание плюс опрос датчика — двумя способами, компилятором с оптимизацией по размеру.
| Суперцикл | На задачах | |
|---|---|---|
| код | 384 байта | 6836 байт |
| постоянная память | 100 байт | ≈ 2,4 КБ + куча |
Флеш-память: около 6,4 КБ. Для F103C8 с его 64 КБ это десятая часть, для F407 с миллионом — незаметно. Число зависит от того, что включено: программные таймеры, группы событий и потоковые буферы добавляют к нему ещё по одному-два килобайта каждый.
Оперативная память — вот где считать внимательно. Она уходит тремя частями:
| Что | Сколько |
|---|---|
| блок управления задачей | 92 байта |
| стек задачи | сколько выделили, минимум обычно 512 байт |
| служебные структуры ядра | ≈ 300 байт плюс задача простоя |
Задача с минимальным стеком стоит 604 байта. У F103C8 всего 20 КБ: десяток задач с запасом по стеку — и памяти не осталось ни на что другое. Заголовок очереди добавляет 80 байт сверх самих данных, программный таймер — 44 байта.
⚠️ Куча легко съедает половину памяти BluePill. Размер кучи задаёт
configTOTAL_HEAP_SIZE, своего умолчания у ядра нет. В заготовках конфигурации из пакета CMSIS-FreeRTOS для Keil — 4 или 8 КБ, в примерах справочника — 10 КБ, а у F103C8 памяти 20 КБ. Задачи, очереди и семафоры при обычном способе создания берутся именно оттуда, поэтому размер кучи подбирают под прибор, а не оставляют как есть. Подробно — в разделе 25.
Процессорное время. Прерывание тика при 1 кГц, когда будить некого, — четыре десятка команд и полторы сотни тактов: около 0,2 % процессора F103 на 72 МГц. Переключения контекста добавляют к этому по полторы микросекунды каждое. На фоне возможностей F4 это ничто, на F103 в нагруженной задаче — уже величина, которую стоит помнить.
И цена, которую не измерить сборкой: новый класс ошибок. Гонки между задачами, инверсия приоритетов, переполнение стека отдельной задачи, взаимная блокировка. Ни одна из них не воспроизводится по требованию и не ловится отладчиком с первого раза. Разделы 30 и 36 посвящены как раз им.
23.5 Терминология
Слова, которые дальше используются без пояснений.
Задача — функция с бесконечным циклом и собственным стеком. В других системах то же самое называют потоком; в FreeRTOS оба слова означают одно.
Планировщик — часть ядра, выбирающая, кому отдать процессор.
Приоритет — число, чем больше, тем важнее. Нумерация с нуля; нулевой занят задачей простоя, поэтому задачам обычно дают от единицы и выше.
Состояния задачи — четыре:
| Состояние | Что означает |
|---|---|
| выполняется | занимает процессор прямо сейчас; такая задача одна |
| готова | могла бы выполняться, но есть более приоритетная |
| ожидает | ждёт события или истечения времени, процессор не потребляет |
| приостановлена | выведена из игры вручную, планировщик её не рассматривает |
Вытеснение — принудительная передача процессора более приоритетной задаче, не спрашивая текущую. Противоположность — кооперативный режим, где задача отдаёт процессор только сама.
Тик — период системного таймера, единица измерения всех задержек.
Задача простоя — создаётся ядром автоматически и выполняется, когда все прочие ждут. Её приоритет — ноль. В ней освобождается память задач, удаливших себя, и, если настроено, засыпает процессор.
Критическая секция — участок кода, на время которого переключение задач запрещено.
Адаптация ядра — набор файлов, привязывающих переносимую часть к конкретному процессору. Для Cortex‑M3 и Cortex‑M4 они разные, и подмена одного другим — типичная причина того, что «ничего не работает, а почему не понять».
23.6 Когда операционная система не нужна
Раздел, которого обычно не пишут, — а он важнее предыдущих.
Не нужна, если дел одно-два и они простые. Мигать светодиодом и опрашивать кнопку суперцикл делает лучше: меньше кода, меньше памяти, нечему ломаться.
Не нужна ради скорости реакции. Тик — это разрешение задержек и тайм-аутов (1 мс), а не реакции: задача, разбуженная из прерывания, получает процессор сразу на его выходе, за единицы микросекунд (28.3). А то, что требует реакции за единицы тактов, делают прерывания и аппаратура — одинаково с ядром и без.
Не нужна, если памяти в обрез. На F103C8 с 20 КБ ядро с кучей займут больше половины. На камнях с 8 КБ и меньше об этом можно не думать вовсе.
Не нужна, если прибор обязан быть предельно предсказуем. Как ни парадоксально, аккуратно написанный суперцикл проверяется полностью: все пути видны, вариантов чередования нет. Многозадачность порождает комбинаторику состояний, которую перебрать нельзя. Там, где отказ стоит дорого, простота дороже удобства.
Нужна, когда несколько независимых потоков дел с разной срочностью, когда есть длинные операции, которые не должны тормозить остальное, когда прибор обменивается данными по нескольким интерфейсам сразу, и когда объём кода перерос способность удерживать в голове тайминги всех веток.
Практическое правило: суперцикл, пока он читается. Как только в цикле появляется третий счётчик времени и первая ветка вида «а если сейчас идёт передача, то отложим» — это сигнал.
23.7 Планировщик своими руками
Между суперциклом и операционной системой есть промежуточная ступень — кооперативный планировщик. Задачи остаются обычными функциями, а главный цикл вызывает по таблице те, чей срок наступил. Своих стеков у задач нет, вытеснения нет, и каждая задача обязана быстро вернуться. Этого часто хватает, чтобы суперцикл снова стал читаемым.
Обычно начинают с отметок времени:
if (HAL_GetTick() - ts > delay) {      /* так делать не надо */
    work();
    ts = HAL_GetTick();                 /* отметка — после работы */
}
У этой схемы две ошибки, и обе растягивают период. Сравнение > вместо
≥ добавляет миллисекунду. Отметка «сейчас» после работы добавляет
время самой работы и задержку цикла. Это та же ошибка, что у
vTaskDelay в разделе 26.4, и лечится она так же: следующий срок —
прошлый срок плюс период.
#define SCHED_MAX 8

struct task {
    void (*fn)(void);
    uint32_t period;                    /* мс */
    uint32_t next;                      /* срок следующего запуска */
};

struct sched {
    struct task t[SCHED_MAX];
    unsigned count, current;
    uint32_t skipped;                   /* пропущено сроков из-за отставания */
};

/* Срок наступил: now не раньше due. Разность в 32 битах без знака
 * переживает переполнение счётчика, если периоды короче 24 суток. */
static int due(uint32_t now, uint32_t when)
{
    return (uint32_t)(now - when) < 0x80000000u;
}

/* Задача сама меняет свой период — следующий срок отсчитается по-новому */
void sched_delay(struct sched *s, uint32_t period)
{
    s->t[s->current].period = period;
}

/* Из главного цикла: запустить всё, чему пришёл срок. Время берётся
 * заново перед каждой задачей — предыдущая могла работать долго. */
void sched_run(struct sched *s, uint32_t (*now)(void))
{
    for (unsigned i = 0; i < s->count; i++) {
        struct task *t = &s->t[i];
        if (!due(now(), t->next))
            continue;
        s->current = i;
        t->fn();
        t->next += t->period;           /* от прошлого срока: период не уплывает */
        while (due(now(), t->next)) {   /* отстали больше чем на период — пропустить */
            t->next += t->period;
            s->skipped++;
        }
    }
}
sched_add кладёт в таблицу функцию, её период и первый срок. Главный
цикл сводится к for (;;) sched_run(&s, HAL_GetTick);. Планировщик
занимает 24 байта стека на Cortex-M3.
Переполнение счётчика. 32-битный счётчик миллисекунд переполняется
через 49,7 суток. Сравнение now >= next в этот момент ломается,
сравнение разности без знака — нет. Оно работает для любых периодов
короче 24,9 суток.
Отставание. Главный цикл может где-то застрять. Тогда задача не должна выполняться пачкой, наверстывая все пропущенные сроки. Она выполнится один раз, а лишние сроки пропустит. Пример: планировщик простоял 1000 мс, задача с периодом 300 мс сработала один раз, пропустила 3 срока, и её следующий срок — 1500 мс.
Опыт. Минута работы на модели. Часы в миллисекундах стартуют за 4 секунды до переполнения. Задачи: - два светодиода с периодами 300 и 500 мс, работа — по 1 мс; - опрос кнопки раз в 20 мс, работа — 7 мс.
| Светодиод 300 мс | Светодиод 500 мс | Кнопка 20 мс | |
|---|---|---|---|
отметки «сейчас» и > |
194 | 119 | 2143 |
| планировщик | 199 | 119 | 2999 |
| опоздание у планировщика, не больше | 0 мс | 1 мс | 2 мс |
Планировщик выполнил каждую задачу во все сроки, которые поместились в
минуту, в том числе когда счётчик прошёл через ноль. Наивная схема
потеряла 28,5 % опросов кнопки: 7 мс работы и сравнение > превратили
период 20 мс в 28. Опоздание у планировщика не больше суммы работы
остальных задач: нижняя по таблице могла начаться за миг до срока,
а верхние в следующем проходе всё равно пойдут первыми. В опыте
светодиоды почти не опаздывали только потому, что все периоды кратны
20 мс: сроки совпадают, и в проходе первой идёт верхняя задача. Стоит
сменить период кнопки на 23 мс — и светодиоды опаздывают на 6 и 7 мс.
Поэтому быстрые и важные задачи ставят в начало таблицы, а длинную работу
режут на короткие шаги.
Обмен данными. Все задачи выполняются в одном потоке, по очереди.
Общая переменная между ними безопасна, volatile не нужен. volatile и
атомарность нужны, только если данные приходят из прерывания (раздел 7). Когда
данных становится поток — байты из UART, события кнопки, — нужна
очередь. Во FreeRTOS она готовая (раздел 27).
Пределы у схемы те же, что у суперцикла. Одна долгая задача задерживает все остальные. Приоритетов нет, кроме порядка в таблице. Ждать внутри задачи нельзя. Когда задачам понадобится ждать — данных, флага, ресурса, — пора переходить к ядру (23.6).
23.8 Грабли
Код после vTaskStartScheduler не выполняется. Так и задумано: планировщик управление не
возвращает — только если не хватило памяти под задачу простоя (23.2).
Половина ОЗУ BluePill занята, хотя ничего ещё не создано. Куча в конфигурации справочника — 10 КБ из 20 КБ памяти F103C8; размер кучи подбирают под прибор (23.4).
23.9 Итоги
- Суперцикл упирается не в скорость, а в связность: с ростом числа дел каждая правка задевает тайминг остальных.
- Задача — функция с собственным стеком; поэтому её можно прервать и возобновить, а код внутри пишется линейно.
- Правило планировщика одно: выполняется готовая задача с наибольшим приоритетом.
- Ожидание через ядро отдаёт процессор другим — в этом вся выгода.
- «Реальное время» означает предсказуемость срока, а не быстроту.
- Ядро — это файлы в вашей прошивке. Оно не даёт ни драйверов, ни изоляции памяти, ни защиты от сбоев.
- Ассемблерная часть переключения контекста на Cortex‑M — девятнадцать инструкций: половину регистров процессор сохраняет сам.
- Цена: ≈ 6,4 КБ кода, 92 байта на блок управления задачей плюс её стек, и куча, в конфигурации справочника равная половине памяти BluePill.
- Настоящая цена — не память, а гонки, инверсия приоритетов и переполнение стеков.
- Если суперцикл ещё читается, операционная система не нужна.
- Промежуточная ступень — кооперативный планировщик. Следующий срок в нём равен прошлому сроку плюс период, сроки сравниваются по разности без знака, отставшая задача пропускает сроки, а не наверстывает их. В опыте наивные отметки «сейчас» потеряли 28,5 % опросов кнопки.
Дальше: раздел 23а «Прибор без ОС: автоматы, очередь событий, неблокирующие драйверы» — докуда суперцикл дотягивается без ядра, если дать ему очередь, автоматы и программные таймеры, и во что это обходится.