 Embedded HandbookПриложения
23а. Прибор без ОС: автоматы, очередь событий, неблокирующие драйверы
Раздел 23 закончился правилом «суперцикл, пока он читается» — и честным списком его пределов. Прежде чем брать ядро, стоит увидеть, как далеко эти пределы отодвигаются без него. Приём известен десятилетия: события складываются в очередь, логика записывается автоматами, ожидание превращается в программный таймер, а между событиями процессор спит. Получается та же архитектура, что у операционной системы, — но из трёх страниц собственного кода, устройство которого видно насквозь.
Всё в этом разделе собрано двумя компиляторами и прогнано в QEMU; очередь дополнительно проверена на компьютере двумя потоками под ThreadSanitizer (тем же способом, что в разделе 139).
Как это называется в документации
Оригинал Перевод finite state machine (FSM) конечный автомат state / event / transition состояние, событие, переход transition table таблица переходов action действие, привязанное к переходу event queue очередь событий ring buffer / circular buffer кольцевой буфер single producer, single consumer один писатель — один читатель lock-free без блокировок и запрета прерываний non-blocking неблокирующий: вызов возвращается сразу busy-wait / polling занятое ожидание, опрос event loop / dispatcher цикл событий, диспетчер software timer программный таймер run to completion шаг автомата выполняется до конца data race гонка данных
23а.1 Автомат: сначала таблица переходов, потом код
Пример на весь раздел — кнопка. Требования звучат безобидно: подавить
дребезг, отличить короткое нажатие от длинного, о длинном сообщить сразу
по истечении времени, не дожидаясь отпускания. Написанное на if и
флагах, это превращается в кашу уже к третьему требованию — потому что
флаги перечисляют не состояния, а обрывки истории.
Автомат наводит порядок одним ходом: сначала выписываются все состояния и все события, потом — таблица «состояние × событие → новое состояние и действие». Код пишется в последнюю очередь, механически по таблице.
Состояний у кнопки четыре, событий три. События здесь — не уровни на выводе, а фронты (нажали, отпустили) и срабатывание таймера: время в событийной программе — такое же событие, как всё остальное.
| нажатие | отпускание | таймер | |
|---|---|---|---|
| ОТПУЩЕНА | → ДРЕБЕЗГ · взвести 20 мс | — | — |
| ДРЕБЕЗГ | — | → ОТПУЩЕНА · стоп таймера | → НАЖАТА · взвести 780 мс |
| НАЖАТА | — | → ОТПУЩЕНА · стоп, «короткое» | → ДЛИННОЕ · «длинное» |
| ДЛИННОЕ | — | → ОТПУЩЕНА | — |
Прочерк означает «остаться на месте и ничего не делать» — и это полезная часть таблицы: она явно говорит, что повторное «нажатие» в состоянии НАЖАТА не значит ничего. В коде на флагах такие случаи обычно просто не рассмотрены.
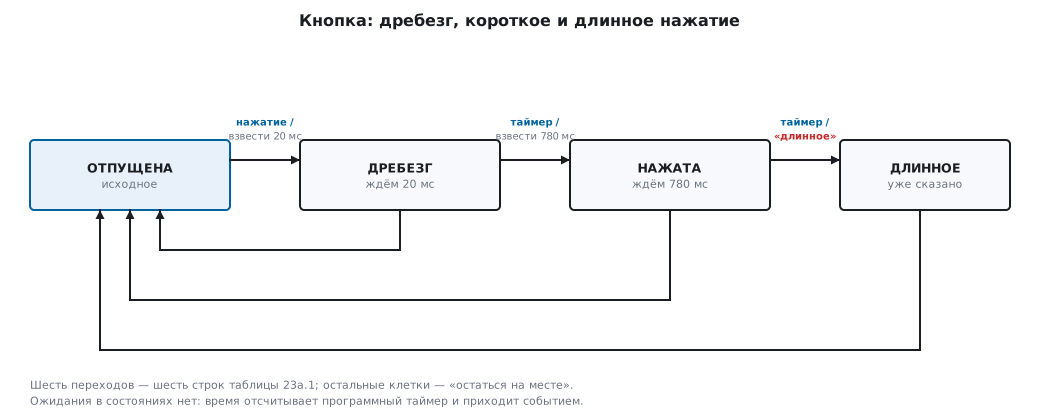
Обратите внимание: ни в одном состоянии автомат не ждёт. «Ждём 20 мс» — это не цикл с задержкой, а взведённый при входе таймер; его срабатывание придёт событием. Действие принадлежит переходу, а не состоянию: «короткое нажатие» объявляется на стрелке НАЖАТА → ОТПУЩЕНА, и только на ней.
На C заголовок автомата — три перечисления и две константы:
enum state { ST_UP, ST_DEBOUNCE, ST_DOWN, ST_LONG, N_STATES };
enum event { EV_PRESS, EV_RELEASE, EV_TIMEOUT, N_EVENTS };
enum out   { OUT_SHORT = 1, OUT_LONG };

#define T_DEBOUNCE 20u                  /* мс: дребезг закончился */
#define T_LONG    780u                  /* мс: дальше — длинное нажатие */
Дальше таблицу можно записать кодом тремя способами — и они заметно различаются по размеру, скорости и удобству сопровождения.
23а.2 Три записи на C: switch, таблица, указатель на функцию
Запись первая — вложенный switch. Самая привычная: снаружи —
по состоянию, внутри — по событию.
static uint8_t st = ST_UP;

void fsm_step(uint8_t ev)
{
    switch (st) {
    case ST_UP:
        if (ev == EV_PRESS)   { timer_start(T_DEBOUNCE); st = ST_DEBOUNCE; }
        break;
    case ST_DEBOUNCE:
        if (ev == EV_RELEASE) { timer_stop(); st = ST_UP; }   /* дребезг */
        if (ev == EV_TIMEOUT) { timer_start(T_LONG); st = ST_DOWN; }
        break;
    case ST_DOWN:
        if (ev == EV_RELEASE) { timer_stop(); report(OUT_SHORT); st = ST_UP; }
        if (ev == EV_TIMEOUT) { report(OUT_LONG); st = ST_LONG; }
        break;
    case ST_LONG:
        if (ev == EV_RELEASE) { st = ST_UP; }
        break;
    }
}
Запись вторая — таблица переходов в постоянной памяти. Код диспетчера один на любой автомат; растут только данные. Каждая клетка — новое состояние плюс действие:
static void a_none(void)   { }
static void a_debounce(void) { timer_start(T_DEBOUNCE); }
static void a_cancel(void) { timer_stop(); }                  /* дребезг */
static void a_hold(void)   { timer_start(T_LONG); }
static void a_short(void)  { timer_stop(); report(OUT_SHORT); }
static void a_long(void)   { report(OUT_LONG); }

struct cell {
    uint8_t next;                       /* новое состояние */
    void (*action)(void);               /* что сделать на переходе */
};

static const struct cell tab[N_STATES][N_EVENTS] = {
    [ST_UP] = {
        [EV_PRESS]   = { ST_DEBOUNCE, a_debounce },
        [EV_RELEASE] = { ST_UP,       a_none },
        [EV_TIMEOUT] = { ST_UP,       a_none },
    },
    [ST_DEBOUNCE] = {
        [EV_PRESS]   = { ST_DEBOUNCE, a_none },
        [EV_RELEASE] = { ST_UP,       a_cancel },
        [EV_TIMEOUT] = { ST_DOWN,     a_hold },
    },
    [ST_DOWN] = {
        [EV_PRESS]   = { ST_DOWN,     a_none },
        [EV_RELEASE] = { ST_UP,       a_short },
        [EV_TIMEOUT] = { ST_LONG,     a_long },
    },
    [ST_LONG] = {
        [EV_PRESS]   = { ST_LONG,     a_none },
        [EV_RELEASE] = { ST_UP,       a_none },
        [EV_TIMEOUT] = { ST_LONG,     a_none },
    },
};

void fsm_step(uint8_t ev)
{
    const struct cell *c = &tab[st][ev];
    c->action();                        /* действие принадлежит переходу */
    st = c->next;
}
Это буквальный перенос таблицы из 23а.1 — вплоть до того, что заполненность
всех клеток проверяется глазами, а прочерки стали a_none.
Запись третья — состояние как указатель на функцию. Диспетчера нет вовсе: текущее состояние — это адрес функции, переход — присваивание.
typedef void (*state_fn)(uint8_t ev);

static state_fn st = s_up;

static void s_down(uint8_t ev)
{
    if (ev == EV_RELEASE) { timer_stop(); report(OUT_SHORT); st = s_up; }
    if (ev == EV_TIMEOUT) { report(OUT_LONG); st = s_long; }
}

void fsm_step(uint8_t ev)
{
    st(ev);
}
Все три собраны для Cortex-M3 с оптимизацией по размеру двумя компиляторами; размеры взяты из map-файлов компоновщиков. Скорость измерена в QEMU пошаговым счётом команд на одном и том же сценарии из девяти событий (дребезг, короткое нажатие, длинное):
switch |
таблица | указатель | |
|---|---|---|---|
| код, gcc −Os | 100 байт | 82 байта | 160 байт |
| код, armclang −Os | 102 байта | 88 байт | 182 байта |
| константы во флеш-памяти | 0 | 96 байт | 0 |
| состояние в ОЗУ | 1 байт | 1 байт | 4 байта |
| команд на 9 событий | 166 | 156 | 141 |
| команд на событие | 15…25 | 13…24, из них семь раз по 17 | 9…21 |
Выводы из таблицы весомее самой таблицы.
Про размер. У switch и у указателя код растёт с каждым переходом,
у таблицы код закончен (82 байта — навсегда), растут данные: по 8 байт
на клетку. Восемь, а не пять: байт состояния, три байта выравнивания,
четыре байта указателя — про эту арифметику см. Грабли.
Про скорость. Указатель на функцию быстрее всех — исчезла развилка по состоянию. Таблица интереснее: семь событий из девяти обработаны ровно за 17 команд — путь через диспетчер один и тот же, какая бы клетка ни выпала. Для программы, где важна предсказуемость времени отклика, это довод не слабее среднего значения.
Про сопровождение. В switch вся логика читается сверху вниз —
для трёх-четырёх состояний он лучший. Таблица заставляет перечислить
все клетки и потому не даёт забыть случай; на десятках состояний она
вне конкуренции. Указатель хорош там, где состояния сильно различаются
по поведению, но помните: на вопрос отладчика «в каком я состоянии»
он отвечает адресом функции.
⚠️ QEMU считает команды, а не такты. На живом F103 добавятся такты ожидания флеш-памяти (раздел 6), поэтому «17 команд» — это оценка порядка величины: единицы микросекунд на 72 МГц. Для сравнения вариантов между собой счёт команд честен: сценарий один и тот же.
23а.3 Кольцевая очередь: из прерывания в цикл без запрета прерываний
Автомату нужны события, а рождаются они в прерываниях: фронт на выводе, тик таймера, байт по I²C. Обработчик должен быть коротким (раздел 7), поэтому внутри него события не обрабатывают, а складывают — и разбирают потом, в главном цикле. Между прерыванием и циклом нужна очередь.
Классическое решение — кольцевой буфер с двумя индексами, у которого один писатель и один читатель: пишет только прерывание, читает только цикл. При таком разделении очередь корректна вообще без запрета прерываний — каждый индекс меняет ровно одна сторона:
#define Q_SIZE 32u                      /* степень двойки: маска вместо деления */
#define Q_MASK (Q_SIZE - 1u)

struct ev {
    uint8_t  code;                      /* какое событие */
    uint8_t  arg;                       /* от кого */
    uint16_t stamp;                     /* когда, мс */
};

static volatile struct ev q_buf[Q_SIZE];
static volatile uint32_t q_head;        /* пишет ТОЛЬКО прерывание */
static volatile uint32_t q_tail;        /* пишет ТОЛЬКО главный цикл */
static volatile uint32_t q_dropped;     /* сколько событий потеряно на переполнении */

/* Из прерывания. Один слот всегда пуст: head == tail означает «пусто»,
 * поэтому догнать хвост головой нельзя. */
static int q_push(uint8_t code, uint8_t arg, uint16_t stamp)
{
    uint32_t h = q_head;
    uint32_t next = (h + 1u) & Q_MASK;
    if (next == q_tail) {               /* полна: потерю считаем, а не молчим */
        q_dropped++;
        return 0;
    }
    q_buf[h].code = code;
    q_buf[h].arg = arg;
    q_buf[h].stamp = stamp;
    q_head = next;                      /* индекс — последним: слот уже заполнен */
    return 1;
}

/* Из главного цикла. */
static int q_pop(struct ev *e)
{
    uint32_t t = q_tail;
    if (t == q_head)                    /* пусто */
        return 0;
    e->code = q_buf[t].code;
    e->arg = q_buf[t].arg;
    e->stamp = q_buf[t].stamp;
    q_tail = (t + 1u) & Q_MASK;         /* освободить слот — тоже последним */
    return 1;
}
На чём держится корректность — три опоры, и каждая обязательна:
- Порядок записей. Слот заполняется до продвижения
q_head; слот вычитывается до продвиженияq_tail. Пока индекс не сдвинут, вторая сторона слота не видит. volatileна всём, включая буфер. Он запрещает компилятору и кешировать индексы в регистрах, и переставлять запись слота с записью индекса: обращения кvolatile-объектам выполняются в порядке текста программы (раздел 124). Индекс безvolatile— см. Грабли: цикл замирает навсегда.- Атомарность индекса. Выровненная запись 32-битного слова на Cortex-M — одна команда, «половину индекса» прочитать нельзя.
Заполнение и опустошение различаются по одному свободному слоту:
head == tail — пусто, поэтому полезных мест в очереди на 32 слота —
31. И обязательная деталь взрослого прибора: переполнение считается.
Молчаливая потеря событий — худшая из невоспроизводимых ошибок; счётчик
q_dropped стоит одной команды, а на отладке первым отвечает
на главный вопрос: теряем или нет.
Прогон в QEMU (Cortex-M3, производитель — прерывание SysTick, потребитель — главный цикл). Две тысячи тиков прерывание кладёт по событию, каждый десятый тик — два подряд; затем читатель нарочно останавливается на сто тиков, а прерывание продолжает класть:
A pushed=2200 popped=2200 maxfill=2 order_err=0
B fit=31 dropped=69 maxfill=31
C first=2200 last=2230 order_err=0
TOTAL pushed=2300 popped=2231 dropped=69
Пока читатель жив, 2200 событий пришли строго по порядку, и даже на
сдвоенных тиках очередь не заполнялась глубже двух. Когда читатель
встал, в очередь поместилось ровно 31 событие, остальные 69 честно
сосчитаны в q_dropped, а уцелевшие номера 2200…2230 пришли подряд —
арифметика сходится до единицы: 2231 + 69 = 2300.
Прогон на компьютере. На двух настоящих потоках роль volatile
играют атомики C11 (раздел 140): запись индекса — с порядком release,
чтение чужого — acquire:
static uint32_t buf[Q_SIZE];
static _Atomic uint32_t head, tail;

static int push(uint32_t v)
{
    uint32_t h = atomic_load_explicit(&head, memory_order_relaxed);
    uint32_t next = (h + 1u) & Q_MASK;
    if (next == atomic_load_explicit(&tail, memory_order_acquire))
        return 0;                       /* полна */
    buf[h] = v;
    atomic_store_explicit(&head, next, memory_order_release);
    return 1;
}
Два миллиона номеров прошли через 32 слота без единого нарушения
порядка, и ThreadSanitizer промолчал: items=2000000 order_err=0.
А в версии с обычными, неатомарными индексами он показал ровно то,
что обязан: WARNING: ThreadSanitizer: data race с адресами всех трёх
чтений в pop.
⚠️ «Один писатель» — это одно прерывание, а не «все прерывания». Если в очередь пишут два обработчика с разными приоритетами, один может вытеснить другой посреди
q_push— и два события лягут в один слот. Либо все источники проходят через одно прерывание (в примерах раздела — тик, который опрашивает кнопку и таймеры), либоq_pushвыполняется при запрещённых прерываниях, либо у каждого писателя своя очередь.
23а.4 Программные таймеры на одном тике
Автомату из 23а.1 нужны «20 мс» и «780 мс», датчику из 23а.5 — «30 мс»,
индикации — «раз в секунду». Аппаратный таймер на каждое ожидание —
расточительность; хватает одного тика SysTick (раздел 12) и массива
сроков:
struct sw_timer {
    uint32_t deadline;                  /* срок в миллисекундах g_ms */
    uint8_t armed;
    uint8_t code;                       /* какое событие положить в очередь */
};

static volatile struct sw_timer timers[N_TIMERS];

void timer_arm(uint8_t i, uint32_t ms, uint8_t code)
{
    timers[i].armed = 0;                /* пока поля меняются, таймер выключен */
    timers[i].deadline = g_ms + ms;
    timers[i].code = code;
    timers[i].armed = 1;                /* включить — последней записью */
}

static void timers_poll(void)           /* из прерывания тика */
{
    for (unsigned i = 0; i < N_TIMERS; i++) {
        if (timers[i].armed && (int32_t)(g_ms - timers[i].deadline) >= 0) {
            timers[i].armed = 0;        /* одноразовый: перевзведёт автомат */
            q_push(timers[i].code, (uint8_t)i, (uint16_t)g_ms);
        }
    }
}
В этих двадцати строках — три решения, и каждое стоит назвать по имени.
Срок, а не остаток. Хранится момент срабатывания, сравнение — через
разность со знаком: (int32_t)(g_ms - deadline) >= 0 переживает
переполнение счётчика миллисекунд (та же арифметика, что в 23.7,
мина — из раздела 3).
Порядок записей при взводе. timer_arm вызывается из главного
цикла (это действие автомата), а timers_poll — из прерывания. Пока
меняются deadline и code, таймер выключен; флаг armed
устанавливается последней записью, и прерывание никогда не увидит
таймер с новым флагом и старым сроком.
Таймер не вызывает, а сообщает. Срабатывание — это q_push события
EV_TIMEOUT из прерывания тика. Писатель у очереди остаётся один,
а автомат получает время тем же путём, что и всё остальное.
Вся конструкция целиком — на схеме:
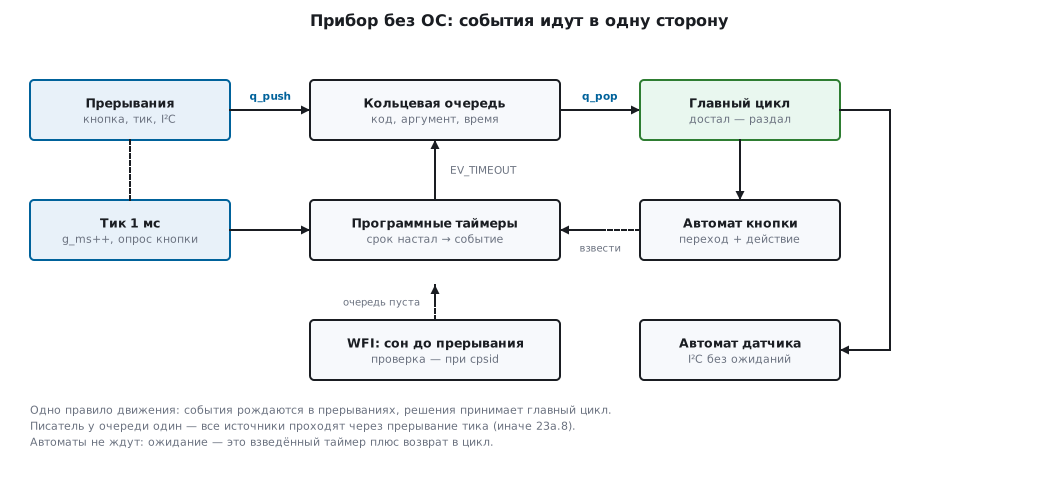
Главный цикл вырождается в диспетчер:
    for (;;) {
        while (q_pop(&e))
            fsm_step(e.code);
        if (g_ms > 1400u)
            break;
        idle();
    }
(условие останова — стендовое: на приборе цикл бесконечен). Прогон всего каркаса в QEMU — прерывание «нажимает» кнопку по сценарию из 23а.2 — даёт в точности ожидаемое и ни событием больше:
OUT short t=100
OUT long t=1000
loops=1401 ms=1401 maxfill=1 dropped=0 outs=2
(от прогона к прогону бывает и loops=1402: первый виток цикла иногда
успевает пройти до первого тика — это не лишнее пробуждение.)
Короткое нажатие объявлено в миллисекунду отпускания, длинное — ровно через 20 + 780 мс после нажатия, дребезг не породил ничего. Очередь за весь прогон не заполнялась глубже одного события.
23а.5 🔧 Неблокирующий драйвер: датчик по I²C вместо ожидания 30 мс
Классическая сцена: датчик по запросу начинает преобразование и лишь через 30 мс готов отдать результат. Драйвер «в лоб» повторяет документацию дословно:
    i2c_write(SENS_ADDR, &cmd, 1);      /* команда «начать» */
    delay_ms(30);                       /* прибор мёртв 30 мс */
    i2c_read(SENS_ADDR, raw, 2);        /* забрать результат */
Тридцать миллисекунд — это первый предел суперцикла из 23.1 в чистом виде: кнопки не опрашиваются, индикация стоит, второй такой датчик доводит мёртвое время до 60 мс. В событийном каркасе то же самое — автомат из трёх состояний, где ожидание превратилось во взведённый таймер, а завершение обмена по шине — в событие от прерывания I²C (раздел 17):
enum s_state { S_IDLE, S_MEASURING, S_READING };

void sensor_step(uint8_t ev)
{
    switch (s_st) {
    case S_IDLE:
        if (ev == SEV_POLL) {           /* пора мерить */
            i2c_start_write(SENS_ADDR, &cmd_measure, 1);
            timer_arm(TIMER_SENSOR, 30, SEV_TIMEOUT);
            s_st = S_MEASURING;
        }
        break;
    case S_MEASURING:
        if (ev == SEV_TIMEOUT) {        /* 30 мс прошли — забрать результат */
            i2c_start_read(SENS_ADDR, raw, 2);
            s_st = S_READING;
        }
        break;
    case S_READING:
        if (ev == SEV_I2C_DONE) {       /* прочитано: обработать и спать */
            sensor_value = (uint16_t)(((uint16_t)raw[0] << 8) | raw[1]);
            s_st = S_IDLE;
        }
        break;
    }
}
Рецепт переделки любого блокирующего драйвера одинаков:
- Каждый
delay_ms(N)→ состояние плюсtimer_arm(N). - Каждый опрос флага в цикле → состояние плюс событие из прерывания.
- Каждый вызов, который «делает всё сразу», →
..._start(), который только запускает и возвращается.
Процессор между шагами свободен: пока датчик преобразует, автомат кнопки обрабатывает нажатия, а при пустой очереди прибор спит. Ждать осталось негде — и это свойство архитектуры, а не аккуратности конкретного драйвера.
23а.6 Сон между событиями: WFI без потерянного пробуждения
Если события рождаются только в прерываниях, между событиями процессору
нечего делать — и цикл может спать. Наивное if (пусто) __WFI();
содержит гонку «потерянного пробуждения», разобранную в 84.6: событие,
пришедшее между проверкой и сном, будить уже некого. Лекарство то же,
что и там, — проверять и засыпать при запрещённых прерываниях:
static void idle(void)
{
    __asm volatile("cpsid i");
    if (q_tail == q_head)               /* очередь пуста — можно спать */
        __asm volatile("wfi");          /* ожидающее прерывание всё равно разбудит */
    __asm volatile("cpsie i");
}
WFI просыпается от ожидающего прерывания даже при PRIMASK = 1;
обработчик выполнится после cpsie i, положит событие — и очередной
виток цикла его заберёт. Компилятор собирает это без единой лишней
команды — проверка пустоты зажата между cpsid и wfi:
 8000352:   cpsid   i
 8000354:   ldr r2, [r5, #0]
 8000356:   ldr r3, [r7, #0]
 8000358:   cmp r2, r3
 800035a:   bne.n   800035e <main+0xce>
 800035c:   wfi
 800035e:   cpsie   i
Работу пары «очередь + WFI» видно в прогоне из 23а.4: loops=1401 при
ms=1401 — главный цикл просыпался ровно один раз на тик, ни одного
холостого витка и ни одного потерянного события за 1401 мс. Без idle()
тот же цикл крутился бы миллионы раз, сжигая ток на опросе пустой
очереди; сколько тока экономит сон и какие режимы глубже — раздел 10.
23а.7 Когда всё же ОС: честное сравнение с 23.6
Стенд из 23а.4 — очередь, четыре таймера, автомат кнопки таблицей и сон — собрался в 1216 байт кода вместе со стендовой печатью; каркас держит в ОЗУ 176 байт (128 — очередь, 32 — таймеры, 12 — индексы и счётчик потерь, 4 — время). Прибор из 23.4 на FreeRTOS занимал 6836 байт кода и ≈ 2,4 КБ ОЗУ плюс куча. Разница — порядок: на F103C8, где ядро с кучей из 23.4 забирали больше половины из 20 КБ, каркас оставляет память практически нетронутой.
При этом главные пределы суперцикла из 23.1 событийный каркас действительно снимает: длинных ожиданий больше нет (23а.5), реакция не зависит от самой медленной ветки, счётчиков времени в цикле нет — время стало событиями. Что он не снимает:
| Предел | Суперцикл | Событийный каркас | ОСРВ |
|---|---|---|---|
| блокирующее ожидание | съедает всё | устранено | устранено |
| длинное вычисление | тормозит всё | тормозит всё | вытесняется |
| приоритеты | нет | только порядок разбора | есть |
| код дела | последовательность | разрезан на состояния | последовательность |
| память | минимум | +очередь и таймеры | +стек каждой задаче |
Строка про длинное вычисление — ключевая. Шаг автомата выполняется до конца: если пересчёт фильтра занимает 40 мс, все события ждут эти 40 мс, и никакая очередь не поможет — вытеснять некому. Строка «код дела» — цена читаемости: дело, которое в задаче ОСРВ было бы десятью строками подряд, автомат режет на состояния, и связность теряется (тот самый четвёртый предел из 23.1, он никуда не делся — лишь отодвинулся).
Итого правило раздела 23.6 уточняется так: событийный каркас — пока
каждый шаг короткий, а дел меньше десятка. Появились длинные
вычисления, которые нельзя порезать, нужны настоящие приоритеты, или
автоматы начали обмениваться событиями так густо, что таблицы перестали
читаться, — пора в раздел 24. Тем более что переучиваться не придётся:
очередь с ожиданием здесь называется xQueueReceive (раздел 27 —
кнопка этого раздела повторена там в 27.7 уже на ядре), таймеры —
службой таймеров ядра. Механика уже знакома, меняются имена.
23а.8 Грабли
Индекс очереди без volatile — и цикл замирает навсегда. Компилятор
выносит чтение неизменяемой (по его мнению) переменной из цикла: на
стенде версия без атомиков, собранная с −O1, повисла — читатель вечно
видел пустую очередь (прибит по тайм-ауту). Та же программа с −O0
работала, но ThreadSanitizer показал гонку. «Работает в отладочной
сборке, виснет в релизной» — это оно (раздел 124).
Таблица переходов наполовину из воздуха. Клетка {uint8_t, указатель}
занимает 8 байт: три байта — выравнивание (раздел 126). 96 байт таблицы
кнопки — терпимо; на большом автомате замените указатель номером
действия из enum — клетка сожмётся до 2 байт.
Два прерывания пишут в одну очередь. Более приоритетное вытесняет
q_push посреди работы — два события в одном слоте. Один писатель,
либо запрет прерываний вокруг q_push (23а.3).
Слот пишется после индекса. Уберите volatile с буфера — и
компилятор вправе сдвинуть заполнение слота за запись q_head;
читатель получит мусор. Порядок гарантирован только между
volatile-обращениями (раздел 124).
Таймер взводится в два приёма — и стреляет старым сроком. Если
armed не сбрасывается на время правки полей, прерывание может застать
новый флаг со старым deadline. Флаг — последней записью (23а.4).
«Подождать 30 мс» внутри действия автомата. Действие выполняется
в диспетчере: delay_ms в нём останавливает весь прибор — ожидание
оформляется состоянием и таймером (23а.5).
Проверка пустоты — до cpsid. Потерянное пробуждение: событие
пришло между проверкой и WFI, прибор спит до следующего прерывания
(84.6, стенд 23а.6).
23а.9 Итоги
- Автомат начинается с таблицы «состояние × событие», а не с кода; прочерки в ней — тоже решения. Время — такое же событие, как фронт на выводе: «ждём» значит «взведён таймер».
- Три записи автомата на C измерены:
switch— 100 байт кода, таблица — 82 байта кода и 96 байт данных, указатель на функцию — 160 байт (gcc −Os, Cortex-M3). По скорости на девяти событиях: 166, 156 и 141 команда; у таблицы время почти постоянно — семь событий из девяти по 17 команд. - Кольцевая очередь «один писатель — один читатель» корректна без
запрета прерываний на трёх опорах: индекс — последней записью,
volatileна индексах и буфере, атомарность выровненного слова. В QEMU 2300 событий прошли без нарушения порядка; переполнение сосчитано до единицы (31 поместилось, 69 вq_dropped). - На настоящих потоках роль
volatileиграют атомики C11 (release/acquire): два миллиона событий — и ThreadSanitizer молчит; без атомиков он показывает гонку, а −O1 превращает её в вечное зависание. - Программные таймеры: один тик, массив сроков, сравнение разностью
со знаком,
armed— последней записью, срабатывание — событием в ту же очередь. - Неблокирующий драйвер получается механически:
delay_ms→ состояние плюс таймер, опрос флага → событие из прерывания, «сделать всё» → «запустить и вернуться». - Сон между событиями — проверка и
WFIподcpsid(84.6): в прогоне цикл просыпался ровно раз на тик, 1401 виток за 1401 мс, ноль потерянных событий. - Весь каркас — 1216 байт кода и 176 байт ОЗУ против 6836 байт и ≈ 2,4 КБ у того же прибора на ядре. Но длинное вычисление каркас не вытеснит и линейность кода не вернёт: станет тесно — раздел 24.
Дальше: раздел 24 «Устройство FreeRTOS» — из каких файлов состоит ядро, как называются его типы и функции и что нужно, чтобы оно запустилось на плате.