 Embedded HandbookПриложения
139. Потоки POSIX и синхронизация: mutex, cond, rwlock, барьер, TLS
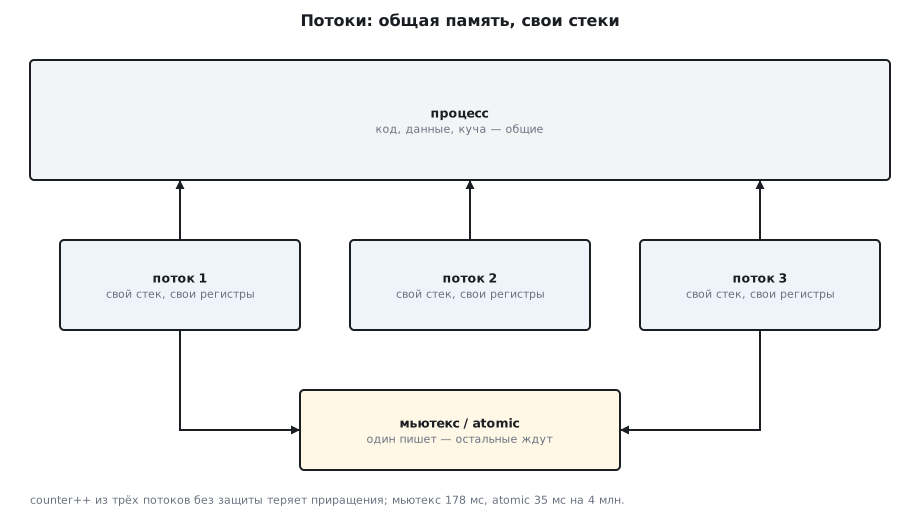
Процессы (раздел 136) изолированы друг от друга, и обмен между ними
стоит копирования через ядро. Потоки живут внутри одного процесса:
общая память, общие файлы, общая куча — и у каждого свой стек, свои
регистры и своя маска сигналов. Создать поток дешевле, чем процесс, и
данные ему передавать не нужно — они уже общие. Плата за это — гонки:
два потока, меняющие одну переменную, портят её, и защищать общее
приходится самому. Здесь — потоки POSIX (pthread) и полный набор
средств синхронизации, каждое — в опыте из _verify/sys139/ в stm-sys:1.
Задачи FreeRTOS из части IV — те же потоки: мьютекс, семафор и очередь там устроены так же, только имена другие, и всё, что здесь сказано о гонках и взаимоблокировках, относится и к прошивке.
Как это называется в документации
Оригинал Перевод thread поток joinable, detached поток, которого ждут join; отсоединённыйmutex (mutual exclusion) мьютекс: взаимное исключение critical section критическая секция condition variable условная переменная spurious wakeup ложное пробуждение read-write lock блокировка «много читателей — один писатель» spin lock спин-блокировка: активное ожидание barrier барьер: точка сбора потоков thread-local storage (TLS) данные, свои у каждого потока deadlock взаимоблокировка cancellation point точка отмены потока data race гонка данных Amdahl's law закон Амдала
139.1 Создать, дождаться, отпустить
    for (int k = 0; k < 4; k++) pthread_create(&th[k], NULL, fn, NULL);
    for (int k = 0; k < 4; k++) pthread_join(th[k], NULL);
pthread_create получает функцию void *f(void *) и аргумент; поток
возвращает указатель — его получает pthread_join. Возвращать адрес
локальной переменной потока нельзя: стек потока исчезает вместе с ним.
Функции pthread не пишут в errno, а возвращают код ошибки (у каждого
потока errno своё).
Три способа закончить поток: return из функции, pthread_exit,
pthread_cancel из другого потока — последний срабатывает только в
точках отмены (sleep, read, pthread_cond_wait…). Завершённый поток,
которого никто не join, держит ресурсы, как зомби; pthread_detach
говорит, что ждать его не будут, и ресурсы освободятся сами. exit из
любого потока завершает весь процесс.
fork в многопоточной программе. fork копирует только тот поток,
который его вызвал. Мьютекс, который в этот момент держал другой поток, в
потомке так и останется занятым: освободить его некому. Опыт: поток взял
мьютекс, главный вызвал fork — в потомке pthread_mutex_timedlock ждал
секунду и вернул ETIMEDOUT. Свои блокировки malloc и stdio glibc в
потомке восстанавливает сама — 300 потомков при соседнем потоке, крутящем
malloc, не зависли ни разу, — но о блокировках других библиотек она не
знает. Поэтому в потомке многопоточной программы до exec вызывают только
async-signal-safe функции (136.6), а лучше сразу exec или posix_spawn;
для особых случаев есть pthread_atfork.
Цена: 1000 пар create + join — 46 мс, по 46 мкс; пара fork + wait
стоила 116 мкс (раздел 136). Стек потока по умолчанию — размер
RLIMIT_STACK, 8 МБ; тысяча потоков — 8 ГБ адресного пространства.
Физически стек занимает только тронутые страницы, и на 64-битной машине это
обычно не беда, а на 32-битной плате с Linux, где программе доступно около
3 ГБ, помещается лишь несколько сотен таких потоков. Поэтому размер задают
через атрибуты (pthread_attr_setstacksize).
Сигнал, посланный процессу, получает любой поток, где он не заблокирован.
Поэтому сигналы блокируют в main через pthread_sigmask до создания потоков
(маску потоки наследуют) и принимают в одном потоке через sigwait или
signalfd (141.4).
139.2 Гонка и три способа её закрыть
Четыре потока по миллиону раз увеличивают общий счётчик:
static void *f_plain(void *a)   { (void)a; for (int i = 0; i < N; i++) plain++; return NULL; }
static void *f_mutex(void *a)   { (void)a; for (int i = 0; i < N; i++) { pthread_mutex_lock(&mx); guarded++; pthread_mutex_unlock(&mx); } return NULL; }
static void *f_atomic(void *a)  { (void)a; for (int i = 0; i < N; i++) atomic_fetch_add(&atomic_cnt, 1); return NULL; }
4 потока × 1000000 приращений:
  без защиты: 1455881 (потеряно 2544119), 2 мс
  мьютекс:    4000000, 178 мс
  atomic:     4000000, 35 мс
Без защиты потеряна большая часть приращений (в этом прогоне — больше
половины): plain++ — это чтение, сложение
и запись, и два потока, прочитавшие одно значение, запишут одно и то же.
Переменная объявлена volatile — и это ничего не изменило: volatile
запрещает компилятору убирать обращения к памяти, но атомарности не даёт
(раздел 124). Без volatile компилятор при -O2 свернул бы миллион
приращений в одно сложение, и гонка была бы не видна — вот и вся разница.
Мьютекс закрывает гонку ценой 178 мс — в десятки раз дороже: каждый захват
при конкуренции — переход в ядро (futex). Атомарное сложение — 35 мс:
одна команда процессора с префиксом lock: ядро захватывает строку кэша,
и при конкуренции её пересылка между ядрами и стоит эти 35 мс. Правило выбора: счётчик
или флаг — атомарная переменная; структура, список, несколько полей
сразу — мьютекс.
Гонку находят инструменты, а не глаза. ThreadSanitizer (-fsanitize=thread)
называет строку:
WARNING: ThreadSanitizer: data race (pid=14)
SUMMARY: ThreadSanitizer: data race /v/sys139/race_mutex.c:15 in f_plain
Helgrind из Valgrind (valgrind --tool=helgrind) делает то же без
пересборки, но в десятки раз медленнее:
Possible data race during read of size 8 at 0x10C060 by thread #3
ERROR SUMMARY: 6 errors from 2 contexts
139.3 Мьютекс: типы и взаимоблокировка
pthread_mutex_t — 40 байт; PTHREAD_MUTEX_INITIALIZER для статических,
pthread_mutex_init с атрибутами для остальных. Тип задают атрибутом:
| Тип | Повторный lock из того же потока |
Чужой unlock |
|---|---|---|
NORMAL (по умолчанию) |
зависает навсегда | не проверяется |
ERRORCHECK |
EDEADLK |
EPERM |
RECURSIVE |
считает вложенность | EPERM |
Классическая взаимоблокировка: поток 1 держит a и ждёт b, поток 2
держит b и ждёт a. С обычным lock оба ждут вечно; программа
использует pthread_mutex_timedlock и через полсекунды получает ответ:
    pthread_mutex_lock(&a); usleep(50000);                 /* держим a, тянемся к b */
    int r = lock_with_timeout(&b, 500);
    printf("поток 1: a взят, b: %s\n", r ? strerror(r) : "взят");
поток 1: a взят, b: Connection timed out
поток 2: b взят, a: Connection timed out
ERRORCHECK, второй lock из того же потока: Resource deadlock avoided
ERRORCHECK, лишний unlock: Operation not permitted
Лечение взаимоблокировки — не тайм-аут, а порядок: все потоки берут
мьютексы в одном и том же порядке (a, потом b), и круг не замыкается.
ERRORCHECK стоит включать в отладочной сборке: он превращает зависание
в код ошибки.
139.4 Условная переменная: очередь заданий
Мьютекс защищает данные, но не умеет ждать события «данные появились». Для этого — условная переменная в паре с мьютексом. Производитель кладёт задания в список, три потребителя разбирают:
static void *consumer(void *arg)
{
    int me = (int)(long)arg;
    for (;;) {
        pthread_mutex_lock(&qlock);
        while (!head && !done)                       /* while, не if: пробуждение не гарантирует данных */
            pthread_cond_wait(&qready, &qlock);      /* отпускает мьютекс на время ожидания */
        if (!head && done) { pthread_mutex_unlock(&qlock); return NULL; }
        struct job *j = head; head = j->next;
        pthread_mutex_unlock(&qlock);
        processed[me]++;                             /* работа — вне мьютекса */
        free(j);
    }
}
обработано: 2346 + 1 + 653 = 3000
Три правила, без которых очередь ломается:
- Ждать в цикле
while.pthread_cond_waitможет вернуться без сигнала (ложное пробуждение), и другой потребитель мог забрать задание первым — условие перепроверяют. cond_waitотпускает мьютекс на время сна и берёт обратно перед возвратом — поэтому его вызывают только с захваченным мьютексом.signalбудит одного,broadcast— всех. Закрывая очередь, ставят флагdoneпод мьютексом и делаютbroadcast, иначе двое из трёх потребителей уснут навсегда.
Распределение 2346/1/653 — не ошибка: потоки не обязаны делить работу поровну; кто проснулся первым, тот и забрал. Все 3000 обработаны, ни одно не потеряно и не обработано дважды.
139.5 rwlock, спин-блокировка, барьер
rwlock пускает много читателей одновременно и одного писателя в одиночестве. Четыре читателя по 200 000 чтений и писатель с 1000 записей по всей таблице — таблица после каждой записи однородна:
rwlock: 4 читателя × 200000, писатель 1000 записей; таблица цела: да
Выгоден, когда чтений много, а записей мало; при частых записях проигрывает мьютексу — читатели копятся в очереди перед каждой.
Спин-блокировка (pthread_spin_lock) не спит, а крутится в цикле,
пока не освободится. Оправдана только на многоядерной машине для
секций в десятки наносекунд; на одном ядре — вредна, поток крутится,
пока владелец не получит квант времени.
Барьер собирает count потоков: pthread_barrier_wait не возвращает,
пока не подошли все. В опыте пять потоков (четыре читателя и писатель)
стартуют в одну точку, чтобы измерение не зависело от порядка создания.
pthread_cond_t — 48 байт, pthread_rwlock_t — 56.
139.6 Свои данные у каждого потока
Глобальная переменная общая, локальная — только внутри функции. Между ними — данные потока: у каждого потока своя копия одной переменной.
static __thread int tls_counter; /* у каждого потока своя копия */
Каждый из четырёх читателей насчитал в ней 200 000, а у главного потока она осталась 0:
читатель: tls_counter = 200000, key = 0
главный поток: tls_counter = 0 (своя копия)
__thread (в C11 — _Thread_local, раздел 140) — статическое
объявление. Динамический вариант — ключи: pthread_key_create с функцией
освобождения, pthread_setspecific/pthread_getspecific; ключ создают
один раз на процесс через pthread_once. Так делают библиотеки, которым
нужна своя копия данных у каждого потока. errno в glibc устроен через
__thread, а strtok_r безопасен иначе: его состояние хранит вызывающий
в своей переменной (раздел 140.5).
Отмена и очистка. pthread_cancel останавливает поток в ближайшей
точке отмены, и перед смертью выполняются обработчики
pthread_cleanup_push — в обратном порядке. Они вызываются при отмене
и при pthread_exit, а при обычном ходе снимаются парным pthread_cleanup_pop
(с аргументом 1 — с вызовом). push и pop ставят парой в одной области
видимости; выходить через return между ними нельзя.
cleanup: освободить ресурсы отменённого потока
отменённый поток вернул PTHREAD_CANCELED: да
139.7 Сколько даёт параллельность: закон Амдала
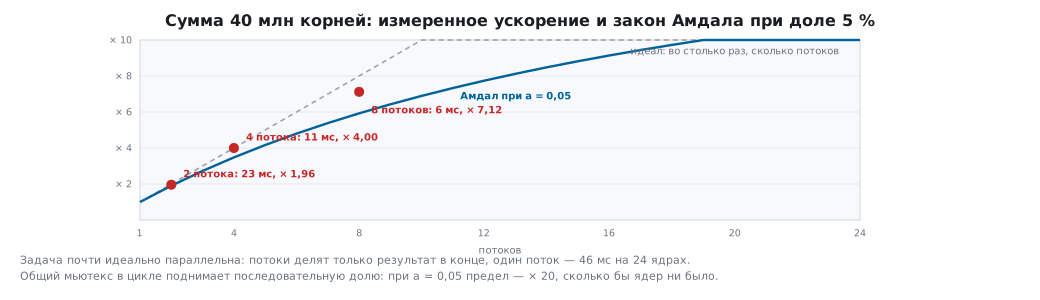
Если доля a работы не параллелится, p потоков ускоряют программу не
более чем в 1 / (a + (1 − a) / p) раз. Сумма 40 миллионов квадратных
корней на 24-ядерной машине:
ядер: 24; 1 поток: 46 мс
2 потоков: 23 мс, ускорение 1.96, Амдал при a=0,05: 1.90
4 потоков: 11 мс, ускорение 4.00, Амдал при a=0,05: 3.48
8 потоков: 6 мс, ускорение 7.12, Амдал при a=0,05: 5.93
Задача почти идеально параллельна — потоки не делят ничего, кроме
результата в конце, — и ускорение близко к числу потоков. Стоит
добавить общий мьютекс в цикл, как последовательная доля вырастет, и
восемь потоков дадут меньше, чем два. При a = 0,05 предел — 20 раз,
сколько бы ядер ни было.
139.8 Грабли
| Симптом | Причина |
|---|---|
| счётчик не сходится, каждый раз по-разному | гонка: ++ не атомарен; volatile не помогает |
гонка «исчезла» при -O2 |
компилятор свернул цикл; гонка осталась в настоящем коде |
| поток вернул мусор | вернул адрес своей локальной переменной |
| зависание, все потоки спят | взаимоблокировка: разный порядок захвата мьютексов |
| зависание в одном потоке на своём же мьютексе | повторный lock NORMAL-мьютекса; в отладке — ERRORCHECK |
| потребитель берёт пустую очередь | if вместо while вокруг cond_wait |
| потребители не просыпаются при закрытии | signal вместо broadcast, флаг done не под мьютексом |
cond_wait без мьютекса — падение или вечный сон |
вызывать только с захваченным мьютексом |
cleanup не вызван |
поток вышел через return, а не отменён |
| тысяча потоков — «не хватает памяти» | стек 8 МБ на поток; задать stacksize |
потомок после fork завис на мьютексе |
мьютекс держал другой поток, а его в потомке нет; до exec — только async-signal-safe |
| восемь потоков медленнее двух | общий мьютекс в цикле: последовательная доля выросла |
139.9 Итоги
- Поток: 46 мкс на создание против 116 у процесса; общая память, свой стек 8 МБ.
forkв многопоточной программе оставляет один поток, а чужие мьютексы — занятыми: сразуexecилиposix_spawn.- Гонка теряет приращения (в прогоне — больше половины); мьютекс — 178 мс, атомарная
операция — 35 мс;
volatileне защита. - Мьютексы брать в одном порядке;
ERRORCHECKиtimedlockдля отладки. - Условная переменная:
while, с мьютексом,broadcastпри закрытии. - rwlock — много читателей; барьер — общий старт;
__thread— своя копия. - Закон Амдала: при 5 % последовательной части предел — 20 раз.
Полные исходники
race_mutex.c — счётчик из четырёх потоков без защиты, с мьютексом и с атомарным сложением.
/* Раздел 139: счётчик из четырёх потоков — без мьютекса, с мьютексом, с атомарным сложением;
   время каждого варианта. */
#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>
#include <stdatomic.h>
#include <time.h>

#define N 1000000
static volatile long plain;                  /* volatile: чтобы -O2 не свернул цикл в одно сложение */
static long guarded;
static atomic_long atomic_cnt;
static pthread_mutex_t mx = PTHREAD_MUTEX_INITIALIZER;

static void *f_plain(void *a)   { (void)a; for (int i = 0; i < N; i++) plain++; return NULL; }
static void *f_mutex(void *a)   { (void)a; for (int i = 0; i < N; i++) { pthread_mutex_lock(&mx); guarded++; pthread_mutex_unlock(&mx); } return NULL; }
static void *f_atomic(void *a)  { (void)a; for (int i = 0; i < N; i++) atomic_fetch_add(&atomic_cnt, 1); return NULL; }

static double run4(void *(*fn)(void *))
{
    struct timespec t0, t1;
    pthread_t th[4];
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int k = 0; k < 4; k++) pthread_create(&th[k], NULL, fn, NULL);
    for (int k = 0; k < 4; k++) pthread_join(th[k], NULL);
    clock_gettime(CLOCK_MONOTONIC, &t1);
    return (t1.tv_sec - t0.tv_sec) * 1e3 + (t1.tv_nsec - t0.tv_nsec) / 1e6;
}

int main(void)
{
    double a = run4(f_plain), b = run4(f_mutex), c = run4(f_atomic);
    printf("4 потока × %d приращений:\n", N);
    printf("  без защиты: %ld (потеряно %ld), %.0f мс\n", plain, 4L * N - plain, a);
    printf("  мьютекс:    %ld, %.0f мс\n", guarded, b);
    printf("  atomic:     %ld, %.0f мс\n", atomic_load(&atomic_cnt), c);
    return 0;
}
deadlock.c — взаимоблокировка двух потоков и её обнаружение.
/* Раздел 139: взаимоблокировка двух потоков на двух мьютексах и её обнаружение:
   pthread_mutex_timedlock вместо вечного ожидания; ERRORCHECK ловит повторный захват. */
#include <stdio.h>
#include <string.h>
#include <pthread.h>
#include <time.h>
#include <errno.h>
#include <unistd.h>

static pthread_mutex_t a = PTHREAD_MUTEX_INITIALIZER, b = PTHREAD_MUTEX_INITIALIZER;
static pthread_barrier_t bar;   /* оба потока держат свой первый мьютекс, прежде чем тянуться ко второму */
static pthread_barrier_t done;  /* и отпускают его, только когда оба получили ответ timedlock */

static int lock_with_timeout(pthread_mutex_t *m, int ms)
{
    struct timespec ts; clock_gettime(CLOCK_REALTIME, &ts);
    ts.tv_nsec += ms * 1000000L; ts.tv_sec += ts.tv_nsec / 1000000000L; ts.tv_nsec %= 1000000000L;
    return pthread_mutex_timedlock(m, &ts);
}

static void *t1(void *x)
{
    (void)x;
    pthread_mutex_lock(&a); usleep(50000);                 /* держим a, тянемся к b */
    pthread_barrier_wait(&bar);                            /* без барьера под нагрузкой поток 1 успевал взять оба */
    int r = lock_with_timeout(&b, 500);
    printf("поток 1: a взят, b: %s\n", r ? strerror(r) : "взят");
    pthread_barrier_wait(&done);                           /* иначе a освобождался раньше срока потока 2 */
    if (!r) pthread_mutex_unlock(&b);
    pthread_mutex_unlock(&a);
    return NULL;
}

static void *t2(void *x)
{
    (void)x;
    pthread_mutex_lock(&b); usleep(50000);                 /* держим b, тянемся к a — круг замкнулся */
    pthread_barrier_wait(&bar);
    int r = lock_with_timeout(&a, 500);
    printf("поток 2: b взят, a: %s\n", r ? strerror(r) : "взят");
    pthread_barrier_wait(&done);
    if (!r) pthread_mutex_unlock(&a);
    pthread_mutex_unlock(&b);
    return NULL;
}

int main(void)
{
    pthread_t x, y;
    pthread_barrier_init(&bar, NULL, 2);
    pthread_barrier_init(&done, NULL, 2);
    pthread_create(&x, NULL, t1, NULL); pthread_create(&y, NULL, t2, NULL);
    pthread_join(x, NULL); pthread_join(y, NULL);

    pthread_mutexattr_t at; pthread_mutexattr_init(&at);
    pthread_mutexattr_settype(&at, PTHREAD_MUTEX_ERRORCHECK);
    pthread_mutex_t e; pthread_mutex_init(&e, &at);
    pthread_mutex_lock(&e);
    int r = pthread_mutex_lock(&e);                  /* повторный захват тем же потоком */
    printf("ERRORCHECK, второй lock из того же потока: %s\n", strerror(r));
    pthread_mutex_unlock(&e); r = pthread_mutex_unlock(&e);
    printf("ERRORCHECK, лишний unlock: %s\n", strerror(r));
    return 0;
}
cond_queue.c — очередь заданий на мьютексе и условной переменной.
/* Раздел 139: очередь заданий — производитель и три потребителя на мьютексе и условной
   переменной; ожидание в цикле while, ложные пробуждения безопасны. */
#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>
#include <unistd.h>

struct job { struct job *next; int id; };
static struct job *head;
static int done, processed[3];
static pthread_mutex_t qlock = PTHREAD_MUTEX_INITIALIZER;
static pthread_cond_t qready = PTHREAD_COND_INITIALIZER;

static void *consumer(void *arg)
{
    int me = (int)(long)arg;
    for (;;) {
        pthread_mutex_lock(&qlock);
        while (!head && !done)                       /* while, не if: пробуждение не гарантирует данных */
            pthread_cond_wait(&qready, &qlock);      /* отпускает мьютекс на время ожидания */
        if (!head && done) { pthread_mutex_unlock(&qlock); return NULL; }
        struct job *j = head; head = j->next;
        pthread_mutex_unlock(&qlock);
        processed[me]++;                             /* работа — вне мьютекса */
        free(j);
    }
}

int main(void)
{
    pthread_t th[3];
    for (long k = 0; k < 3; k++) pthread_create(&th[k], NULL, consumer, (void *)k);
    for (int i = 0; i < 3000; i++) {
        struct job *j = malloc(sizeof *j); j->id = i;
        pthread_mutex_lock(&qlock);
        j->next = head; head = j;
        pthread_mutex_unlock(&qlock);
        pthread_cond_signal(&qready);                /* разбудить одного */
    }
    pthread_mutex_lock(&qlock); done = 1; pthread_mutex_unlock(&qlock);
    pthread_cond_broadcast(&qready);                 /* разбудить всех: очередь закрыта */
    for (int k = 0; k < 3; k++) pthread_join(th[k], NULL);
    printf("обработано: %d + %d + %d = %d\n", processed[0], processed[1], processed[2],
           processed[0] + processed[1] + processed[2]);
    return 0;
}
Дальше: раздел 140 — потоки и атомарные операции C11, OpenMP.