 Embedded HandbookПриложения
140. Потоки C11, атомарные операции и OpenMP
Потоки POSIX — стандарт операционной системы, а не языка. C11 внёс в
сам язык три вещи: потоки <threads.h>, атомарные типы <stdatomic.h>
и класс хранения _Thread_local. Первое — тонкая обёртка над pthread,
второе — то, на чём стоят все блокировки, третье — свои данные у
потока без функций. Плюс OpenMP: способ распараллелить цикл одной
строкой, не написав ни одного create и join. Всё — в опытах
_verify/sys140/, stm-sys:1, gcc 12.
Атомарные операции — та же тема, что в разделе 124 для прерываний на микроконтроллере; здесь они разобраны с другой стороны: как на них строится блокировка и что такое порядок памяти при нескольких ядрах.
Как это называется в документации
Оригинал Перевод thrd_t,mtx_t,cnd_tпоток, мьютекс, условная переменная C11 atomic operation атомарная операция: неделимая для других потоков lock-free без блокировки compare-and-swap (CAS), compare-exchange сравнить и обменять memory order порядок памяти relaxed, acquire, release, seq_cst ослабленный, захват, освобождение, полный порядок memory fence барьер памяти thread-local локальный для потока reentrant реентерабельная: можно вызвать заново, не дожидаясь конца thread-safe безопасна для потоков reduction свёртка: сложение частных результатов потоков
140.1 Потоки C11
Те же понятия, что в pthread, другие имена и ошибки кодами
thrd_success/thrd_error вместо errno:
| POSIX | C11 |
|---|---|
pthread_create(&t, NULL, f, arg) |
thrd_create(&t, f, arg) — f возвращает int |
pthread_join(t, &p) |
thrd_join(t, &res) |
pthread_detach, pthread_exit, pthread_self |
thrd_detach, thrd_exit, thrd_current |
sched_yield, nanosleep |
thrd_yield, thrd_sleep |
pthread_mutex_t, _lock, _unlock, _trylock, _timedlock |
mtx_t, mtx_lock, mtx_unlock, mtx_trylock, mtx_timedlock |
pthread_cond_t, _wait, _signal, _broadcast |
cnd_t, cnd_wait, cnd_signal, cnd_broadcast |
pthread_once |
call_once |
pthread_key_* |
tss_create, tss_get, tss_set |
    for (long k = 0; k < 4; k++)
        if (thrd_create(&th[k], worker, (void *)k) != thrd_success) { puts("thrd_create"); return 1; }
    for (int k = 0; k < 4; k++) { thrd_join(th[k], &res); printf("thrd_join поток %d вернул %d\n", k, res); }
Мьютекс создают mtx_init(&mx, mtx_plain); mtx_timed разрешает
mtx_timedlock, mtx_recursive — вложенный захват. В glibc это те же
40 байт, что pthread_mutex_t. В контейнере заголовок threads.h есть
(glibc с 2.28), собирается с -std=c11 -lpthread. Атрибутов потока
(стек, приоритет) в C11 нет, отмены нет, барьеров и rwlock нет — когда
они нужны, берут pthread.
140.2 Атомарные типы
_Atomic int или atomic_int — переменная, каждая операция над
которой неделима: ++, +=, присваивание и чтение, — и два потока не
потеряют приращение. Как это сделано, зависит от процессора. На x86-64
++ — одна команда с префиксом lock (lock addl), а чтение — обычная
mov. На Cortex-M3 и M4 — петля LDREX/STREX (раздел 124.5). У
Cortex-M0 таких команд нет, и ++ становится вызовом библиотеки: у GCC —
__atomic_fetch_add_4, у armclang — __sync_fetch_and_add_4. Готовой
неделимости библиотеки для голого камня не дают: у GCC и у microlib
armclang этой функции нет вовсе, а стандартная библиотека armclang просит
взамен __user_cmpxchg_4. Недостающее прошивка пишет сама, запретом
прерываний. Явные функции — atomic_load, atomic_store,
atomic_fetch_add, atomic_fetch_or, atomic_exchange,
atomic_compare_exchange_*. Четыре потока по 200 000 раз:
        atomic_fetch_add_explicit(&acnt, 1, memory_order_relaxed);   /* атомарно */
        plain++;                                                       /* гонка */
        mtx_lock(&mx); guarded++; mtx_unlock(&mx);                     /* мьютекс C11 */
        while (atomic_flag_test_and_set_explicit(&spin, memory_order_acquire)) ;   /* спин */
        spin_guarded++;
        atomic_flag_clear_explicit(&spin, memory_order_release);
atomic 800000, мьютекс 800000, спин 800000, без защиты 789678 (потеряно 10322), mine в main 0
atomic_int lock-free: 1; sizeof mtx_t 40
atomic_is_lock_free отвечает, реализован ли тип командой процессора
(1) или скрытой блокировкой (0): atomic_int на x86-64 — без
блокировки, структура из 32 байт — уже нет. atomic_flag — единственный
тип, который обязан быть lock-free везде; на нём написана
спин-блокировка из четырёх строк выше.
_Thread_local — то же, что __thread в разделе 139: у каждого
потока своя копия mine, и в main она осталась нулём.
140.3 Compare-and-swap: как устроен замок
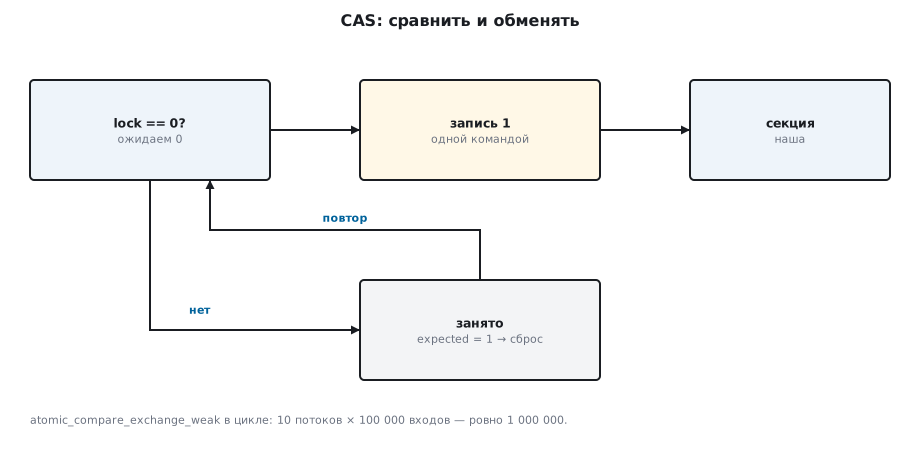
Все мьютексы, семафоры и очереди без блокировок стоят на одной
команде: сравнить и обменять. atomic_compare_exchange_weak(&v,
&expected, desired) атомарно проверяет, равно ли v значению
expected; если да — записывает desired и возвращает истину; если
нет — кладёт в expected то, что нашла, и возвращает ложь. Замок:
        int expected = 0;
        while (!atomic_compare_exchange_weak(&lock, &expected, 1))   /* если lock == 0 — ставим 1 */
            expected = 0;                                            /* иначе expected стал 1 — сбросить и повторить */
        lock_count++;                                                /* критическая секция */
        atomic_store(&lock, 0);
CAS-замок: 10 потоков × 100000 = 1000000
Десять потоков, миллион входов в критическую секцию, ни одного
потерянного. weak может ложно вернуть ложь (на некоторых
архитектурах), поэтому он стоит в цикле; strong — без ложных отказов,
но дороже. Так же устроены счётчики ссылок, стек без блокировок и
futex в glibc: быстрый путь — CAS в пользовательском режиме, в ядро —
только когда замок занят.
140.4 Порядок памяти
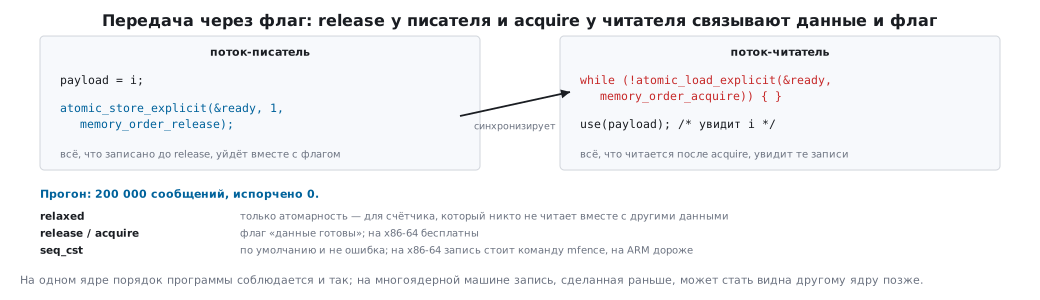
Своей программе одно ядро всегда показывает её обращения по порядку. Но компилятор переставляет обычные обращения к памяти и на одноядерном микроконтроллере, а другие участники шины — DMA и периферия — могут увидеть записи в другом порядке: у Cortex-M7 — из-за буфера записи и кэша (раздел 124.6). На многоядерной машине переставляет и сам процессор: запись, сделанная раньше в коде, может стать видна другому ядру позже. Отсюда второй параметр атомарных функций — порядок памяти:
| Порядок | Что обещает |
|---|---|
memory_order_relaxed |
только атомарность; порядок относительно других обращений — никакой |
memory_order_release (запись) |
всё, что записано до неё, видно потоку, который прочитает её с acquire |
memory_order_acquire (чтение) |
всё, что читается после неё, увидит записи до парной release |
memory_order_acq_rel |
и то и другое (для read-modify-write) |
memory_order_seq_cst |
полный единый порядок для всех потоков; по умолчанию |
Передача сообщения через флаг: писатель кладёт данные, потом поднимает
флаг с release; читатель ждёт флага с acquire и только потом читает
данные:
        payload = i;
        atomic_store_explicit(&ready, 1, memory_order_release);                 /* всё до этого видно после acquire */
release/acquire: 200000 сообщений, испорчено 0
Счётчик, который никто не читает вместе с другими данными, — relaxed:
самый дешёвый, и достаточный (так в первом опыте). Флаг «данные готовы» —
пара release/acquire. Всё остальное — seq_cst, он по умолчанию и
он не ошибка, только дороже на ARM и слабых моделях памяти; на x86-64
acquire/release бесплатны, а seq_cst стоит команду mfence при
записи. Барьер без переменной — atomic_thread_fence(order). В разделе
124 те же барьеры стояли перед запуском DMA: __DMB — это
atomic_thread_fence на языке Cortex-M.
140.5 Реентерабельность и потокобезопасность
Функция реентерабельна, если её можно вызвать заново, пока
предыдущий вызов не закончился, — из обработчика сигнала или
прерывания. Функция потокобезопасна, если её могут звать несколько
потоков одновременно. Это разные свойства: malloc потокобезопасен
(внутри мьютекс), но не реентерабелен — вызов из обработчика сигнала
посреди malloc попадёт на занятый мьютекс. Нереентерабельными делают
статические буферы: strtok, localtime, getenv в старом виде;
их _r-варианты (strtok_r, localtime_r) получают буфер от
вызывающего. POSIX перечисляет функции, которые могут быть
небезопасны для потоков; всё остальное в стандартной библиотеке
обязано быть безопасным.
140.6 OpenMP: параллельный цикл одной директивой
OpenMP — набор директив #pragma omp и библиотека; компилятор сам
создаёт потоки и делит цикл между ними. Ключ -fopenmp, версия в
контейнере — _OPENMP 201511 (OpenMP 4.5):
    #pragma omp parallel for reduction(+:r)          /* у каждого потока своя копия r, в конце сложение */
    for (long i = 0; i < TOTAL; i++) r += sqrt((double)i);
последовательно: 46 мс
parallel for reduction: 10 мс, потоков 24, ускорение 4.5, сумма та же: да
без reduction: cnt = 666665 из 4000000
с omp atomic: cnt = 4000000
reduction(+:r) — главное слово: без него r общая, и потоки
устраивают ту же гонку, что и везде: счётчик без reduction в худшем
из 20 прогонов досчитал до 666 665 из 4 000 000. Проявляется гонка не
каждый раз: если потоки успели отработать свои куски по очереди, потерь
нет — поэтому опыт повторяется. #pragma omp atomic перед cnt++ чинит
это ценой скорости, #pragma omp critical — секция под мьютексом.
Число потоков — переменная OMP_NUM_THREADS или num_threads(3) в
директиве; omp_get_thread_num и omp_get_num_threads — кто я и
сколько нас. С четырьмя потоками ускорение 3,9 — как у ручных потоков
в разделе 139; с 24 потоками на той же задаче — всего 4,5, хотя ядер в
машине опыта 24 и гиперпотоков нет. Задача на 46 мс мала: на 24 потока это
куски по 2 мс, и запуск потоков, ожидание самого медленного и соседние
процессы съедают заметную долю. Повторные прогоны это показывают: 8 потоков
дают ускорение 6,5–7, 24 — 6,4–7,3, а 12 и 16 пляшут от 4 до 12 раз.
Ускорение меряют на задаче подлиннее и берут лучшее из нескольких прогонов.
OpenMP уместен для счётных циклов по массивам — обработки сигналов, матриц, изображений; для сервера с соединениями нужны обычные потоки или дескрипторы событий (раздел 141).
140.7 Грабли
| Симптом | Причина |
|---|---|
threads.h не найден |
старая glibc (до 2.28) или Windows без C11-потоков |
mtx_timedlock возвращает thrd_error |
мьютекс создан mtx_plain; нужен mtx_timed |
atomic_is_lock_free = 0 на структуре |
тип больше слова процессора — внутри скрытая блокировка |
| CAS в цикле «крутится вечно» | expected не сбрасывают после неудачи |
| данные за флагом иногда старые | relaxed на флаге; нужна пара release/acquire |
| функция падает из обработчика сигнала | потокобезопасна, но не реентерабельна (malloc, printf) |
| OpenMP-цикл считает неверно | общая переменная без reduction, private или atomic |
| 24 потока ускоряют не больше, чем 8 | задача мала: куски по 2 мс, время пляшет от прогона к прогону — мерить на задаче длиннее |
140.8 Итоги
- C11:
thrd_*,mtx_*,cnd_*,call_once,tss_*— обёртка надpthread, без атрибутов, отмены и rwlock. _Atomic: 800 000 из 800 000 против потерь без защиты;atomic_flagвсегда без блокировки;atomic_is_lock_free— проверка типа.- CAS-замок: 10 × 100 000 = 1 000 000;
weak— в цикле. - Порядок памяти:
relaxedдля счётчиков,release/acquireдля флага,seq_cstпо умолчанию. - Реентерабельность ≠ потокобезопасность:
malloc— второе, не первое. - OpenMP:
parallel for reduction,atomic,critical; безreduction— гонка.
Полные исходники
c11_threads.c — потоки, мьютексы и атомарные операции C11, _Thread_local, спин-блокировка.
/* Раздел 140: потоки и мьютексы C11 (<threads.h>), атомарные операции (<stdatomic.h>),
   _Thread_local, спин-блокировка на compare-and-exchange, thrd_sleep. */
#include <stdio.h>
#include <stdlib.h>
#include <threads.h>
#include <stdatomic.h>
#include <time.h>

#define N 200000
static atomic_int acnt;
static int plain;
static mtx_t mx;
static int guarded;
static _Thread_local int mine;                       /* своя копия у каждого потока */
static atomic_flag spin = ATOMIC_FLAG_INIT;
static int spin_guarded;

static int worker(void *arg)
{
    for (int i = 0; i < N; i++) {
        atomic_fetch_add_explicit(&acnt, 1, memory_order_relaxed);   /* атомарно */
        plain++;                                                       /* гонка */
        mtx_lock(&mx); guarded++; mtx_unlock(&mx);                     /* мьютекс C11 */
        while (atomic_flag_test_and_set_explicit(&spin, memory_order_acquire)) ;   /* спин */
        spin_guarded++;
        atomic_flag_clear_explicit(&spin, memory_order_release);
        mine++;
    }
    printf("поток %d: _Thread_local mine = %d\n", (int)(long)arg, mine);
    return (int)(long)arg * 10;
}

int main(void)
{
    thrd_t th[4]; int res;
    mtx_init(&mx, mtx_plain);
    for (long k = 0; k < 4; k++)
        if (thrd_create(&th[k], worker, (void *)k) != thrd_success) { puts("thrd_create"); return 1; }
    for (int k = 0; k < 4; k++) { thrd_join(th[k], &res); printf("thrd_join поток %d вернул %d\n", k, res); }
    printf("atomic %d, мьютекс %d, спин %d, без защиты %d (потеряно %d), mine в main %d\n",
           atomic_load(&acnt), guarded, spin_guarded, plain, 4 * N - plain, mine);
    printf("atomic_int lock-free: %d; sizeof mtx_t %zu\n", atomic_is_lock_free(&acnt), sizeof(mtx_t));
    struct timespec t0, t1;
    timespec_get(&t0, TIME_UTC);
    thrd_sleep(&(struct timespec){ .tv_nsec = 200000000 }, NULL);
    timespec_get(&t1, TIME_UTC);
    printf("thrd_sleep 200 мс: прошло %ld мс\n", (t1.tv_sec - t0.tv_sec) * 1000 + (t1.tv_nsec - t0.tv_nsec) / 1000000);
    mtx_destroy(&mx);
    return 0;
}
cas_order.c — замок на compare-and-exchange и порядок памяти release/acquire против relaxed.
/* Раздел 140: compare-and-exchange (CAS) как основа блокировок без ядра, и порядок памяти:
   передача данных через флаг с release/acquire против relaxed. */
#include <stdio.h>
#include <stdatomic.h>
#include <threads.h>

static atomic_int lock;
static int lock_count;

static int locker(void *a)
{
    (void)a;
    for (int i = 0; i < 100000; i++) {
        int expected = 0;
        while (!atomic_compare_exchange_weak(&lock, &expected, 1))   /* если lock == 0 — ставим 1 */
            expected = 0;                                            /* иначе expected стал 1 — сбросить и повторить */
        lock_count++;                                                /* критическая секция */
        atomic_store(&lock, 0);
    }
    return 0;
}

/* Передача сообщения через флаг: писатель кладёт данные, потом поднимает флаг;
   читатель ждёт флага и читает данные. С relaxed порядок не гарантирован. */
static int payload;
static atomic_int ready;
static long bad;

static int writer(void *a) { (void)a; for (int i = 1; i <= 200000; i++) {
        while (atomic_load_explicit(&ready, memory_order_acquire)) ;            /* ждём, пока читатель заберёт */
        payload = i;
        atomic_store_explicit(&ready, 1, memory_order_release);                 /* всё до этого видно после acquire */
    } return 0; }
static int reader(void *a) { (void)a; for (int i = 1; i <= 200000; i++) {
        while (!atomic_load_explicit(&ready, memory_order_acquire)) ;
        if (payload != i) bad++;
        atomic_store_explicit(&ready, 0, memory_order_release);
    } return 0; }

int main(void)
{
    thrd_t t[10];
    for (int k = 0; k < 10; k++) thrd_create(&t[k], locker, NULL);
    for (int k = 0; k < 10; k++) thrd_join(t[k], NULL);
    printf("CAS-замок: 10 потоков × 100000 = %d\n", lock_count);
    thrd_t w, r;
    thrd_create(&w, writer, NULL); thrd_create(&r, reader, NULL);
    thrd_join(w, NULL); thrd_join(r, NULL);
    printf("release/acquire: 200000 сообщений, испорчено %ld\n", bad);
    printf("порядки: relaxed %d, acquire %d, release %d, acq_rel %d, seq_cst %d\n",
           memory_order_relaxed, memory_order_acquire, memory_order_release, memory_order_acq_rel, memory_order_seq_cst);
    return 0;
}
Дальше: раздел 141 — неблокирующий ввод-вывод и epoll.