 Embedded HandbookПриложения
16б. Приём UART без потерь: DMA в кольцо, IDLE и половина буфера
В разделе 16.5 схема «DMA складывает байты в кольцо, а пауза в линии
зовёт разбор» описана словами. В разделе 5а.5 та же задача решена
обёрткой HAL ReceiveToIdle в обычном режиме DMA: принять порцию,
разобрать, запустить заново. Здесь — кольцевой режим целиком своим
кодом: позиция записи по счётчику NDTR, три события (половина кольца,
конец кольца, пауза), разбор кадров прямо в кольце без копирования,
размер кольца от скорости и худшей задержки обработчика и переполнение —
и кольца, и приёмника (ORE).
Опоры: справочные руководства RM0008 (F1: DMA — 13.3, USART — 27.3–27.6)
и RM0090 (F4: DMA — 10.3–10.5, USART — 30.3–30.6), заголовки CMSIS из
паков Keil, даташит STM32F103x8/xB (объём ОЗУ), HAL F4 из пака Keil
2.17.1 и HAL F1 1.8.7 из архива STM32Cube. Сам разбор (uring.c) прогнан на компьютере против модели
«USART + DMA по кругу» на потоке из 20 000 кадров со случайными паузами и
длинами и тот же прогон — в QEMU на Cortex-M4. Код для F103 и F407
собран armclang.
Как это называется в документации
Оригинал Перевод circular mode ( CIRC)кольцевой режим DMA number of data to transfer ( CNDTR,SxNDTR)счётчик оставшихся передач half transfer ( HTIF,HTIE)пройдена половина transfer complete ( TCIF,TCIE)пройден конец idle line detected ( IDLE,IDLEIE)пауза в линии overrun error ( ORE)переполнение приёмника error interrupt enable ( EIE)прерывание по ошибкам при приёме через DMA DMA enable receiver ( DMAR)запросы DMA от приёмника direct mode ( DMDIS= 0)прямой режим потока, без FIFO reception to idle ( ReceiveToIdle)приём до паузы — обёртка HAL
16б.1 Кольцо, в которое пишет DMA
Канал DMA настроен «из регистра данных USART в память» с приращением
адреса памяти и битом CIRC. На каждый принятый байт он переносит его в
кольцо и уменьшает счётчик. Дойдя до нуля, счётчик в кольцевом режиме сам
загружается прежним значением, и запись идёт снова с начала — так
описывают кольцевой режим оба руководства (RM0008, 13.3.3; RM0090,
10.3.8). Настроили один раз — канал принимает вечно.
Сколько байт уже в кольце, говорит сам счётчик: пока канал включён,
CNDTR у F1 и SxNDTR у F4 только читаются и показывают, сколько
передач осталось до конца круга. Отсюда позиция, куда DMA положит
следующий байт:
wr = size − NDTR
Вторую позицию — докуда разобрано — ведёт программа (rd). Всё между
rd и wr по кругу и есть неразобранное. Больше ничего не нужно: ни
счётчика принятых байт, ни перезапуска канала.
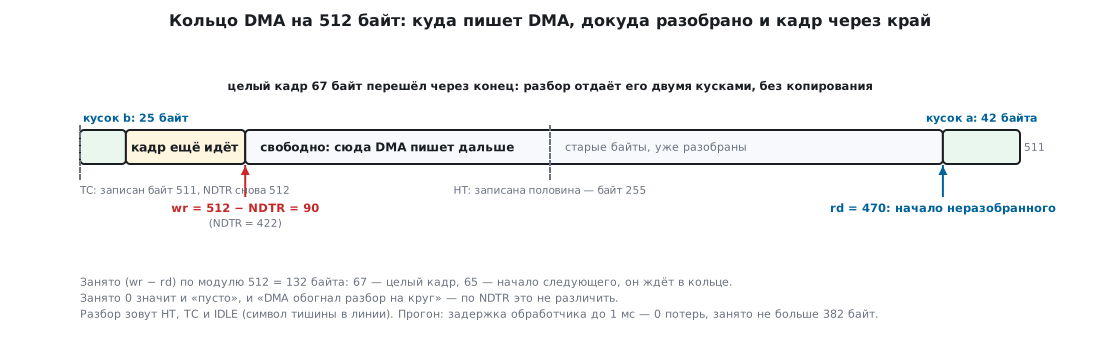
У этой пары указателей один слепой случай: wr = rd. Так выглядит и
пустое кольцо, и кольцо, которое DMA прошёл целиком, пока разбор спал.
По счётчику их не различить — поэтому размер кольца считают так, чтобы
второго случая не было (16б.5).
16б.2 Три события: половина, конец и пауза
Разбор надо позвать вовремя. Поводов три.
Половина кольца (HT) и конец кольца (TC) — прерывания самого
канала DMA: флаг HTIF поднимается, когда передана половина, TCIF —
когда передан последний элемент (RM0008, 13.3.3; RM0090, 10.3.17). В
сплошном потоке без пауз они приходят через каждые size/2 байт и не
дают кольцу переполниться.
Пауза в линии (IDLE) — флаг USART: линия молчала целый символ
после последнего байта (RM0008, 27.3.1: «idle character» — целый кадр
единиц). Поднимается один раз на паузу: снова он встанет только после
нового принятого байта (примечание к биту IDLE). Он отдаёт хвост
сообщения сразу, не дожидаясь половины кольца.
Что будет без одного из них, показал прогон uring_sim.c: 921 600 бод,
20 000 кадров, всего 715 183 байта, обработчик запускается через
случайную задержку от 0 до 1000 мкс после события:
| События | Кольцо | Принято кадров | Затёрто байт | Наибольшая занятость | Наибольшая задержка кадра |
|---|---|---|---|---|---|
| HT + TC + IDLE | 512 | 20 000 | 0 | 382 | 3428 мкс |
| только IDLE | 512 | 19 801 | 877 | 501 | 5982 мкс |
| только IDLE | 2048 | 20 000 | 0 | 695 | 7156 мкс |
| только HT + TC | 512 | 19 994 | 0 | 401 | 61 320 мкс |
Только IDLE теряет кадры, как только кадры идут вплотную дольше, чем помещается в кольцо: пауз нет — разбор не зовут. Помогает лишь кольцо больше самой длинной пачки, а её длину заранее обычно не знают. Только HT и TC не теряет ни байта, но кадр перед паузой ждёт, пока DMA не дойдёт до следующей половины: до 61 320 мкс в прогоне, а шесть последних кадров так и не отданы — событий больше нет. Все три вместе — 0 потерь и задержка не больше 3428 мкс.
Эта задержка — не ошибка. В сплошном потоке пауз нет, и кадр ждёт ближайшей половины кольца плюс задержку обработчика: для 512 байт это 2778 + 1000 = 3778 мкс сверху. Нужна меньшая — уменьшают кольцо или разбирают ещё и по таймеру.
16б.3 🔧 Код: F103 и F407
USART1 принимает на 921 600 бод. У F103 его запросы приёма обслуживает
канал 5 DMA1 (RM0008, таблица 78), у F407 — поток 2 или 5 DMA2 на
канале 4 (RM0090, таблица 43); здесь взят поток 2. Делитель
BRR одинаково даёт 923 077 бод, ошибка +0,16 %:
| Камень | Тактовая USART1 | BRR |
DMA |
|---|---|---|---|
| STM32F103 | APB2 72 МГц | 0x4E (4 + 14/16) | DMA1, канал 5 |
| STM32F407 | APB2 84 МГц | 0x5B (5 + 11/16) | DMA2, поток 2, канал 4 |
Код для F103 (uring_f103.c):
    uring_init(&rx, rx_buf, RX_SIZE, app_frame);
    DMA1_Channel5->CCR = 0;                     /* канал выключен: только так пишутся CNDTR и адреса */
    DMA1_Channel5->CPAR = (uint32_t)&USART1->DR;
    DMA1_Channel5->CMAR = (uint32_t)rx_buf;
    DMA1_Channel5->CNDTR = RX_SIZE;
    DMA1->IFCR = DMA_IFCR_CGIF5;
    DMA1_Channel5->CCR = DMA_CCR5_MINC | DMA_CCR5_CIRC | DMA_CCR5_HTIE | DMA_CCR5_TCIE | DMA_CCR5_EN;

    USART1->BRR = 78u;                          /* 72 МГц / 78 = 923 077 бод: +0,16 % */
    USART1->CR3 = USART_CR3_DMAR | USART_CR3_EIE;
    USART1->CR1 = USART_CR1_UE | USART_CR1_RE | USART_CR1_IDLEIE;
Направление «из периферии в память» и байтовые размеры — нули в CCR,
их не пишут. DMAR включает запросы DMA от приёмника, EIE —
прерывание по ошибкам кадра, шума и переполнения, которое при приёме
через DMA иначе не придёт (RM0008, таблица 196: EIE нужен только при
приёме через DMA). Обработчики:
static void rx_poll(void)
{
    uring_poll(&rx, (uint16_t)DMA1_Channel5->CNDTR);
}

void DMA1_Channel5_IRQHandler(void)             /* HT или TC: пройдена половина или конец кольца */
{
    DMA1->IFCR = DMA_IFCR_CGIF5;
    rx_poll();
}

void USART1_IRQHandler(void)
{
    uint32_t sr = USART1->SR;
    if (sr & USART_SR_ORE)
        uart_ore++;
    /* IDLE, ORE, NE, FE снимает пара «чтение SR, затем DR». При RXNE = 1 байт ещё ждёт DMA:
       его не трогаем, флаг снимется при следующем входе */
    if ((sr & (USART_SR_IDLE | USART_SR_ORE | USART_SR_NE | USART_SR_FE)) && !(sr & USART_SR_RXNE))
        (void)USART1->DR;
    if (sr & USART_SR_IDLE)
        rx_poll();
}
Оба прерывания стоят на одном приоритете (5): разбор не может прервать
сам себя, и общий rx не нужно защищать. В листинге armclang настройка
сводится к записям CCR = 0xA7, CR3 = 0x41 и CR1 = 0x2014; адрес
регистра данных USART1 в CPAR — 0x40013804.
У F407 (uring_f407.c) отличий три. Поток перед настройкой выключают и
ждут, пока EN станет нулём, — он гаснет не сразу. Флаги потока
сбрасывают в LIFCR до включения прерываний: иначе поднятый с прошлого
раза флаг сразу даст прерывание (RM0090, 10.4). И FIFO потока не
включают:
    DMA2_Stream2->FCR = 0;                      /* прямой режим, без FIFO */
    DMA2->LIFCR = S2_FLAGS;                     /* старые флаги иначе сразу дадут прерывание */
    DMA2_Stream2->CR = (4u << DMA_SxCR_CHSEL_Pos) | DMA_SxCR_MINC | DMA_SxCR_CIRC
                     | DMA_SxCR_HTIE | DMA_SxCR_TCIE | DMA_SxCR_EN;
В листинге это LIFCR = 0x3D0000 (пять флагов потока 2) и SxCR =
0x08000519; PAR — 0x40011004, регистр данных USART1 у F407.
16б.4 Разбор кадров прямо в кольце
Кадр в примере: 0x55, длина (1…64), данные, сумма — дополнение суммы
длины и данных. Самый длинный кадр — 67 байт. Разбор (uring.c) идёт от
rd к wr и не копирует ничего:
void uring_poll(uring_t *r, uint16_t ndtr)
{
    uint16_t wr = (uint16_t)(r->size - ndtr);          /* куда DMA положит следующий байт */
    if (wr >= r->size)                                 /* NDTR = 0 в миг перезагрузки */
        wr = 0;
    uint16_t used = (uint16_t)(wr >= r->rd ? wr - r->rd : wr + r->size - r->rd);
    if (used > r->hiwater)
        r->hiwater = used;
Дальше в цикле: не 0x55 или длина вне 1…64 — сдвиг на байт (поиск
начала); кадр пришёл не весь — выход, rd остаётся на его начале; сумма
не сошлась — сдвиг на байт; иначе кадр отдаётся обратному вызову и rd
прыгает за него. Кадр, перешедший через конец кольца, отдаётся двумя
кусками — «до конца кольца» и «с начала»:
        uint16_t s = idx(r, 2);                        /* данные: кусок до конца кольца и остаток */
        uint16_t n1 = (uint16_t)(r->size - s < len ? r->size - s : len);
        r->on_frame(&r->buf[s], n1, n1 < len ? r->buf : 0, (uint16_t)(len - n1));
Такой разбор не делит на размер кольца (индекс поправляется вычитанием), поэтому кольцо не обязано быть степенью двойки. Цена «без копирования» видна в 16б.5: пока кадр не пришёл целиком, его начало занимает место в кольце. И обратный вызов должен успеть воспользоваться данными до выхода: указатели смотрят в кольцо, которое DMA скоро перепишет.
hiwater — наибольшая занятость кольца, какую видел разбор. Это дешёвый
датчик запаса: в прогоне с кольцом 512 и задержкой до 1000 мкс она
дошла до 382.
16б.5 Размер кольца: скорость и худшая задержка
На 921 600 бод при 8N1 символ длится 10,85 мкс — 92 160 байт в секунду.
Кольцо не теряет данных, пока DMA не догоняет rd. К моменту разбора в
кольце может лежать начало недошедшего кадра — до 66 байт — плюс всё, что
пришло с прошлого запуска. А занять все size байт нельзя: тогда wr =
rd, и кольцо выглядит пустым (16б.1). Отсюда условие:
size ≥ FMAX + W, где FMAX = 67 — самый длинный кадр, W — сколько
байт DMA пишет между двумя запусками разбора.
Опрос по таймеру раз в P: W = P × скорость. HT + TC + IDLE с задержкой обработчика от 0 до L: события приходят через size/2 байт, но один запуск может быть сразу, а следующий — опоздать на L. Тогда W = size/2 + L × скорость и size ≥ 2 × (FMAX + L × скорость).
Формула (uring16c.py) против прогона (uring_sim.c: наименьшее чётное
кольцо без единой потери, и восемь следующих — тоже без потерь):
| Как зовут разбор | Байт за L или P | По формуле | Прогон | Степень двойки |
|---|---|---|---|---|
| HT + TC + IDLE, L до 250 мкс | 23,04 | 181 | 166 | 256 |
| HT + TC + IDLE, L до 500 мкс | 46,08 | 227 | 204 | 256 |
| HT + TC + IDLE, L до 1000 мкс | 92,16 | 319 | 266 | 512 |
| HT + TC + IDLE, L до 2000 мкс | 184,32 | 503 | 382 | 512 |
| опрос раз в 1000 мкс | 92,16 | 160 | 160 | 256 |
| опрос раз в 2000 мкс | 184,32 | 252 | 252 | 256 |
| опрос раз в 5000 мкс | 460,8 | 528 | 512 | 1024 |
| опрос раз в 10 000 мкс | 921,6 | 989 | 926 | 1024 |
Формула нигде не меньше прогона: это верхняя оценка. При опросе она совпала с прогоном для 1 и 2 мс; на 5 и 10 мс в случайном потоке не нашлось столь длинной сплошной пачки с длинным кадром на краю. При событиях прогон меньше формулы: худшее сочетание «этот запуск сразу, следующий через L, и кадр на краю самый длинный» случается редко. Проверять кольцо на него случаем не стоит — берут формулу и округляют вверх.
Два вывода из таблицы. Задержка обработчика дорогая: от 250 до 2000 мкс кольцо растёт почти втрое. И опрос раз в 1 мс, при таком же размере, не хуже прерываний с задержкой до 1 мс — просто задержка доставки кадра тогда до 999 мкс без пауз в линии. Сам буфер невелик: 512 байт — 2,5 % ОЗУ F103 (20 КБ) и 0,39 % у F407 (128 КБ основного ОЗУ).
16б.6 Переполнение, ORE и ReceiveToIdle
Переполнение кольца — DMA обогнал разбор на круг. Счётчик о нём
молчит: позиция по NDTR снова «впереди», и разбор честно читает
смесь старого и нового. Ловит его только проверка кадра. В прогоне с
кольцом 256 и задержкой до 1000 мкс (формула требует 319) затёрто 12
байт, пропало 7 кадров, при поиске начала выброшено 42 байта — и 0
ложных кадров: сумма их не пропустила. Без суммы или номера кадра такая
порча прошла бы внутрь программы.
Переполнение приёмника (ORE) — другое. Байт стоит в регистре
данных, пока его не заберёт DMA; если следующий байт принят раньше, чем
это случилось, поднимается ORE. Содержимое регистра данных при этом не
теряется, пропадает байт в сдвиговом регистре (RM0008 и RM0090,
описание бита ORE). На это у DMA есть время одного символа: 10,85 мкс
на 921 600 бод — 781 такт при 72 МГц и 1823 при 168 МГц; на 115 200 бод —
86,81 мкс. Не успевает DMA, только если шину надолго заняли другие
каналы или потоки с большим приоритетом. Прерывание по ORE при приёме
через DMA дают только через EIE. Код 16б.3 считает такие случаи в
uart_ore и снимает флаг, не отнимая байт у DMA.
HAL. HAL_UARTEx_ReceiveToIdle_DMA (раздел 5а.5) с каналом DMA в
кольцевом режиме делает почти то же, но иначе:
HAL: ReceiveToIdle_DMA, DMA по кругу |
Свой код этого раздела | |
|---|---|---|
| что приходит в обратный вызов | Size — позиция в буфере, не приращение |
разбор сам берёт позицию из NDTR |
| «докуда разобрано» | вести самому | rd в uring_t |
| пауза ровно на конце буфера | вызова от IDLE нет: условие 0 < NDTR < размера; позицию уже сообщил вызов по TC |
разбор зовут все три события |
| от чего пришёл вызов | в HAL F1 1.8.7 — HAL_UARTEx_GetRxEventType (TC, HT, IDLE); в HAL F4 из пака 2.17.1 её нет |
не важно: разбор одинаковый |
| ошибка при приёме через DMA | любая — блокирующая: HAL выключает DMAR, останавливает DMA, зовёт HAL_UART_ErrorCallback |
счёт в uart_ore, приём идёт дальше |
Последняя строка — главное отличие на практике: в HAL один
ORE, шум или ошибка кадра останавливают приём, пока его не запустят
заново из HAL_UART_ErrorCallback (16.4). Своё кольцо просто продолжает
работать, а порчу отбрасывает проверка кадра.
16б.7 Грабли
Байт в кольце позже, чем говорит NDTR (F4). Включён FIFO потока:
в режиме «периферия → память» поток копит данные в FIFO и сливает в
память по достижении порога (RM0090, 10.3.6), а SxNDTR считает
передачи со стороны периферии. Для приёма UART — прямой режим,
DMDIS = 0: каждый запрос сразу даёт одну запись в память.
Прерывание сразу после включения потока. Флаг HTIF или TCIF
остался с прошлого раза. Сбросить в LIFCR/HIFCR (F4) или IFCR (F1)
до включения.
Кадры пропадают только под нагрузкой. Кольцо посчитано по средней, а
не по худшей задержке обработчика. Считать по 16б.5 и смотреть
hiwater: если он подбирается к размеру кольца — запаса нет.
Разбор портит собственное состояние. Прерывания DMA и USART на разных приоритетах: вызов от IDLE вклинивается в разбор от HT. Один приоритет на оба — или запрет прерываний на время разбора.
Снятие IDLE отнимает байт. Пара «чтение SR, затем DR» при
RXNE = 1 забирает байт, который ждал DMA. Читать DR только при
RXNE = 0; при RXNE = 1 флаг снимется на следующем входе.
После ошибки HAL молчит. В HAL ошибка при приёме через DMA
останавливает приём (16б.6); без перезапуска в HAL_UART_ErrorCallback
порт глух до сброса.
Данные кадра испорчены позже. Обратный вызов сохранил указатель на кусок кольца и прочёл его потом. К тому времени DMA переписал место — копировать то, что нужно после выхода.
На F7 и H7 в кольце старые байты. DMA пишет в память мимо кэша данных ядра — кольцо либо в некэшируемой области, либо с аннулированием строк кэша перед разбором (раздел 11б).
16б.8 Итоги
- Позиция записи — size −
NDTR; вторую,rd, ведёт программа.wr=rd— и пусто, и «обогнали на круг». - Разбор зовут HT, TC и IDLE: без IDLE хвост ждёт до 61 320 мкс, без HT и TC кольцо 512 теряет 199 кадров из 20 000.
- Размер кольца: опрос — size ≥ FMAX + P × скорость; события — size ≥ 2 × (FMAX + L × скорость). На 921 600 бод, кадрах до 67 байт и задержке до 1000 мкс — 319, берём 512; прогон: 0 потерь, занятость до 382.
- Разбор без копирования держит начало недошедшего кадра в кольце: это FMAX в формуле.
- Переполнение кольца
NDTRне видит — ловит сумма кадра: 12 затёртых байт, 7 пропавших кадров, 0 ложных. OREпри DMA — шина не отдана за символ: 10,85 мкс на 921 600 бод; прерывание — только черезEIE.- HAL
ReceiveToIdleв кольце даёт позицию, а не приращение, и останавливается на любой ошибке; свой код считает ошибки и работает дальше.
Полные исходники
uring.c — разбор кадров прямо в кольце DMA.
/* 16б: разбор кадров прямо в кольце DMA. Позиция записи — size - NDTR. */
#include "uring.h"

void uring_init(uring_t *r, const uint8_t *buf, uint16_t size, uring_frame_fn fn)
{
    r->buf = buf;
    r->size = size;
    r->rd = 0;
    r->hiwater = 0;
    r->frames = 0;
    r->skipped = 0;
    r->on_frame = fn;
}

static uint16_t idx(const uring_t *r, uint32_t i)        /* rd + i по кругу, без деления */
{
    i += r->rd;
    return (uint16_t)(i >= r->size ? i - r->size : i);
}

void uring_poll(uring_t *r, uint16_t ndtr)
{
    uint16_t wr = (uint16_t)(r->size - ndtr);          /* куда DMA положит следующий байт */
    if (wr >= r->size)                                 /* NDTR = 0 в миг перезагрузки */
        wr = 0;
    uint16_t used = (uint16_t)(wr >= r->rd ? wr - r->rd : wr + r->size - r->rd);
    if (used > r->hiwater)
        r->hiwater = used;

    while (used >= 4u) {                               /* короче кадра не бывает */
        uint8_t len = r->buf[idx(r, 1)];
        if (r->buf[r->rd] != URING_SYNC || len == 0u || len > URING_MAXPAY) {
            r->rd = idx(r, 1);                         /* не начало кадра: сдвиг на байт */
            used--;
            r->skipped++;
            continue;
        }
        if (used < len + 3u)
            break;                                     /* кадр пришёл не весь: ждать, не копируя */
        uint8_t sum = len;
        for (uint32_t i = 0; i < len; i++)
            sum = (uint8_t)(sum + r->buf[idx(r, 2u + i)]);
        if ((uint8_t)(sum + r->buf[idx(r, 2u + len)]) != 0xFFu) {   /* сумма + ~сумма = 0xFF */
            r->rd = idx(r, 1);
            used--;
            r->skipped++;
            continue;
        }
        uint16_t s = idx(r, 2);                        /* данные: кусок до конца кольца и остаток */
        uint16_t n1 = (uint16_t)(r->size - s < len ? r->size - s : len);
        r->on_frame(&r->buf[s], n1, n1 < len ? r->buf : 0, (uint16_t)(len - n1));
        r->rd = idx(r, len + 3u);
        used = (uint16_t)(used - (len + 3u));
        r->frames++;
    }
}
uring_f103.c — STM32F103: USART1 и DMA1 канал 5 по кругу, события HT, TC и IDLE.
/* 16б: STM32F103 — USART1 (RX на PA10) на 921 600 бод, DMA1 канал 5 по кругу в кольцо 512 байт.
   Разбор зовут три события: половина кольца (HT), конец кольца (TC) и пауза в линии (IDLE).
   Собирается armclang: -DSTM32F10X_MD -include stm32f10x.h. */
#include <stdint.h>
#include "uring.h"

#define RX_SIZE 512u
_Static_assert(RX_SIZE % 2u == 0u && RX_SIZE <= 65535u, "HT — ровно половина; NDTR 16-битный");
_Static_assert(DMA_CCR5_CIRC == 0x20 && DMA_CCR5_HTIE == 0x4 && DMA_CCR5_TCIE == 0x2, "CIRC, HTIE, TCIE (RM0008, DMA_CCRx)");
_Static_assert(USART_CR3_DMAR == 0x40 && USART_CR3_EIE == 0x1 && USART_SR_IDLE == 0x10 && USART_SR_ORE == 0x8,
               "DMAR и EIE в CR3, IDLE и ORE в SR (RM0008)");

extern void app_frame(const uint8_t *a, uint16_t na, const uint8_t *b, uint16_t nb);

static uint8_t rx_buf[RX_SIZE];
static uring_t rx;
volatile uint32_t uart_ore;                     /* сколько раз DMA не успел забрать байт */

void uart_rx_start(void)
{
    RCC->AHBENR |= RCC_AHBENR_DMA1EN;
    RCC->APB2ENR |= RCC_APB2ENR_IOPAEN | RCC_APB2ENR_USART1EN;
    GPIOA->CRH = (GPIOA->CRH & ~(0xFu << 8)) | (0x8u << 8);   /* PA10: вход с подтяжкой */
    GPIOA->BSRR = 1u << 10;                                  /* подтяжка вверх: линия в покое — 1 */

    uring_init(&rx, rx_buf, RX_SIZE, app_frame);
    DMA1_Channel5->CCR = 0;                     /* канал выключен: только так пишутся CNDTR и адреса */
    DMA1_Channel5->CPAR = (uint32_t)&USART1->DR;
    DMA1_Channel5->CMAR = (uint32_t)rx_buf;
    DMA1_Channel5->CNDTR = RX_SIZE;
    DMA1->IFCR = DMA_IFCR_CGIF5;
    DMA1_Channel5->CCR = DMA_CCR5_MINC | DMA_CCR5_CIRC | DMA_CCR5_HTIE | DMA_CCR5_TCIE | DMA_CCR5_EN;

    USART1->BRR = 78u;                          /* 72 МГц / 78 = 923 077 бод: +0,16 % */
    USART1->CR3 = USART_CR3_DMAR | USART_CR3_EIE;
    USART1->CR1 = USART_CR1_UE | USART_CR1_RE | USART_CR1_IDLEIE;

    NVIC_SetPriority(DMA1_Channel5_IRQn, 5);    /* один приоритет: разбор не прерывает сам себя */
    NVIC_SetPriority(USART1_IRQn, 5);
    NVIC_EnableIRQ(DMA1_Channel5_IRQn);
    NVIC_EnableIRQ(USART1_IRQn);
}

static void rx_poll(void)
{
    uring_poll(&rx, (uint16_t)DMA1_Channel5->CNDTR);
}

void DMA1_Channel5_IRQHandler(void)             /* HT или TC: пройдена половина или конец кольца */
{
    DMA1->IFCR = DMA_IFCR_CGIF5;
    rx_poll();
}

void USART1_IRQHandler(void)
{
    uint32_t sr = USART1->SR;
    if (sr & USART_SR_ORE)
        uart_ore++;
    /* IDLE, ORE, NE, FE снимает пара «чтение SR, затем DR». При RXNE = 1 байт ещё ждёт DMA:
       его не трогаем, флаг снимется при следующем входе */
    if ((sr & (USART_SR_IDLE | USART_SR_ORE | USART_SR_NE | USART_SR_FE)) && !(sr & USART_SR_RXNE))
        (void)USART1->DR;
    if (sr & USART_SR_IDLE)
        rx_poll();
}
uring_f407.c — STM32F407: USART1 и DMA2 поток 2 по кругу.
/* 16б: STM32F407 — USART1 (RX на PA10, AF7) на 921 600 бод, DMA2 поток 2 канал 4 по кругу.
   FIFO потока не включаем: в прямом режиме каждый байт сразу уходит в память.
   Собирается armclang: -DSTM32F407xx -include stm32f4xx.h. */
#include <stdint.h>
#include "uring.h"

#define RX_SIZE 512u
_Static_assert(DMA_SxCR_CHSEL_Pos == 25u && DMA_SxCR_CIRC == 0x100u, "CHSEL с бита 25, CIRC — бит 8 (RM0090, DMA_SxCR)");
_Static_assert(DMA_SxFCR_DMDIS == 0x4u, "DMDIS = 0 — прямой режим (RM0090, DMA_SxFCR)");
_Static_assert(USART_CR3_DMAR == 0x40u && USART_SR_IDLE == 0x10u, "DMAR в CR3, IDLE в SR — как у F1");

extern void app_frame(const uint8_t *a, uint16_t na, const uint8_t *b, uint16_t nb);

static uint8_t rx_buf[RX_SIZE];
static uring_t rx;
volatile uint32_t uart_ore;

#define S2_FLAGS (DMA_LIFCR_CTCIF2 | DMA_LIFCR_CHTIF2 | DMA_LIFCR_CTEIF2 | DMA_LIFCR_CDMEIF2 | DMA_LIFCR_CFEIF2)

void uart_rx_start(void)
{
    RCC->AHB1ENR |= RCC_AHB1ENR_GPIOAEN | RCC_AHB1ENR_DMA2EN;
    RCC->APB2ENR |= RCC_APB2ENR_USART1EN;
    GPIOA->MODER = (GPIOA->MODER & ~(3u << 20)) | (2u << 20);       /* PA10 — альтернативная функция */
    GPIOA->PUPDR = (GPIOA->PUPDR & ~(3u << 20)) | (1u << 20);       /* подтяжка вверх */
    GPIOA->AFR[1] = (GPIOA->AFR[1] & ~(0xFu << 8)) | (7u << 8);     /* AF7 — USART1_RX */

    uring_init(&rx, rx_buf, RX_SIZE, app_frame);
    DMA2_Stream2->CR = 0;
    while (DMA2_Stream2->CR & DMA_SxCR_EN) {    /* поток гаснет не сразу */
    }
    DMA2_Stream2->PAR = (uint32_t)&USART1->DR;
    DMA2_Stream2->M0AR = (uint32_t)rx_buf;
    DMA2_Stream2->NDTR = RX_SIZE;
    DMA2_Stream2->FCR = 0;                      /* прямой режим, без FIFO */
    DMA2->LIFCR = S2_FLAGS;                     /* старые флаги иначе сразу дадут прерывание */
    DMA2_Stream2->CR = (4u << DMA_SxCR_CHSEL_Pos) | DMA_SxCR_MINC | DMA_SxCR_CIRC
                     | DMA_SxCR_HTIE | DMA_SxCR_TCIE | DMA_SxCR_EN;

    USART1->BRR = 0x5Bu;                        /* 84 МГц: 5 + 11/16 -> 923 077 бод, +0,16 % */
    USART1->CR3 = USART_CR3_DMAR | USART_CR3_EIE;
    USART1->CR1 = USART_CR1_UE | USART_CR1_RE | USART_CR1_IDLEIE;

    NVIC_SetPriority(DMA2_Stream2_IRQn, 5);
    NVIC_SetPriority(USART1_IRQn, 5);
    NVIC_EnableIRQ(DMA2_Stream2_IRQn);
    NVIC_EnableIRQ(USART1_IRQn);
}

static void rx_poll(void)
{
    uring_poll(&rx, (uint16_t)DMA2_Stream2->NDTR);
}

void DMA2_Stream2_IRQHandler(void)
{
    DMA2->LIFCR = S2_FLAGS;
    rx_poll();
}

void USART1_IRQHandler(void)
{
    uint32_t sr = USART1->SR;
    if (sr & USART_SR_ORE)
        uart_ore++;
    if ((sr & (USART_SR_IDLE | USART_SR_ORE | USART_SR_NE | USART_SR_FE)) && !(sr & USART_SR_RXNE))
        (void)USART1->DR;
    if (sr & USART_SR_IDLE)
        rx_poll();
}
Дальше: раздел 16в «Bluetooth-модуль HC-05/HC-06: прозрачный UART, AT-режим, сопряжение и протокол поверх канала» — тот же UART без провода: настройка модуля AT-командами и кадры с подтверждением поверх радиоканала.