 Embedded HandbookПриложения
85. TinyML: машинное обучение на микроконтроллере
TinyML — это машинное обучение там, где данные рождаются: на микроконтроллере рядом с датчиком, при потреблении порядка милливатт. Устройство не отправляет сырой сигнал в облако, а само решает: сказали ли ключевое слово, какой жест сделан, не изнашивается ли подшипник. Это быстрее, не требует сети и не выносит данные наружу.
Главное, что нужно понять: на микроконтроллере модель не учится, а только работает. Обучают её на компьютере, потом ужимают и кладут во Flash как обычный массив чисел. В разделе этот путь пройден целиком на маленьком примере — от данных до вывода в целых числах на C, — и каждое число проверено сборкой и расчётом.
Как это называется в документации
Оригинал Перевод machine learning, model машинное обучение, модель feature, feature vector признак, вектор признаков training / inference обучение / вывод supervised / unsupervised learning обучение с учителем / без учителя classification, anomaly detection классификация, обнаружение аномалий train / test split обучающая и тестовая выборки quantization, scale, zero point квантование, шаг, нулевая точка multiply–accumulate (MAC) умножение с накоплением keyword spotting, wake word распознавание ключевого слова spectrogram, MFCC спектрограмма, мел-кепстральные коэффициенты autoencoder, k-means автоэнкодер, метод k-средних
85.1 Как это устроено
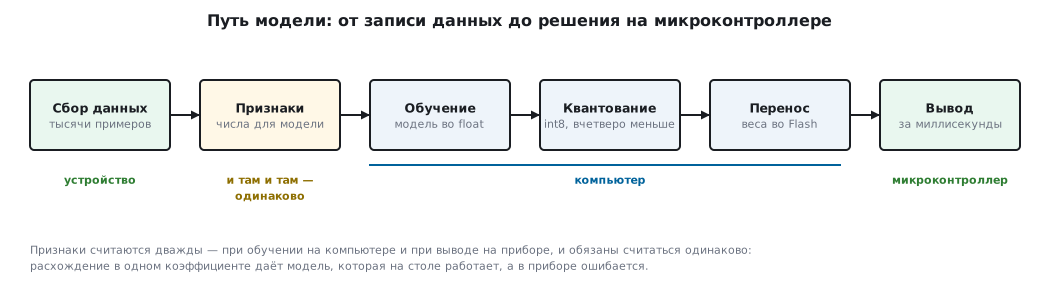
| Шаг | Где | Что получается |
|---|---|---|
| сбор данных | устройство, запись | тысячи примеров с метками |
| признаки | компьютер и устройство — одинаково | числа, по которым модель решает |
| обучение | компьютер | модель во float |
| квантование | компьютер | модель в int8, вчетверо меньше |
| перенос | компьютер → прошивка | массив весов во Flash |
| вывод | микроконтроллер | решение за миллисекунды |
Обучение с учителем — когда для каждого примера известен правильный ответ: «это слово “да”», «это износ». Без учителя — когда ответов нет и модель ищет закономерности сама; так ищут аномалии.
Признаки бывают двоичные (да/нет), категориальные (цвет, тип), порядковые (оценка по шкале) и количественные (измеренная величина). Количественный признак не обязан быть неограниченным — температура в допустимых пределах тоже количественная; а вот оценка «плохо — хорошо — отлично» записана числами, но складывать их бессмысленно, это порядок.
Четыре типовые задачи TinyML и их данные:
| Задача | Датчик | Сколько данных |
|---|---|---|
| ключевое слово | микрофон | 16 000 отсчётов в секунду |
| жест | акселерометр | сотни отсчётов в секунду |
| износ, аномалия | датчик вибрации | тысячи отсчётов в секунду |
| объект в кадре | камера | десятки килобайт на кадр |
85.2 Признаки: не сырой сигнал, а его суть
Звук для распознавания речи оцифровывают на 16 кГц — этого хватает на полосу до 8 кГц. Секунда такого звука в int16 — 32 000 байт, больше всего ОЗУ F103C8 (20 КБ, раздел 80.1). Поэтому сигнал не хранят целиком, а режут на окна по 30 мс со сдвигом 20 мс и каждое окно сразу превращают в признаки:
- быстрое преобразование Фурье даёт спектр окна — из какой смеси частот оно состоит; ряд спектров подряд — спектрограмма;
- спектр сворачивают в 13 мел-кепстральных коэффициентов (MFCC): они подчёркивают низкие частоты, которые ухо различает лучше.
Секунда звука — это 49 окон по 13 коэффициентов, 637 признаков вместо 16 000 отсчётов. Громко сказано слово или тихо, признаки похожи — ради этого их и считают.
Правило, на котором ломаются проекты: признаки на устройстве должны считаться ровно так же, как при обучении — те же окна, те же константы, тот же масштаб. Модель, обученная на одних признаках и получившая другие, отвечает мусором, и никакая точность на компьютере этого не покажет. Простые признаки — среднее, скользящее среднее, размах — считаются фильтрами из раздела 81.
85.3 Модель в памяти: зачем int8
Небольшая сеть для ключевых слов: 637 признаков → 32 нейрона → 3 ответа. В ней 20 515 параметров:
| Хранение | Размер | F103C8 (Flash 64 КБ) |
|---|---|---|
| float, 4 байта | 82 060 байт | не помещается |
| int8, смещения int32 | 20 620 байт | помещается |
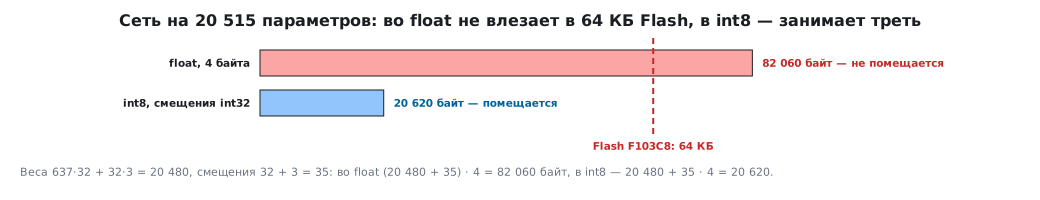
«Помещается» здесь сказано про веса. Прошивке нужно ещё две вещи. Код,
который исполняет модель: свой цикл, как в 85.5, — сотни байт, а
TensorFlow Lite для микроконтроллеров даже с одной операцией
FullyConnected занимает около 21 КБ Flash (armclang -Os, Cortex-M3).
Вместе с весами это 41 КБ из 64 — на остальную прошивку остаётся около
трети. И ОЗУ под промежуточные результаты: у этой сети это вход 637 байт,
32 байта первого слоя и 3 ответа, плюс буферы окон звука. Библиотеки
называют эту область рабочей памятью (tensor arena) и требуют выделить её
заранее одним массивом; сколько нужно конкретной модели, оценивает
STM32Cube.AI (85.8).
Квантование заменяет каждое вещественное число целым от −128 до 127: x ≈ шаг · (q − нулевая точка).
/* ── квантование: x ≈ scale · (q − zero) ── */
int8_t quantize(float x, float scale, int zero)
{
    long q = lroundf(x / scale) + zero;
    if (q > 127)
        q = 127;
    if (q < -128)
        q = -128;
    return (int8_t)q;
}
Ошибка при этом — не больше половины шага: в проверке с шагом 1/127 на отрезке от −1 до 1 она составила 0,003937, ровно 1/254. Модели это обычно почти не вредит — ниже видно, насколько.
85.4 Цена вывода и чем считает Cortex-M
Один вывод этой сети — 20 480 умножений с накоплением, по одному на каждый вес. Как их выполняет ядро, видно по машинному коду:
| Ядро | Команды на одно умножение с накоплением |
|---|---|
| Cortex-M0 | две: muls и adds |
| Cortex-M3 | одна: mla |
| Cortex-M4, код компилятора | одна: smlabb (команда DSP, но по одному умножению) |
| Cortex-M4, библиотека CMSIS-NN | smlad — два умножения за команду, sxtb16 раскладывает байты |
Компилятор сам упакованную команду не подставил: обычный цикл на M4 —
smlabb, одно умножение на элемент. В ядре CMSIS-NN для M4 — 42 команды
smlad и столько же sxtb16, а то же ядро для M3 собирается только на
mla. Поэтому на F407 нейросеть считают библиотекой, а не своим циклом.
Вещественная арифметика — та же история: корень в детекторе аномалий из
85.6 на M4 с FPU — одна команда vsqrt.f32, на M3 — вызов библиотечной
функции (раздел 69).
85.5 Весь путь на маленьком примере
Задача: по вибрации отличить исправный подшипник от изношенного. Два признака на окно: среднеквадратичное значение вибрации и доля энергии в верхней полосе частот. На компьютере — 2000 примеров: 1500 для обучения, 500 для проверки, которых модель не видела.
Обучение. Логистическая регрессия: взвешенная сумма признаков плюс смещение, решение — по знаку. На Python градиентным спуском получены веса 2,392 и 4,215 и смещение 0,781.
Квантование. Признаки и веса — в int8 со своими шагами, смещение — в
int32 в единицах «шаг признака × шаг веса». Квантование здесь симметричное:
нулевая точка у признаков и весов равна нулю, поэтому dot_s8 просто
перемножает коды. С ненулевой нулевой точкой её сначала вычитают из каждого
кода (или заранее вносят поправку в смещение), иначе сумма уедет. Веса стали целыми 72 и 127,
смещение — 1015. Скрипт записывает их в заголовок — так модель и
попадает в прошивку, массивом во Flash:
#define ML_N 2
static const int8_t ML_W[ML_N] = {72, 127};
#define ML_B (1015)
Вывод на микроконтроллере — целиком в целых числах:
/* ── скалярное произведение int8 с накоплением в int32 ── */
int32_t dot_s8(const int8_t *a, const int8_t *b, int n)
{
    int32_t acc = 0;
    for (int i = 0; i < n; i++)
        acc += (int32_t)a[i] * b[i];
    return acc;
}

/* ── классификатор: знак w·x + b целиком в целых числах ── */
int ml_classify_q(const int8_t *xq)
{
    return dot_s8(ML_W, xq, ML_N) + ML_B > 0;
}
Результат на 500 проверочных примерах:
| Модель | Верно |
|---|---|
| float на компьютере | 494 из 500 |
| int8 на C | 494 из 500 |
| совпадение ответов float и int8 | 500 из 500 |
Квантование не отняло ни одного верного ответа. Вывод int8 на C дал ровно
тот же результат, что и целочисленный расчёт на Python, — это и есть
проверка, что модель перенесена без ошибок. Код собран armclang для
Cortex-M0, M3 и M4 без предупреждений.
85.6 Аномалии: учить только норму
Для износа, утечки, поломки есть трудность: примеров неисправности мало, а способов сломаться — тысячи. Собрать данные «как ломается станок» можно, только ломая станки. Выход — учить модель только норме и считать аномалией всё, что на неё не похоже.
Простейший вариант не требует нейросети: считать на лету среднее и разброс сигнала и поднимать тревогу, когда отсчёт уходит от среднего дальше заданного числа сигм. Алгоритм Уэлфорда делает это за одно прохождение, без хранения отсчётов:
typedef struct {
    uint32_t n;
    float mean;
    float m2;       /* сумма квадратов отклонений от среднего */
} welford_t;

void welford_add(welford_t *w, float x)
{
    w->n++;
    float d = x - w->mean;
    w->mean += d / (float)w->n;
    w->m2 += d * (x - w->mean);
}

/* На сколько сигм x отстоит от накопленной нормы */
float welford_z(const welford_t *w, float x)
{
    if (w->n < 2)
        return 0.0f;
    float var = w->m2 / (float)(w->n - 1);
    return var > 0.0f ? (x - w->mean) / sqrtf(var) : 0.0f;
}
В проверке детектор учился на 1000 отсчётах нормы с порогом 4σ: ложных срабатываний — ноль, а сдвиг среднего на 6σ пойман на первом же отсчёте. Состояние — 12 байт.
Для многомерных данных тот же принцип развивают дальше: метод k-средних запоминает центры групп нормальных примеров и меряет расстояние до ближайшего; автоэнкодер — нейросеть, обученная восстанавливать нормальный сигнал через узкое горло, — на аномалии восстанавливает плохо, и большая ошибка восстановления поднимает флаг. Главное — детектор перестают учить, как только он начал работать, иначе он постепенно примет аномалию за норму.
85.7 Изображения: почему не скользящим окном
Самый прямой способ найти объект в кадре — водить по нему окно и спрашивать модель про каждое положение. Окно 48×48 с шагом 16 по кадру 160×120 — это 40 положений; при 100 мс на вывод — 4 секунды на кадр. Поэтому на микроконтроллере берут малое разрешение и сети, которые за один проход дают и класс, и место объекта, либо сначала выделяют «интересные» области простым алгоритмом и классифицируют только их.
85.8 Инструменты
- TensorFlow Lite для микроконтроллеров — переводит обученную модель в массив и исполняет её на устройстве;
- CMSIS-NN — быстрые ядра нейросетей для Cortex-M (85.4); на них опираются и другие исполняющие библиотеки;
- STM32Cube.AI — преобразует модели для STM32 и оценивает память и время вывода на конкретном камне;
- онлайн-сервисы, которые собирают данные с телефона или платы, обучают модель и отдают готовый код — удобно для первого прототипа.
85.9 Ответственность
Модель ошибается всегда — вопрос, как часто и чего это стоит. Ложная тревога о поломке двигателя — остановка линии; пропущенная — авария. Порог выбирают по цене ошибки, а точность меряют на данных из реальных условий: с шумом, эхом, другими голосами. Датчик, который всё время слушает или смотрит, собирает данные о людях: их защищают так же, как любые другие (раздел 37.4), а лучше не хранят вовсе — решение принято на месте, наружу уходит только результат.
85.10 Грабли
В лаборатории модель узнаёт слово, на улице — нет. Данные собраны в тишине; нужны шум, эхо, разные голоса и расстояния.
Точность на компьютере 99 %, на устройстве — случайная. Признаки на устройстве считаются иначе, чем при обучении.
Проверка показала 100 %. Проверяли на тех же данных, на которых учили.
Модель не помещается во Flash. Веса во float; после квантования в int8 — вчетверо меньше.
После квантования ответы «поплыли». Шаг выбран не по диапазону данных, и крупные значения упёрлись в ±127.
Вывод идёт секунды. Свой цикл вместо CMSIS-NN на M4, сеть не по размеру камня, скользящее окно по кадру.
Вещественные вычисления медленные. У M0 и M3 нет FPU — всё через библиотеку.
Детектор аномалий перестал срабатывать. Он продолжал учиться и принял неисправность за норму.
85.11 Итоги
- На микроконтроллере модель только работает; учат её на компьютере, ужимают и кладут во Flash массивом.
- Признаки считают одинаково при обучении и на устройстве; секунда звука 16 кГц — 32 000 байт, признаков из неё — 637.
- int8 вчетверо меньше float: сеть на 20 515 параметров — 82 060 байт во float и 20 620 в int8; ошибка квантования — не больше половины шага.
- Cortex-M0 умножает и складывает двумя командами, M3 — одной
mla, M4 в CMSIS-NN —smlad, два умножения за команду. - Пример целиком: 494 из 500 и во float, и в int8; ответы совпали все 500, вывод на C совпал с расчётом на Python.
- Аномалии ищут, обучив только норму: среднее и разброс на лету — 12 байт и ни одного ложного срабатывания на 1000 отсчётах.
Дальше: раздел 86 «Типы сетей и основные технологии».