 Embedded HandbookПриложения
121е. Курсовой проект TinyML: своя модель под задачу с нуля и до прошивки — распознавание жестов браслетом на STM32F407
Часть XIV разбирала шаги по одному: подходы — в 116 и 116а, как учится сеть — в 116б, признаки и данные — в 117 и 117а, обучение — в 118 и 118а, int8 — в 119, сжатие — в 119а, развёртывание — в 119б, поток со сглаживанием для звука — в 121б. Здесь все шаги пройдены подряд на одной задаче, как в курсовом проекте: браслет на запястье узнаёт четыре жеста. Постановка и бюджет, прошивка сбора, записи 24 человек, разведка и чистка, две модели и выбор, int8, вывод на C, прошивка распознавания со сглаживанием, проверка на людях, которых модель не видела, и итог по флеш-памяти, ОЗУ, командам и энергии.
Браслет — плата F4-Discovery на ремешке: на ней уже есть акселерометр
LIS3DSH на SPI1 (раздел 198л). Все файлы стенда — в _verify/ml121g/;
pipe121g.py проходит их по порядку: Python в образах stm-ml:1
и stm-tf:1, C — gcc в stm-sys:1 и arm-none-eabi-gcc с QEMU в
stm-arm:1, размеры — armclang для F407. Данные синтетические, зерно
фиксировано: повторный прогон даёт те же файлы до байта.
Опоры: кадр с CRC и приём на компьютере — 117а; разбиение по людям — 118.3 и 118а.1; квантование, масштаб и пересчёт — 119; поток, кольцо и окно с перекрытием в TFLM — 119б.5; конечный автомат вместо модели — 198г.
Как это называется в документации
Оригинал Перевод gesture recognition распознавание жестов output data rate (ODR) частота выдачи отсчётов датчика full scale шкала: предел измерения, ±4 g anti-aliasing filter bandwidth полоса фильтра от наложения auto-increment (IF_ADD_INC) адрес регистра растёт сам при чтении подряд data ready, overrun (ZYXDA, ZYXOR) отсчёт готов; отсчёт затёрт новым exploratory data analysis (EDA) разведка данных subject-wise split, leave-subjects-out разбиение по людям null class, background класс «нет жеста», фон sliding window, hop скользящее окно, сдвиг majority vote голосование по нескольким окнам hysteresis гистерезис: включиться трудно, выключиться отдельно rejection threshold порог «не уверен» false trigger ложное срабатывание event-level metrics счёт по событиям, а не по окнам
121е.1 Постановка, бюджет и дерево проекта
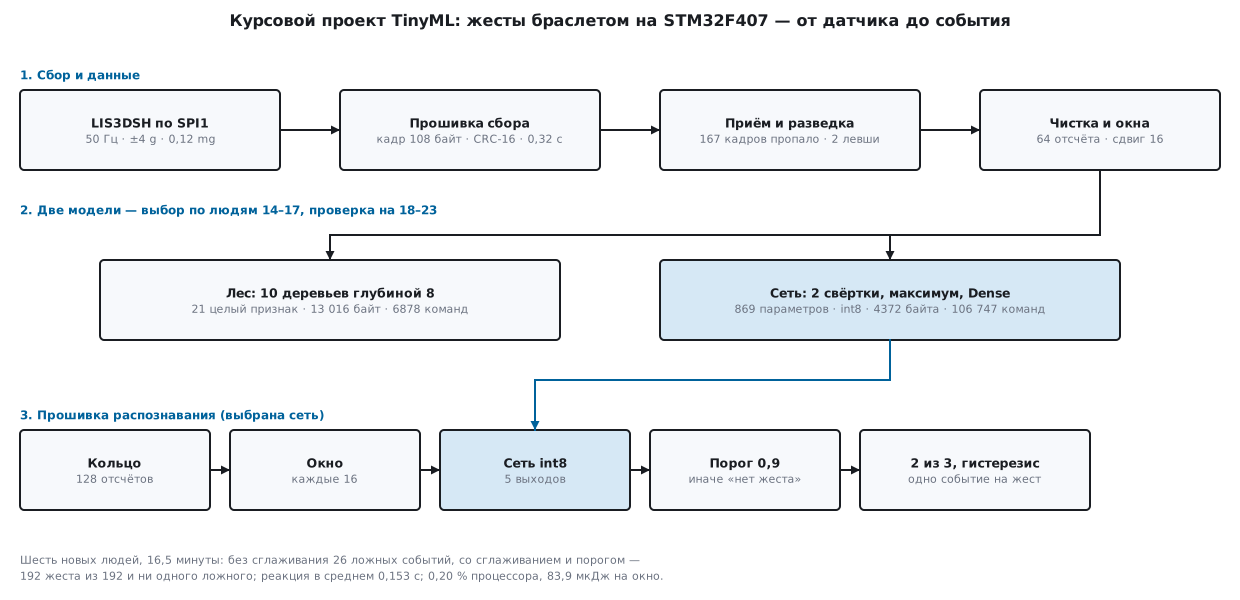
Задача: браслет узнаёт четыре жеста — взмах поперёк предплечья, поворот кисти туда и обратно, двойной стук пальцем по браслету и круг кистью, — а всё остальное считает классом «нет жеста»: покой, набор текста, ходьбу с махом руки и «почти жесты» вроде движения к чашке. Ответ — событие: один жест — одно событие, без очереди срабатываний.
Бюджет пишется до первой строки кода — по нему потом выбирают модель:
| Требование | Цель |
|---|---|
| Реакция после конца жеста | не позже 0,5 с |
| Пропуск жестов на новом человеке | не больше 5 % |
| Ложные события | не больше одного за 10 минут |
| Флеш-память под распознавание | не больше 16 КБ |
| ОЗУ под распознавание | не больше 4 КБ |
| Время процессора на 168 МГц | не больше 1 % |
Дерево проекта — так его удобно сдавать; справа — файлы стенда:
tinyml-bracelet/
  fw_collect/   прошивка сбора: датчик, кадр, UART       collect121g.c
  data/         сырые записи и разметка, не правятся     sensor.bin, scenario.txt (пишет sim121g.py)
  host/         приём, разведка, чистка, окна             prep121g.py
  train/        модели, выбор, выгрузка в C               cnn121g.py, train121g.py
  fw_recog/     прошивка распознавания                    recog121g.c, model121g.h
  test/         C против Python, команды в QEMU           run121g.sh, bench121g.c
  report/       сводки прогонов                           *121g.txt
Порядок работ — от рисков к удобству: сначала прошивка сбора и приём с проверкой «байт в байт», потом разведка, и только потом модели. Сверку C с Python ставят сразу, на первой же модели: расхождение в одно округление (121е.5) видно только ей.
121е.2 Прошивка сбора: датчик по SPI и кадр с CRC
Настройка датчика — три записи в регистры, значения — из lis3dsh.h пака
Keil STM32F4xx_DFP 2.17.1:
int lis_init(void)
{
    if (lis_rd(LIS_WHO_AM_I) != 0x3Fu)
        return -1;
    lis_wr(LIS_CTRL6, CTRL6_ADD_INC);
    lis_wr(LIS_CTRL5, CTRL5_4G_BW50);
    lis_wr(LIS_CTRL4, CTRL4_50HZ_XYZ);
    return lis_rd(LIS_CTRL4) == CTRL4_50HZ_XYZ && lis_rd(LIS_CTRL5) == CTRL5_4G_BW50 ? 0 : -2;
}
CTRL_REG4 = 0x57: 50 Гц (LIS3DSH_DATARATE_50 = 0x50) и три оси
(LIS3DSH_XYZ_ENABLE = 0x07). Шкала — ±4 g, 0,12 mg на единицу
(LIS3DSH_SENSITIVITY_0_12G). Пример BSP ставит ±2 g, 100 Гц и полосу
800 Гц; в записях проекта 191 отсчёт, где хотя бы одна ось сильнее
1966 mg — предела шкалы ±2 g (0,06 mg × 32 768), — и там бы он упёрся.
CTRL_REG5 = 0xC8 собран по описанию регистра в том же заголовке: полоса
фильтра — биты 7:6, шкала — биты 5:3. Готовые константы полосы для этого
не годятся (грабли 121е.7). CTRL_REG6 = 0x10 — бит IF_ADD_INC:
шесть байт X, Y, Z читаются одной посылкой, адрес растёт сам:
    spi_byte(LIS_RD | LIS_OUT_X_L);     /* шесть байт подряд: X_L X_H Y_L Y_H Z_L Z_H */
        v[i] = (int16_t)((uint16_t)b[2 * i] | (uint16_t)b[2 * i + 1] << 8);
Готовность — бит ZYXDA регистра STATUS, бит ZYXOR — отсчёт затёрт,
пока прошлый не прочли; прошивка их считает. Кадр — формат раздела 117а,
тип 3: 16 отсчётов × 3 оси × 2 байта, 108 байт на 0,32 с — 337,5 байта
в секунду, 2,9 % от 11 520 байт в секунду UART на 115 200 бод. armclang
с -Os собрал прошивку сбора в 914 байт кода, из них collect — 400,
lis_init — 74.
На компьютере та же collect() работает с моделью датчика: модель
отвечает на те же посылки SPI — WHO_AM_I, запись регистров, STATUS,
шесть байт с автоприращением — и отдаёт поток из sensor.bin. За
24 записи прошивка выдала 12 248 кадров, 1 324 944 байта, затёртых
отсчётов — 0. Так прошивку сбора проверяют до того, как её зальют в
плату: всё, что не касается выводов и тактов, уже прогнано.
121е.3 Записи участников, разведка и чистка
24 участника, у каждого свои темп (0,8–1,25 обычного), сила, наклон руки до 25°, смещение нуля осей до 40 mg, разброс чувствительности осей 3 % и шум; двое — номера 5 и 20 — носят браслет на левой руке. Сеанс — по 8 повторов каждого жеста в случайном порядке, между ними — 1,5–3,5 с фона, в конце — минута одного фона. Всего 196 151 отсчёт, 3923 с, по 192 повтора каждого жеста. Разбиение — по людям: 0–13 — обучение, 14–17 — подбор, 18–23 — проверка; среди проверочных есть левша.
Чтобы разведке было что найти, стенд портит данные так, как их портит жизнь. У троих в UART бьются биты — один на 1000 байт, — у одного пропадают куски по 40 байт. У участника 9 подсказчик жестов спешил на секунду.
Что нашла разведка:
- Канал. По номерам кадров пропало 167 кадров, 53,4 с записи; CRC при этом сработал 156 раз, остальное съели сбитые синхрослова. Чистые 20 записей совпали с потоком датчика до отсчёта.
- Тяжесть. Модуль ускорения в покое — от 947 до 1050 mg: так выглядят смещение нуля и разброс чувствительности. Отсчёты в предел шкалы ±4 g не упирались.
- Левая рука. Средний взмах по оси Y у правшей — не меньше +473 mg,
у двух левшей — −523 и −995 mg: ось Y зеркальна. Рука записана
в метаданных первого кадра (
hand=L) — разведка лишь подтвердила. - Разметка. Взаимная корреляция «активность × метки» дала сдвиг 50 отсчётов, 1,00 с, у участника 9 и 0 у всех остальных.
Чистка: у левшей ось Y меняет знак (то же сделает прошивка по настройке руки), метки участника 9 сдвинуты на 50 отсчётов, окна с пропавшими кадрами выброшены. Метка окна — жест, если в окне не меньше 80 % его длины; «нет жеста» — если окно не задевает ни одного жеста; остальные окна спорные и в обучение не идут. У обучающих людей с шагом 4 вышло 16 587 окон «нет жеста» и 1302, 1150, 1316 и 966 окон жестов; спорных окон — 6202, окон с пропуском — 1904. Перекос в пользу фона обе модели выправляют весами классов.
121е.4 Две модели и выбор
Лес (116а). Признаки окна — 21 целое число: по каждой оси сумма, размах, сумма модулей разностей, число скачков больше 4000 единиц (480 mg за 20 мс — стук), разброс, разность половин окна; и три попарные ковариации. Все целые, все меньше 2²⁴: C считает их так же, как numpy, а scikit-learn не теряет их при переводе во float32. Размер выбран на людях 14–17: 5 деревьев глубиной 6 — 1456 верных окон из 1467, 10 и 6 — 1455, 10 и 8 — 1462, 20 и 8 — 1464. Взяты 10 деревьев глубиной 8: в пределах двух окон от лучшего, а вдвое меньше. В лесу 1018 узлов и 514 листьев.
Сеть (118а). Окно 64 × 3 → Conv1D(8, 5, strides=2, ReLU) →
Conv1D(16, 5, strides=2, ReLU) → глобальный максимум → Dense(5):
869 параметров. Ранняя остановка по людям 14–17 — 45 эпох, лучшие веса
с 37-й.
На 2446 бесспорных окнах шести новых людей:
| Модель | Верно из 2446 |
|---|---|
| Лес, scikit-learn | 2426 |
| Лес, листья в долях 1/255, целые признаки | 2426 |
| Сеть, float32 | 2443 |
| Сеть, int8 | 2443 |
Лес в целых числах ответил как scikit-learn во всех 2446 окнах; сеть int8 — как float32 во всех 2446.
Честное разбиение. Тот же лес, обученный на окнах вперемешку, на отложенных так же вперемешку окнах верен в 2443 случаях из 2446 — на 17 больше, чем на новых людях. Вперемешку модель видела соседние окна тех же людей и мерит память, а не умение.
Левша. Без зеркала оси Y лес на левше 20 верен в 372 окнах из 394, с зеркалом — в 394. Если и в обучении левшу 5 не зеркалить, лес выучит обе руки и ответит на 394: но только потому, что левша в обучении был.
Выбор по окнам не делают: прибор отвечает событиями, а не окнами. Сравнение — в 121е.6, на потоке.
121е.5 int8 и вывод на C
Сеть квантована конвертером TensorFlow Lite в полный int8
(раздел 119), представительная выборка — 600 обучающих окон. Файл —
6144 байта, операторы EXPAND_DIMS, CONV_2D, RESHAPE, REDUCE_MAX,
FULLY_CONNECTED: Conv1D стала CONV_2D с высотой 1. Масштаб входа —
0,0177715234, нулевая точка −34: вход покрывает от −1642 до 2813 mg.
Что сильнее — упирается в предел: таких значений в потоке проверочных
людей 32 из 148 905.
Вывод на C свой, без библиотеки (TFLM — раздел 119б): две свёртки, максимум
и полносвязный слой в int8, пересчёт масштаба — как в эталонных ядрах
TFLite. Эталон — интерпретатор TensorFlow Lite 2.21.0 с ядрами
BUILTIN_REF. У свёртки пересчёт идёт двумя округлениями —
SaturatingRoundingDoublingHighMul, затем RoundingDivideByPOT. У
полносвязного слоя с масштабом на каждый выход эталон округляет один раз,
в 64 битах:
static int8_t requant64(int32_t acc, int32_t m, int sh, int zo)
{
    int ts = 31 - sh;
    int64_t v = (((int64_t)acc * m + ((int64_t)1 << (ts - 1))) >> ts) + zo;
С двумя округлениями и в нём выходы сети совпали с эталоном в 3036 окнах из 3081, с одним — во всех 3081. События от этого не поменялись, но сверка бит в бит показала разницу сразу.
Лес в C — массивы узлов: номер признака, порог, левый и правый потомок;
в листе — пять долей по 1/255 в байтах. Порог scikit-learn — середина
между двумя целыми значениями признака t, и для целого признака сравнение
x <= floor(t) даёт ровно то же. Ответ — сумма листьев по деревьям:
n = f[RF_FEAT[n]] <= RF_THR[n] ? RF_LEFT[n] : RF_RIGHT[n];
121е.6 Поток, новый человек и бюджет итога
Прошивка распознавания кладёт каждый отсчёт в кольцо на 128 отсчётов
(у левши — с зеркальной осью Y), каждые 16 отсчётов берёт окно 64:
1,28 с, перекрытие 75 % — сдвиг меньше, чем в 119б, чтобы реакция была
быстрее. Ответ окна — класс с наибольшим выходом или «нет жеста», если
уверенность ниже порога. У сети уверенность — softmax по выходам int8 без
expf: разности выходов от 0 до −255, а exp от них — таблица:
        sum += CNN_EXP[q[c] - q[k]];
    return (uint64_t)65536 * 100 >= (uint64_t)CNN_TAU * sum ? c : 0;
Сглаживание — голосование и гистерезис: событие — когда жест набрал 2 голоса из 3 последних окон; выключение — 2 окна подряд без него, и только потом может прийти следующее событие:
            if ((s->hist[0] == c) + (s->hist[1] == c) + (s->hist[2] == c) >= 2) {
    s->off = d != s->state ? s->off + 1 : 0;
Пороги выбраны на людях 14–17 по счёту «верно минус не тот класс минус ложные», из равных — самый строгий: у леса 0,7, у сети 0,9. У сети порог от 0 до 0,9 на подборе не изменил ни одного события: она уверена почти всегда — ниже 0,9 лишь 60 окон из 3081 на проверке, у леса — 515.
Проверка — шесть новых людей, 16,5 минуты записи, 192 жеста, из них 6 минут одного фона. Событие засчитано жесту, если конец окна пришёл не позже 1,92 с после конца жеста; второе событие на тот же жест — ложное:
| Модель и обработка | Верно | Не тот жест | Пропуск | Ложных |
|---|---|---|---|---|
| Лес, ответ каждого окна | 186 | 5 | 1 | 23 |
| Лес, 2 из 3 и гистерезис | 189 | 2 | 1 | 3 |
| Лес, то же и порог 0,7 | 187 | 0 | 5 | 1 |
| Сеть, ответ каждого окна | 178 | 14 | 0 | 26 |
| Сеть, 2 из 3 и гистерезис | 192 | 0 | 0 | 1 |
| Сеть, то же и порог 0,9 | 192 | 0 | 0 | 0 |
Без сглаживания обе модели верны в 99 % бесспорных окон и при этом дают 23–26 ложных событий: окно сдвигается на 16 отсчётов, один жест попадает в несколько окон подряд и дробится на события, а ответы на краях жеста дают 5 и 14 событий «не тот жест». Голосование и гистерезис убрали почти всё. На подборе сеть набрала 115, лес — 114, ложных у обоих 0; выбрана сеть — она и меньше во флеш-памяти. У сети на каждом из шести новых людей — 32 жеста из 32; у леса на худшем — 29. Реакция сети — в среднем 0,153 с после конца жеста, не позже 0,5 с.
Бюджет — размеры из объектного файла armclang (-O2), команды — QEMU
netduinoplus2 с -icount, стек — -fstack-usage arm-none-eabi-gcc:
| Статья | Лес | Сеть |
|---|---|---|
| Флеш: модель и её код | 13 016 байт | 4372 байта |
| Флеш: кольцо, окно, сглаживание | 610 байт | 610 байт |
| ОЗУ: кольцо и окно на стеке | 1160 байт | 1160 байт |
| ОЗУ: буферы слоёв | — | 640 байт |
| Стек функции модели | 216 байт | 96 байт |
| Команд на окно | 6878 | 106 747 |
| Время на 168 МГц, не меньше | 40,9 мкс | 635,4 мкс |
| Доля процессора при окне раз в 0,32 с | 0,01 % | 0,20 % |
| Энергия на окно, ядро | 5,4 мкДж | 83,9 мкДж |
У сети 1024 байта из 4372 — таблица exp; веса и масштабы — 960 байт
отдельными массивами, остальные мелкие массивы компилятор положил в пул литералов
функции. Кольцо и окно — 67,8 команды на отсчёт, решение и
сглаживание — 248 команд на окно. Время — команды, делённые на 168 МГц:
тактов не меньше, чем команд. Энергия — 3,3 В · 40 мА · время: 40 мА —
ток F407 на 168 МГц без периферии, DS8626 ред. 9, таблица 20. Все
требования 121е.1 выполнены с запасом: самая тесная статья — реакция,
0,5 с ровно на границе.
121е.7 Грабли
Константы полосы фильтра BSP включают другую шкалу. В lis3dsh.h
LIS3DSH_FILTER_BW_40 = 0x08 — то же, что LIS3DSH_FULLSCALE_4, а по
описанию регистра полоса лежит в битах 7:6, шкала — в битах 5:3.
FULLSCALE_4 | FILTER_BW_40 даёт ±4 g и полосу 800 Гц, FILTER_BW_50
(0x18) — шкалу ±8 g. Значение собирают по описанию битов и читают обратно.
Отсчёт из BSP врёт на 31 mg. LIS3DSH_ReadACC кладёт байты в
int8_t buffer[6] и считает (buffer[2*i+1] << 8) + buffer[2*i]:
младший байт со знаком. Если он больше 0x7F, результат меньше на 256 единиц. На записях
проекта так испорчено 295 443 значения из 588 453 — половина, — ошибка
до 31 mg. Собирать отсчёт — как
в lis_rd_xyz, из беззнаковых байт.
Окна вперемешку. На окнах вперемешку лес верен в 2443 случаях из 2446, на новых людях — в 2426. В курсовой это выглядит как «модель работает», пока её не наденет другой человек. Проверка — только на людях, которых не было в обучении, а пороги и выбор модели — на отдельной группе подбора.
Метрика по окнам. 99 % верных окон и 23–26 ложных событий за 16,5 минуты — одна и та же модель. Сдают счёт по событиям: верно, не тот жест, пропуск, ложные — и отдельно ложные в чистом фоне.
Рука и ориентация. Без зеркала оси левша теряет 22 окна из 394. Рука, сторона ношения и ось датчика — в метаданных записи и в настройках прибора.
Разметка уехала. Подсказчик спешил на секунду — и метки участника 9 стоят на секунду раньше жестов: в «жест» попадает фон. Взаимная корреляция активности с метками даёт сдвиг одним числом на человека: 50 отсчётов у него и 0 у остальных.
Сверка C с Python в конце. Своё ядро int8 ошиблось в 45 окнах из 3081 из-за одного округления. Сверку бит в бит заводят на первой модели, и она гоняется на каждом изменении.
Порог уверенности у сети почти ничего не режет. Уверенность выше 0,9 у сети в 3021 окне из 3081. Порог подбирают на подборе и проверяют, меняет ли он хоть что-то; ложные события убирает сглаживание, а не порог.
Где теряется время. Не на модели: обе модели здесь — по одному скрипту, и из находок раздела самой модели касается одна — порог сети. Остальные — данные, канал и сверка: пропавшие кадры, левши, сдвиг разметки, константы и чтение отсчёта в BSP, окна вперемешку, округление в C. Поэтому раньше всего проверяют то, что дорого найти поздно: приём байт в байт, метаданные записи, разбиение по людям, сверку C с Python.
121е.8 Итоги
- Браслет: LIS3DSH по SPI1, 50 Гц, ±4 g; кадр 108 байт с CRC-16 на 0,32 с, 337,5 байта в секунду; прошивка сбора — 914 байт кода, проверена на модели датчика: 12 248 кадров, 0 затёртых отсчётов.
- Данные: 24 человека, 3923 с, по 192 повтора жеста; разведка нашла 167 пропавших кадров, двух левшей и сдвиг разметки на 1,00 с.
- Модели: лес 10 × 8 на 21 целом признаке — 2426 из 2446 окон; сеть на 869 параметров — 2443 и во float32, и в int8; окна вперемешку завышают оценку на 17 окон.
- C против эталона: лес и сеть совпали во всех 3081 окне потока, события — у всех шести людей; при двух округлениях в полносвязном слое — 3036.
- На шести новых людях: без сглаживания 23–26 ложных событий, с голосованием, гистерезисом и порогом у сети — 192 жеста из 192 и ни одного ложного за 16,5 минуты; реакция в среднем 0,153 с.
- Бюджет сети: 4372 байта флеш-памяти, 106 747 команд на окно, 0,20 % процессора, 83,9 мкДж на окно; лес — 13 016 байт и 6878 команд.
Чек-лист сдачи
- Бюджет и требования записаны до кода, итог сверен с ними по каждой строке.
- Прошивка сбора: регистры датчика читаются обратно, кадр с CRC и номером, приём на компьютере совпал с потоком байт в байт.
- Метаданные в каждой записи: человек, рука, прошивка, частота, шкала.
- Отчёт разведки: пропуски, смещения, рука, сдвиг разметки, перекос классов — с числами.
- Разбиение по людям; пороги и выбор модели — на подборе, проверка один раз.
- Две модели и сравнение по событиям на потоке, а не по окнам.
- Сверка C с Python бит в бит на всех проверочных окнах.
- Бюджет итога: флеш, ОЗУ, стек, команды, энергия — из сборки и прогона.
- Один скрипт повторяет всё с нуля, и повтор даёт те же файлы.
Полные исходники
recog121g.c — прошивка распознавания: кольцо, окно, лес и сеть int8, порог «не уверен», голосование и гистерезис; сверка с Python на компьютере.
/* recog121g.c — раздел 121е: распознавание жестов браслетом на F407.
 * Отсчёт датчика (int16 × 3) → кольцо на 128 отсчётов → каждые 16 отсчётов окно 64 (1,28 с,
 * перекрытие 75 %) → модель: случайный лес на 21 целом признаке или свёрточная сеть int8 →
 * ответ окна («нет жеста», если уверенность ниже порога) → сглаживание: событие — 2 голоса
 * из 3 последних окон, выключение — 2 окна подряд без этого жеста (гистерезис).
 * Модель — model121g.h (train121g.py). Арифметика целая, кроме входа сети (float32, как в Python).
 * -DRECOG_HOST — сверка с Python на потоках проверочных участников (test121g.bin);
 * -DRECOG_BENCH — счёт команд в QEMU (bench121g.c). Проверка — _verify/ml121g_check.py. */
#include <math.h>
#include <stdint.h>
#include <string.h>

#include "model121g.h"

#define N     64                        /* отсчётов в окне */
#define HOP   16                        /* сдвиг окна: 0,32 с */
#define RING  128                       /* кольцо: степень двойки, больше окна на запас */
#define NC    5                         /* 0 — нет жеста, 1 взмах, 2 поворот, 3 двойной стук, 4 круг */
#define NF    21

/* ── кольцо и окно ── */
typedef struct {
    int16_t x[RING][3];
    uint32_t head;                      /* сколько отсчётов пришло всего */
    int left_hand;                      /* браслет на левой руке — зеркало оси Y */
} ring_t;

void ring_push(ring_t *r, const int16_t v[3])
{
    int16_t *d = r->x[r->head & (RING - 1)];
    d[0] = v[0];
    d[1] = r->left_hand ? (int16_t)(v[1] == INT16_MIN ? INT16_MAX : -v[1]) : v[1];
    d[2] = v[2];
    r->head++;
}

int ring_window(const ring_t *r, int16_t w[N][3])  /* 1 — готово новое окно */
{
    if (r->head < N || (r->head - N) % HOP)
        return 0;
    for (uint32_t i = 0; i < N; i++)
        memcpy(w[i], r->x[(r->head - N + i) & (RING - 1)], sizeof w[i]);
    return 1;
}

/* ── модель 1: признаки и лес ── */
static void features(const int16_t w[N][3], int32_t f[NF])
{
    int64_t s[3] = { 0 }, q[3] = { 0 }, c[3] = { 0 };
    for (int a = 0; a < 3; a++) {
        int32_t mn = w[0][a], mx = w[0][a], d = 0, jumps = 0, half = 0;
        for (int i = 0; i < N; i++) {
            int32_t v = w[i][a];
            s[a] += v;
            q[a] += (int64_t)v * v;
            half += i < N / 2 ? v : -v;
            mn = v < mn ? v : mn;
            mx = v > mx ? v : mx;
            if (i) {
                int32_t dv = v - w[i - 1][a];
                dv = dv < 0 ? -dv : dv;
                d += dv;
                jumps += dv > 4000;
            }
        }
        f[a] = (int32_t)s[a];
        f[3 + a] = mx - mn;
        f[6 + a] = d;
        f[9 + a] = jumps;
        f[12 + a] = (int32_t)((64 * q[a] - s[a] * s[a]) >> 18);
        f[15 + a] = half;
    }
    for (int i = 0; i < N; i++) {
        c[0] += (int64_t)w[i][0] * w[i][1];
        c[1] += (int64_t)w[i][0] * w[i][2];
        c[2] += (int64_t)w[i][1] * w[i][2];
    }
    f[18] = (int32_t)((64 * c[0] - s[0] * s[1]) >> 18);
    f[19] = (int32_t)((64 * c[1] - s[0] * s[2]) >> 18);
    f[20] = (int32_t)((64 * c[2] - s[1] * s[2]) >> 18);
}

void rf_window(const int16_t w[N][3], int32_t sum[NC])
{
    int32_t f[NF];
    features(w, f);
    memset(sum, 0, NC * sizeof sum[0]);
    for (int t = 0; t < RF_TREES; t++) {
        unsigned n = RF_ROOT[t];
        while (RF_FEAT[n] >= 0)
            n = f[RF_FEAT[n]] <= RF_THR[n] ? RF_LEFT[n] : RF_RIGHT[n];
        const uint8_t *p = &RF_LEAF[NC * RF_THR[n]];
        for (int c = 0; c < NC; c++)
            sum[c] += p[c];
    }
}

/* ── модель 2: свёрточная сеть int8, пересчёт масштаба — как в эталонных ядрах TFLite ── */
static int32_t high_mul(int32_t a, int32_t b)    /* SaturatingRoundingDoublingHighMul */
{
    if (a == INT32_MIN && b == INT32_MIN)
        return INT32_MAX;
    int64_t ab = (int64_t)a * b;
    int64_t nudge = ab >= 0 ? (1 << 30) : (1 - (1 << 30));
    return (int32_t)((ab + nudge) / ((int64_t)1 << 31));
}

static int32_t div_pot(int32_t x, int e)         /* RoundingDivideByPOT */
{
    int32_t mask = (int32_t)((1u << e) - 1u), rem = x & mask, th = (mask >> 1) + (x < 0);
    return (x >> e) + (rem > th);
}

static int8_t requant(int32_t acc, int32_t m, int sh, int zo, int lo)
{
    int32_t v = div_pot(high_mul(acc * (1 << (sh > 0 ? sh : 0)), m), sh > 0 ? 0 : -sh) + zo;
    return (int8_t)(v < lo ? lo : v > 127 ? 127 : v);
}

#ifndef FC_TWO_ROUNDINGS
/* у FULLY_CONNECTED с масштабом на каждый выход эталон TFLite 2.21 округляет один раз, в int64 */
static int8_t requant64(int32_t acc, int32_t m, int sh, int zo)
{
    int ts = 31 - sh;
    int64_t v = (((int64_t)acc * m + ((int64_t)1 << (ts - 1))) >> ts) + zo;
    return (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
}
#endif

/* Conv1D, шаг 2, без полей: вход [len][ci], веса [co][k][ci], выход [lo][co], ReLU */
static void conv(const int8_t *in, int len, int ci, const int8_t *wt, const int32_t *b, const int32_t *m,
                 const int8_t *sh, int co, int za, int zo, int8_t *out)
{
    int lo = (len - 5) / 2 + 1;
    for (int t = 0; t < lo; t++)
        for (int c = 0; c < co; c++) {
            int32_t acc = b[c];
            const int8_t *x = in + 2 * t * ci, *k = wt + c * 5 * ci;
            for (int j = 0; j < 5 * ci; j++)
                acc += (x[j] - za) * k[j];
            out[t * co + c] = requant(acc, m[c], sh[c], zo, zo);
        }
}

void cnn_window(const int16_t w[N][3], int8_t q[NC])
{
    static int8_t in[N * 3], h1[30 * 8], h2[13 * 16];
    int8_t g[16];
    for (int i = 0; i < N * 3; i++) {
        float x = (float)w[i / 3][i % 3] / 8192.0f;
        int32_t v = (int32_t)floorf(x / CNN_IN_S + 0.5f) + CNN_IN_ZP;
        in[i] = (int8_t)(v < -128 ? -128 : v > 127 ? 127 : v);
    }
    conv(in, N, 3, CNN_W0, CNN_B0, CNN_M0, CNN_SH0, 8, CNN_ZA0, CNN_ZO0, h1);
    conv(h1, 30, 8, CNN_W1, CNN_B1, CNN_M1, CNN_SH1, 16, CNN_ZA1, CNN_ZO1, h2);
    for (int c = 0; c < 16; c++) {                /* глобальный максимум: масштаб тот же */
        int8_t mx = h2[c];
        for (int t = 1; t < 13; t++)
            mx = h2[t * 16 + c] > mx ? h2[t * 16 + c] : mx;
        g[c] = mx;
    }
    for (int c = 0; c < NC; c++) {
        int32_t acc = CNN_B2[c];
        for (int j = 0; j < 16; j++)
            acc += (g[j] - CNN_ZA2) * CNN_W2[c * 16 + j];
#ifdef FC_TWO_ROUNDINGS                         /* опыт: округлить как у свёртки */
        q[c] = requant(acc, CNN_M2[c], CNN_SH2[c], CNN_OUT_ZP, -128);
#else
        q[c] = requant64(acc, CNN_M2[c], CNN_SH2[c], CNN_OUT_ZP);
#endif
    }
}

/* ── ответ окна с порогом «не уверен» ── */
int rf_decide(const int32_t s[NC])
{
    int c = 0;
    for (int k = 1; k < NC; k++)
        if (s[k] > s[c])
            c = k;
    return 100 * s[c] >= RF_TAU * 255 * RF_TREES ? c : 0;
}

int cnn_decide(const int8_t q[NC])               /* p_max = 65536 / Σ exp(s·(q − q_max)) */
{
    int c = 0;
    uint32_t sum = 0;
    for (int k = 1; k < NC; k++)
        if (q[k] > q[c])
            c = k;
    for (int k = 0; k < NC; k++)
        sum += CNN_EXP[q[c] - q[k]];
    return (uint64_t)65536 * 100 >= (uint64_t)CNN_TAU * sum ? c : 0;
}

/* ── сглаживание: голосование и гистерезис ── */
typedef struct {
    uint8_t hist[3], state, off;
} smooth_t;

int smooth_step(smooth_t *s, int d)              /* жест, если событие, иначе 0 */
{
    s->hist[0] = s->hist[1];
    s->hist[1] = s->hist[2];
    s->hist[2] = (uint8_t)d;
    if (s->state == 0) {
        for (int c = 1; c < NC; c++)
            if ((s->hist[0] == c) + (s->hist[1] == c) + (s->hist[2] == c) >= 2) {
                s->state = (uint8_t)c;
                s->off = 0;
                return c;
            }
        return 0;
    }
    s->off = d != s->state ? s->off + 1 : 0;
    if (s->off >= 2)
        s->state = 0;
    return 0;
}

#ifdef RECOG_HOST
#include <stdio.h>
#include <stdlib.h>

static uint32_t rd32(FILE *f)
{
    uint32_t v = 0;
    if (fread(&v, 4, 1, f) != 1)
        exit(3);
    return v;
}

int main(int argc, char **argv)
{
    FILE *f = fopen(argc > 1 ? argv[1] : "test121g.bin", "rb");
    if (!f)
        return 1;
    uint32_t np = rd32(f), win = 0, rf_same = 0, cnn_same = 0, ev_same = 0, ev_n = 0;
    for (uint32_t p = 0; p < np; p++) {
        static ring_t r;
        memset(&r, 0, sizeof r);
        r.left_hand = (int)rd32(f);
        uint32_t n = rd32(f);
        int16_t *x = malloc(6u * n);
        if (!x || fread(x, 6, n, f) != n)
            return 2;
        uint32_t nw = rd32(f);
        int32_t *ers = malloc(4u * NC * nw);
        int8_t *eq = malloc((size_t)NC * nw);
        if (fread(ers, 4 * NC, nw, f) != nw || fread(eq, NC, nw, f) != nw)
            return 2;
        uint32_t ne[2] = { rd32(f), rd32(f) }, got[2] = { 0, 0 }, ok[2] = { 1, 1 };
        uint32_t *ev = malloc(8u * (ne[0] + ne[1]) + 8u);
        if (fread(ev, 8, ne[0] + ne[1], f) != ne[0] + ne[1])
            return 2;
        smooth_t sm[2];
        memset(sm, 0, sizeof sm);
        uint32_t k = 0;
        for (uint32_t i = 0; i < n; i++) {
            int16_t w[N][3];
            ring_push(&r, &x[3 * i]);
            if (!ring_window(&r, w))
                continue;
            int32_t s[NC];
            int8_t q[NC];
            rf_window(w, s);
            cnn_window(w, q);
            rf_same += memcmp(s, &ers[NC * k], sizeof s) == 0;
            cnn_same += memcmp(q, &eq[NC * k], sizeof q) == 0;
            int e[2] = { smooth_step(&sm[0], rf_decide(s)), smooth_step(&sm[1], cnn_decide(q)) };
            for (int m = 0; m < 2; m++)
                if (e[m]) {
                    uint32_t j = got[m]++, *want = &ev[2 * ((m ? ne[0] : 0) + j)];
                    ok[m] &= j < ne[m] && want[0] == k && want[1] == (uint32_t)e[m];
                }
            k++;
            win++;
        }
        for (int m = 0; m < 2; m++) {
            ev_same += ok[m] && got[m] == ne[m];
            ev_n += got[m];
        }
        free(x);
        free(ers);
        free(eq);
        free(ev);
    }
    printf("windows=%u\nrf_same=%u\ncnn_same=%u\nevents_same=%u,%u\nevents=%u\n", win, rf_same, cnn_same, ev_same, 2 * np,
           ev_n);
    return 0;
}
#endif
collect121g.c — прошивка сбора: LIS3DSH по SPI1, кадр с CRC в UART; на компьютере — модель датчика.
/* collect121g.c — раздел 121е: прошивка сбора данных браслета на F4-Discovery.
 * LIS3DSH на SPI1 (SCK PA5, MISO PA6, MOSI PA7, CS PE3): 50 Гц, ±4 g, три оси.
 * Каждые 16 отсчётов (0,32 с) — кадр формата раздела 117а: A5 5A | тип | длина | номер |
 * время, мкс | данные | CRC-16/CCITT-FALSE; первый кадр записи — строка метаданных.
 * Регистры и биты — из lis3dsh.h пака Keil STM32F4xx_DFP 2.17.1.
 * С -DCOLLECT_HOST вместо SPI и UART — модель датчика и файлы: прошивка читает те же
 * регистры у модели, которая отдаёт записанный поток (sensor.bin от sim121g.py).
 * Проверка — _verify/ml121g_check.py. */
#include <stddef.h>
#include <stdint.h>

#define LIS_WHO_AM_I 0x0Fu              /* читается 0x3F (I_AM_LIS3DSH) */
#define LIS_CTRL4    0x20u              /* ODR 7:4, BDU 3, ZEN YEN XEN 2:0 */
#define LIS_CTRL5    0x24u              /* полоса фильтра 7:6, шкала 5:3 */
#define LIS_CTRL6    0x25u              /* бит 4 IF_ADD_INC: адрес растёт сам при чтении подряд */
#define LIS_STATUS   0x27u              /* бит 3 ZYXDA — готов отсчёт, бит 7 ZYXOR — отсчёт затёрт */
#define LIS_OUT_X_L  0x28u
#define LIS_RD       0x80u              /* старший бит адреса — чтение */

#define CTRL4_50HZ_XYZ 0x57u            /* LIS3DSH_DATARATE_50 | LIS3DSH_XYZ_ENABLE */
#define CTRL5_4G_BW50  0xC8u            /* полоса 50 Гц: биты 7:6 = 11; ±4 g: биты 5:3 = 001 */
#define CTRL6_ADD_INC  0x10u

#define FR_SYNC0 0xA5u
#define FR_SYNC1 0x5Au
#define FR_META  1u
#define FR_ACC   3u                     /* данные — FR_N отсчётов × 3 оси × int16 */
#define FR_N     16u
#define FR_HEAD  10u
#define FR_MAX   (FR_HEAD + 6u * FR_N + 2u)
#define T_FRAME_US 320000u              /* 16 отсчётов при 50 Гц */

/* ── то, что даёт плата (ниже: регистры F407 или модель на компьютере) ── */
static void cs(int low);
static uint8_t spi_byte(uint8_t b);
static int wait_sample(void);           /* 1 — датчик готов, 0 — поток кончился (только на компьютере) */
static void uart_write(const uint8_t *p, size_t n);

/* ── датчик ── */
static uint8_t lis_rd(uint8_t reg)
{
    cs(1);
    spi_byte(LIS_RD | reg);
    uint8_t v = spi_byte(0);
    cs(0);
    return v;
}

static void lis_wr(uint8_t reg, uint8_t v)
{
    cs(1);
    spi_byte(reg);
    spi_byte(v);
    cs(0);
}

static void lis_rd_xyz(int16_t v[3])
{
    uint8_t b[6];
    cs(1);
    spi_byte(LIS_RD | LIS_OUT_X_L);     /* шесть байт подряд: X_L X_H Y_L Y_H Z_L Z_H */
    for (int i = 0; i < 6; i++)
        b[i] = spi_byte(0);
    cs(0);
    for (int i = 0; i < 3; i++)
        v[i] = (int16_t)((uint16_t)b[2 * i] | (uint16_t)b[2 * i + 1] << 8);
}

int lis_init(void)
{
    if (lis_rd(LIS_WHO_AM_I) != 0x3Fu)
        return -1;
    lis_wr(LIS_CTRL6, CTRL6_ADD_INC);
    lis_wr(LIS_CTRL5, CTRL5_4G_BW50);
    lis_wr(LIS_CTRL4, CTRL4_50HZ_XYZ);
    return lis_rd(LIS_CTRL4) == CTRL4_50HZ_XYZ && lis_rd(LIS_CTRL5) == CTRL5_4G_BW50 ? 0 : -2;
}

/* ── кадр (формат раздела 117а) ── */
uint16_t crc16_ccitt(const uint8_t *p, size_t n)
{
    uint16_t c = 0xFFFFu;
    while (n--) {
        c ^= (uint16_t)(*p++ << 8);
        for (int i = 0; i < 8; i++)
            c = (c & 0x8000u) ? (uint16_t)((c << 1) ^ 0x1021u) : (uint16_t)(c << 1);
    }
    return c;
}

static void put16(uint8_t *p, uint16_t v)
{
    p[0] = (uint8_t)v;
    p[1] = (uint8_t)(v >> 8);
}

size_t frame_seal(uint8_t *out, uint8_t type, uint16_t seq, uint32_t t_us, uint8_t len)
{
    out[0] = FR_SYNC0;
    out[1] = FR_SYNC1;
    out[2] = type;
    out[3] = len;
    put16(out + 4, seq);
    put16(out + 6, (uint16_t)t_us);
    put16(out + 8, (uint16_t)(t_us >> 16));
    put16(out + FR_HEAD + len, crc16_ccitt(out + 2, FR_HEAD - 2u + len));
    return FR_HEAD + len + 2u;
}

/* ── запись: метаданные, затем кадры по 16 отсчётов; ZYXOR — отсчёт пропущен ── */
typedef struct {
    uint32_t frames, samples, overruns;
} collect_stat;

int collect(const char *meta, collect_stat *st)
{
    static uint8_t fr[FR_MAX];
    uint16_t seq = 0;
    uint8_t n = 0;
    while (meta[n] && n < 6u * FR_N)
        fr[FR_HEAD + n] = (uint8_t)meta[n], n++;
    uart_write(fr, frame_seal(fr, FR_META, seq++, 0, n));
    if (lis_init() != 0)
        return -1;
    uint32_t t_us = 0, k = 0;
    while (wait_sample()) {
        int16_t v[3];
        if (lis_rd(LIS_STATUS) & 0x80u)
            st->overruns++;
        lis_rd_xyz(v);
        for (int a = 0; a < 3; a++)
            put16(fr + FR_HEAD + 6u * k + 2u * (unsigned)a, (uint16_t)v[a]);
        st->samples++;
        if (++k == FR_N) {
            uart_write(fr, frame_seal(fr, FR_ACC, seq++, t_us, 6u * FR_N));
            st->frames++;
            t_us += T_FRAME_US;
            k = 0;
        }
    }
    return 0;
}

#ifdef COLLECT_HOST
/* ── компьютер: модель LIS3DSH на «шине» и файлы ── */
#include <stdio.h>
#include <stdlib.h>

static struct {
    uint8_t reg[128], addr, first, sel;
    const int16_t *xyz;
    uint32_t n, i;
} lis;
static FILE *fout;

static void cs(int low)
{
    lis.sel = (uint8_t)low;
    lis.first = 1;
}

static uint8_t spi_byte(uint8_t b)
{
    if (!lis.sel)
        return 0xFF;
    if (lis.first) {                    /* первый байт — адрес и направление */
        lis.first = 0;
        lis.addr = b;
        return 0xFF;
    }
    uint8_t a = lis.addr & 0x7Fu, v = 0;
    if (lis.addr & LIS_RD) {
        v = lis.reg[a];
        if (a == LIS_OUT_X_L + 5u)      /* прочитан Z_H — отсчёт забран */
            lis.reg[LIS_STATUS] &= (uint8_t)~0x88u;
    } else
        lis.reg[a] = b;
    if (lis.reg[LIS_CTRL6] & CTRL6_ADD_INC)
        lis.addr = (uint8_t)((lis.addr & LIS_RD) | ((a + 1u) & 0x7Fu));
    return v;
}

static int wait_sample(void)            /* датчик выдал следующий отсчёт */
{
    if (lis.i >= lis.n)
        return 0;
    if (lis.reg[LIS_STATUS] & 0x08u)
        lis.reg[LIS_STATUS] |= 0x80u;
    for (int a = 0; a < 3; a++) {
        uint16_t u = (uint16_t)lis.xyz[3 * lis.i + (uint32_t)a];
        lis.reg[LIS_OUT_X_L + 2 * a] = (uint8_t)u;
        lis.reg[LIS_OUT_X_L + 2 * a + 1] = (uint8_t)(u >> 8);
    }
    lis.reg[LIS_STATUS] |= 0x08u;
    lis.i++;
    return 1;
}

static void uart_write(const uint8_t *p, size_t n)
{
    fwrite(p, 1, n, fout);
}

/* как пересчитывает отсчёт LIS3DSH_ReadACC из BSP: байты в int8_t, затем (hi << 8) + lo */
static int16_t bsp_mg(uint8_t lo, uint8_t hi)
{
    int8_t b0 = (int8_t)lo, b1 = (int8_t)hi;
    float f = (float)((b1 << 8) + b0) * 0.12f;
    return (int16_t)f;
}

int main(int argc, char **argv)
{
    FILE *fi = fopen(argc > 1 ? argv[1] : "sensor.bin", "rb");
    if (!fi)
        return 1;
    uint8_t len;
    char meta[256], name[512];
    int rec = 0;
    uint32_t frames = 0, samples = 0, overruns = 0, bytes = 0, bsp_bad = 0, bsp_n = 0, bsp_max = 0;
    while (fread(&len, 1, 1, fi) == 1) {
        uint32_t ns;
        if (fread(meta, 1, len, fi) != len || fread(&ns, 4, 1, fi) != 1)
            return 1;
        meta[len] = 0;
        int16_t *xyz = malloc(6u * ns);
        if (!xyz || fread(xyz, 6, ns, fi) != ns)
            return 1;
        for (int a = 0; a < 128; a++)
            lis.reg[a] = 0;
        lis.reg[LIS_WHO_AM_I] = 0x3Fu;
        lis.xyz = xyz;
        lis.n = ns;
        lis.i = 0;
        snprintf(name, sizeof name, "%s/p%02d.bin", argc > 2 ? argv[2] : ".", rec++);
        fout = fopen(name, "wb");
        if (!fout)
            return 1;
        collect_stat st = { 0, 0, 0 };
        if (collect(meta, &st) != 0)
            return 2;
        bytes += (uint32_t)ftell(fout);
        fclose(fout);
        frames += st.frames;
        samples += st.samples;
        overruns += st.overruns;
        for (uint32_t i = 0; i < 3u * ns; i++) {
            uint16_t u = (uint16_t)xyz[i];
            int16_t good = (int16_t)((float)xyz[i] * 0.12f), bad = bsp_mg((uint8_t)u, (uint8_t)(u >> 8));
            uint32_t d = (uint32_t)abs(good - bad);
            bsp_n++;
            bsp_bad += d != 0;
            if (d > bsp_max)
                bsp_max = d;
        }
        free(xyz);
    }
    printf("recs=%d\nframes=%u\nsamples=%u\noverruns=%u\nbytes=%u\nframe_bytes=%u\n", rec, frames, samples, overruns,
           bytes, (unsigned)FR_MAX);
    printf("bsp_bad=%u,%u\nbsp_max_mg=%u\n", bsp_bad, bsp_n, bsp_max);
    return 0;
}
#else
/* ── F407: SPI1 и USART2 на регистрах (CMSIS stm32f407xx.h); такты — 168 МГц, APB1 42, APB2 84 ── */
#include "stm32f407xx.h"

static void cs(int low)
{
    GPIOE->BSRR = low ? GPIO_BSRR_BR3 : GPIO_BSRR_BS3;
}

static uint8_t spi_byte(uint8_t b)
{
    while (!(SPI1->SR & SPI_SR_TXE)) {
    }
    *(volatile uint8_t *)&SPI1->DR = b;
    while (!(SPI1->SR & SPI_SR_RXNE)) {
    }
    return *(volatile uint8_t *)&SPI1->DR;
}

static int wait_sample(void)            /* опрос ZYXDA: 50 раз в секунду, SPI на 5,25 МГц успевает с запасом */
{
    while (!(lis_rd(LIS_STATUS) & 0x08u)) {
    }
    return 1;
}

static void uart_write(const uint8_t *p, size_t n)
{
    while (n--) {
        while (!(USART2->SR & USART_SR_TXE)) {
        }
        USART2->DR = *p++;
    }
}

static void board_init(void)
{
    RCC->AHB1ENR |= RCC_AHB1ENR_GPIOAEN | RCC_AHB1ENR_GPIOEEN;
    RCC->APB2ENR |= RCC_APB2ENR_SPI1EN;
    RCC->APB1ENR |= RCC_APB1ENR_USART2EN;
    GPIOA->MODER |= (2u << 4) | (2u << 10) | (2u << 12) | (2u << 14);     /* PA2, PA5…PA7 — альтернативная функция */
    GPIOA->AFR[0] |= (7u << 8) | (5u << 20) | (5u << 24) | (5u << 28);    /* USART2 — AF7, SPI1 — AF5 */
    GPIOE->MODER |= 1u << 6;                                              /* PE3 — выход CS */
    GPIOE->BSRR = GPIO_BSRR_BS3;
    SPI1->CR1 = SPI_CR1_MSTR | SPI_CR1_BR_1 | SPI_CR1_BR_0 | SPI_CR1_SSM | SPI_CR1_SSI | SPI_CR1_SPE; /* 84/16, режим 0 */
    USART2->BRR = (42000000u + 115200u / 2u) / 115200u;
    USART2->CR1 = USART_CR1_UE | USART_CR1_TE;
}

int main(void)
{
    static collect_stat st;
    board_init();
    collect("dev=F407DISC;fw=1.0.0;sensor=LIS3DSH;fs=50;fsr=4;mg_lsb=0.12;person=p00;hand=R", &st);
    for (;;) {
    }
}
#endif
Дальше: раздел 122 «Целые типы и преобразования: продвижение, знак, переполнение».