 Embedded HandbookПриложения
73. Измерение времени и производительности
«Быстрее» и «медленнее» без замера — это мнение. На микроконтроллере вопрос времени не праздный: обработчик прерывания обязан закончиться до следующего прерывания, цикл регулятора — уложиться в свой период, ответ по протоколу — прийти раньше, чем собеседник решит, что связь пропала.
Раздел про то, чем измерять время на камне и на компьютере, как пересчитывать такты во время — и главное, как не обмануть себя замером. Один из разобранных примеров — «ускорение», которое на деле оказалось сломанным циклом ожидания.
Как это называется в документации
Оригинал Перевод execution time, latency время выполнения, задержка cycle count, CPI число тактов, тактов на команду cycle counter (DWT CYCCNT) счётчик тактов timestamp метка времени resolution, overhead разрешение, накладные расходы замера wall-clock time, CPU time астрономическое время, процессорное время monotonic clock монотонные часы benchmark эталонный замер warm-up прогрев logic analyzer логический анализатор profiling профилирование
73.1 Чем измерять на камне
| Инструмент | Разрешение | Где есть | Когда брать |
|---|---|---|---|
| вывод и осциллограф или логический анализатор | наносекунды | везде | время «снаружи», без влияния на код |
счётчик тактов DWT->CYCCNT |
один такт | Cortex-M3, M4, M7, M33 | точный замер участка кода; на части камней с M7 доступ к блоку сначала открывают записью 0xC5ACCE55 в DWT->LAR |
SysTick |
миллисекунда | любой Cortex-M | длинные интервалы, тайм-ауты |
| аппаратный таймер | такт таймера | везде | интервалы между событиями, захват |
| метки в отладочный канал | такт | M3 и старше | журнал событий со временем |
Вывод и осциллограф — самый честный способ. Перед участком кода
поднять ножку, после — опустить, и прибор покажет длительность
импульса. Две записи в BSRR почти ничего не стоят, а прибор не зависит
от того, что происходит в программе. Логический анализатор к тому же
покажет рядом и линии интерфейса — видно, сколько проходит между
байтами.
Счётчик тактов — встроенный в ядро 32-разрядный счётчик, который
растёт на каждом такте. Как включить и как им пользоваться — раздел 35.3.
Важно знать, что у Cortex-M0 и M0+ его нет вовсе: в их заголовках
ядра нет ни блока DWT, ни CYCCNT, и код, читающий DWT->CYCCNT, с
заголовком F072 просто не собирается. На F0 время меряют таймером или
выводом.
SysTick даёт миллисекунды (раздел 7.4), аппаратный таймер —
всё, что между ними, а режим захвата измеряет интервалы между
внешними событиями без участия процессора (раздел 13.6). Метки в
отладочный канал — это журнал со временем, почти не тормозящий
программу (раздел 21).
73.2 Такты и время
Пересчёт простой: время — это такты, делённые на частоту.
| Частота ядра | Один такт | Счётчик тактов переполняется через |
|---|---|---|
| 72 МГц (F103) | 13,9 нс | 59,7 с |
| 168 МГц (F407) | 5,95 нс | 25,6 с |
Переполнение не мешает замеру коротких участков: разность
конец − начало в беззнаковой арифметике верна и через ноль
(раздел 7.4). Мешает только замеру дольше этих секунд.
У SysTick счётчик 24-разрядный: на полной частоте без делителя он
проходит все 2²⁴ значений за 233 мс на 72 МГц и за 99,9 мс на 168 МГц.
Поэтому его используют не как секундомер, а как источник прерывания раз
в миллисекунду — и считают миллисекунды программно.
Одно и то же число тактов — не одно и то же время, и наоборот. На высокой частоте Flash не успевает за ядром и вставляет такты ожидания (раздел 6.4): тот же код на 72 МГц выполняется за большее число тактов, чем на 24. Поэтому результат замера записывают вместе с частотой и настройками Flash.
73.3 Цена вызова: HAL против регистра
Популярное утверждение: «вызов библиотеки медленный, пишите в
регистры». Проверим на функции записи в вывод из библиотеки F4 —
HAL_GPIO_WritePin, собранной из её исходника с оптимизацией:
HAL_GPIO_WritePin:
    cmp     r2, #0
    it      eq
    lsleq   r1, r1, #16        ; сброс — сдвинуть маску в старшую половину
    str     r1, [r0, #24]      ; запись в BSRR
    bx      lr
Пять команд. Вызов HAL_GPIO_WritePin(GPIOA, GPIO_PIN_5, GPIO_PIN_SET)
добавляет ещё пять: четыре кладут три аргумента в регистры (адрес порта
занимает две) и одна переходит в функцию. Прямая запись
GPIOA->BSRR = GPIO_PIN_5 — четыре команды и возврат.
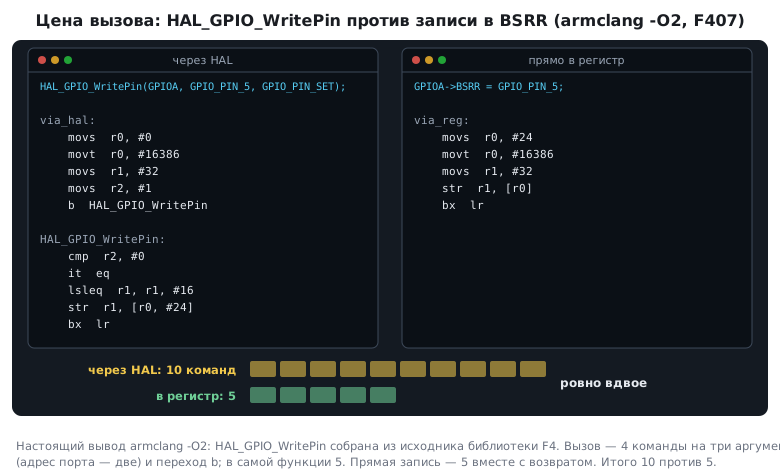
Итого десять команд против пяти — вдвое по числу команд. Но команда — не такт: переход и возврат на Cortex-M3 и M4 стоят от двух до четырёх тактов (конвейер заполняется заново), а после перехода Flash может добавить такты ожидания (73.2). По времени отношение выходит около двух, но точное число даёт только счётчик тактов на плате (73.1). Не в пять и не в десять раз — это видно и без него. Разница заметна в цикле, который дёргает вывод миллионы раз, и незаметна везде, где между записями происходит что-то ещё.
Картина меняется, если собрать без оптимизации или включить проверку
параметров библиотеки (USE_FULL_ASSERT): тогда каждый вызов обрастает
проверками и накладными расходами. Вывод простой: сравнение
«библиотека против регистров» зависит от библиотеки, уровня оптимизации
и настроек сборки — его меряют, а не принимают на веру.
73.4 «Ускорение», которое оказалось ошибкой
Бывает, что переписанный «напрямую через регистры» код начинает работать заметно быстрее. Прежде чем радоваться, стоит проверить, что он работает правильно. Вот типичная запись ожидания флага:
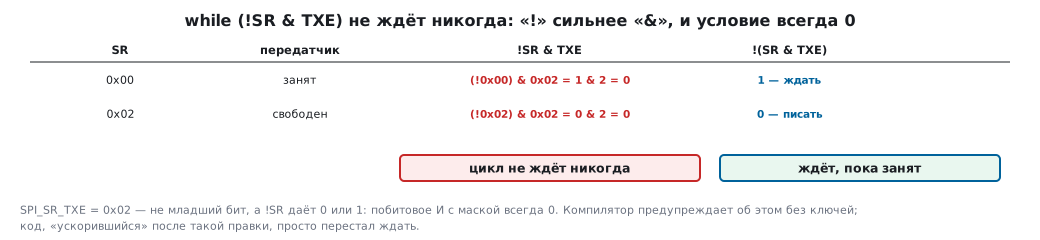
while (!SPI1->SR & SPI_SR_TXE) { } /* ждём, пока освободится передатчик */
Отрицание ! сильнее побитового & (раздел 65.3), и условие читается
как (!SPI1->SR) & SPI_SR_TXE. !SR — это 0 или 1, а маска флага — не
младший бит, поэтому результат всегда ноль. Компилятор так и
поступает: прочитав регистр, он возвращает константу 0 — цикл ожидания
не ждёт никогда. Правильно — while (!(SPI1->SR & SPI_SR_TXE)).
Код стал «быстрее», потому что перестал ждать. Байты теперь пишутся в передатчик, не дожидаясь, пока он освободится, и часть из них теряется или портится — но на осциллографе это видно не сразу.
Хорошая новость: компилятор предупреждает о такой записи без всяких ключей — «logical not is only applied to the left hand side of this bitwise operator». Правило из этого примера шире: подозрительно хороший результат замера — повод сначала проверить правильность.
73.5 Замер на компьютере
| Функция | Что меряет |
|---|---|
clock() |
процессорное время программы; CLOCKS_PER_SEC = 1 000 000 |
clock_gettime(CLOCK_MONOTONIC, …) |
астрономическое время, разрешение 1 нс |
time() |
секунды — для замеров не годится |
Это значения Linux. В Windows с библиотекой Microsoft clock() считает
прошедшее время, а не процессорное, CLOCKS_PER_SEC равно 1000, а
clock_gettime нет — вместо неё берут QueryPerformanceCounter.
struct timespec a, b;
clock_gettime(CLOCK_MONOTONIC, &a);
work();
clock_gettime(CLOCK_MONOTONIC, &b);
double ms = (b.tv_sec - a.tv_sec) * 1e3 + (b.tv_nsec - a.tv_nsec) * 1e-6;
Монотонные часы не прыгают при переводе системного времени — поэтому для замеров берут именно их, а не часы реального времени.
Процессорное время clock() не растёт, пока программа ждёт ввода или
спит, — это полезно, когда нужно отделить вычисления от ожидания.
73.6 Методика: как не обмануть себя
Оптимизатор выбрасывает работу, результат которой не нужен. Цикл на
сто миллионов шагов, суммирующий числа в переменную, которую потом
никто не читает, на компьютере «выполнился» почти за ноль миллисекунд:
компилятор его просто удалил (раздел 63.5). Тот же цикл с записью в
volatile занял заметное время. Замеряемую работу либо используют —
печатают результат, — либо складывают в volatile-переменную.
Замеры не повторяются. Пять одинаковых замеров подряд на компьютере дают пять разных чисел: мешают другие программы, кэши, частота процессора. Замер повторяют много раз и берут наименьшее значение — оно ближе всего к собственной цене кода. На камне разброс меньше, но его вносят прерывания: короткий участок меряют либо с запрещёнными прерываниями, либо много раз.
Для проверки сроков на камне нужно обратное — наибольшее значение:
обработчик и цикл регулятора обязаны укладываться и в худшем случае, а
минимум прячет редкие долгие проходы — прерывание посреди участка, промах
ускорителя Flash, длинную ветку. Максимум копят прямо в программе,
if (dt > dt_max) dt_max = dt;, и смотрят после долгой работы (раздел 76.9).
Сам замер стоит времени. Чтение счётчика — несколько тактов; для очень коротких участков вычитают цену «пустого» замера.
Печать внутри замеряемого участка всё портит. Один символ на 115200 бод — 86,8 мкс, строка из 20 символов — 1,74 мс, то есть 125 000 тактов на 72 МГц. Это больше, чем длятся почти любые участки, которые хочется измерить. Метку времени сохраняют в переменную, а печатают после.
Сравнивают при одинаковых условиях: та же частота, тот же уровень оптимизации, те же данные. Замер без этих трёх подписей бесполезен.
73.7 Замер как довод
Замер хорош, когда отвечает на конкретный вопрос. Пример из раздела
66.8: рекурсивный fib(30) и итеративный. Разница видна и без часов
(2 692 537 вызовов против 30 шагов), но замер подтверждает её
количественно — рекурсивный вариант медленнее в тысячи раз. Точное
число от запуска к запуску гуляет, а порядок остаётся.
Такой замер почти всегда показывает, что главное — алгоритм, а не «библиотека против регистров»: выбор другого способа вычисления даёт тысячи раз, а переписывание одной функции — проценты. Как оценивать алгоритмы без замера — раздел 76, как ускорять код — раздел 75.
73.8 Грабли
Код после переписывания «ускорился в пять раз». Проверьте, что он
работает: например, цикл ожидания !SR & FLAG не ждёт никогда.
Замер показывает ноль. Оптимизатор выбросил работу, результат которой не используется.
Результаты замеров гуляют. Мешают прерывания, другие программы, кэши; повторять и брать наименьшее, а для проверки сроков — наибольшее.
Замер с печатью показывает миллисекунды. Время ушло на печать, а не на код.
DWT->CYCCNT не компилируется на F0. У Cortex-M0 нет счётчика
тактов; меряют таймером или выводом.
Счётчик тактов «перепрыгнул» через ноль. Для коротких замеров это не страшно — вычитание беззнаковое; для длинных — больше минуты на 72 МГц — нужен другой инструмент.
SysTick как секундомер не дотягивает до секунды. 24 бита на полной
частоте — меньше четверти секунды; считают миллисекунды прерыванием.
Один и тот же код на другой частоте занял другое число тактов. Такты ожидания Flash.
Библиотечная функция «медленнее в разы». Проверьте уровень
оптимизации и USE_FULL_ASSERT.
73.9 Итоги
- На камне время меряют выводом и осциллографом, счётчиком тактов,
SysTick, таймером; у Cortex-M0 и M0+ счётчика тактов нет. - Такт — 13,9 нс на 72 МГц и 5,95 нс на 168 МГц; счётчик тактов переполняется за 59,7 и 25,6 секунды.
SysTick24-разрядный: считает миллисекунды прерыванием, а не весь интервал в одном счёте.HAL_GPIO_WritePinс оптимизацией — 5 команд, вызов — ещё 5; прямая запись — 5. Разница вдвое по командам, по тактам — около того, и она зависит от настроек сборки.!SR & FLAG— всегда ноль: «ускорение» оказалось неработающим ожиданием. Компилятор об этом предупреждает.- На компьютере —
clock_gettime(CLOCK_MONOTONIC)с разрешением 1 нс;clock()считает процессорное время. - Работу, результат которой не нужен, оптимизатор выбрасывает; замер повторяют и берут наименьшее; печать внутри замера недопустима — символ на 115200 бод стоит 86,8 мкс.
- Главный выигрыш даёт алгоритм, а не способ записи.
Дальше: раздел 74 «Библиотеки языка C».