 Embedded HandbookПриложения
7б. Ассемблер Cortex-M: Thumb-2 глазами C
Писать прошивку на ассемблере не нужно. Читать его приходится постоянно:
отладчик остановился на HardFault посреди незнакомых команд, функция
вдруг стала вдвое больше, «простое» деление тянет за собой библиотеку.
Этот раздел — как читать то, что сделал компилятор, и что умеет ядро
Cortex-M4 такого, чего нет у Cortex-M0.
Всё показанное — выход arm-none-eabi-gcc -O2 и objdump на двенадцати
маленьких функциях (_verify/thumb7b/funcs.c) для двух ядер, а ассемблерные
функции и ловушки ошибок прогнаны в QEMU (машина netduinoplus2, Cortex-M4F).
Правила сверены с руководством по ядру Cortex-M4 из пакета. Сверяет
_verify/thumb7b_check.py. Как писать на ассемблере самому — стартовый код,
атомики, DSP, переключение задач — в разделе 7в; ассемблер x86-64 — в разделе 144.
Листинг у себя получают двумя путями. Ассемблер компилятора —
arm-none-eabi-gcc -O2 -mcpu=cortex-m4 -mthumb -S file.c (с -fverbose-asm — ещё и
с именами переменных). Дизассемблер готовой прошивки — arm-none-eabi-objdump -d -S app.elf:
ключ -S перемежает код с исходником, если собрано с -g. В CubeIDE и Keil то же
показывает окно Disassembly во время отладки.
Как это называется в документации
Оригинал Перевод Thumb-2 instruction set набор команд Thumb-2: 16- и 32-битные команды вперемешку 16-bit / 32-bit encoding ( .n/.w)короткая / длинная запись команды calling convention (AAPCS) соглашение о вызовах IT block (If-Then) блок «если — то»: до четырёх условных команд literal pool пул литералов: константы рядом с кодом pre-indexed / post-indexed addressing адресация со сдвигом до / после обращения divide-by-zero trap (DIV_0_TRP) ловушка деления на ноль UsageFault, UFSR отказ «неправильное использование» и его регистр причин
7б.1 Регистры и соглашение о вызовах
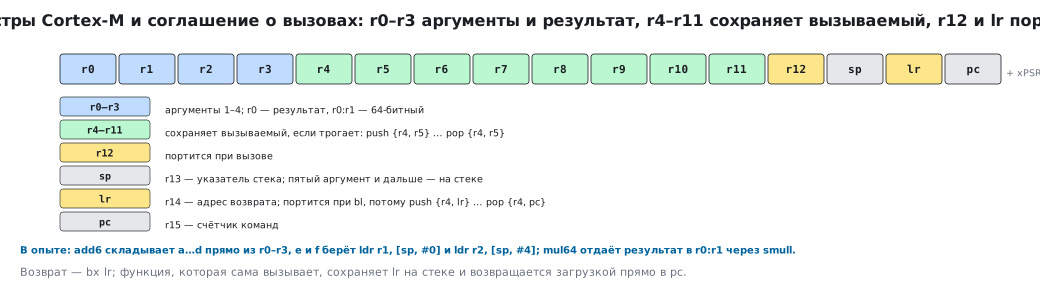
У ядра шестнадцать 32-битных регистров: r0–r12 общего назначения, sp (r13)
— указатель стека, lr (r14) — адрес возврата, pc (r15) — счётчик команд.
Плюс xPSR с флагами N, Z, C, V.
Кто что хранит, решает соглашение о вызовах (AAPCS). Все его правила видны на выходе компилятора:
| Регистр | Роль | Где видно в опыте |
|---|---|---|
r0–r3 |
первые четыре аргумента; r0 — результат |
add6: a…d сложены прямо из r0–r3 |
| стек | пятый аргумент и дальше | add6: ldr r1, [sp, #0] и ldr r2, [sp, #4] — это e и f |
r0:r1 |
64-битный результат | mul64: smull r0, r1, r0, r1 |
r4–r11 |
сохраняет вызываемый, если трогает | asm_minmax: push {r4, r5} … pop {r4, r5} |
r12, lr |
портятся при вызове | вызывающий не рассчитывает на них после bl |
Возврат из функции — bx lr: переход по адресу из lr. Функция, которая
сама кого-то вызывает, сохраняет lr на стеке: push {r4, lr} в начале и
pop {r4, pc} в конце — возврат прямо загрузкой в pc.
7б.2 Шестнадцать и тридцать два бита
В Thumb-2 команды бывают 16- и 32-битными, вперемешку. Короткие работают в
основном с r0–r7 и маленькими константами; длинные умеют всё. В листинге
objdump длинную запись там, где могла быть короткая, помечает суффикс .w
(ldr.w, and.w), короткую — .n (bne.n).
Двенадцать функций одного файла, -O2:
| Cortex-M4 (Thumb-2) | Cortex-M0 (Thumb) | |
|---|---|---|
код .text |
140 байт | 188 байт |
| 16-битных команд | 35 | 75 |
| 32-битных команд | 13 | 4 — только bl |
| константы в пуле | 4 байта | 16 байт |
| вызовы библиотеки | нет | __aeabi_lmul ×2, __clzsi2, __aeabi_idiv |
У M0 на треть больше кода, и это без самих библиотечных функций: они добавятся при компоновке.
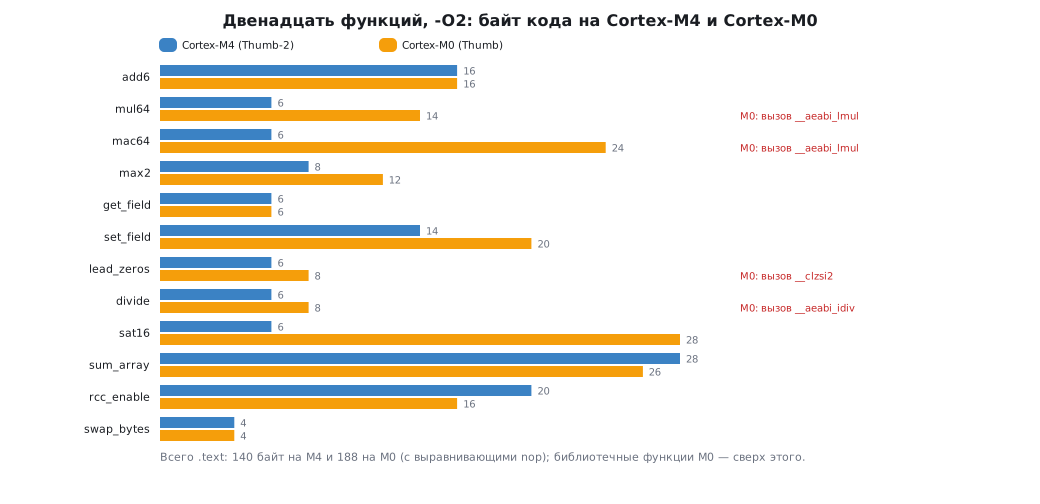
Выигрыш не везде: sum_array на M4 — 28 байт против 26, rcc_enable — 20
против 16. Там, где M0 обходится короткими командами, у M4 длинные ldr.w,
str.w, add.w — они делают больше, но и места занимают вдвое.
7б.3 Одна строка C — одна команда
Главное, что даёт Thumb-2 по сравнению с Thumb у M0, — команды, которые делают целую строку C за раз:
| Строка C | Cortex-M4 | Cortex-M0 |
|---|---|---|
(int64_t)a * b |
smull r0, r1, r0, r1 |
вызов __aeabi_lmul |
acc + (int64_t)a * b |
smlal r0, r1, r2, r3 |
вызов __aeabi_lmul + adds/adcs |
a > b ? a : b |
cmp; it lt; movlt r0, r1 |
cmp; bge; movs |
(x >> 5) & 0x3F |
ubfx r0, r0, #5, #6 |
lsls #21; lsrs #26 |
__builtin_clz(x) |
clz r0, r0 |
вызов __clzsi2 |
a / b |
sdiv r0, r0, r1 |
вызов __aeabi_idiv |
насыщение до int16_t |
ssat r0, #16, r0 |
два сравнения, два перехода, две константы |
__builtin_bswap32(x) |
rev r0, r0 |
rev r0, r0 |
Все функции прогнаны на M4 в QEMU: max2(-5, 3) = 3, get_field(0x7E0) = 0x3F,
lead_zeros(1) = 31, sat16(40000) = 32767, sat16(−40000) = −32768,
mac64(10¹², 100000, −300000) = 970 000 000 000 (0xE1_D8816400), swap_bytes(0x12345678) = 0x78563412.
IT-блок. Команда it lt делает следующую команду условной: movlt
выполнится, только если после cmp было «меньше». В блоке до четырёх
команд (itt, ite, itete…). Переходов нет — нет и сброса конвейера.
У M0 IT-блоков нет, и тот же max2 — с переходом bge.
Не всякая «очевидная» команда будет выбрана. Для записи поля
(x & ~(0x3F << 5)) | ((v & 0x3F) << 5) у M4 есть bfi, но GCC собрал
lsls + and.w + bic.w + orrs — 14 байт вместо возможных 6. Компилятор
не обязан узнавать каждый шаблон; если это горячее место — __builtin
или встроенный ассемблер.
7б.4 Константы: литеральный пул
Адрес регистра — 32-битное число, а в команду помещается лишь маленькая константа.
Поэтому компилятор кладёт число рядом с кодом и читает его командой
ldr относительно pc:
rcc_enable (Cortex-M4):
  74:  ldr    r2, [pc, #12]        ; r2 = 0x40023000 — из пула по адресу 0x84
  76:  ldr.w  r3, [r2, #2096]      ; + 0x830 = 0x40023830 (RCC_AHB1ENR)
  7a:  orr.w  r3, r3, #1
  7e:  str.w  r3, [r2, #2096]
  82:  bx     lr
  84:  .word  0x40023000
Хитрость M4: в пул положена база 0x40023000, а младшие биты ушли в смещение
32-битной ldr.w — одну базу можно разделить на много регистров блока. У M0
смещение короткое, и в пул ложится весь адрес 0x40023830.
Отладчик, дизассемблирующий подряд, покажет .word как бессмысленную команду —
это данные, а не код.
7б.5 Цикл и адресация
sum_array, цикл (Cortex-M4):         sum_array, цикл (Cortex-M0):
  ldr.w  r2, [r3, #4]!                 ldmia  r3!, {r2}
  cmp    r3, r1                        adds   r0, r0, r2
  add    r0, r2                        cmp    r3, r1
  bne.n  64                            bne.n  98
[r3, #4]! — сначала прибавить 4 к r3, прочитать по новому адресу и
оставить r3 сдвинутым: указатель шагает сам, отдельного adds нет. У M0
такой адресации нет; компилятор взял ldmia r3!, {r2} — «загрузить
несколько регистров», здесь один, с тем же сдвигом указателя.
7б.6 Функция на ассемблере вручную
Файл .S (с большой буквы — через препроцессор) рядом с C-файлами, вызов из C
по тем же правилам AAPCS:
asm_minmax:                       @ void asm_minmax(const int32_t *p, uint32_t n, int32_t out[2]), n ≥ 1
    push    {r4, r5}              @ r4, r5 — «чужие»: сохранить и вернуть
    ldr     r3, [r0], #4          @ r3 = *p, затем p += 4
    mov     r4, r3                @ минимум
    mov     r5, r3                @ максимум
    subs    r1, r1, #1
    beq     2f
1:  ldr     r3, [r0], #4
    cmp     r3, r4
    it      lt
    movlt   r4, r3
    cmp     r3, r5
    it      gt
    movgt   r5, r3
    subs    r1, r1, #1            @ флаги ставит само вычитание — отдельный cmp не нужен
    bne     1b
2:  strd    r4, r5, [r2]          @ две записи одной командой
    pop     {r4, r5}
    bx      lr
[r0], #4 — послеиндексная форма: прочитать по r0, потом сдвинуть.
Первый элемент читается до проверки n, поэтому функции нужно n ≥ 1: при
n = 0 вычитание даст 0xFFFFFFFF, и цикл уйдёт далеко за массив.
Результаты в QEMU:
| Вызов | Результат |
|---|---|
asm_minmax({5, −3, 12, 7, −8, 0}, 6) |
min −8, max 12 |
asm_minmax({12}, 1) |
min 12, max 12 |
asm_sum({1, 2, 3, 4, 5, 0xFFFFFFFF}, 6) |
0x0000000E — перенос из старшего бита потерян, как в C |
asm_sum(…, 0) |
0 — выход сразу по cbz |
cbz/cbnz — «сравнить с нулём и перейти» одной 16-битной командой; но
по руководству только для r0–r7, только вперёд на 4…130 байт и не внутри IT-блока.
Цикл asm_sum — четыре команды, как и у компилятора: ручной ассемблер
не быстрее на простом коде. Его место — то, чего не выразить на C: вход в
исключение (раздел 7а), переключение задач, точная последовательность команд.
7б.7 Деление на ноль и невыровненный доступ
Два случая, в которых Cortex-M4 ведёт себя не так, как ждёт программист на C.
Опыт в QEMU; обработчик UsageFault запоминает регистры причин и перешагивает
виновную 32-битную команду:
| Случай | Что произошло |
|---|---|
7 / 0, CCR.DIV_0_TRP = 0 (по умолчанию) |
результат 0, никакого исключения |
7 / 0, DIV_0_TRP = 1, UsageFault включён |
UsageFault, CFSR = 0x02000000 (DIVBYZERO); сохранённый PC = 0x08000590 — адрес самой sdiv |
LDR с нечётного адреса |
прочитано 0x14131211 — работает |
LDRD с того же адреса |
UsageFault, CFSR = 0x01000000 (UNALIGNED) — всегда, без всяких настроек |
7 / 0 с ловушкой, но UsageFault выключен в SHCSR |
HardFault, HFSR = 0x40000000 (FORCED), в CFSR та же причина |
Выводы:
- Деление на ноль молчит. По умолчанию
sdivвернёт 0, и программа поедет дальше с неправильным числом. Ловушку включают двумя битами:SCB->CCR |= SCB_CCR_DIV_0_TRP_MskиSCB->SHCSR |= SCB_SHCSR_USGFAULTENA_Msk. - Перешагнуть команду — не исправить ошибку. После пропуска
sdivвr0осталось делимое (7) — «результат» оказался мусором. Обработчик отказа должен сообщить и перезапустить, а не продолжить. - Невыровненный
LDR/STRработает, аLDRD/STRD/LDM/STM— нет. Именно их компилятор ставит для 64-битных полей и копирования структур: чтение через(uint64_t *)(buf + 1)при разборе пакета падает не всегда, а только там, где компилятор решил читать парой регистров. - UsageFault, BusFault и MemManage без разрешения в
SHCSRстановятся HardFault. ВHFSRбит FORCED, а настоящая причина — всё равно вCFSR.
Ограничение модели. По руководству с CCR.UNALIGN_TRP = 1 падает и
невыровненный LDR. QEMU 7.2 этого не моделирует: в опыте LDR с нечётного
адреса прочитался и с включённым битом. На кристалле — UsageFault UNALIGNED.
7б.8 Встроенный ассемблер
Когда нужна одна-две команды посреди C, файл .S не нужен:
static uint32_t ldrd_at(const uint8_t *p)
{
    uint32_t lo, hi;
    __asm volatile("ldrd %0, %1, [%2]" : "=r"(lo), "=r"(hi) : "r"(p) : "memory");
    return lo ^ hi;
}
"=r" — выход в любой регистр, "r" — вход, "memory" — предупредить
компилятор, что команда читает память. Для частых случаев готовы функции
CMSIS: __CLZ, __REV, __SSAT, __DSB, __disable_irq — это тот же встроенный
ассемблер, но проверенный.
7б.9 Грабли
В дизассемблере бессмысленные команды посреди функции. Это литеральный пул:
данные после bx lr.
Деление на ноль «работает». sdiv возвращает 0; включить DIV_0_TRP и
USGFAULTENA хотя бы в отладочной сборке.
HardFault на чтении структуры из буфера. Невыровненный указатель и LDRD/LDM
— CFSR = 0x01000000. Копировать через memcpy в выровненную переменную.
Все отказы — HardFault. Не включены UsageFault, BusFault, MemManage в SHCSR;
причина всё равно в CFSR.
Код для M0 заметно больше. Без библиотек — на треть (188 байт против 140, 7б.2),
а с __aeabi_idiv, __aeabi_lmul и __clzsi2 из libgcc — ещё больше: деления,
64-битного умножения и clz у M0 в железе нет.
Ручной ассемблер портит переменные вызывающего. Тронул r4–r11 — сохрани
их; lr — тоже, если внутри есть bl.
Условная команда вне IT-блока. movlt без it lt GNU as по умолчанию не
соберёт: «thumb conditional instruction should be in IT block». С ключом
-mimplicit-it=always он вставит it lt сам.
7б.10 Итоги
- AAPCS: аргументы в
r0–r3, дальше стек; результат вr0(r0:r1для 64 бит);r4–r11сохраняет вызываемый. - Thumb-2 мешает 16- и 32-битные команды: 12 функций — 140 байт на M4 против
188 на M0, где деление,
clzи 64-битное умножение — вызовы библиотеки. - M4 делает строку C одной командой:
smull,smlal,ubfx,clz,sdiv,ssat; выбор без перехода — IT-блок до четырёх команд. - Длинные константы — в литеральном пуле рядом с кодом.
- Деление на ноль по умолчанию даёт 0; невыровненные
LDRD/LDMпадают всегда; без разрешения вSHCSRлюбой отказ — HardFault с FORCED.
Полные исходники
asm7b.S — две функции на ассемблере, вызываемые из C по соглашению AAPCS.
/* Раздел 7б: две функции, написанные на ассемблере вручную, — вызываются из C по соглашению AAPCS:
 * аргументы в r0…r3, результат в r0, r4…r11 надо сохранить, если трогаешь. */
    .syntax unified
    .thumb
    .text

    .global asm_sum             /* uint32_t asm_sum(const uint32_t *p, uint32_t n) */
    .type asm_sum, %function
    .thumb_func
asm_sum:
    movs    r2, #0              /* сумма */
    cbz     r1, 2f              /* n == 0 — сразу выход */
1:  ldr     r3, [r0], #4        /* r3 = *p; p += 4 — одна команда */
    adds    r2, r2, r3
    subs    r1, r1, #1          /* флаги ставит сама команда вычитания — отдельное сравнение не нужно */
    bne     1b
2:  mov     r0, r2
    bx      lr
    .size asm_sum, . - asm_sum

    .global asm_minmax          /* void asm_minmax(const int32_t *p, uint32_t n, int32_t out[2]), n ≥ 1 */
    .type asm_minmax, %function
    .thumb_func
asm_minmax:
    push    {r4, r5}            /* r4, r5 — «чужие»: сохранить и вернуть */
    ldr     r3, [r0], #4
    mov     r4, r3              /* минимум */
    mov     r5, r3              /* максимум */
    subs    r1, r1, #1
    beq     2f
1:  ldr     r3, [r0], #4
    cmp     r3, r4
    it      lt                  /* следующая команда выполнится, только если r3 < r4 */
    movlt   r4, r3
    cmp     r3, r5
    it      gt
    movgt   r5, r3
    subs    r1, r1, #1
    bne     1b
2:  strd    r4, r5, [r2]        /* две 32-битные записи одной командой */
    pop     {r4, r5}
    bx      lr
    .size asm_minmax, . - asm_minmax
run7b.c — прошивка опыта в QEMU: ассемблерные функции, деление на ноль, невыровненный доступ и HardFault.
/* Раздел 7б: прогон в QEMU netduinoplus2 (STM32F405, Cortex-M4F).
 * 1. Ассемблерные функции из asm7b.S и функции из funcs.c на настоящем наборе команд.
 * 2. Деление на ноль: без ловушки результат 0; с CCR.DIV_0_TRP — UsageFault.
 * 3. Невыровненный доступ: LDR по нечётному адресу работает, LDRD — UsageFault; с CCR.UNALIGN_TRP падает и LDR.
 * 4. Если UsageFault не включён в SHCSR — та же ошибка поднимается до HardFault (HFSR.FORCED).
 * Обработчик ошибки запоминает регистры состояния и перешагивает виновную 32-битную команду. */
#include <stdint.h>

#define RCC_APB2ENR (*(volatile uint32_t *)0x40023844)
#define USART1_SR   (*(volatile uint32_t *)0x40011000)
#define USART1_DR   (*(volatile uint32_t *)0x40011004)
#define USART1_CR1  (*(volatile uint32_t *)0x4001100C)
#define SCB_CCR     (*(volatile uint32_t *)0xE000ED14)
#define SCB_SHCSR   (*(volatile uint32_t *)0xE000ED24)
#define SCB_CFSR    (*(volatile uint32_t *)0xE000ED28)
#define SCB_HFSR    (*(volatile uint32_t *)0xE000ED2C)

uint32_t asm_sum(const uint32_t *p, uint32_t n);
void asm_minmax(const int32_t *p, uint32_t n, int32_t out[2]);
int max2(int a, int b);
uint32_t get_field(uint32_t x);
uint32_t set_field(uint32_t x, uint32_t v);
int lead_zeros(uint32_t x);
int divide(int a, int b);
int sat16(int x);
int64_t mac64(int64_t acc, int32_t a, int32_t b);
uint32_t swap_bytes(uint32_t x);
int add6(int a, int b, int c, int d, int e, int f);

static void putc1(char c)
{
    while (!(USART1_SR & (1u << 7))) {
    }
    USART1_DR = (uint32_t)c;
}

static void puts1(const char *s)
{
    while (*s)
        putc1(*s++);
}

static void puthex(uint32_t v)
{
    static const char hex[] = "0123456789abcdef";
    puts1("0x");
    for (int i = 28; i >= 0; i -= 4)
        putc1(hex[(v >> i) & 0xF]);
}

static void putdec(int32_t v)
{
    char b[12];
    int i = 0;
    uint32_t u = v < 0 ? 0u - (uint32_t)v : (uint32_t)v;
    if (v < 0)
        putc1('-');
    do {
        b[i++] = (char)('0' + u % 10);
        u /= 10;
    } while (u);
    while (i)
        putc1(b[--i]);
}

static void kv(const char *k, uint32_t v)
{
    puts1(k);
    puts1("=");
    puthex(v);
    puts1("\n");
}

static void kd(const char *k, int32_t v)
{
    puts1(k);
    puts1("=");
    putdec(v);
    puts1("\n");
}

/* что увидел обработчик ошибки */
volatile uint32_t f_kind, f_cfsr, f_hfsr, f_pc;

void fault_c(uint32_t *frame, uint32_t kind)
{
    f_kind = kind;
    f_cfsr = SCB_CFSR;
    f_hfsr = SCB_HFSR;
    f_pc = frame[6];
    SCB_CFSR = f_cfsr;          /* биты сбрасываются записью единицы */
    SCB_HFSR = f_hfsr;
    frame[6] += 4;              /* перешагнуть виновную команду: SDIV и LDRD здесь 32-битные */
}

__attribute__((naked)) void UsageFault_Handler(void)
{
    __asm volatile("tst lr, #4 \n ite eq \n mrseq r0, msp \n mrsne r0, psp \n movs r1, #6 \n push {lr} \n bl fault_c \n pop {pc}");
}

__attribute__((naked)) void HardFault_Handler(void)
{
    __asm volatile("tst lr, #4 \n ite eq \n mrseq r0, msp \n mrsne r0, psp \n movs r1, #3 \n push {lr} \n bl fault_c \n pop {pc}");
}

static void report(const char *name)
{
    puts1(name);
    puts1(": fault=");
    putdec((int32_t)f_kind);
    puts1(" cfsr=");
    puthex(f_cfsr);
    puts1(" hfsr=");
    puthex(f_hfsr);
    puts1(" pc=");
    puthex(f_pc);
    puts1("\n");
    f_kind = f_cfsr = f_hfsr = f_pc = 0;
}

static const uint32_t words[6] = {1, 2, 3, 4, 5, 0xFFFFFFFFu};
static const int32_t vals[6] = {5, -3, 12, 7, -8, 0};
static uint8_t buf[16] __attribute__((aligned(8))) = {0x10, 0x11, 0x12, 0x13, 0x14, 0x15, 0x16, 0x17,
                                                      0x18, 0x19, 0x1A, 0x1B, 0x1C, 0x1D, 0x1E, 0x1F};
volatile int zero = 0;
volatile int seven = 7;

static uint32_t ldrd_at(const uint8_t *p)
{
    uint32_t lo, hi;
    __asm volatile("ldrd %0, %1, [%2]" : "=r"(lo), "=r"(hi) : "r"(p) : "memory");
    return lo ^ hi;
}

int main(void)
{
    RCC_APB2ENR |= 1u << 4;
    USART1_CR1 = (1u << 13) | (1u << 3);

    kv("asm_sum6", asm_sum(words, 6));
    kv("asm_sum0", asm_sum(words, 0));
    int32_t mm[2];
    asm_minmax(vals, 6, mm);
    kd("asm_min", mm[0]);
    kd("asm_max", mm[1]);
    asm_minmax(vals + 2, 1, mm);
    kd("asm_min1", mm[0]);
    kd("asm_max1", mm[1]);

    kd("max2", max2(-5, 3));
    kv("get_field", get_field(0x7E0u));
    kv("set_field", set_field(0xFFFFFFFFu, 0x15u));
    kd("clz1", lead_zeros(1));
    kd("clz_top", lead_zeros(0x80000000u));
    kd("sat_hi", sat16(40000));
    kd("sat_lo", sat16(-40000));
    kd("sat_mid", sat16(-123));
    int64_t m = mac64(1000000000000LL, 100000, -300000);
    kv("mac_lo", (uint32_t)m);
    kv("mac_hi", (uint32_t)((uint64_t)m >> 32));
    kv("swap", swap_bytes(0x12345678u));
    kd("add6", add6(1, 2, 3, 4, 5, 6));

    /* деление на ноль */
    kd("div_ok", divide(seven * 6, seven));
    kd("div0_notrap", divide(seven, zero));
    report("div0_notrap");
    SCB_SHCSR |= 1u << 18;                  /* USGFAULTENA */
    SCB_CCR |= 1u << 4;                     /* DIV_0_TRP */
    kd("div0_trap_result", divide(seven, zero));
    report("div0_trap");

    /* невыровненный доступ */
    kv("ldr_odd", *(volatile uint32_t *)(void *)(buf + 1));
    report("ldr_odd");
    kv("ldrd_even", ldrd_at(buf));
    report("ldrd_even");
    ldrd_at(buf + 1);
    report("ldrd_odd");
    SCB_CCR |= 1u << 3;                     /* UNALIGN_TRP */
    (void)*(volatile uint32_t *)(void *)(buf + 1);
    report("ldr_odd_trap");
    SCB_CCR &= ~(1u << 3);

    /* UsageFault выключен — ошибка поднимается до HardFault */
    SCB_SHCSR &= ~(1u << 18);
    divide(seven, zero);
    report("div0_escalated");
    puts1("done\n");
    for (;;) {
    }
}
Дальше: раздел 7в «Ассемблер Cortex-M на практике: стартовый код, атомики, DSP и переключение задач».