 Embedded HandbookПриложения
33б. Трассировка FreeRTOS: макросы trace и временная диаграмма задач
В разделе 35.3 ядро видно снимком: uxTaskGetSystemState отвечает, кто
сейчас в каком состоянии и сколько процессора набрал. В разделе 26.9 учёт
времени задач показал доли процессора. Ни то ни другое не отвечает на
вопрос «когда»: кто вытеснил кого, сколько задача простояла готовой,
почему периодическая задача сегодня запустилась на 3 мс позже. Здесь —
своя трассировка: макросы trace…, которые ядро оставило пустыми,
пишут каждое переключение и каждое взятие ресурса в кольцо с меткой
времени; отладчик забирает кольцо, программа на ПК рисует временную
диаграмму задач. На прогоне видны инверсия приоритетов (и как её снимает
мьютекс), дрожание периодической задачи и голодание; посчитано, сколько
стоит сам трассировщик.
Опоры: раздел 26 (задачи, приоритеты, учёт времени — 26.9), 28.6
(критические секции и прерывания), 30.5 (инверсия приоритетов и
наследование — здесь не повторяется, только измеряется), 33.3
(configUSE_TRACE_FACILITY), 33а (голодание задачи-сторожа), 35.3
(снимок задач, счётчик тактов DWT->CYCCNT), 21 и 21а (каналы SWO и
RTT, по которым кольцо уходит с платы). Ядро — FreeRTOS 10.5.1 из пака
CMSIS-FreeRTOS, порт ARM_CM4F (github.com/FreeRTOS/FreeRTOS-Kernel,
лицензия MIT). Опыт — QEMU 7.2, машина netduinoplus2 (STM32F405,
Cortex-M4F, как F407); та же прошивка собрана и под F407 с DWT->CYCCNT.
Как это называется в документации
Оригинал Перевод trace hook macros ( traceTASK_SWITCHED_IN, …)макросы трассировки: пустые места в ядре под свой код event record запись события: время, код, задача, довесок flight recorder mode режим самописца: новое затирает самое старое timeline, task swimlanes временная диаграмма: полоса на каждую задачу ready-to-run latency задержка «стала готовой → получила процессор» probe effect влияние измерения: трассировщик сам тратит такты
33б.1 Схема: от макроса в ядре до диаграммы на ПК
Путь события — четыре шага:
- Макрос в ядре. В
tasks.cиqueue.cстоят вызовыtraceTASK_SWITCHED_IN(),traceQUEUE_SEND(pxQueue)и другие. По умолчанию они пустые. Определённые вFreeRTOSConfig.h, они раскрываются внутри ядра — им видны его внутренние переменные. - Запись в кольцо. Свой
trace_evкладёт 8 байт: метка времени, код события, номер задачи, довесок. Кольцо — в ОЗУ, 1024 записи. - Выгрузка. Отладчик читает кольцо из памяти: в опыте — gdb по точке останова, на плате — RTT (21а) или поток по SWO (21).
- Разбор. Программа на ПК
tdiag.pyпревращает записи в отрезки «задача работала с … по …» и рисует диаграмму.
Вот что получилось на прогоне сценария из 30.5: три задачи, H ждёт ресурс, которым владеет L, а M вклинивается. Рисунок построен по двум выгруженным кольцам — с двоичным семафором и с мьютексом:
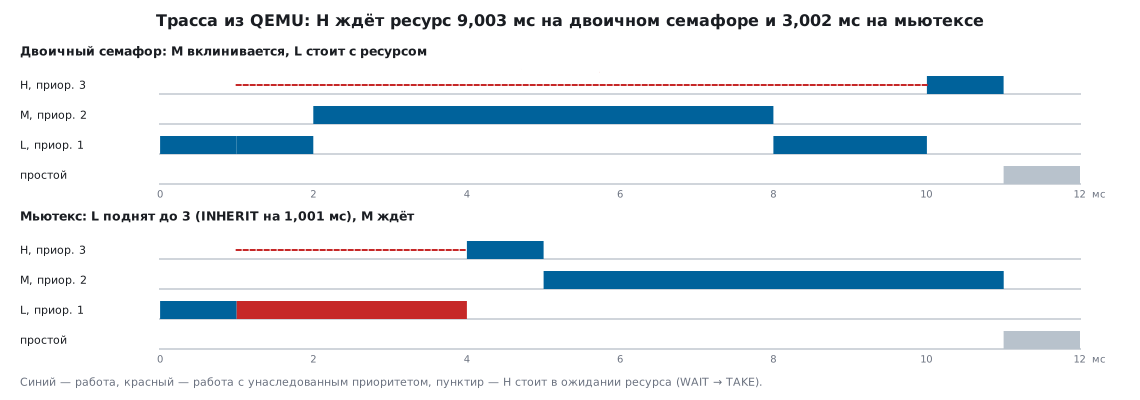
Числа на рисунке — из кольца, а не из модели: 9,003 мс ожидания H против 3,002. Сценарий и разбор — в 33б.5.
33б.2 Макросы ядра: какие есть и где стоят
В FreeRTOS.h версии 10.5.1 — 89 макросов trace…, и каждый
обёрнут так (цитата без комментария ядра, лицензия MIT):
#ifndef traceTASK_SWITCHED_IN
    #define traceTASK_SWITCHED_IN()
#endif
Определил свой раньше — ядро возьмёт его. Для временной диаграммы хватает немногих:
| Макрос | Где вызывается | Что видно внутри |
|---|---|---|
traceTASK_SWITCHED_IN() |
vTaskSwitchContext — после выбора задачи; и в vTaskStartScheduler для первой |
pxCurrentTCB — новая задача |
traceTASK_SWITCHED_OUT() |
там же, до выбора | pxCurrentTCB — уходящая |
traceTASK_INCREMENT_TICK(xTickCount) |
xTaskIncrementTick — в прерывании тика |
счёт тиков до прибавления |
traceMOVED_TASK_TO_READY_STATE(pxTCB) |
prvAddTaskToReadyList: создание, пробуждение, наследование |
задача, ставшая готовой |
traceQUEUE_SEND(pxQueue), traceQUEUE_RECEIVE(pxQueue) |
xQueueGenericSend, xQueueReceive, xQueueSemaphoreTake — удачная запись и чтение |
очередь; семафор и мьютекс — тоже очереди |
traceBLOCKING_ON_QUEUE_RECEIVE(pxQueue) |
задача сейчас встанет ждать | очередь |
traceTASK_PRIORITY_INHERIT(holder, prio) |
xTaskPriorityInherit |
держатель мьютекса и новый приоритет |
traceTASK_PRIORITY_DISINHERIT(holder, prio) |
xTaskPriorityDisinherit |
держатель и его прежний приоритет |
traceTASK_DELAY_UNTIL(xTimeToWake) |
xTaskDelayUntil (vTaskDelayUntil — макрос над ней) и vTaskPlaceOnEventListRestricted |
тик пробуждения |
traceTASK_CREATE(pxNewTCB) |
prvAddNewTaskToReadyList |
имя и номер новой задачи |
Номер задачи — поле uxTCBNumber, номер очереди — uxQueueNumber
(vQueueSetQueueNumber). Оба есть только при
configUSE_TRACE_FACILITY = 1 (33.3): задачи нумеруются 1, 2, … по
порядку создания, задача простоя получает следующий номер. Свои макросы
(trace_rec.h):
#if TRACE_ON
#define traceTASK_CREATE(t)               trace_name((t)->uxTCBNumber, (t)->pcTaskName)
#define traceTASK_SWITCHED_IN()           trace_in(pxCurrentTCB->uxTCBNumber, pxCurrentTCB->uxPriority)
#define traceMOVED_TASK_TO_READY_STATE(t) trace_ev(TR_READY, (t)->uxTCBNumber, (t)->uxPriority)
#define traceTASK_INCREMENT_TICK(n)       trace_ev(TR_TICK, trace_cur, (n) + 1u)
#define traceQUEUE_SEND(q)                trace_ev(TR_GIVE, trace_cur, (q)->uxQueueNumber)
#define traceQUEUE_RECEIVE(q)             trace_ev(TR_TAKE, trace_cur, (q)->uxQueueNumber)
#define traceBLOCKING_ON_QUEUE_RECEIVE(q) trace_ev(TR_WAIT, trace_cur, (q)->uxQueueNumber)
#define traceTASK_PRIORITY_INHERIT(t, p)  trace_ev(TR_INHERIT, (t)->uxTCBNumber, (p))
#define traceTASK_PRIORITY_DISINHERIT(t, p) trace_ev(TR_DISINHERIT, (t)->uxTCBNumber, (p))
#define traceTASK_DELAY_UNTIL(w)          trace_ev(TR_DELAY, trace_cur, (w))
#endif
Две экономии. traceTASK_SWITCHED_OUT не записывается: уход задачи — это
приход следующей, и его время уже есть. pxCurrentTCB и тип блока задачи
TCB_t объявлены только в tasks.c, в queue.c их не видно — поэтому
traceTASK_SWITCHED_IN запоминает номер текущей задачи в trace_cur, а
события очередей берут его оттуда.
33б.3 Запись в кольцо: 8 байт, метка времени, без блокировок ядра
Запись — uint32_t метки времени, байт кода события, байт номера
задачи и 16 бит довеска (приоритет, номер очереди, тик). Кольцо —
степень двойки, индекс — младшие биты счётчика записей
(trace_rec.c):
void trace_ev(uint32_t ev, uint32_t task, uint32_t arg)
{
    uint32_t pm = irq_save();               /* часть макросов зовётся при открытых прерываниях */
    if (trace_buf.on) {
        trace_rec_t *r = &trace_buf.ring[trace_buf.head & (TRACE_N - 1u)];
        r->ts = TRACE_NOW();
        r->ev = (uint8_t)ev;
        r->task = (uint8_t)task;
        r->arg = (uint16_t)arg;
        trace_buf.head++;                   /* кольцо: новая запись затирает самую старую */
    }
    irq_restore(pm);
}

void trace_in(uint32_t task, uint32_t prio)
{
    trace_cur = task;
    trace_ev(TR_IN, task, prio);
}
Почему запрет прерываний. Переключение и тик идут при поднятом
BASEPRI, события очередей — внутри taskENTER_CRITICAL. Но
traceTASK_DELAY_UNTIL и traceBLOCKING_ON_QUEUE_RECEIVE ядро зовёт
при приостановленном планировщике и открытых прерываниях: тик может
прийти посреди записи, и две записи лягут в одну ячейку. PRIMASK на
время записи — три команды (mrs, cpsid, msr) и защита от любого
прерывания, в том числе срочнее порога ядра (28.6). Функции ядра внутри
trace_ev звать нельзя: она сама вызвана из ядра.
Метка времени. На F407 — счётчик тактов DWT->CYCCNT (35.3): 32
бита на 168 МГц, оборот за 25,6 с; программа на ПК разворачивает
переполнения сама, если между соседними записями меньше оборота. QEMU
DWT не моделирует — в опыте CYCCNT читался нулём. Там вместо него
TIM2 с делителем 1: при -icount shift=0 он прибавляет единицу на
каждую выполненную команду. Проверка — цикл work_ms на 0,1 мс: 33 333
оборота по три команды, 99 999 команд, TIM2 насчитал 100 151 (с вызовом).
Миллисекунда тика в QEMU — 10⁶ команд, все времена ниже — в
миллисекундах этого счёта, а цена — в командах:
void trace_clock_start(void)
{
#ifdef TRACE_QEMU
    RCC_APB1ENR |= 1u;                      /* TIM2EN */
    TIM2_PSC = 0u;
    TIM2_ARR = 0xFFFFFFFFu;                 /* TIM2 32-битный: свободный счёт */
    TIM2_EGR = 1u;
    TIM2_CR1 = 1u;
#else
    CoreDebug->DEMCR |= CoreDebug_DEMCR_TRCENA_Msk;
    DWT->CYCCNT = 0u;
    DWT->CTRL |= DWT_CTRL_CYCCNTENA_Msk;
#endif
}
Режим самописца. Кольцо не останавливается, когда заполнено:
1025-я запись ложится на место первой. После отказа в нём остаётся
последняя тысяча событий перед ним — ровно то, что нужно. Поле head
считает все записи, поэтому программа на ПК знает, сколько затёрто.
Имена задач хранятся отдельно, по номеру, — их пишет
traceTASK_CREATE один раз.
33б.4 Выгрузка и разбор на ПК
Кольцо вместе с заголовком и именами — одна структура trace_buf на
8304 байта. В опыте прошивка, закончив сценарий, выключает запись и
вызывает пустую trace_done; на ней стоит точка останова gdb, и
структура уходит в файл целиком:
target remote :1234
break trace_done
continue
dump binary value inv_sem.bin trace_buf
На плате то же делают без остановки. Через RTT (21а) кольцо становится
каналом «вверх», и отладчик читает его на ходу. Через SWO (21) каждую
запись отправляют в канал ITM прямо из trace_ev — тогда кольцо в ОЗУ
не нужно, но линия должна успевать: 8 байт на событие. Как настраивать
оба канала — в своих разделах, здесь они не повторяются.
tdiag.py разбирает файл: заголовок <4I, имена, записи <IBBH. Записи
до первого TR_IN отбрасываются — они сделаны до обнуления счётчика при
старте планировщика. Масштаб — по самим тикам: среднее расстояние между
записями TR_TICK — это миллисекунда (в опыте 999 999 отсчётов).
Главное — превратить поток событий в отрезки работы:
    runs, cur, since = [], None, None
    for t, e in zip(ts, ev):
        if e[1] == 1:
            if cur is not None:
                runs.append((cur, ms(since), ms(t), prio))
            cur, since, prio = e[2], t, e[3]
Каждое TR_IN закрывает отрезок прежней задачи и открывает новый. Из
пары TR_WAIT → TR_TAKE получается время ожидания ресурса, из
TR_READY → TR_IN — задержка «готова → работает», из суммы отрезков —
доля процессора. Диаграмма — текстом, клетка 0,25 мс (# — задача
работает, ^ — работает с чужим приоритетом), или в SVG (--svg).
33б.5 Что видно на трассе: инверсия, дрожание, голодание
Инверсия приоритетов и мьютекс
Сценарий — как в 30.5, задачи из app.c:
static void task_l(void *arg)
{
    (void)arg;
    xSemaphoreTake(lock, portMAX_DELAY);
    work_ms(40);                            /* 4 мс с ресурсом */
    xSemaphoreGive(lock);
    vTaskSuspend(NULL);
}

static void task_h(void *arg)
{
    (void)arg;
    vTaskDelay(pdMS_TO_TICKS(1));
    xSemaphoreTake(lock, portMAX_DELAY);
    work_ms(10);                            /* 1 мс с ресурсом */
    xSemaphoreGive(lock);
    vTaskSuspend(NULL);
}

static void task_m(void *arg)
{
    (void)arg;
    vTaskDelay(pdMS_TO_TICKS(2));
    work_ms(60);                            /* 6 мс своей работы, ресурс не нужен */
    vTaskSuspend(NULL);
}
work_ms — пустой цикл по три команды на оборот, без ожидания: время
работы не зависит от того, вытесняли задачу или нет. Приоритеты: H — 3,
M — 2, L — 1. lock — двоичный семафор или мьютекс. Разбор кольца
с семафором:
ожидание ресурса H: 1.000 … 10.003 мс = 9.003 мс
  пока ждала, работали: M 6.001 мс, L 3.002 мс
H      |                                        ####    |
M      |        ########################                |
L      |########                        ########        |
IDLE   |                                            ####|
мс      0   1   2   3   4   5   6   7   8   9   10  11  12
H просит ресурс на 1-й мс и ждёт 9,003 мс: из них 6,001 мс работает M,
которой ресурс не нужен вовсе. С мьютексом кольцо содержит два новых
события — INHERIT на 1,001 мс (L поднята до 3) и DISINHERIT на
4,002 мс:
ожидание ресурса H: 1.000 … 4.003 мс = 3.002 мс
  пока ждала, работали: L 3.002 мс
H      |                ####                            |
L      |####^^^^^^^^^^^^                                |
M      |                    ########################    |
IDLE   |                                            ####|
мс      0   1   2   3   4   5   6   7   8   9   10  11  12
Ожидание H — ровно остаток работы L с ресурсом, 3,002 мс. Цена наследования тоже видна: M стала готовой на 2-й мс и получила процессор только через 3,003 мс. Доли процессора в обоих прогонах одинаковые (H 1,001, L 4,001, M 6,001 мс за 20 мс) — по ним инверсию не увидеть, по времени — сразу.
Дрожание и голодание
Сценарий нагрузки, 200 мс:
| Задача | Приоритет | Что делает |
|---|---|---|
| burst | 3 | раз в 7 мс вспышка работы: 1; 3; 0,5; 2 мс по кругу |
| period | 2 | раз в 5 мс (vTaskDelayUntil) 0,5 мс работы |
| poll | 2 | с 100-й по 160-ю мс опрашивает флаг в цикле, не уступая процессор |
| logger | 1 | раз в 10 мс 0,5 мс работы |
Задержка «готова → работает» по кольцу (готовой задачу делает тик,
работать она начинает с TR_IN):
| period | logger | |
|---|---|---|
| лучшая | 156 команд | 0,5 мс — ждёт period |
| средняя | 0,372 мс | 5,348 мс |
| худшая | 3,001 мс, на 70-й мс | 60,521 мс, готова на 100-й мс |
Дрожание. 156 команд — это путь от записи TR_READY в прерывании
тика до TR_IN в PendSV: столько стоит само переключение. Всё сверх —
чужая работа: на 70-й мс period и burst проснулись вместе, и period
ждала трёхмиллисекундную вспышку. С 100-й по 160-ю мс к этому
добавляется poll: у неё тот же приоритет, и ядро делит с ней процессор
по тикам, — period на 100-й мс стартовала на 102-й.
Голодание. logger стала готовой на 100-й мс и получила процессор на 160,521-й — когда poll остановилась. Кусок диаграммы (клетка 0,5 мс):
burst  |      ######        #             ####          ##          |
period |#             #      #        #         #         #         |
poll   |            ## #####  ######## ###    ## #######   #########|
logger |                                                            |
IDLE   | #####                                                      |
мс      95        100       105       110       115       120       125
Полоса logger пуста; задача простоя не работала с 98-й по 164,523-ю мс. После 160-й мс logger
отработала все семь пропущенных периодов подряд — 3,5 мс работы до
164,523-й мс: vTaskDelayUntil с прошедшим моментом пробуждения не ждёт. Задача простоя тоже голодала — значит, не
работали бы и ловушка простоя, и сон без тика (33.5).
Исправления — period на приоритет 4, выше burst, а poll после каждого
опроса уступает процессор vTaskDelay(1):
period |#         #         #         #         #         #         |
burst  |      #### ##        #            ####          ##          |
poll   |             .. . .   . . . .  ..     .  .. . .    .. . . . |
logger |             #.                #.                  #.       |
IDLE   | #####        ######  ########  ##    ## #######    ########|
мс      95        100       105       110       115       120       125
period теперь стартует через 156…304 команды после своего тика, logger ждёт не больше 3,501 мс. Но трасса показывает и цену: burst, которую period теперь вытесняет, получила задержку до 0,501 мс вместо 230 команд. Дрожание не исчезает — его переносят на того, кому оно безвредно.
33б.6 Сколько стоит трассировщик и чем его заменить
Цена записана тем же счётчиком команд QEMU:
| Что | Без трассы | С трассой | Источник |
|---|---|---|---|
одна запись trace_ev с вызовом |
— | 26 команд | 100 вызовов: 2805 против 205 у пустого цикла |
переключение задач (taskYIELD туда и обратно, 2000 раз) |
61,5 команды | 90,5 | 123 008 и 181 008 команд |
то же с учётом времени задач (configGENERATE_RUN_TIME_STATS) |
81,5 | — | 163 008 команд |
| ОЗУ | — | 8304 байта | кольцо 1024 × 8, имена 12 × 8, заголовок 16 |
| флеш-память | 7372 байта | 7836 | +464 байта: функции и макросы в ядре |
На переключение трасса добавляет 29 команд, учёт времени — 20. В сценарии нагрузки — 2,58 записи на миллисекунду: кольца на 1024 записи хватает примерно на 400 мс истории, а 518 записей за прогон — около 15 тысяч команд из 200 миллионов, меньше 0,01 %. Это влияние измерения, и оно не нулевое: каждое переключение под трассой длиннее на 29 команд. Гонку, которая зависит от десятка тактов, трассировщик может спрятать — грабли ниже.
Дешёвая альтернатива — учёт времени ядром. Включается тремя
строками (FreeRTOSConfig.h), источник времени — тот же счётчик:
#if STATS_ON
#define configGENERATE_RUN_TIME_STATS           1
#define configUSE_STATS_FORMATTING_FUNCTIONS    1
#define portCONFIGURE_TIMER_FOR_RUN_TIME_STATS() trace_clock_zero()
#define portGET_RUN_TIME_COUNTER_VALUE()        trace_now()
#else
#define configGENERATE_RUN_TIME_STATS           0
#endif
vTaskGetRunTimeStats в сценарии нагрузки напечатал для period
19 512 558 отсчётов и 9 %, для poll — 40 012 518 и 20 %, для простоя —
85 454 239 и 42 %. Кольцо дало 19,513, 40,013 и 85,454 мс — совпадение
до микросекунды: оба считают одним счётчиком на одних и тех же
переключениях. Проценты ядро округляет вниз (9 % против 9,8 %).
| Учёт времени ядром | Своя трасса | |
|---|---|---|
| ОЗУ | 4 байта на задачу и 8 на ядро | 8304 байта на 1024 события |
| переключение | +20 команд | +29 команд |
| флеш-память | +64 байта счёта; с печатью vTaskGetRunTimeStats через sprintf — +4324 |
+464 байта |
| отвечает на | «сколько процессора у кого» | «кто, когда и почему» |
| инверсия в опыте | не видна: доли одинаковые | 9,003 против 3,002 мс |
Обычный порядок: в изделии держат учёт времени (без печати — читают
uxTaskGetSystemState, 35.3), трассу включают сборкой, когда нужно
понять порядок событий.
33б.7 Грабли
CYCCNT всегда ноль. Не включён TRCENA в CoreDebug->DEMCR или
работаете в QEMU: там DWT нет, счётчик читается нулём. Все записи с
одной меткой времени — диаграмма схлопывается в точку.
Две записи в одной ячейке. Запись без запрета прерываний: часть
макросов ядро зовёт при открытых прерываниях, и тик вклинивается между
чтением и увеличением head. Одна запись теряется, другая дублируется.
Вызов ядра из макроса. xTaskGetCurrentTaskHandle, printf,
запись в очередь — изнутри vTaskSwitchContext и прерывания тика.
Рекурсия в ядро или ожидание там, где ждать нельзя. Из макроса — только
свои переменные и регистры.
Медленная запись тянет время. snprintf в макросе переключения —
сотни команд на каждое переключение, и трасса показывает уже другую
программу. Запись — фиксированные 8 байт, разбор — на ПК.
Кольцо затёрлось раньше, чем остановили. 2,58 записи на мс — 400 мс
истории; при частых прерываниях с записью в очередь — меньше.
Останавливать запись нужно в момент события (trace_stop в обработчике
отказа или в задаче-стороже, 33а), а не когда заметили.
Номера задач все нули. configUSE_TRACE_FACILITY = 0: полей
uxTCBNumber и uxQueueNumber нет, макросы не соберутся — или
соберутся с чужим полем, если писать их без опоры на ядро.
Мьютекс без номера. Не вызван vQueueSetQueueNumber: события всех
очередей с номером 0, и не отличить ресурс от очереди сообщений.
Учёт времени через минуту — мусор. 32-битный счётчик ядро копит
без защиты от переполнения (26.9); для трассы это не беда — она хранит
разности, — а проценты vTaskGetRunTimeStats после оборота ложные.
Гонка пропала под трассой. Влияние измерения: 29 команд на переключение сдвигают моменты. Пропала — значит, она зависит от времени; ищут её, меняя нагрузку, а не выключая трассу.
33б.8 Итоги
- Ядро FreeRTOS 10.5.1 оставляет 89 пустых макросов
trace…; определённые вFreeRTOSConfig.h, они видятpxCurrentTCBиpxQueue. Для диаграммы хватаетSWITCHED_IN,MOVED_TASK_TO_READY_STATE,INCREMENT_TICK, событий очередей и наследования. - Запись — 8 байт в кольцо из 1024, под
PRIMASK, метка —DWT->CYCCNT(в QEMU — TIM2 по командам). Кольцо с именами — 8304 байта ОЗУ, +464 байта флеш-памяти, 26 команд на запись, +29 на переключение. - Выгрузка — gdb (
dump binary value), RTT или SWO; разбор на ПК превращаетTR_INв отрезки работы, пары событий — в ожидания. - Инверсия на прогоне: H ждёт 9,003 мс на двоичном семафоре, из них 6,001 мс работает M; на мьютексе — 3,002 мс, только остаток L.
- Дрожание period — до 3,001 мс от вспышки старшей задачи; голодание logger — 60,521 мс за poll, которая не уступает процессор. После исправлений — 156…304 команды и 3,501 мс.
- Учёт времени ядром дешевле (+20 команд на переключение) и даёт те же доли, но не порядок событий: инверсию он не показывает.
Полные исходники
trace_rec.h — трассировщик: макросы ядра и формат записи.
/* Раздел 33б: лёгкий трассировщик FreeRTOS — события ядра в кольцо по 8 байт.
 * Подключается в конце FreeRTOSConfig.h: макросы trace… ядра раскрываются внутри tasks.c и queue.c,
 * поэтому им видны pxCurrentTCB, pxQueue и поля TCB (нужен configUSE_TRACE_FACILITY = 1). */
#ifndef TRACE_REC_H
#define TRACE_REC_H

#include <stdint.h>

#ifndef TRACE_ON
#define TRACE_ON 1
#endif
#define TRACE_N      1024u                  /* записей в кольце, степень двойки */
#define TRACE_TASKS  12u                    /* сколько имён задач помнить */
#define TRACE_NAME   8u                     /* = configMAX_TASK_NAME_LEN */

enum {                                      /* код события — байт ev записи */
    TR_IN = 1,          /* задача получила процессор; arg — её текущий приоритет */
    TR_READY,           /* задача стала готовой; task — она, arg — приоритет */
    TR_TICK,            /* тик; arg — младшие 16 бит счёта тиков */
    TR_GIVE,            /* запись в очередь или отдача семафора/мьютекса; arg — номер очереди */
    TR_TAKE,            /* чтение из очереди или взятие; arg — номер очереди */
    TR_WAIT,            /* задача встала ждать очередь; arg — номер очереди */
    TR_INHERIT,         /* держатель мьютекса task поднят до arg */
    TR_DISINHERIT,      /* держатель мьютекса task вернулся к arg */
    TR_DELAY,           /* задача уснула до тика arg */
    TR_MARK             /* метка приложения; arg — её код */
};

typedef struct {
    uint32_t ts;                            /* метка времени: DWT->CYCCNT, в QEMU — TIM2->CNT */
    uint8_t ev;                             /* код события TR_… */
    uint8_t task;                           /* номер задачи uxTCBNumber: 1, 2, … по порядку создания */
    uint16_t arg;                           /* смысл зависит от события */
} trace_rec_t;

typedef struct {
    uint32_t magic;                         /* 'TR33' — читатель на ПК узнаёт блок */
    uint32_t head;                          /* сколько записей сделано всего; в кольце — последние TRACE_N */
    uint32_t n;                             /* TRACE_N */
    uint32_t on;                            /* писать или нет */
    char name[TRACE_TASKS][TRACE_NAME];     /* имя задачи по её номеру */
    trace_rec_t ring[TRACE_N];
} trace_buf_t;

extern trace_buf_t trace_buf;
extern volatile uint32_t trace_cur;         /* номер задачи, что сейчас работает */

uint32_t trace_now(void);
void trace_clock_start(void);
void trace_clock_zero(void);
void trace_ev(uint32_t ev, uint32_t task, uint32_t arg);
void trace_in(uint32_t task, uint32_t prio);
void trace_name(uint32_t task, const char *name);
void trace_start(void);
void trace_stop(void);
void trace_done(void);                      /* точка останова для отладчика: кольцо готово */

#if TRACE_ON
#define traceTASK_CREATE(t)               trace_name((t)->uxTCBNumber, (t)->pcTaskName)
#define traceTASK_SWITCHED_IN()           trace_in(pxCurrentTCB->uxTCBNumber, pxCurrentTCB->uxPriority)
#define traceMOVED_TASK_TO_READY_STATE(t) trace_ev(TR_READY, (t)->uxTCBNumber, (t)->uxPriority)
#define traceTASK_INCREMENT_TICK(n)       trace_ev(TR_TICK, trace_cur, (n) + 1u)
#define traceQUEUE_SEND(q)                trace_ev(TR_GIVE, trace_cur, (q)->uxQueueNumber)
#define traceQUEUE_RECEIVE(q)             trace_ev(TR_TAKE, trace_cur, (q)->uxQueueNumber)
#define traceBLOCKING_ON_QUEUE_RECEIVE(q) trace_ev(TR_WAIT, trace_cur, (q)->uxQueueNumber)
#define traceTASK_PRIORITY_INHERIT(t, p)  trace_ev(TR_INHERIT, (t)->uxTCBNumber, (p))
#define traceTASK_PRIORITY_DISINHERIT(t, p) trace_ev(TR_DISINHERIT, (t)->uxTCBNumber, (p))
#define traceTASK_DELAY_UNTIL(w)          trace_ev(TR_DELAY, trace_cur, (w))
#endif

#endif
trace_rec.c — запись событий в кольцо.
/* Раздел 33б: запись событий ядра в кольцо. Метка времени — счётчик тактов DWT->CYCCNT на камне;
 * в QEMU он читается нулём, поэтому там (TRACE_QEMU) — TIM2 с делителем 1: при -icount shift=0
 * он прибавляет единицу на каждую выполненную команду. */
#include "trace_rec.h"

#ifdef TRACE_QEMU
#define RCC_APB1ENR (*(volatile uint32_t *)0x40023840)
#define TIM2_CR1    (*(volatile uint32_t *)0x40000000)
#define TIM2_EGR    (*(volatile uint32_t *)0x40000014)
#define TIM2_CNT    (*(volatile uint32_t *)0x40000024)
#define TIM2_PSC    (*(volatile uint32_t *)0x40000028)
#define TIM2_ARR    (*(volatile uint32_t *)0x4000002C)
#define TRACE_NOW() TIM2_CNT
#else
#include "stm32f4xx.h"
#define TRACE_NOW() DWT->CYCCNT
#endif

trace_buf_t trace_buf;
volatile uint32_t trace_cur;

uint32_t trace_now(void)
{
    return TRACE_NOW();
}

void trace_clock_start(void)
{
#ifdef TRACE_QEMU
    RCC_APB1ENR |= 1u;                      /* TIM2EN */
    TIM2_PSC = 0u;
    TIM2_ARR = 0xFFFFFFFFu;                 /* TIM2 32-битный: свободный счёт */
    TIM2_EGR = 1u;
    TIM2_CR1 = 1u;
#else
    CoreDebug->DEMCR |= CoreDebug_DEMCR_TRCENA_Msk;
    DWT->CYCCNT = 0u;
    DWT->CTRL |= DWT_CTRL_CYCCNTENA_Msk;
#endif
}

void trace_clock_zero(void)                 /* старт планировщика: учёт времени задач — с нуля */
{
#ifdef TRACE_QEMU
    TIM2_CNT = 0u;
#else
    DWT->CYCCNT = 0u;
#endif
}

static inline uint32_t irq_save(void)
{
    uint32_t pm;
    __asm volatile("mrs %0, primask\n cpsid i" : "=r"(pm)::"memory");
    return pm;
}

static inline void irq_restore(uint32_t pm)
{
    __asm volatile("msr primask, %0" ::"r"(pm) : "memory");
}

void trace_ev(uint32_t ev, uint32_t task, uint32_t arg)
{
    uint32_t pm = irq_save();               /* часть макросов зовётся при открытых прерываниях */
    if (trace_buf.on) {
        trace_rec_t *r = &trace_buf.ring[trace_buf.head & (TRACE_N - 1u)];
        r->ts = TRACE_NOW();
        r->ev = (uint8_t)ev;
        r->task = (uint8_t)task;
        r->arg = (uint16_t)arg;
        trace_buf.head++;                   /* кольцо: новая запись затирает самую старую */
    }
    irq_restore(pm);
}

void trace_in(uint32_t task, uint32_t prio)
{
    trace_cur = task;
    trace_ev(TR_IN, task, prio);
}

void trace_name(uint32_t task, const char *name)
{
    if (task < TRACE_TASKS)
        for (uint32_t i = 0; i < TRACE_NAME; i++)
            trace_buf.name[task][i] = name[i];
}

void trace_start(void)
{
    trace_buf.magic = 0x33335254u;          /* 'TR33' */
    trace_buf.n = TRACE_N;
    trace_buf.head = 0u;
    trace_buf.on = 1u;
}

void trace_stop(void)
{
    trace_buf.on = 0u;
}

__attribute__((noinline)) void trace_done(void)
{
    __asm volatile("" ::: "memory");        /* здесь отладчик забирает trace_buf */
}
FreeRTOSConfig.h — настройки ядра с трассировкой и учётом времени.
/* Раздел 33б: FreeRTOS 10.5.1, порт ARM_CM4F, QEMU netduinoplus2 (STM32F405, Cortex-M4F) и F407.
 * TRACE_ON — макросы trace… ядра пишут в кольцо; STATS_ON — учёт времени задач ядром. */
#ifndef FREERTOS_CONFIG_H
#define FREERTOS_CONFIG_H

#ifndef STATS_ON
#define STATS_ON 1
#endif

#define configUSE_PREEMPTION                    1
#define configUSE_TIME_SLICING                  1
#define configUSE_PORT_OPTIMISED_TASK_SELECTION 0
#define configCPU_CLOCK_HZ                      168000000UL
#define configTICK_RATE_HZ                      1000
#define configMAX_PRIORITIES                    6
#define configMINIMAL_STACK_SIZE                256
#define configTOTAL_HEAP_SIZE                   (32 * 1024)
#define configMAX_TASK_NAME_LEN                 8
#define configUSE_16_BIT_TICKS                  0
#define configIDLE_SHOULD_YIELD                 1
#define configUSE_MUTEXES                       1
#define configSUPPORT_DYNAMIC_ALLOCATION        1
#define configSUPPORT_STATIC_ALLOCATION         0
#define configUSE_IDLE_HOOK                     0
#define configUSE_TICK_HOOK                     0
#define configCHECK_FOR_STACK_OVERFLOW          0
#define configUSE_TIMERS                        0
#define configUSE_CO_ROUTINES                   0
#define configUSE_TRACE_FACILITY                1   /* номера задач и очередей для трассировки */

#if STATS_ON
#define configGENERATE_RUN_TIME_STATS           1
#define configUSE_STATS_FORMATTING_FUNCTIONS    1
#define portCONFIGURE_TIMER_FOR_RUN_TIME_STATS() trace_clock_zero()
#define portGET_RUN_TIME_COUNTER_VALUE()        trace_now()
#else
#define configGENERATE_RUN_TIME_STATS           0
#endif

/* число бит приоритета у QEMU иное, чем у STM32 (4), поэтому configPRIO_BITS не задаём */
#define configKERNEL_INTERRUPT_PRIORITY         (15 << 4)
#define configMAX_SYSCALL_INTERRUPT_PRIORITY    (5 << 4)

#define INCLUDE_vTaskDelay                      1
#define INCLUDE_vTaskDelayUntil                 1
#define INCLUDE_vTaskSuspend                    1

void my_assert(const char *file, int line);
#define configASSERT(x) if (!(x)) my_assert(__FILE__, __LINE__)

#include "trace_rec.h"

#endif
app.c — сценарии: инверсия, дрожание, голодание, цена.
/* Раздел 33б: сценарии для трассировки, QEMU netduinoplus2 с -icount shift=0 (1 мс = 10^6 команд).
 * SCEN 1 — инверсия приоритетов на двоичном семафоре, 2 — то же на мьютексе,
 * 3 — нагрузка: дрожание периодической задачи и голодание, 4 — то же после исправлений,
 * 5 — цена: запись в кольцо и переключение задач. */
#include <stdint.h>
#include "FreeRTOS.h"
#include "task.h"
#include "semphr.h"

#ifndef SCEN
#define SCEN 1
#endif

void puts1(const char *s);
void putdec(uint32_t v);

#define LOOPS_PER_MS 333333u                /* цикл work — 3 команды на оборот (проверено трассой) */

__attribute__((noinline)) static void work_ms(uint32_t tenth)   /* работа без ожидания: tenth — десятые доли мс */
{
    for (uint32_t i = 0; i < tenth * (LOOPS_PER_MS / 10u); i++)
        __asm volatile("");
}

#if SCEN != 5
static void finish(uint32_t run_ms)
{
    vTaskDelay(pdMS_TO_TICKS(run_ms));
    trace_stop();
#if configGENERATE_RUN_TIME_STATS
    static char buf[512];
    vTaskGetRunTimeStats(buf);
    puts1("stats:\r\n");
    puts1(buf);
#endif
    puts1("head=");
    putdec(trace_buf.head);
    puts1("\r\ndone\r\n");
    trace_done();
    for (;;)
        vTaskDelay(1000);
}
#endif

#if SCEN == 1 || SCEN == 2
/* ── инверсия: H ждёт ресурс, который держит L, а M ни при чём ── */
static SemaphoreHandle_t lock;

static void task_l(void *arg)
{
    (void)arg;
    xSemaphoreTake(lock, portMAX_DELAY);
    work_ms(40);                            /* 4 мс с ресурсом */
    xSemaphoreGive(lock);
    vTaskSuspend(NULL);
}

static void task_h(void *arg)
{
    (void)arg;
    vTaskDelay(pdMS_TO_TICKS(1));
    xSemaphoreTake(lock, portMAX_DELAY);
    work_ms(10);                            /* 1 мс с ресурсом */
    xSemaphoreGive(lock);
    vTaskSuspend(NULL);
}

static void task_m(void *arg)
{
    (void)arg;
    vTaskDelay(pdMS_TO_TICKS(2));
    work_ms(60);                            /* 6 мс своей работы, ресурс не нужен */
    vTaskSuspend(NULL);
}

static void task_ctl(void *arg)
{
    (void)arg;
    finish(20);
}

static void setup(void)
{
#if SCEN == 1
    lock = xSemaphoreCreateBinary();
    xSemaphoreGive(lock);
#else
    lock = xSemaphoreCreateMutex();
#endif
    vQueueSetQueueNumber(lock, 1);
    xTaskCreate(task_ctl, "ctl", 256, NULL, 5, NULL);
    xTaskCreate(task_h, "H", 256, NULL, 3, NULL);
    xTaskCreate(task_m, "M", 256, NULL, 2, NULL);
    xTaskCreate(task_l, "L", 256, NULL, 1, NULL);
}
#endif

#if SCEN == 3 || SCEN == 4
/* ── нагрузка: burst мешает period, poll морит голодом logger ── */
#define FIX (SCEN == 4)

static void task_burst(void *arg)           /* приоритет 3: раз в 7 мс вспышка 1; 3; 0,5; 2 мс */
{
    static const uint8_t len[4] = {10, 30, 5, 20};
    TickType_t wake = xTaskGetTickCount();
    (void)arg;
    for (uint32_t k = 0;; k++) {
        vTaskDelayUntil(&wake, pdMS_TO_TICKS(7));
        work_ms(len[k % 4u]);
    }
}

static void task_period(void *arg)          /* раз в 5 мс, 0,5 мс работы */
{
    TickType_t wake = xTaskGetTickCount();
    (void)arg;
    for (;;) {
        vTaskDelayUntil(&wake, pdMS_TO_TICKS(5));
        work_ms(5);
    }
}

static void task_poll(void *arg)            /* приоритет 2: с 100-й по 160-ю мс опрашивает флаг */
{
    (void)arg;
    vTaskDelay(pdMS_TO_TICKS(100));
    while (xTaskGetTickCount() < pdMS_TO_TICKS(160)) {
        work_ms(1);
#if FIX
        vTaskDelay(1);                      /* исправление: отдать процессор между опросами */
#endif
    }
    vTaskSuspend(NULL);
}

static void task_logger(void *arg)          /* приоритет 1: раз в 10 мс, 0,5 мс работы */
{
    TickType_t wake = xTaskGetTickCount();
    (void)arg;
    for (;;) {
        vTaskDelayUntil(&wake, pdMS_TO_TICKS(10));
        work_ms(5);
    }
}

static void task_ctl(void *arg)
{
    (void)arg;
    finish(200);
}

static void setup(void)
{
    xTaskCreate(task_ctl, "ctl", 512, NULL, 5, NULL);
    xTaskCreate(task_burst, "burst", 256, NULL, 3, NULL);
    xTaskCreate(task_period, "period", 256, NULL, FIX ? 4 : 2, NULL);
    xTaskCreate(task_poll, "poll", 256, NULL, 2, NULL);
    xTaskCreate(task_logger, "logger", 256, NULL, 1, NULL);
}
#endif

#if SCEN == 5
/* ── цена: 1000 оборотов «A уступает B, B уступает A» ── */
#define ROUNDS 1000u

static void task_b(void *arg)
{
    (void)arg;
    for (;;)
        taskYIELD();
}

static void task_a(void *arg)
{
    (void)arg;
    uint32_t t0 = trace_now();
    for (uint32_t i = 0; i < ROUNDS; i++)
        taskYIELD();
    uint32_t t1 = trace_now();
    puts1("yield: ");
    putdec(t1 - t0);
    puts1(" commands for ");
    putdec(2u * ROUNDS);
    puts1(" switches\r\n");
    trace_stop();
    puts1("head=");
    putdec(trace_buf.head);
    puts1("\r\ndone\r\n");
    trace_done();
    vTaskSuspend(NULL);
}

static void cost_of_record(void)
{
    trace_start();
    uint32_t t0 = trace_now();
    for (uint32_t i = 0; i < 100u; i++)
        __asm volatile("" ::: "memory");
    uint32_t t1 = trace_now();
    for (uint32_t i = 0; i < 100u; i++)
        trace_ev(TR_MARK, 0, i);
    uint32_t t2 = trace_now();
    puts1("loop100: ");
    putdec(t1 - t0);
    puts1(" record100: ");
    putdec(t2 - t1);
    puts1("\r\n");
}

static void setup(void)
{
    cost_of_record();
    xTaskCreate(task_a, "A", 256, NULL, 1, NULL);
    xTaskCreate(task_b, "B", 256, NULL, 1, NULL);
}
#endif

int main(void)
{
    trace_clock_start();
    puts1("scen=");
    putdec(SCEN);
    puts1(" trace=");
    putdec(TRACE_ON);
    puts1(" stats=");
    putdec(configGENERATE_RUN_TIME_STATS);
#ifdef TRACE_QEMU
    *(volatile uint32_t *)0xE000EDFC |= 1u << 24;          /* DEMCR.TRCENA */
    *(volatile uint32_t *)0xE0001000 |= 1u;                /* DWT_CTRL.CYCCNTENA */
    uint32_t c0 = *(volatile uint32_t *)0xE0001004, t0 = trace_now();
    work_ms(1);
    puts1(" cyccnt=");
    putdec(*(volatile uint32_t *)0xE0001004 - c0);         /* QEMU 7.2: DWT нет, читается нулём */
    puts1(" tim2=");
    putdec(trace_now() - t0);                              /* 0,1 мс работы: 3 команды × 33333 оборота */
#endif
    puts1("\r\n");
    setup();
    trace_start();                          /* имена задач уже записаны: trace_name не смотрит на on */
    vTaskStartScheduler();
    puts1("no scheduler\r\n");
    for (;;) {
    }
}
tdiag.py — разбор кольца на ПК.
# -*- coding: utf-8 -*-
"""Раздел 33б: разбор кольца трассировщика FreeRTOS на ПК.

python tdiag.py <файл.bin> [--svg out.svg] [--from мс --to мс] [--step мс]

Файл — trace_buf, выгруженный отладчиком (gdb: dump binary value f.bin trace_buf). Печатает временную
диаграмму задач текстом (одна клетка — 0,25 мс), отрезки работы, ожидания ресурса, задержку
«стала готовой → получила процессор» и долю процессора каждой задачи."""
import os
import struct
import sys

EV = {1: "IN", 2: "READY", 3: "TICK", 4: "GIVE", 5: "TAKE", 6: "WAIT", 7: "INHERIT", 8: "DISINHERIT", 9: "DELAY", 10: "MARK"}
TRACE_TASKS, TRACE_NAME = 12, 8


def load(path):
    raw = open(path, "rb").read()
    magic, head, n, on = struct.unpack_from("<4I", raw, 0)
    assert magic == 0x33335254, "нет признака TR33"
    off = 16
    names = {}
    for i in range(TRACE_TASKS):
        s = raw[off + i * TRACE_NAME: off + (i + 1) * TRACE_NAME].split(b"\0")[0].decode("ascii", "replace")
        if s:
            names[i] = s
    off += TRACE_TASKS * TRACE_NAME
    recs = [struct.unpack_from("<IBBH", raw, off + 8 * i) for i in range(n)]
    first = max(0, head - n)                              # кольцо: живы последние n записей
    ev = [recs[i % n] for i in range(first, head)]
    return names, ev, head, n


def analyse(names, ev):
    start = next(i for i, e in enumerate(ev) if e[1] == 1)   # до первого IN — записи до обнуления счётчика
    ev = ev[start:]
    t0 = ev[0][0]
    ts, last = [], t0
    base = 0
    for e in ev:                                           # счётчик 32 бита: разворачиваем переполнение
        if e[0] < last:
            base += 1 << 32
        last = e[0]
        ts.append(base + e[0] - t0)
    ticks = [t for t, e in zip(ts, ev) if e[1] == 3]
    per_ms = (ticks[-1] - ticks[0]) / (len(ticks) - 1) if len(ticks) > 1 else 1e6   # счёт на тик = на 1 мс
    tick0 = ticks[0] - per_ms if ticks else 0              # момент тика 0 — по первому тику
    ms = lambda t: (t - tick0) / per_ms
    runs, cur, since = [], None, None
    for t, e in zip(ts, ev):
        if e[1] == 1:
            if cur is not None:
                runs.append((cur, ms(since), ms(t), prio))
            cur, since, prio = e[2], t, e[3]
    end = ts[-1]
    if cur is not None:
        runs.append((cur, ms(since), ms(end), prio))
    return dict(ev=ev, ts=ts, ms=ms, runs=runs, per_ms=per_ms, end=ms(end))


def lanes(names, a, t_from, t_to, step=0.25):
    order = [k for k in sorted({r[0] for r in a["runs"]}, key=lambda k: -max(r[3] for r in a["runs"] if r[0] == k))
             if sum(r[2] - r[1] for r in a["runs"] if r[0] == k) > 0.01]
    out = []
    width = int((t_to - t_from) / step)
    for k in order:
        base = min(r[3] for r in a["runs"] if r[0] == k)
        own, inh = [0.0] * width, [0.0] * width             # сколько клетки задача проработала
        for task, b, e, prio in a["runs"]:
            if task != k:
                continue
            for c in range(max(0, int((b - t_from) / step)), min(width, int((e - t_from) / step) + 1)):
                o = min(e, t_from + (c + 1) * step) - max(b, t_from + c * step)
                if o > 0:
                    (own if prio == base else inh)[c] += o
        row = ["^" if inh[c] >= step / 2 else "#" if own[c] + inh[c] >= step / 2 else "." if own[c] + inh[c] > step / 20 else " "
               for c in range(width)]
        out.append("%-7s|%s|" % (names.get(k, "?%d" % k), "".join(row)))
    every = 1 if step <= 0.25 else 5                      # подписи шкалы: каждую 1 или 5 мс
    scale = [" "] * (width + 6)
    t = t_from
    while t <= t_to:
        lab = "%g" % t
        c = int(round((t - t_from) / step))
        scale[c:c + len(lab)] = lab
        t += every
    out.append("%-7s %s" % ("мс", "".join(scale).rstrip()))
    return out


def report(path, t_from=None, t_to=None, svg=None, step=0.25):
    names, ev, head, n = load(path)
    a = analyse(names, ev)
    ms = a["ms"]
    print("файл %s: записей %d, в кольце %d, счёт на 1 мс %.0f" % (os.path.basename(path), head, min(head, n), a["per_ms"]))
    # отрезки работы
    print("отрезки работы (задача: с … по, мс):")
    for task, b, e, prio in a["runs"]:
        if e - b >= 0.05 and names.get(task) != "IDLE":
            print("  %-7s %7.3f … %7.3f  (%.3f мс, приоритет %d)" % (names.get(task, "?"), b, e, e - b, prio))
    # события ресурса
    for t, e in zip(a["ts"], a["ev"]):
        if e[1] in (4, 5, 6, 7, 8) and e[3] == 1 or e[1] in (7, 8):
            print("  %8.3f мс %-10s %-7s арг %d" % (ms(t), EV[e[1]], names.get(e[2], "?"), e[3]))
    # ожидание ресурса: WAIT → следующий TAKE той же задачей
    waits = {}
    pend = {}
    for t, e in zip(a["ts"], a["ev"]):
        if e[1] == 6:
            pend[e[2]] = t
        elif e[1] == 5 and e[2] in pend:
            waits.setdefault(e[2], []).append((ms(pend[e[2]]), ms(t)))
            del pend[e[2]]
    for k, w in waits.items():
        for b, e in w:
            print("ожидание ресурса %s: %.3f … %.3f мс = %.3f мс" % (names.get(k), b, e, e - b))
            busy = {}
            for task, rb, re_, prio in a["runs"]:
                o = min(e, re_) - max(b, rb)
                if o > 0 and task != k:
                    busy[task] = busy.get(task, 0.0) + o
            print("  пока ждала, работали: " + ", ".join("%s %.3f мс" % (names.get(t), busy[t]) for t in sorted(busy, key=lambda t: -busy[t])))
    # готова → работает
    ready = {}
    lat = {}
    starts = {}
    for t, e in zip(a["ts"], a["ev"]):
        if e[1] == 2 and e[2] not in ready:
            ready[e[2]] = t
        elif e[1] == 1 and e[2] in ready:
            lat.setdefault(e[2], []).append((ms(ready[e[2]]), t - ready.pop(e[2])))
            starts.setdefault(e[2], []).append(ms(t))
    for k in sorted(lat):
        if names.get(k) in ("IDLE", "ctl"):
            continue
        v = [x[1] for x in lat[k] if x[0] >= 1.0]          # первый запуск при старте не считаем
        if v:
            worst = max(lat[k], key=lambda x: x[1])
            print("готова→работает %-7s раз %3d: от %d до %d отсчётов (%.3f мс), среднее %.3f мс; худшее — готова на %.0f мс"
                  % (names.get(k), len(v), min(v), max(v), max(v) / a["per_ms"], sum(v) / len(v) / a["per_ms"], worst[0]))
    # доли процессора
    tot = {}
    for task, b, e, prio in a["runs"]:
        tot[task] = tot.get(task, 0.0) + (e - b)
    span = sum(tot.values())
    print("доли процессора по трассе за %.3f мс:" % span)
    for k in sorted(tot, key=lambda k: -tot[k]):
        print("  %-7s %8.3f мс %5.1f %%" % (names.get(k), tot[k], 100.0 * tot[k] / span))
    cnt = {}
    for e in a["ev"]:
        cnt[EV[e[1]]] = cnt.get(EV[e[1]], 0) + 1
    print("события: " + ", ".join("%s %d" % (k, cnt[k]) for k in sorted(cnt, key=lambda k: -cnt[k])))
    print("записей на 1 мс: %.2f; в среднем между записями %.1f отсчёта"
          % (len(a["ev"]) / a["end"], (a["ts"][-1] - a["ts"][0]) / (len(a["ts"]) - 1)))
    if t_from is not None:
        print("диаграмма %g … %g мс, клетка %g мс (# — работает полклетки и больше, . — меньше, ^ — с унаследованным приоритетом):" % (t_from, t_to, step))
        for ln in lanes(names, a, t_from, t_to, step):
            print(ln)
    if svg:
        open(svg, "w", encoding="utf-8").write(to_svg(names, a, t_from or 0, t_to or a["end"]))
    return names, a


def to_svg(names, a, t_from, t_to):
    order = sorted({r[0] for r in a["runs"]}, key=lambda k: -max(r[3] for r in a["runs"] if r[0] == k))
    W, x0, row = 900, 80, 28
    X = lambda t: x0 + (t - t_from) * (W - x0 - 10) / (t_to - t_from)
    h = 30 + row * len(order) + 30
    p = ['<svg xmlns="http://www.w3.org/2000/svg" width="%d" height="%d" font-family="sans-serif" font-size="12">' % (W, h),
         '<rect width="100%" height="100%" fill="#fff"/>']
    for i, k in enumerate(order):
        y = 20 + i * row
        p.append('<text x="4" y="%d">%s</text>' % (y + 16, names.get(k, "?")))
        p.append('<line x1="%d" y1="%d" x2="%d" y2="%d" stroke="#ccc"/>' % (x0, y + 22, W - 10, y + 22))
        base = min(r[3] for r in a["runs"] if r[0] == k)
        for task, b, e, prio in a["runs"]:
            if task == k and e > t_from and b < t_to:
                p.append('<rect x="%.1f" y="%d" width="%.1f" height="18" fill="%s"/>'
                         % (X(max(b, t_from)), y + 4, max(0.5, X(min(e, t_to)) - X(max(b, t_from))), "#00629B" if prio == base else "#C62828"))
    for t in range(int(t_from), int(t_to) + 1):
        p.append('<text x="%.1f" y="%d" text-anchor="middle" fill="#666">%d</text>' % (X(t), h - 8, t))
    p.append("</svg>")
    return "".join(p)


if __name__ == "__main__":
    sys.stdout.reconfigure(encoding="utf-8")
    args = sys.argv[1:]
    svg = t_from = t_to = None
    step = 0.25
    if "--step" in args:
        i = args.index("--step")
        step = float(args[i + 1])
        del args[i:i + 2]
    if "--svg" in args:
        i = args.index("--svg")
        svg = args[i + 1]
        del args[i:i + 2]
    if "--from" in args:
        i = args.index("--from")
        t_from, t_to = float(args[i + 1]), float(args[i + 3])
        del args[i:i + 4]
    report(args[0], t_from, t_to, svg, step)
Дальше: раздел 34 «Макросы FreeRTOS» — справочная таблица всего, что встретилось в части IV, и вопросы для самопроверки.