 Embedded HandbookПриложения
198д. Мини-проект: логический анализатор из BluePill
Последний мини-проект — измерительный. В разделе 36а логический анализатор стоит в списке приборов на столе; пока его там нет, роль приставки на восемь каналов сыграет сама BluePill: таймер задаёт частоту выборки, DMA переносит порт в кольцевой буфер, UART отдаёт запись на компьютер, а Python разбирает её и превращает в файл для программы просмотра. По дороге — честная арифметика: какой потолок частоты выборки следует из устройства шин, сколько миллисекунд влезает в 20 КБ ОЗУ и сколько секунд уходит на выгрузку.
Это прибор «пока прибора нет»: покупная приставка из раздела 36а.6 пишет 8 каналов на 24 Мвыб/с часами напролёт — наша самоделка снимает 16 384 выборки и не быстрее 4,5 Мвыб/с. Зато в ней видно, как логический анализатор устроен изнутри — вплоть до предзаписи и отметки запуска.
Файлы — _verify/la198d/: la_f103.c (прошивка), start_f103.c,
la_host.py (модель захвата, разборщик и конвертер в VCD). Прошивка
собрана для Cortex-M3, модель прогнана на компьютере с самотестом.
Сверяет _verify/la198d_check.py.
Как это называется в документации
Оригинал Перевод memory depth, capture depth глубина записи: сколько выборок помещается в памяти прибора armed «взведён»: запись уже идёт, прибор ждёт условия запуска post-trigger послезапись: часть буфера после момента запуска metastability метастабильность: защёлка, «зависшая» между 0 и 1 synchronizer синхронизатор: две защёлки подряд на асинхронном входе value change dump (VCD) текстовый формат записи сигналов: моменты переключений run-length encoding (RLE) кодирование длинами серий: хранить длительности уровней bus matrix матрица шин: арбитр между процессором и DMA
198д.1 Что делает прибор и что ему не по силам
| Функция | Как |
|---|---|
| восемь каналов | PB0…PB7: младший байт GPIOB->IDR — одна выборка = один байт |
| частота выборки | сетка 100 квыб/с … 4,5 Мвыб/с от TIM2 (кварц ×9 = 72 МГц) |
| глубина записи | кольцо 16 384 выборки — 16,4 мс при 1 Мвыб/с |
| запуск | фронт вверх или вниз на любом из каналов, через EXTI |
| предзапись | четверть кольца — история до фронта, даром |
| выгрузка | USART1: 115 200 или 921 600 бод, свой формат «LA1» |
| на компьютере | временная диаграмма, разбор UART, конвертер в VCD для PulseView |
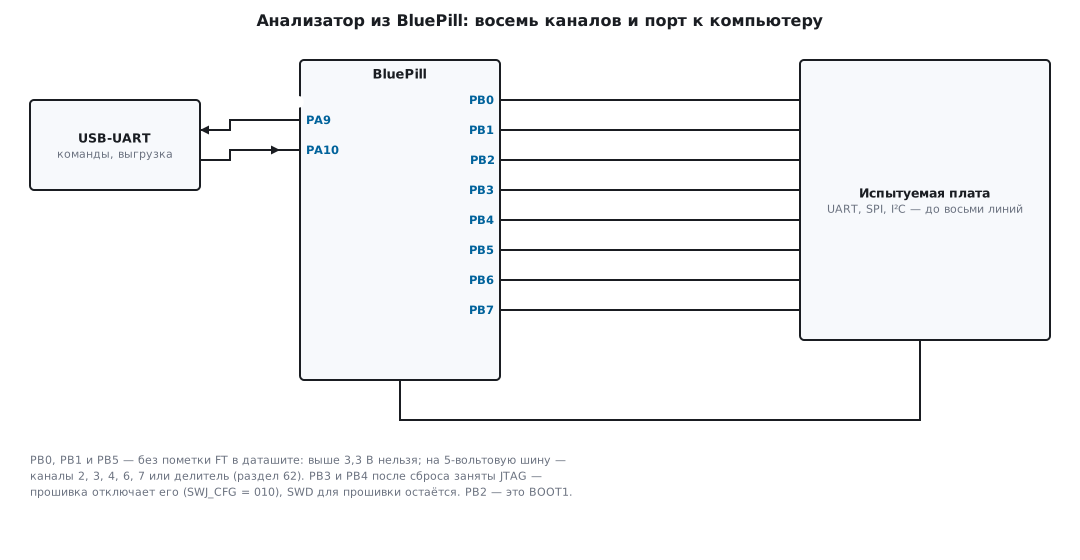
Каналы — весь нижний байт порта B. Два вывода с особенностями: PB2 — это
BOOT1 (на BluePill он заведён на перемычку через резистор — слабый делитель
сигналу не мешает), а PB3 и PB4 после сброса принадлежат JTAG. Прошивка
отключает JTAG первой же строкой настройки (SWJ_CFG = 010 в AFIO_MAPR —
«JTAG-DP выключен, SW-DP включён»), так что прошиваться по SWD можно
по-прежнему, а PB3 и PB4 становятся обычными входами.
⚠️ Три канала из восьми не терпят 5 В. В таблице выводов даташита F103 у PB0, PB1 и PB5 нет пометки FT: их предел — VDD + 0,3 В. FT-входы (остальные пять каналов) держат до 5,5 В. Пятивольтовую шину подключают к каналам 2, 3, 4, 6, 7 — или через делитель (раздел 62). Это относится и к I²C с подтяжками к 5 В.
Что можно разглядывать, решает правило из раздела 36а.6 — не меньше четырёх-пяти выборок на бит: при 1 Мвыб/с это UART 115 200 (8,7 выборки на бит — с запасом), при 4,5 Мвыб/с — SPI и I²C до сотен килогерц. Для шин на мегагерцы и поиска наносекундных выбросов нужен настоящий прибор или осциллограф (раздел 36а).
198д.2 Потолок частоты выборки: считаем по шинам
Путь одной выборки: TIM2 доходит до конца счёта — событие обновления —
запрос DMA — DMA читает GPIOB->IDR — пишет байт в ОЗУ. Прежде чем
обещать мегагерцы, посчитаем, во что этот путь обходится.
- Порт B висит на APB2, мост AHB/APB работает синхронно, APB2 у нас на полных 72 МГц. Чтение через мост — не меньше двух тактов: такт адреса и такт данных, так устроена шина APB.
- Запись байта в ОЗУ — ещё один такт AHB.
- Справочное руководство напоминает: каждая пересылка DMA — три операции (чтение источника, запись приёмника, пересчёт счётчика), плюс арбитраж на матрице шин. Ещё два-три такта накладных.
Итого выборка занимает не меньше пяти тактов по 72 МГц — потолок около 14 Мвыб/с, и то если DMA один на шине. Он не один: матрица шин делит доступ по кругу и гарантирует процессору не меньше половины полосы — значит, и DMA в худшем случае достаётся только половина. Поэтому верхняя ступень сетки — 4,5 Мвыб/с: 16 тактов на выборку, трёхкратный запас к расчётным пяти. Быстрее не обещаем: пропуск выборки DMA ничем не сообщит (198д.9), а «анализатор, который иногда врёт» хуже, чем никакой. Процессор на время захвата уходит с дороги: читает только счётчик DMA.
Память считается проще. Одна выборка — байт, кольцо — 16 КБ из 20 КБ ОЗУ (остальное — стек и переменные; отдать все 20 КБ = 20,5 мс не выйдет):
| Частота выборки | Кольцо 16 384 выборки | Такт на выборку |
|---|---|---|
| 4,5 Мвыб/с | 3,6 мс | 16 |
| 1 Мвыб/с | 16,4 мс | 72 |
| 500 квыб/с | 32,8 мс | 144 |
| 100 квыб/с | 164 мс | 720 |
198д.3 Захват: таймер задаёт шаг, DMA носит байты
Частоту выборки задаёт TIM2: ARR = 72 МГц / f − 1, по каждому событию
обновления — запрос DMA (бит UDE в DIER; сами таймеры — раздел 13,
карта «какой запрос на каком канале» — раздел 9: TIM2_UP обслуживает
канал 2 DMA1). Канал настроен так:
    DMA1_Channel2->CPAR = (uint32_t)&GPIOB->IDR;  /* источник: порт B, чтение словом */
    DMA1_Channel2->CMAR = (uint32_t)ring;
    DMA1_Channel2->CNDTR = N;
    DMA1_Channel2->CCR = DMA_CCR2_PSIZE_1 | DMA_CCR2_MINC | DMA_CCR2_CIRC | DMA_CCR2_EN;
Две неочевидные ширины. Регистры GPIO у F1 положено читать только
32-битными словами — поэтому источник объявлен 32-битным (PSIZE_1),
а приёмник байтовый: по таблице ширин из справочного руководства DMA
в этом случае пишет в память младший байт прочитанного слова — как раз
PB0…PB7. Один запрос — один байт кольца, процессор не участвует.
Дальше запускается сам захват:
    TIM2->ARR = (uint16_t)(FCLK / rates[rate_i] - 1u);
    TIM2->EGR = TIM_EGR_UG;                       /* применить ARR сразу */
    TIM2->DIER = TIM_DIER_UDE;                    /* запрос DMA по событию обновления */
    TIM2->CR1 = TIM_CR1_CEN;                      /* выборки пошли */
🔧 Рецепт: проверить сетку выборки меандром. Настроить на PA8 ШИМ 100 кГц со скважностью 50 % (раздел 13.5) и перемычкой завести его на канал 7. В записи при 1 Мвыб/с период обязан быть ровно 10 выборок — если получается 11–12 «через раз», выборки теряются, частоту выборки надо снижать. Такой самопроверкой стоит встречать каждую новую скорость.
198д.4 Запуск: ждать фронт, не теряя начала
Наивный план «увидели фронт — начали писать» теряет самое интересное: то, что было до фронта, — а хочется видеть, например, состояние линий перед стартом обмена. Решение всех настоящих анализаторов — писать всегда: DMA работает в циклическом режиме (раздел 9) и гоняет кольцо по кругу ещё до всякого запуска. Фронт ничего не запускает — он лишь ставит отметку.
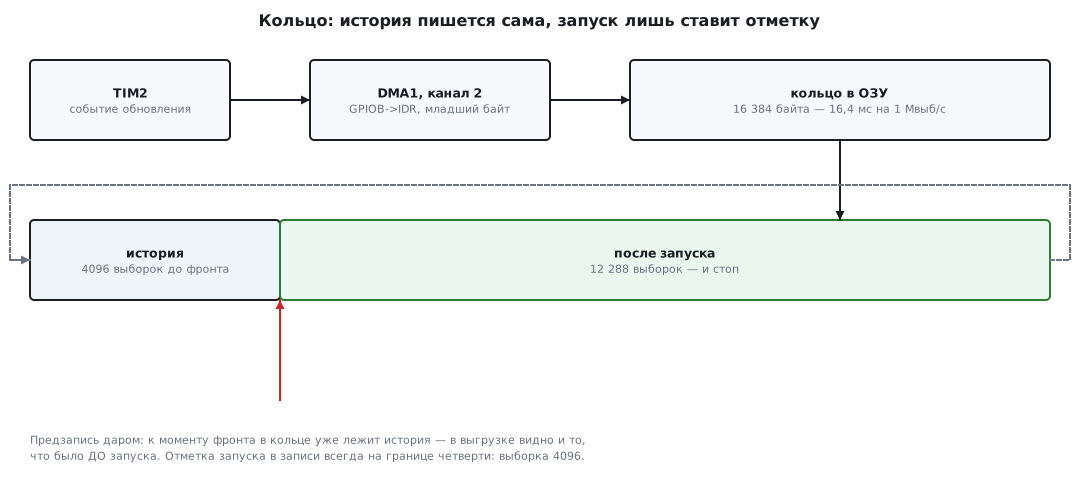
Фронт ловит EXTI (раздел 7): линия по номеру канала, порт B, фронт вверх или вниз. Обработчик крошечный:
void EXTI_IRQHandler(void)
{
    trig_ndtr = DMA1_Channel2->CNDTR;   /* где кольцо было в момент фронта */
    EXTI->PR = 0xFFu;                   /* снять запросы */
    EXTI->IMR &= ~0xFFu;                /* второй фронт уже не нужен */
    triggered = 1;
}
Порядок такой: взвели — прошивка сперва даёт кольцу накопить предзапись (четверть кольца, 4096 выборок) и только потом разрешает EXTI. После фронта дописываются оставшиеся 12 288 выборок — и таймер останавливается. В выгруженной записи отметка запуска поэтому всегда стоит ровно на выборке 4096, а перед ней — настоящая история входов.
Отметка не идеальна: вход в прерывание — 12 тактов плюс хвосты (раздел 7),
и CNDTR читается с запозданием. На 4,5 Мвыб/с (16 тактов на выборку)
отметка может уехать на одну-две выборки — сами данные при этом не
искажаются ни на бит: их пишет DMA, которому до прерываний дела нет.
198д.5 Выгрузка: свой формат и сколько ждать
После остановки кольцо разворачивается по времени — от самой старой выборки к самой свежей — и уходит в USART1 с 16-байтовым заголовком:
| Байты | Что |
|---|---|
| 0…3 | LA1 и версия формата (1) |
| 4…7 | частота выборки, Гц |
| 8…11 | число выборок (16 384) |
| 12…15 | номер выборки с отметкой запуска |
    uint32_t start = (N - DMA1_Channel2->CNDTR) & (N - 1u);  /* самая старая выборка */
    uint32_t trig = (N - trig_ndtr) & (N - 1u);              /* выборка момента запуска */
    for (uint32_t i = 0; i < N; i++)
        tx(ring[(start + i) & (N - 1u)]);         /* кольцо — по порядку времени */
Выгрузка — (16 + 16 384) байта, по 10 бит на байт — 164 000 бит:
| Скорость порта | Делитель BRR | Фактически | Время выгрузки |
|---|---|---|---|
| 115 200 бод | 625 | ровно 115 200 | 1,42 с |
| 921 600 бод | 78 | 923 077 бод (+0,16 %) | 0,18 с |
Ровно 921 600 из 72 МГц не делится — ближайший целый делитель 78 даёт
923 077 бод; ошибка 0,16 % для UART незаметна (допуск — около 2 %,
раздел 16). Команды прибору — однобайтовые: 0…7 — канал запуска,
a/A — взвести по фронту вниз/вверх, g — снять без условия,
s — следующая частота выборки, u — переключить скорость порта.
Сборка arm-none-eabi-gcc -Os для Cortex-M3, без предупреждений:
1272 байта Flash и 16 396 байт ОЗУ, из них 16 384 — кольцо.
Прошивка — младший брат: почти вся работа лежит на DMA и компьютере.
198д.6 Разбор на компьютере: диаграмма, UART и VCD
Компьютерная половина — la_host.py. Она читает выгрузку, печатает
кусок временной диаграммы вокруг отметки запуска:
к0  ▔▔▔▔▔▔▔▔▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁
к1  ▁▁▔▔▔▔▔▔▔▔▔▔▁▁▁▁▁▁▁▁▁▁▔▔▔▔▔▔▔▔▔▔
            ^ запуск (выборка 4096)
— и разбирает UART: старт по фронту вниз, каждый бит читается в середине:
        if prev == 1 and cur == 0:                    # старт-бит
            byte = 0
            for bit in range(8):
                p = k + (1.5 + bit) * spb             # середина бита данных
После стоп-бита разборщик прыгает в его середину и ждёт настоящий фронт следующего старта — пересинхронизация на каждом байте, как в живом приёмнике UART (раздел 16). Без неё передатчик со скоростью на 2 % выше уезжал бы на 1,7 выборки за кадр, и к пятому байту разбор рассыпался.
Тот же скрипт — конвертер в VCD: текстовый формат «моменты переключений и новые значения», который PulseView (раздел 36а.6) открывает как импорт, — и запись самодельного прибора попадает в те же разборщики протоколов, что и запись покупного:
$timescale 1 ns $end
$var wire 1 ! k0 $end
...
#4096000
0!
Самотест. Модель в la_host.py повторяет алгоритм прошивки один
в один: кольцо, предзапись, фронт, отметка, выгрузка «LA1». Генератор
подаёт на канал 0 посылку UART 115 200 при 1 Мвыб/с в 20 разных фазах
относительно сетки выборки, запись прогоняется через разборщик:
phases 20/20 байт-в-байт, посылка b'la198d' (6 байт)
mark=[4096] (предзапись ровно PRE)
tx+2%: 20/20
Все 20 фаз разобраны байт-в-байт, отметка запуска в каждой записи — на выборке 4096, до неё — тишина линии (история цела). И с передатчиком, завышенным на 2 %, — тоже 20 из 20: запас 8,7 выборки на бит работает.
198д.7 Ограничения — честно
- Момент выборки дрожит. Выборка случается не в такт таймера, а в момент, когда DMA добрался до чтения порта: между запросом и чтением — синхронизация и арбитраж, и этот сдвиг гуляет на несколько тактов по 14 нс. На 1 Мвыб/с — незаметно, на 4,5 Мвыб/с — уже проценты периода. Плюс обычное квантование: любой фронт известен с точностью ±1 выборка (раздел 36а.6).
- Вход асинхронный. Фронт, пришедший впритык к выборке, может защёлкнуться «между 0 и 1» — метастабильность. Для разглядывания протоколов это не страшно: бит уедет на одну выборку; настоящие приборы ставят на входе синхронизатор — две защёлки подряд.
- Порог не настраивается. Входы читают уровни по правилам своего порта (раздел 8): для 1,8-вольтовой логики прибор с настраиваемым порогом — из раздела 36а.
- Запись конечна. 16 384 выборки, потом пауза на выгрузку — редкое событие караулят запуском по фронту, а не длинной записью.
198д.8 Что улучшить
- Кодирование длинами серий (RLE): хранить не выборки, а пары «уровень — длительность». Медленные шины с длинными паузами влезают в то же кольцо в десятки раз глубже.
- Потоковый съём на малых скоростях: 923 077 бод — это 92 300 байт/с, поток покрывает выборку примерно до 90 квыб/с. Добавить ступень 50 квыб/с — и писать на компьютер без остановки, глубина ограничена только диском.
- USB вместо UART (раздел 20): у F103 есть USB — выгрузка в разы быстрее и без переходника.
- Шестнадцать каналов: приёмник DMA — полуслово, весь порт B; глубина кольца при этом падает вдвое.
198д.9 Грабли
Каналы 3 и 4 молчат или читаются мусором. PB3 и PB4 после сброса
принадлежат JTAG. Отключить JTAG (SWJ_CFG = 010) — SWD для прошивки
останется.
На неподключённых каналах — случайная «активность». Вход без подтяжки висит и ловит наводки (раздел 8). Это не сигнал; подтягивать все восемь входов не стоит — подтяжка грузит испытуемую линию.
Меандр 100 кГц в записи «плавает»: то 10 выборок период, то 12. Частота выборки выше, чем DMA успевает обслуживать: запрос таймера пришёл, пока прежний не завершён, — выборка молча пропала, флага ошибки нет. Держаться обоснованной сетки и проверять её меандром (рецепт в 198д.3).
Взвели — а фронт, пришедший сразу после команды, пропущен. Прошивка сначала копит предзапись (4096 выборок: при 100 квыб/с это 41 мс) и лишь потом разрешает EXTI. Это цена гарантированной истории до запуска.
UART в записи разбирается через раз. Мало выборок на бит: правило из раздела 36а.6 — не меньше четырёх-пяти, а если передатчик тактируется от RC-генератора (±2 %), — с запасом. Поднять частоту выборки.
После сеанса на 5-вольтовой шине плата стала греться. PB0, PB1 или PB5 — без FT: 5 В на них — за пределом абсолютного максимума даташита. Пятивольтовое — только на FT-каналы или через делитель (раздел 62).
198д.10 Итоги
- Анализатор = TIM2 (частота выборки) + DMA в кольцо (запись) + EXTI (отметка запуска) + UART (выгрузка) + Python (разбор и VCD).
- Потолок — из шин: не меньше пяти тактов на выборку → около 14 Мвыб/с в идеале; обещаем 4,5 Мвыб/с — 16 тактов на выборку, трёхкратный запас.
- Кольцо 16 384 выборки: 16,4 мс при 1 Мвыб/с; предзапись — четверть кольца, отметка запуска всегда на выборке 4096.
- Выгрузка 164 000 бит: 1,42 с при 115 200 бод и 0,18 с при 921 600 (делитель 78 — фактически 923 077 бод, ошибка 0,16 %).
- Самотест модели: 20 фаз байт-в-байт, и с передатчиком +2 % — тоже 20/20.
- Прошивка — 1272 байта Flash, 16 396 байт ОЗУ; каналы PB0, PB1, PB5 — только 3,3 В, остальные пять — FT до 5,5 В.
Полные исходники
la_f103.c — прошивка анализатора на BluePill: захват восьми каналов и выгрузка.
/* Мини-проект «Логический анализатор»: BluePill (STM32F103C8), регистры через CMSIS.
 *   PB0…PB7 — восемь каналов (PB0, PB1, PB5 — не FT: только до 3,3 В);
 *   PA9/PA10 — USART1: команды и выгрузка, 115 200 или 921 600 бод.
 * Такт: кварц 8 МГц × 9 = 72 МГц. TIM2 задаёт частоту выборки (событие
 * обновления), DMA1 канал 2 по каждому событию переносит GPIOB->IDR
 * (младший байт = PB0…PB7) в кольцевой буфер на 16 384 выборки.
 * Запуск — фронт на выбранном канале через EXTI; кольцо к этому моменту
 * уже пишется, поэтому в записи есть и то, что было ДО фронта. */
#include "stm32f10x.h"

#define N        16384u                 /* выборок в кольце; степень двойки */
#define PRE      (N / 4u)               /* предзапись: четверть кольца — история */
#define FCLK     72000000u

static uint8_t ring[N];
static volatile uint32_t trig_ndtr;     /* CNDTR в момент запуска */
static volatile uint8_t triggered;

static const uint32_t rates[] = { 4500000u, 2000000u, 1000000u, 500000u, 100000u };
static uint8_t rate_i = 2;              /* 1 Мвыб/с по умолчанию */
static uint8_t trig_ch = 0;             /* канал запуска: PB0 */
static uint16_t brr = 625;              /* 72 МГц / 625 = 115 200 бод */

/* один обработчик на все линии EXTI0…EXTI9_5 — в таблице векторов
 * шесть ячеек указывают сюда */
void EXTI_IRQHandler(void)
{
    trig_ndtr = DMA1_Channel2->CNDTR;   /* где кольцо было в момент фронта */
    EXTI->PR = 0xFFu;                   /* снять запросы */
    EXTI->IMR &= ~0xFFu;                /* второй фронт уже не нужен */
    triggered = 1;
}

static void clock_72mhz(void)
{
    RCC->CR |= RCC_CR_HSEON;
    while (!(RCC->CR & RCC_CR_HSERDY)) {
    }
    FLASH->ACR = FLASH_ACR_PRFTBE | FLASH_ACR_LATENCY_2;
    RCC->CFGR = RCC_CFGR_PLLSRC | RCC_CFGR_PLLMULL9 | RCC_CFGR_PPRE1_DIV2;
    RCC->CR |= RCC_CR_PLLON;
    while (!(RCC->CR & RCC_CR_PLLRDY)) {
    }
    RCC->CFGR |= RCC_CFGR_SW_PLL;
    while ((RCC->CFGR & RCC_CFGR_SWS) != RCC_CFGR_SWS_PLL) {
    }
}

static void tx(uint8_t b)
{
    while (!(USART1->SR & USART_SR_TXE)) {
    }
    USART1->DR = b;
}

static void tx_str(const char *s)
{
    for (; *s; s++)
        tx((uint8_t)*s);
}

static void tx_u32(uint32_t v)          /* десятичное число в консоль */
{
    char b[11];
    int i = 10;
    b[i] = 0;
    do {
        b[--i] = (char)('0' + v % 10u);
        v /= 10u;
    } while (v);
    tx_str(b + i);
}

/* сколько выборок кольцо накрутило с прошлого взгляда на CNDTR */
static uint32_t advanced(uint32_t *prev)
{
    uint32_t cur = DMA1_Channel2->CNDTR;
    uint32_t d = (*prev - cur) & (N - 1u);   /* CNDTR идёт вниз и перезаряжается */
    *prev = cur;
    return d;
}

static void capture_start(void)
{
    DMA1_Channel2->CCR = 0;                       /* стоп и настройка с нуля */
    DMA1_Channel2->CPAR = (uint32_t)&GPIOB->IDR;  /* источник: порт B, чтение словом */
    DMA1_Channel2->CMAR = (uint32_t)ring;
    DMA1_Channel2->CNDTR = N;
    DMA1_Channel2->CCR = DMA_CCR2_PSIZE_1 | DMA_CCR2_MINC | DMA_CCR2_CIRC | DMA_CCR2_EN;
        /* источник 32 бита, приёмник 8 бит: в память идёт младший байт — PB0…PB7 */
    TIM2->PSC = 0;
    TIM2->ARR = (uint16_t)(FCLK / rates[rate_i] - 1u);
    TIM2->EGR = TIM_EGR_UG;                       /* применить ARR сразу */
    TIM2->DIER = TIM_DIER_UDE;                    /* запрос DMA по событию обновления */
    TIM2->CR1 = TIM_CR1_CEN;                      /* выборки пошли */
}

static void wait_samples(uint32_t need, uint32_t *prev)
{
    uint32_t done = 0;
    while (done < need)
        done += advanced(prev);
}

static void dump(void)
{
    uint32_t start = (N - DMA1_Channel2->CNDTR) & (N - 1u);  /* самая старая выборка */
    uint32_t trig = (N - trig_ndtr) & (N - 1u);              /* выборка момента запуска */
    tx('L');
    tx('A');
    tx('1');
    tx(1);                                        /* версия формата */
    uint32_t rate = rates[rate_i];
    uint32_t mark = (trig - start) & (N - 1u);    /* запуск в координатах выгрузки */
    for (int i = 0; i < 4; i++)
        tx((uint8_t)(rate >> 8 * i));             /* всё — младшим байтом вперёд */
    for (int i = 0; i < 4; i++)
        tx((uint8_t)(N >> 8 * i));
    for (int i = 0; i < 4; i++)
        tx((uint8_t)(mark >> 8 * i));
    for (uint32_t i = 0; i < N; i++)
        tx(ring[(start + i) & (N - 1u)]);         /* кольцо — по порядку времени */
}

/* edge: -1 — фронт вниз, +1 — вверх, 0 — снять сразу */
static void capture(int edge)
{
    uint32_t prev = N;
    capture_start();
    wait_samples(PRE, &prev);                     /* сначала накопить историю */
    if (edge) {
        uint32_t line = 1u << trig_ch;
        AFIO->EXTICR[trig_ch >> 2] =
            (AFIO->EXTICR[trig_ch >> 2] & ~(0xFu << 4 * (trig_ch & 3u)))
            | (1u << 4 * (trig_ch & 3u));         /* линия — к порту B */
        EXTI->RTSR = (EXTI->RTSR & ~0xFFu) | (edge > 0 ? line : 0);
        EXTI->FTSR = (EXTI->FTSR & ~0xFFu) | (edge < 0 ? line : 0);
        EXTI->PR = line;
        triggered = 0;
        EXTI->IMR |= line;
        while (!triggered) {                      /* кольцо пишется, процессор ждёт */
        }
        prev = trig_ndtr;
    } else {
        trig_ndtr = DMA1_Channel2->CNDTR;
        prev = trig_ndtr;
    }
    wait_samples(N - PRE, &prev);                 /* дописать три четверти после */
    TIM2->CR1 = 0;                                /* стоп: кольцо замерло */
    DMA1_Channel2->CCR &= ~DMA_CCR2_EN;
    dump();
}

int main(void)
{
    clock_72mhz();
    RCC->AHBENR |= RCC_AHBENR_DMA1EN;
    RCC->APB2ENR |= RCC_APB2ENR_IOPAEN | RCC_APB2ENR_IOPBEN
                  | RCC_APB2ENR_USART1EN | RCC_APB2ENR_AFIOEN;
    RCC->APB1ENR |= RCC_APB1ENR_TIM2EN;
    AFIO->MAPR = AFIO_MAPR_SWJ_CFG_JTAGDISABLE;   /* JTAG выключен, SWD остался: PB3, PB4 — наши */
    GPIOB->CRL = 0x44444444u;                     /* PB0…PB7 — входы без подтяжки, как у прибора */
    GPIOA->CRH = (GPIOA->CRH & ~0xFF0u) | 0x4A0u; /* PA9 — альтернативный выход, PA10 — вход */
    USART1->BRR = brr;
    USART1->CR1 = USART_CR1_UE | USART_CR1_TE | USART_CR1_RE;
    NVIC_EnableIRQ(EXTI0_IRQn);
    NVIC_EnableIRQ(EXTI1_IRQn);
    NVIC_EnableIRQ(EXTI2_IRQn);
    NVIC_EnableIRQ(EXTI3_IRQn);
    NVIC_EnableIRQ(EXTI4_IRQn);
    NVIC_EnableIRQ(EXTI9_5_IRQn);
    for (;;) {
        while (!(USART1->SR & USART_SR_RXNE)) {
        }
        uint8_t c = (uint8_t)USART1->DR;
        if (c >= '0' && c <= '7') {               /* канал запуска */
            trig_ch = (uint8_t)(c - '0');
            tx_str("c=");
            tx_u32(trig_ch);
            tx_str("\r\n");
        } else if (c == 's') {                    /* следующая скорость по кругу */
            rate_i = (uint8_t)((rate_i + 1u) % (sizeof rates / sizeof rates[0]));
            tx_str("s=");
            tx_u32(rates[rate_i]);
            tx_str("\r\n");
        } else if (c == 'u') {                    /* скорость порта туда-обратно */
            brr = (brr == 625) ? 78 : 625;        /* 115 200 или 72 МГц / 78 = 923 077 */
            while (!(USART1->SR & USART_SR_TC)) {
            }
            USART1->BRR = brr;
            tx_str(brr == 625 ? "u=115200\r\n" : "u=921600\r\n");
        } else if (c == 'a') {
            capture(-1);                          /* взвести: фронт вниз (старт-бит UART) */
        } else if (c == 'A') {
            capture(+1);                          /* взвести: фронт вверх */
        } else if (c == 'g') {
            capture(0);                           /* снять сразу, без условия */
        }
    }
}
la_host.py — компьютерная часть: команды, приём и разбор захвата.
# -*- coding: utf-8 -*-
"""Мини-проект «Логический анализатор из BluePill»: компьютерная часть.

python la_host.py selftest   — модель захвата + разбор, 20 фаз, байт-в-байт
python la_host.py vcd dump.la out.vcd — конвертер записи в VCD для PulseView

Модель повторяет алгоритм прошивки la_f103.c один в один: кольцо на
N выборок, предзапись PRE, запуск по спадающему фронту канала 0,
затем N−PRE выборок после и выгрузка в формате LA1.
"""
import struct
import sys

N = 16384          # выборок в кольце (= прошивке)
PRE = N // 4       # предзапись: 4096 выборок истории
RATE = 1_000_000   # выборок в секунду
BAUD = 115200
MSG = b"la198d"    # что «передатчик» шлёт по каналу 0

sys.stdout.reconfigure(encoding="utf-8", errors="replace")


# ── сигнал ───────────────────────────────────────────────────────────────
def uart_level(t_bits):
    """Уровень линии UART в момент t (в битах от начала посылки): кадры 8N1 подряд."""
    if t_bits < 0:
        return 1
    frame, pos = divmod(t_bits, 10.0)
    frame = int(frame)
    if frame >= len(MSG):
        return 1
    bit = int(pos)
    if bit == 0:
        return 0                        # старт
    if bit <= 8:
        return (MSG[frame] >> (bit - 1)) & 1
    return 1                            # стоп


def signal_byte(k, s0, spb):
    """Восемь каналов в момент выборки k: к0 — UART, к1 — меандр 50 кГц."""
    ch0 = uart_level((k - s0) / spb)
    ch1 = (k // 10) & 1                 # период 20 выборок = 50 кГц при 1 Мвыб/с
    return ch0 | (ch1 << 1)


# ── модель захвата: алгоритм прошивки ────────────────────────────────────
def capture(s0, spb, rate=RATE):
    """Кольцо + предзапись + запуск по фронту вниз на к0. Возвращает выгрузку LA1."""
    ring = bytearray(N)
    k = 0
    prev_ch0 = 1
    trig_k = None
    while True:
        b = signal_byte(k, s0, spb)
        ring[k % N] = b
        if k >= PRE and trig_k is None and prev_ch0 == 1 and (b & 1) == 0:
            trig_k = k                  # EXTI: фронт вниз после взведения
        prev_ch0 = b & 1
        k += 1
        if trig_k is not None and k == trig_k + (N - PRE):
            break                       # дописаны три четверти после запуска
    start = k % N                       # самая старая выборка
    mark = (trig_k - (k - N)) % N       # запуск в координатах выгрузки
    out = b"LA1" + bytes([1]) + struct.pack("<III", rate, N, mark)
    out += bytes(ring[(start + i) % N] for i in range(N))
    return out


# ── разбор выгрузки ──────────────────────────────────────────────────────
def parse(dump):
    if dump[:3] != b"LA1" or dump[3] != 1:
        raise ValueError("не формат LA1")
    rate, n, mark = struct.unpack("<III", dump[4:16])
    return rate, mark, dump[16:16 + n]


def decode_uart(samples, ch, rate, baud):
    """Старт по фронту вниз, выборка в середине каждого бита. Возвращает байты."""
    spb = rate / baud
    out, k, prev = [], 0, 1
    while k < len(samples):
        cur = (samples[k] >> ch) & 1
        if prev == 1 and cur == 0:                    # старт-бит
            byte = 0
            for bit in range(8):
                p = k + (1.5 + bit) * spb             # середина бита данных
                if p >= len(samples):
                    return out
                byte |= ((samples[int(p)] >> ch) & 1) << bit
            stop = k + 9.5 * spb
            if stop < len(samples) and (samples[int(stop)] >> ch) & 1:
                out.append(byte)
            k = int(k + 9.5 * spb)                    # в середину стоп-бита:
            prev = 1                                  # следующий старт ищем по фронту
        else:
            prev = cur
        k += 1
    return out


def ascii_diagram(samples, mark, channels=(0, 1), span=32):
    """Кусок временной диаграммы вокруг запуска: ▔ — единица, ▁ — ноль."""
    lines = []
    for ch in channels:
        row = "".join("▔" if (samples[k] >> ch) & 1 else "▁"
                      for k in range(mark - 8, mark - 8 + span))
        lines.append("к%d  %s" % (ch, row))
    lines.append("            ^ запуск (выборка %d)" % mark)
    return "\n".join(lines)


def to_vcd(dump, path):
    """Конвертер LA1 → VCD: PulseView открывает такой файл сам (раздел 36а)."""
    rate, mark, samples = parse(dump)
    ids = "!\"#$%&'("
    with open(path, "w", encoding="ascii") as f:
        f.write("$timescale 1 ns $end\n$scope module la $end\n")
        for ch in range(8):
            f.write("$var wire 1 %s k%d $end\n" % (ids[ch], ch))
        f.write("$upscope $end\n$enddefinitions $end\n")
        last = None
        n_edges = 0
        for k, b in enumerate(samples):
            if last is None or b != last:
                f.write("#%d\n" % round(k * 1e9 / rate))
                for ch in range(8):
                    v = (b >> ch) & 1
                    if last is None or v != ((last >> ch) & 1):
                        f.write("%d%s\n" % (v, ids[ch]))
                        n_edges += 1
                last = b
    return n_edges


# ── самотест ─────────────────────────────────────────────────────────────
def selftest():
    ok = True
    spb = RATE / BAUD
    print("rate=%d baud=%d spb=%.2f" % (RATE, BAUD, spb))
    print("N=%d PRE=%d post=%d" % (N, PRE, N - PRE))

    good = 0
    marks = set()
    for phase in range(20):
        s0 = PRE + 500 + phase / 20.0          # посылка на полбита позже с каждым шагом
        dump = capture(s0, spb)
        rate, mark, samples = parse(dump)
        marks.add(mark)
        got = bytes(decode_uart(samples, 0, rate, BAUD))
        idle_before = all((samples[k] & 1) == 1 for k in range(mark - 400, mark))
        if got == MSG and idle_before:
            good += 1
        else:
            ok = False
            print("phase %02d: FAIL got=%r" % (phase, got))
    print("phases %d/20 байт-в-байт, посылка %r (%d байт)" % (good, MSG, len(MSG)))
    print("mark=%s (предзапись ровно PRE)" % sorted(marks))

    # передатчик со скоростью +2 % — разбор всё ещё честной серединой бита
    good2 = 0
    for phase in range(20):
        s0 = PRE + 500 + phase / 20.0
        dump = capture(s0, RATE / (BAUD * 1.02))
        rate, mark, samples = parse(dump)
        if bytes(decode_uart(samples, 0, rate, BAUD)) == MSG:
            good2 += 1
    print("tx+2%%: %d/20" % good2)
    ok &= good2 == 20

    dump = capture(PRE + 500.0, spb)
    rate, mark, samples = parse(dump)
    print(ascii_diagram(samples, mark))
    edges = to_vcd(dump, "la_test.vcd")
    print("vcd: %d переключений, файл la_test.vcd" % edges)

    hdr_bits = (16 + N) * 10
    print("выгрузка: (16+%d) байт = %d бит" % (N, hdr_bits))
    print("  115200 бод: %.2f с" % (hdr_bits / 115200))
    print("  921600 бод (фактических 923077): %.2f с" % (hdr_bits / (72e6 / 78)))
    print("память: %d выборок = %.1f мс при 1 Мвыб/с; все 20 КБ дали бы %.1f мс"
          % (N, N / 1e3, 20480 / 1e3))
    print("SELFTEST OK" if ok else "SELFTEST FAIL")
    return 0 if ok else 1


if __name__ == "__main__":
    if len(sys.argv) >= 2 and sys.argv[1] == "vcd":
        with open(sys.argv[2], "rb") as f:
            n = to_vcd(f.read(), sys.argv[3])
        print("vcd: %d переключений → %s" % (n, sys.argv[3]))
        sys.exit(0)
    sys.exit(selftest())
Дальше: раздел 198е «Мини-проект: CAN-сниффер на STM32 — протокол SLCAN поверх USB CDC» — анализатор ловил биты, сниффер ловит кадры шины CAN.