 Embedded HandbookПриложения
106б. Пакет по байтам: Ethernet, ARP, IPv4, ICMP, UDP и TCP глазами микроконтроллера
В разделе 105 наш код сам спрашивал ядро Linux — слал ARP-запрос и ping и разбирал ответы. В разделе 106 он провёл рукопожатие TCP. В разделе 106а кадр дошёл из провода в буфер F407 по кольцу дескрипторов. Теперь всё наоборот: спрашивают нас. Здесь — самый маленький стек, который отвечает на ARP, ping и UDP, без ОС и без выделения памяти. Он работает прямо в буфере, куда DMA положил кадр, и собирает ответ в буфере передачи.
Опоры: справочное руководство RM0090 (дескриптор передачи и вставка
контрольных сумм), заголовок HAL stm32f4xx_hal_eth.h из пака Keil
STM32F4xx_DFP, opt.h из lwIP в архиве STM32CubeF4 1.28.0. Код стека один
и тот же для ПК и для F407. На ПК его собирает gcc, и он отвечает
настоящему ядру Linux через интерфейс tap. Для F407 его собирает armclang;
листинги — дизассемблер fromelf.
Как это называется в документации
Оригинал Перевод EtherType поле типа кадра: 0x0800 — IPv4, 0x0806 — ARP echo request, echo reply эхо-запрос и эхо-ответ ICMP — это и есть ping network byte order порядок байт сети: старший вперёд packed structure упакованная структура: поля без промежутков, адрес любой incremental checksum update поправка суммы после замены одного слова checksum insertion control (CIC) биты дескриптора передачи: какие суммы вставит MAC store-and-forward (TSF) передача после накопления кадра в FIFO целиком tap interface виртуальный интерфейс Linux: кадры Ethernet идут в программу
106б.1 Один вызов на кадр
Весь стек — одна функция. Она получает принятый кадр и буфер для ответа и возвращает длину ответа или 0:
unsigned net_input(net_t *nt, const uint8_t *f, unsigned n, uint8_t *out);
Внутри — развилки по полям кадра. MAC получателя: наш или широковещательный.
EtherType: ARP или IPv4. У IPv4 — сумма заголовка, адрес получателя,
фрагмент ли это, и номер протокола: 1 — ICMP, 17 — UDP, 6 — TCP. На каждый
выброшенный кадр — свой счётчик в net_t: чужой, неверная сумма, не
разобран. Очередей, таймеров и выделения памяти нет: кадр пришёл — ответ
собран — кадр ушёл.
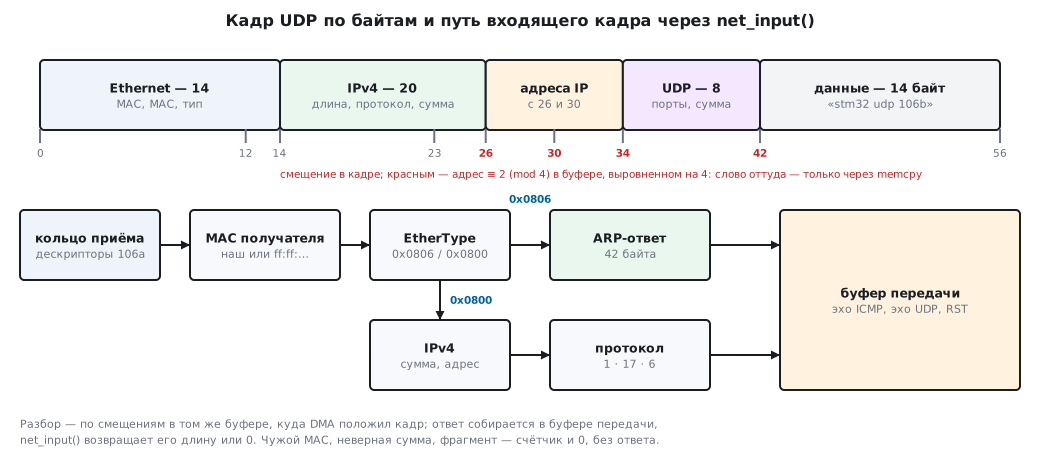
106б.2 Заголовки: структуры, порядок байт, выравнивание
Заголовки описаны упакованными структурами. Размеры и смещения сторожит компилятор, а не комментарий:
_Static_assert(sizeof(eth_hdr_t) == 14, "заголовок Ethernet — 14 байт");
_Static_assert(sizeof(arp_pkt_t) == 28, "ARP — 28 байт");
_Static_assert(sizeof(ip_hdr_t) == 20, "IPv4 без параметров — 20 байт");
_Static_assert(sizeof(icmp_hdr_t) == 8, "ICMP echo — 8 байт");
_Static_assert(sizeof(udp_hdr_t) == 8, "UDP — 8 байт");
_Static_assert(sizeof(tcp_hdr_t) == 20, "TCP без параметров — 20 байт");
_Static_assert(offsetof(ip_hdr_t, src) == 12 && offsetof(tcp_hdr_t, flags) == 13, "смещения полей как в стандарте");
Порядок байт. В сети старший байт идёт первым, а Cortex-M и x86 хранят
числа младшим вперёд. Переставлять можно данные при каждом чтении, а можно
константу — один раз, при компиляции. Стек сравнивает поле как есть
с переставленной константой: e->type == NET16(0x0806). На каждом кадре
байты не переставляются вовсе.
Выравнивание. Заголовок Ethernet — 14 байт, поэтому всё, что за ним,
сдвинуто на 2 от границы слова. Буфер DMA выровнен на 4, а адреса IP
начинаются со смещений 26 и 30, UDP — с 34, данные — с 42: у всех остаток 2.
Обычная структура обещает компилятору выровненный адрес, упакованная — нет.
Разница видна в коде одной и той же функции src ^ dst:
pair_xor:         LDRD  r0,r1,[r0,#0]
                  EORS  r0,r0,r1
pair_xor_packed:  LDR   r1,[r0,#0]
                  LDR   r0,[r0,#4]
                  EORS  r0,r0,r1
Для обычной структуры armclang склеил два чтения в одно LDRD. Невыровненный
LDRD на Cortex-M4 — отказ UsageFault всегда, при любых настройках
(разделы 7б и 35). Для упакованной — два LDR, их M4 выполняет с любого
адреса, пока в CCR не включён бит UNALIGN_TRP. Поэтому в стеке структуры упакованы, адреса IP хранятся байтами,
а 32-битные слова суммы читаются через memcpy — его armclang превращает
в тот же одиночный LDR (листинг в 106б.3). У lwIP для того же есть параметр ETH_PAD_SIZE —
сколько байт добавить перед заголовком Ethernet, чтобы выровнять то, что
после него. По умолчанию он 0 (раздел 106в).
106б.3 Контрольная сумма: словами по 32 бита
Сумма та же, что в разделе 105: сложение с переносом по кругу и инверсия. Но складывать можно не 16-битными словами, а 32-битными. Переносы копятся в старшей половине 64-битного накопителя. Порядок байт сумме безразличен: результат, записанный в пакет как есть, уже в порядке сети.
uint32_t csum_add(uint32_t acc, const void *p, size_t n)
{
    const uint8_t *b = p;
    uint64_t s = acc;
    for (; n >= 4; n -= 4, b += 4) {
        uint32_t w;
        memcpy(&w, b, 4);               /* одна LDR: невыровненный адрес Cortex-M4 допускает */
        s += w;
    }
    if (n >= 2) {
        uint16_t h;
        memcpy(&h, b, 2);
        s += h;
        b += 2;
        n -= 2;
    }
    if (n)
        s += *b;                        /* нечётный байт — старший байт последнего слова в сети */
    s = (s & 0xFFFFFFFFu) + (s >> 32);
    return (uint32_t)s + (uint32_t)(s >> 32);
}
armclang развернул цикл на 4 слова. На каждое слово — LDR, ADDS и ADC:
сложение и перенос в старшую половину. Ещё 4 команды — счётчик и переход
на все 16 байт:
LDR   r5,[r1,#0]
LDR   r4,[r1,#4]
LDR   r3,[r1,#8]
ADDS  r0,r0,r5
LDR   r6,[r1,#0xc]
ADC   r7,r7,#0
ADDS  r0,r0,r4
ADC   r7,r7,#0
ADDS  r0,r0,r3
ADC   r3,r7,#0
ADDS  r0,r0,r6
SUB   r2,r2,#0x10
ADC   r7,r3,#0
CMP   r2,#3
ADD   r1,r1,#0x10
BHI   {pc}-0x2a
16 команд на 16 байт — 4 команды на 32-битное слово.
UDP и TCP считают сумму ещё и по псевдозаголовку (раздел 106.1). В заголовке IP адреса отправителя и получателя лежат подряд, поэтому псевдозаголовок не собирают отдельно — берут 8 байт прямо из пакета:
static uint16_t l4_sum(const ip_hdr_t *ip, const void *seg, unsigned len, uint8_t proto)
{
    uint32_t acc = csum_add(NET16(proto) + NET16(len), ip->src, 8);   /* src и dst лежат подряд */
    return csum_fin(csum_add(acc, seg, len));
}
Для эхо-ответа ICMP сумму вообще не пересчитывают. Ответ — копия запроса, в которой тип 8 стал 0. Сумму поправляют на разницу одного 16-битного слова (RFC 1624):
static uint16_t csum_update(uint16_t hc, uint16_t m, uint16_t m1)
{
    return csum_fin((uint32_t)(uint16_t)~hc + (uint16_t)~m + m1);
}
В опыте (106б.5) у запроса в поле суммы 0x9d7b, у ответа 0xa57b. Слово «тип, код» уменьшилось на 0x0800, и поле выросло на столько же. Для ping на 1472 байта данных это правка трёх слов вместо прохода по 1480 байтам.
106б.4 Ответы: ARP, ping, UDP и сброс TCP
ARP. На запрос «у кого 10.106.2.50» отвечаем своим MAC. В ответе операция 2, отправитель — мы, искомый — тот, кто спрашивал. Ответ — 42 байта: 14 заголовка и 28 ARP.
Ping. Эхо-ответ — копия запроса: тот же идентификатор, тот же порядковый номер, те же данные, тип 0. Новый только заголовок IP — со своим номером пакета и флагом «не дробить». Сумма ICMP — поправкой из 106б.3.
UDP. Порт 7 — эхо: данные возвращаются заглавными буквами, так в опыте видно, что ответил наш код, а не ядро. Ноль в поле суммы у UDP значит «суммы нет». Такой пакет принимаем без проверки, а посчитанный ноль отправляем как 0xFFFF. Длину берём из заголовка UDP и сверяем с IP, а не с длиной кадра. Короткий кадр в проводе дополнен до 60 байт, и хвост из нулей данными не считается.
TCP. Заголовок разобран — порты, номера, длина заголовка, флаги, — но соединений нет. На любой сегмент, кроме сброса, ответ — RST, как у узла без слушающего порта. На SYN — RST+ACK с подтверждением «номер + 1»: SYN занимает один номер. Свой TCP для прибора писать не стоит. Нужны повторы по тайм-ауту, окно, порядок сегментов, номера по кругу и память на каждое соединение (раздел 106) — это и есть готовый стек. lwIP разбирается в разделе 106в.
106б.5 Опыт: тот же код против ядра Linux
Код стека не знает про железо, поэтому на ПК он собирается gcc без
изменений. Вместо кольца дескрипторов у него интерфейс tap: ядро Linux
отдаёт в программу кадры Ethernet целиком (IFF_TAP | IFF_NO_PI) и
принимает от неё ответы как из провода. Контейнер запускается без сети
(--network none), но с правом создать tap0. По одну сторону tap0 — наш
стек (10.106.2.50), по другую — ядро (10.106.2.1). ARP-запросы и ping
шлют программы BusyBox, UDP и TCP — сокеты ядра из Python.
| Что | Отправлено | Ответов | Время ответа, мс (мин./сред./макс.) |
|---|---|---|---|
| arping | 3 | 3 | — |
| ping, 56 байт данных | 20 | 20 | 0,067 / 0,101 / 0,295 |
| ping, 1472 байта данных | 3 | 3 | 0,088 / 0,190 / 0,394 |
| UDP-эхо на порт 7 | 20 | 20 | 0,076 / 0,111 / 0,137 |
Ping на 1472 байта данных — пакет IP в 1500 байт, кадр 1514 байт: самый длинный без дробления. Ядро приняло и его. Соединение TCP на порт 80 получило отказ через 0,251 мс: ядро поверило нашему RST. Время ответа — это ядро, tap и программа на ПК, а не микроконтроллер. Оно показывает только, что ответ не ждёт тайм-аута.
Потом «петля»: Python собирает кадры UDP сам, на struct и со своей
суммой, и шлёт их в tap0 сырым сокетом. Верный кадр получил ответ. Кадр
с нулём в поле суммы UDP — тоже. С испорченной суммой UDP, с испорченной
суммой IP и с чужим MAC получателя ответов нет. Все 50 кадров нашего стека
отдельный сокет поймал и пересчитал заново: 4 ARP, 23 ICMP, 22 UDP и 1 TCP,
ни одной неверной суммы.
Счётчики стека после опыта: принято 60 кадров. Ответов: ARP — 4 (3 от arping и 1 от самого ядра перед первым ping), ICMP — 23, UDP — 22, RST — 1. Выброшено за неверную сумму — 2, чужих — 8: 7 кадров IPv6, которые ядро шлёт на групповые адреса, и 1 кадр петли с чужим MAC. Неразобранных — 0.
Обмен ARP байт в байт — запрос ядра и наш ответ:
Ethernet    ff ff ff ff ff ff 02 00 00 00 00 01 08 06
ARP         00 01 08 00 06 04 00 01
отправитель 02 00 00 00 00 01 0a 6a 02 01
искомый     ff ff ff ff ff ff 0a 6a 02 32

Ethernet    02 00 00 00 00 01 02 00 00 00 01 06 08 06
ARP         00 01 08 00 06 04 00 02
отправитель 02 00 00 00 01 06 0a 6a 02 32
искомый     02 00 00 00 00 01 0a 6a 02 01
И обмен UDP — датаграмма «stm32 udp 106b» с порта 40106 (0x9caa) на порт 7 и ответ:
Ethernet    02 00 00 00 01 06 02 00 00 00 00 01 08 00
IPv4        45 00 00 2a 95 08 40 00 40 11 8c b4 0a 6a 02 01 0a 6a 02 32
UDP         9c aa 00 07 00 16 ea 2a
данные      73 74 6d 33 32 20 75 64 70 20 31 30 36 62

Ethernet    02 00 00 00 00 01 02 00 00 00 01 06 08 00
IPv4        45 00 00 2a 01 1d 40 00 40 11 20 a0 0a 6a 02 32 0a 6a 02 01
UDP         00 07 9c aa 00 16 6a 8b
данные      53 54 4d 33 32 20 55 44 50 20 31 30 36 42
Кадры по 56 байт: на tap дополнять до 60 некому, в проводе это сделает MAC. В ответе поменялись местами MAC, адреса IP и порты. Номер пакета стал нашим (0x011d), сумма IP — 0x20a0, сумма UDP — 0x6a8b. Ядро их проверило и отдало данные сокету.
106б.6 На F407: кольцо дескрипторов и суммы в MAC
На F407 то же ядро стека стоит между кольцом приёма из раздела 106а и одним дескриптором передачи. Опрос кольца — в главном цикле:
void eth_poll(void)
{
    eth_desc_t *d = &rx_ring[rx_cur];
    uint32_t s;
    while (!((s = d->des0) & OWN)) {
        unsigned n = eth_rx_len(d) - 4u;                    /* FL — вместе с FCS */
        if ((s & (RX_ES | RX_FS | RX_LS)) == (RX_FS | RX_LS) && n <= BUF_SIZE && !(tx_desc.des0 & OWN)) {
            unsigned r = net_input(&net, d->buf, n, (uint8_t *)tx_buf);
            if (r) {
                tx_desc.des1 = r;                           /* до 60 байт дополнит и FCS добавит MAC */
                tx_desc.des0 = OWN | TX_FS | TX_LS | TX_TCH | (NET_HW_CSUM ? TX_CIC : 0u);
                ETH->DMATPDR = 0;                           /* передатчик: «есть кадр» */
            }
        }
        d->des0 = OWN;                                      /* буфер — обратно DMA */
        rx_cur = (rx_cur + 1u) % NRX;
        d = &rx_ring[rx_cur];
    }
    if (ETH->DMASR & ETH_DMASR_RBUS) {                      /* приём стоял: свободных буферов не было */
        ETH->DMASR = ETH_DMASR_RBUS;
        ETH->DMARPDR = 0;
    }
}
В длине FL из дескриптора уже есть 4 байта FCS, их отнимают. Кадр с
ошибкой или разложенный по нескольким буферам пропускается. Пока
передатчик не забрал прошлый ответ (OWN у дескриптора передачи), новый
не собирается. Буфер приёма в любом случае возвращается DMA. Кадры
с чужим MAC до кольца обычно не доходят: не прошедший фильтр адресов
кадр MAC выбрасывает сам (RM0090). Проверка MAC в net_input — вторая,
на случай приёма всех кадров подряд.
Суммы в MAC. Биты 23:22 CIC слова TDES0 говорят MAC, какие суммы
вставить при передаче (RM0090). Значение 11 — сумма заголовка IP и сумма
ICMP, UDP или TCP вместе с псевдозаголовком. В HAL это
ETH_DMATXDESC_CIC_TCPUDPICMP_FULL = 0x00C00000. Два условия из RM0090:
- вставка работает, только когда передача ждёт кадр в FIFO целиком —
бит TSF в DMAOMR. Поэтому
eth_tx_initего ставит; - у ICMP поверх IPv4 поле суммы перед передачей должно быть 0x0000,
иначе MAC вставит неверную сумму. Стек с
NET_HW_CSUM = 1пишет нули во все поля сумм.
На приёме суммы всё равно проверяет программа. Аппаратная проверка приёма (IPCO) требует расширенных дескрипторов, а кольцо 106а — из обычных.
Сборка armclang для F407 (-O2, без предупреждений; _Static_assert на
размеры заголовков и биты дескрипторов):
| Что | Код, байт | Данные, байт |
|---|---|---|
| ядро стека, суммы считает программа | 2862 | — |
| ядро стека, суммы вставляет MAC | 2444 | — |
| драйвер 106а, опрос кольца и передача | 614 | 7764 обнуляемых + 44 net_t |
Аппаратные суммы экономят 418 байт кода и проход по каждому передаваемому кадру. Из 7764 байт ОЗУ 6144 занимают четыре буфера приёма по 1536, ещё 1536 — буфер передачи.
106б.7 Грабли
Проверка EtherType никогда не срабатывает. Поле сравнивают с 0x0806 «как есть», а в памяти лежат байты 08 06, и Cortex-M читает их как 0x0608. Сравнивать с переставленной константой, а не переставлять поле.
UsageFault на разборе заголовка. Указатель на обычную (неупакованную)
структуру поставлен на смещение 14 или 26, и компилятор склеил два чтения
в LDRD. Упаковать структуру или читать через memcpy.
Ping отвечает, а UDP нет. Посчитанная сумма UDP вышла нулём и ушла как 0x0000: получатель решил, что суммы нет, — это ещё полбеды. Хуже, когда сумму считали без псевдозаголовка: ядро выбрасывает датаграмму молча.
В данные UDP попали лишние нули. Длину взяли из кадра, а короткий кадр дополнен до 60 байт. Длину брать из заголовков IP и UDP.
С CIC = 11 ping перестал отвечать. В поле суммы ICMP осталась сумма запроса: MAC требует там 0x0000. Или не выставлен TSF, и вставка молча не работает.
Биты CIC ищут не там. В обзоре вставки сумм RM0090 называет биты 28:27
слова TDES1, а в описании дескриптора и в HAL это биты 23:22 слова TDES0.
Верить описанию дескриптора и маске ETH_DMATXDESC_CIC.
Ответы на TCP без конца. Стек отвечает RST на RST — два узла перебрасываются сбросами. На сегмент с RST не отвечают.
106б.8 Итоги
- Стек без ОС — одна функция на кадр: развилки по MAC, EtherType и протоколу, ответ в буфере передачи, длина или 0.
- Заголовки 14, 20 и 8 байт сторожит
_Static_assert. Всё после Ethernet сдвинуто на 2:LDRDпадает, упакованная структура иmemcpy— нет. - Сумма словами по 32 бита: 4 команды armclang на слово. Для ping она поправляется на одно слово (0x9d7b → 0xa57b), а не пересчитывается.
- Против ядра Linux на tap0: 3 из 3 ARP, 20 из 20 и 3 из 3 ping (до 1514 байт кадра), 20 из 20 UDP, TCP получил RST за 0,251 мс; 50 ответных кадров перепроверены, неверных сумм 0.
- На F407: CIC = 11 плюс TSF, у ICMP поле суммы 0x0000; ядро стека 2862 байта кода, с суммами в MAC — 2444.
- Свой TCP не писать: только сброс, соединения — lwIP (106в).
Полные исходники
pkt106c.h — заголовок стека: структуры кадров Ethernet, ARP, IPv4, ICMP, UDP.
/* 106б: минимальный стек без ОС — Ethernet II, ARP, IPv4, ICMP echo, UDP и ответ RST на TCP.
   Без привязки к железу: собирается gcc под Linux (tap) и armclang под STM32F407. */
#ifndef PKT106C_H
#define PKT106C_H
#include <stddef.h>
#include <stdint.h>

#define PACKED __attribute__((packed))

#ifndef NET_HW_CSUM
#define NET_HW_CSUM 0                   /* 1 — суммы при передаче вставляет MAC F407 (CIC = 11), поля — нули */
#endif

_Static_assert(__BYTE_ORDER__ == __ORDER_LITTLE_ENDIAN__, "код рассчитан на младший байт вперёд: x86 и Cortex-M");

/* порядок байт: в сети — старший вперёд; переставляем константы при компиляции, а не данные */
#define NET16(x) ((uint16_t)((((x) & 0xFFu) << 8) | (((x) >> 8) & 0xFFu)))

typedef struct PACKED {
    uint8_t  dst[6], src[6];
    uint16_t type;                      /* EtherType: 0x0800 — IPv4, 0x0806 — ARP */
} eth_hdr_t;

typedef struct PACKED {
    uint16_t htype, ptype;              /* 1 — Ethernet, 0x0800 — IPv4 */
    uint8_t  hlen, plen;                /* 6 и 4 */
    uint16_t op;                        /* 1 — запрос, 2 — ответ */
    uint8_t  sha[6], spa[4];            /* MAC и IP отправителя */
    uint8_t  tha[6], tpa[4];            /* MAC и IP искомого */
} arp_pkt_t;

typedef struct PACKED {
    uint8_t  vihl, tos;                 /* 0x45: версия 4, заголовок 5 слов */
    uint16_t len, id, frag;             /* frag: флаги и смещение фрагмента */
    uint8_t  ttl, proto;                /* proto: 1 — ICMP, 6 — TCP, 17 — UDP */
    uint16_t sum;
    uint8_t  src[4], dst[4];            /* адреса — байтами: не читать словом с невыровненного адреса */
} ip_hdr_t;

typedef struct PACKED {
    uint8_t  type, code;                /* 8 — эхо-запрос, 0 — эхо-ответ */
    uint16_t sum, id, seq;
} icmp_hdr_t;

typedef struct PACKED {
    uint16_t sport, dport, len, sum;
} udp_hdr_t;

typedef struct PACKED {
    uint16_t sport, dport;
    uint32_t seq, ack;
    uint8_t  off, flags;                /* off: длина заголовка в словах в старших 4 битах */
    uint16_t win, sum, urg;
} tcp_hdr_t;

_Static_assert(sizeof(eth_hdr_t) == 14, "заголовок Ethernet — 14 байт");
_Static_assert(sizeof(arp_pkt_t) == 28, "ARP — 28 байт");
_Static_assert(sizeof(ip_hdr_t) == 20, "IPv4 без параметров — 20 байт");
_Static_assert(sizeof(icmp_hdr_t) == 8, "ICMP echo — 8 байт");
_Static_assert(sizeof(udp_hdr_t) == 8, "UDP — 8 байт");
_Static_assert(sizeof(tcp_hdr_t) == 20, "TCP без параметров — 20 байт");
_Static_assert(offsetof(ip_hdr_t, src) == 12 && offsetof(tcp_hdr_t, flags) == 13, "смещения полей как в стандарте");

#define TCP_FIN 0x01u
#define TCP_SYN 0x02u
#define TCP_RST 0x04u
#define TCP_ACK 0x10u

typedef struct {
    uint8_t  mac[6], ip[4];
    uint16_t ip_id;                     /* номер следующего своего пакета */
    uint32_t rx, arp, icmp, udp, tcp_rst, bad_sum, not_ours, dropped;
} net_t;

uint32_t csum_add(uint32_t acc, const void *p, size_t n);
uint16_t csum_fin(uint32_t acc);
unsigned udp_build(net_t *nt, uint8_t *out, const uint8_t dmac[6], const uint8_t dip[4],
                   uint16_t sport, uint16_t dport, const uint8_t *data, unsigned n);
unsigned net_input(net_t *nt, const uint8_t *f, unsigned n, uint8_t *out);

#endif
pkt106c.c — разбор входящего кадра и ответ — ARP, ping, UDP-эхо, RST на TCP.
/* 106б: разбор входящего кадра и ответ — ARP, ping, UDP-эхо, RST на TCP. Без ОС, без malloc, без железа.
   out — буфер передачи не меньше принятого кадра (1514 байт хватает на любой). */
#include <string.h>
#include "pkt106c.h"

#define NET32(x)   __builtin_bswap32(x)
#define ETH_ARP    NET16(0x0806)
#define ETH_IP     NET16(0x0800)
#define ECHO_PORT  7u

static const uint8_t BCAST[6] = {0xFF, 0xFF, 0xFF, 0xFF, 0xFF, 0xFF};

/* сумма в обратном коде (RFC 1071) словами по 32 бита в порядке процессора; порядок байт
   для этой суммы не важен — результат, записанный в пакет как есть, уже в порядке сети */
uint32_t csum_add(uint32_t acc, const void *p, size_t n)
{
    const uint8_t *b = p;
    uint64_t s = acc;
    for (; n >= 4; n -= 4, b += 4) {
        uint32_t w;
        memcpy(&w, b, 4);               /* одна LDR: невыровненный адрес Cortex-M4 допускает */
        s += w;
    }
    if (n >= 2) {
        uint16_t h;
        memcpy(&h, b, 2);
        s += h;
        b += 2;
        n -= 2;
    }
    if (n)
        s += *b;                        /* нечётный байт — старший байт последнего слова в сети */
    s = (s & 0xFFFFFFFFu) + (s >> 32);
    return (uint32_t)s + (uint32_t)(s >> 32);
}

uint16_t csum_fin(uint32_t acc)
{
    acc = (acc & 0xFFFFu) + (acc >> 16);
    acc = (acc & 0xFFFFu) + (acc >> 16);
    return (uint16_t)~acc;
}

/* RFC 1624: сумма после замены одного 16-битного слова m на m1 — без прохода по данным */
static uint16_t csum_update(uint16_t hc, uint16_t m, uint16_t m1)
{
    return csum_fin((uint32_t)(uint16_t)~hc + (uint16_t)~m + m1);
}

/* сумма UDP и TCP: псевдозаголовок (адреса, протокол, длина) и сам сегмент */
static uint16_t l4_sum(const ip_hdr_t *ip, const void *seg, unsigned len, uint8_t proto)
{
    uint32_t acc = csum_add(NET16(proto) + NET16(len), ip->src, 8);   /* src и dst лежат подряд */
    return csum_fin(csum_add(acc, seg, len));
}

static void eth_fill(uint8_t *out, const uint8_t dst[6], const uint8_t src[6], uint16_t type)
{
    eth_hdr_t *e = (eth_hdr_t *)out;
    memcpy(e->dst, dst, 6);
    memcpy(e->src, src, 6);
    e->type = type;
}

static void ip_fill(net_t *nt, ip_hdr_t *ip, const uint8_t dst[4], uint8_t proto, unsigned l4len)
{
    ip->vihl  = 0x45;
    ip->tos   = 0;
    ip->len   = NET16(20u + l4len);
    ip->id    = NET16(nt->ip_id);
    nt->ip_id++;
    ip->frag  = NET16(0x4000);          /* «не дробить» */
    ip->ttl   = 64;
    ip->proto = proto;
    ip->sum   = 0;
    memcpy(ip->src, nt->ip, 4);
    memcpy(ip->dst, dst, 4);
    ip->sum   = NET_HW_CSUM ? 0 : csum_fin(csum_add(0, ip, 20));
}

unsigned udp_build(net_t *nt, uint8_t *out, const uint8_t dmac[6], const uint8_t dip[4],
                   uint16_t sport, uint16_t dport, const uint8_t *data, unsigned n)
{
    ip_hdr_t  *ip = (ip_hdr_t *)(out + 14);
    udp_hdr_t *u  = (udp_hdr_t *)(out + 34);
    if (data)                           /* NULL — данные уже на месте, в out + 42 */
        memcpy(out + 42, data, n);
    eth_fill(out, dmac, nt->mac, ETH_IP);
    ip_fill(nt, ip, dip, 17, 8u + n);
    u->sport = NET16(sport);
    u->dport = NET16(dport);
    u->len   = NET16(8u + n);
    u->sum   = 0;
    uint16_t c = NET_HW_CSUM ? 0 : l4_sum(ip, u, 8u + n, 17);
    u->sum   = (c || NET_HW_CSUM) ? c : 0xFFFFu;    /* ноль в поле значит «суммы нет» */
    return 42u + n;
}

static unsigned arp_input(net_t *nt, const uint8_t *f, unsigned n, uint8_t *out)
{
    const arp_pkt_t *a = (const arp_pkt_t *)(f + 14);
    if (n < 14 + 28 || a->htype != NET16(1) || a->ptype != ETH_IP || a->hlen != 6 || a->plen != 4) {
        nt->dropped++;
        return 0;
    }
    if (a->op != NET16(1) || memcmp(a->tpa, nt->ip, 4)) {
        nt->not_ours++;                 /* спрашивают не нас или это чужой ответ */
        return 0;
    }
    arp_pkt_t *r = (arp_pkt_t *)(out + 14);
    eth_fill(out, a->sha, nt->mac, ETH_ARP);
    r->htype = NET16(1);
    r->ptype = ETH_IP;
    r->hlen  = 6;
    r->plen  = 4;
    r->op    = NET16(2);
    memcpy(r->sha, nt->mac, 6);
    memcpy(r->spa, nt->ip, 4);
    memcpy(r->tha, a->sha, 6);
    memcpy(r->tpa, a->spa, 4);
    nt->arp++;
    return 14 + 28;
}

static unsigned icmp_input(net_t *nt, const eth_hdr_t *e, const ip_hdr_t *ip, const uint8_t *l4, unsigned len, uint8_t *out)
{
    const icmp_hdr_t *q = (const icmp_hdr_t *)l4;
    if (len < 8 || q->type != 8 || q->code != 0) {
        nt->dropped++;
        return 0;
    }
    if (csum_fin(csum_add(0, q, len)) != 0) {
        nt->bad_sum++;
        return 0;
    }
    icmp_hdr_t *r = (icmp_hdr_t *)(out + 34);
    uint16_t m, m1;
    memcpy(r, q, len);                  /* ответ — копия запроса: id, номер и данные те же */
    memcpy(&m, r, 2);
    r->type = 0;
    memcpy(&m1, r, 2);
    r->sum = NET_HW_CSUM ? 0 : csum_update(q->sum, m, m1);  /* тип 8 → 0: поправить, а не считать заново */
    eth_fill(out, e->src, nt->mac, ETH_IP);
    ip_fill(nt, (ip_hdr_t *)(out + 14), ip->src, 1, len);
    nt->icmp++;
    return 34u + len;
}

static unsigned udp_input(net_t *nt, const eth_hdr_t *e, const ip_hdr_t *ip, const uint8_t *l4, unsigned len, uint8_t *out)
{
    const udp_hdr_t *u = (const udp_hdr_t *)l4;
    unsigned ul = len >= 8 ? NET16(u->len) : 0;
    if (ul < 8 || ul > len) {
        nt->dropped++;
        return 0;
    }
    if (u->sum && l4_sum(ip, u, ul, 17) != 0) {     /* ноль — отправитель сумму не считал */
        nt->bad_sum++;
        return 0;
    }
    if (u->dport != NET16(ECHO_PORT)) {
        nt->dropped++;
        return 0;
    }
    unsigned n = ul - 8;
    for (unsigned i = 0; i < n; i++) {      /* эхо заглавными буквами — видно, что ответил наш код */
        uint8_t c = l4[8 + i];
        out[42 + i] = (c >= 'a' && c <= 'z') ? (uint8_t)(c - 32) : c;
    }
    nt->udp++;
    return udp_build(nt, out, e->src, ip->src, ECHO_PORT, NET16(u->sport), NULL, n);
}

/* своего TCP нет: на любой сегмент — сброс, как у узла без слушающего порта */
static unsigned tcp_input(net_t *nt, const eth_hdr_t *e, const ip_hdr_t *ip, const uint8_t *l4, unsigned len, uint8_t *out)
{
    const tcp_hdr_t *t = (const tcp_hdr_t *)l4;
    unsigned hl = len >= 20 ? (t->off >> 4) * 4u : 0;
    if (hl < 20 || hl > len || (t->flags & TCP_RST)) {
        nt->dropped++;                  /* на сброс не отвечают */
        return 0;
    }
    if (l4_sum(ip, t, len, 6) != 0) {
        nt->bad_sum++;
        return 0;
    }
    tcp_hdr_t *r = (tcp_hdr_t *)(out + 34);
    memset(r, 0, sizeof *r);
    r->sport = t->dport;
    r->dport = t->sport;
    r->off   = 5u << 4;
    if (t->flags & TCP_ACK) {
        r->seq   = t->ack;
        r->flags = TCP_RST;
    } else {                            /* SYN и FIN занимают по номеру */
        uint32_t used = len - hl + !!(t->flags & TCP_SYN) + !!(t->flags & TCP_FIN);
        r->ack   = NET32(NET32(t->seq) + used);
        r->flags = TCP_RST | TCP_ACK;
    }
    eth_fill(out, e->src, nt->mac, ETH_IP);
    ip_fill(nt, (ip_hdr_t *)(out + 14), ip->src, 6, 20);
    r->sum = NET_HW_CSUM ? 0 : l4_sum((const ip_hdr_t *)(out + 14), r, 20, 6);
    nt->tcp_rst++;
    return 54;
}

static unsigned ip_input(net_t *nt, const uint8_t *f, unsigned n, uint8_t *out)
{
    const eth_hdr_t *e = (const eth_hdr_t *)f;
    const ip_hdr_t *ip = (const ip_hdr_t *)(f + 14);
    unsigned tot = n >= 34 ? NET16(ip->len) : 0;
    if (tot < 20 || tot > n - 14 || ip->vihl != 0x45) {     /* параметры IP не поддерживаем */
        nt->dropped++;
        return 0;
    }
    if (csum_fin(csum_add(0, ip, 20)) != 0) {
        nt->bad_sum++;
        return 0;
    }
    if (memcmp(ip->dst, nt->ip, 4) || (e->src[0] & 1u)) {
        nt->not_ours++;
        return 0;
    }
    if (ip->frag & NET16(0x3FFF)) {     /* фрагменты не собираем */
        nt->dropped++;
        return 0;
    }
    const uint8_t *l4 = f + 34;         /* дополнение кадра до 60 байт отбрасывает длина из IP */
    switch (ip->proto) {
    case 1:
        return icmp_input(nt, e, ip, l4, tot - 20, out);
    case 17:
        return udp_input(nt, e, ip, l4, tot - 20, out);
    case 6:
        return tcp_input(nt, e, ip, l4, tot - 20, out);
    default:
        nt->dropped++;
        return 0;
    }
}

unsigned net_input(net_t *nt, const uint8_t *f, unsigned n, uint8_t *out)
{
    const eth_hdr_t *e = (const eth_hdr_t *)f;
    nt->rx++;
    if (n < sizeof *e) {
        nt->dropped++;
        return 0;
    }
    if (memcmp(e->dst, nt->mac, 6) && memcmp(e->dst, BCAST, 6)) {
        nt->not_ours++;                 /* MAC обычно отсеивает такие сам — фильтр по адресу */
        return 0;
    }
    if (e->type == ETH_ARP)
        return arp_input(nt, f, n, out);
    if (e->type == ETH_IP)
        return ip_input(nt, f, n, out);
    nt->dropped++;                      /* IPv6, VLAN и прочее — не наше */
    return 0;
}
pkt106c_f407.c — стек на F407: кадры из кольца дескрипторов и ответ дескриптором передачи.
/* 106б на F407: кадры из кольца дескрипторов 106а — в net_input, ответ — дескриптором передачи.
   armclang -DSTM32F407xx -include stm32f4xx.h -I _verify/eth106a; ядро стека — pkt106c.c. */
#include "eth106a.c"                    /* кольцо приёма rx_ring, OWN, NRX, BUF_SIZE, eth_rx_len — раздел 106а */
#include "pkt106c.h"

#define RX_ES   (1u << 15)              /* RDES0: сводка ошибок */
#define RX_FS   (1u << 9)               /* первый буфер кадра */
#define RX_LS   (1u << 8)               /* последний буфер кадра */
#define TX_LS   (1u << 29)              /* TDES0 */
#define TX_FS   (1u << 28)
#define TX_CIC  (3u << 22)              /* суммы IP и ICMP/UDP/TCP с псевдозаголовком — считает MAC */
#define TX_TCH  (1u << 20)              /* next — адрес следующего дескриптора */

_Static_assert(TX_CIC == 0x00C00000u && TX_TCH == 0x00100000u && TX_FS == 0x10000000u, "TDES0: CIC 23:22, TCH 20, FS 28");
_Static_assert(RX_ES == 0x8000u && RX_FS == 0x200u && RX_LS == 0x100u, "RDES0: ES 15, FS 9, LS 8");

static eth_desc_t tx_desc;
static uint32_t tx_buf[BUF_SIZE / 4];
static uint32_t rx_cur;
static net_t net = {.mac = {0x02, 0x00, 0x00, 0x00, 0x01, 0x06}, .ip = {10, 106, 2, 50}};

void eth_tx_init(void)
{
    tx_desc.buf  = (uint8_t *)tx_buf;
    tx_desc.next = &tx_desc;            /* кольцо из одного дескриптора */
    tx_desc.des0 = TX_TCH;              /* OWN = 0: дескриптор у программы */
    ETH->DMATDLAR = (uint32_t)&tx_desc;
    if (NET_HW_CSUM)
        ETH->DMAOMR |= ETH_DMAOMR_TSF;  /* вставка сумм работает только с накоплением кадра целиком */
}

void eth_poll(void)
{
    eth_desc_t *d = &rx_ring[rx_cur];
    uint32_t s;
    while (!((s = d->des0) & OWN)) {
        unsigned n = eth_rx_len(d) - 4u;                    /* FL — вместе с FCS */
        if ((s & (RX_ES | RX_FS | RX_LS)) == (RX_FS | RX_LS) && n <= BUF_SIZE && !(tx_desc.des0 & OWN)) {
            unsigned r = net_input(&net, d->buf, n, (uint8_t *)tx_buf);
            if (r) {
                tx_desc.des1 = r;                           /* до 60 байт дополнит и FCS добавит MAC */
                tx_desc.des0 = OWN | TX_FS | TX_LS | TX_TCH | (NET_HW_CSUM ? TX_CIC : 0u);
                ETH->DMATPDR = 0;                           /* передатчик: «есть кадр» */
            }
        }
        d->des0 = OWN;                                      /* буфер — обратно DMA */
        rx_cur = (rx_cur + 1u) % NRX;
        d = &rx_ring[rx_cur];
    }
    if (ETH->DMASR & ETH_DMASR_RBUS) {                      /* приём стоял: свободных буферов не было */
        ETH->DMASR = ETH_DMASR_RBUS;
        ETH->DMARPDR = 0;
    }
}

/* выравнивание: адреса IP в кадре — со смещения 26, не кратного 4 */
typedef struct {
    uint32_t src, dst;
} ip_pair_t;                            /* обычная структура: компилятор считает адрес кратным 4 */

typedef struct PACKED {
    uint32_t src, dst;
} ip_pair_packed_t;                     /* упакованная: адрес может быть любым */

uint32_t pair_xor(const ip_pair_t *p)
{
    return p->src ^ p->dst;
}

uint32_t pair_xor_packed(const ip_pair_packed_t *p)
{
    return p->src ^ p->dst;
}
Дальше: раздел 106в «lwIP на STM32: буферы, три интерфейса и память» — готовый стек, который делает то же и ещё TCP, и сколько он стоит в памяти F407.