 Embedded HandbookПриложения
112. Наблюдаемость: логи, метрики, оповещения
Стенд из раздела 111 работает — но как узнать, что он работает сейчас, в три часа ночи, и что прибор в дальнем цехе не перегрелся? Наблюдаемость отвечает на три вопроса дежурного: что случилось — журналы, насколько плохо — метрики, когда звать человека — оповещения. Раздел добавляет все три к приёмнику телеметрии и проверяет их сценарием: прибор перегревается, перезагружается, замолкает, а потом падает сам приёмник. Всё собрано в Compose из настоящих Prometheus v3.14.0 и Alertmanager v0.34.0.
Как это называется в документации
Оригинал Перевод observability наблюдаемость structured logging журнал со структурой: строка — запись JSON log rotation ротация журнала: старые файлы удаляются metric, time series метрика, временной ряд counter / gauge счётчик (только растёт) / показатель (любое значение) label метка ряда: dev="A1"scrape сбор метрик опросом alerting rule правило оповещения firing / resolved сработало / снято on-call дежурный
112.1 Путь данных
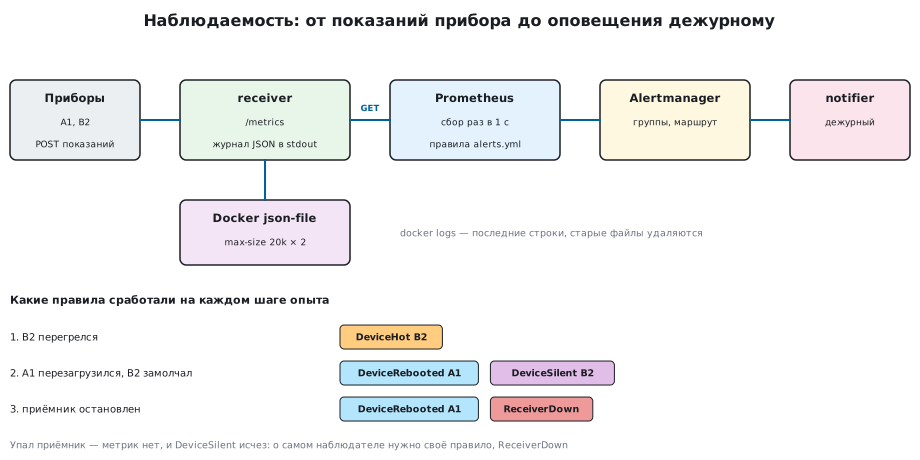
- Приёмник пишет каждое событие строкой JSON в стандартный вывод; Docker
складывает эти строки в файлы и отдаёт командой
docker logs. - Приёмник показывает счётчики и последние показания по адресу
/metrics; Prometheus опрашивает его раз в секунду и хранит историю. - Prometheus проверяет правила; сработавшее правило уходит в Alertmanager,
тот группирует оповещения и отправляет дежурному — в опыте это отдельный
сервис
notifier.
Каждое звено можно заменить — Loki вместо docker logs, VictoriaMetrics
вместо Prometheus, мессенджер вместо notifier, — а устройство останется
тем же.
112.2 Журнал: одна строка — одно событие
Строка вида «принято от A1, 21.5» удобна глазу, но её не отфильтровать и не сосчитать. Приёмник пишет запись JSON:
static void log_json(const char *level, const char *event, const char *extra)
{
    printf("{\"ts\":%.3f,\"level\":\"%s\",\"event\":\"%s\"%s%s}\n", now(), level, event, extra[0] ? "," : "", extra);
    fflush(stdout);
}
В журнале это выглядит так:
{"ts":1789230267.718,"level":"info","event":"telemetry","dev":"A1","t":21.5,"up":100}
{"ts":1789230271.973,"level":"warn","event":"alert","alert":"DeviceHot","status":"firing"}
У каждой записи — время, уровень и имя события, дальше — поля события.
Такие строки фильтруют по полю (event = telemetry, dev = B2),
а не регулярными выражениями. Писать — в стандартный вывод, не в файл
внутри контейнера: файл пропадёт вместе с контейнером, а вывод соберёт
Docker. fflush нужен, потому что вывод в канал буферизуется блоками,
и без него строки придут с опозданием.
112.3 Журнал не должен съесть диск
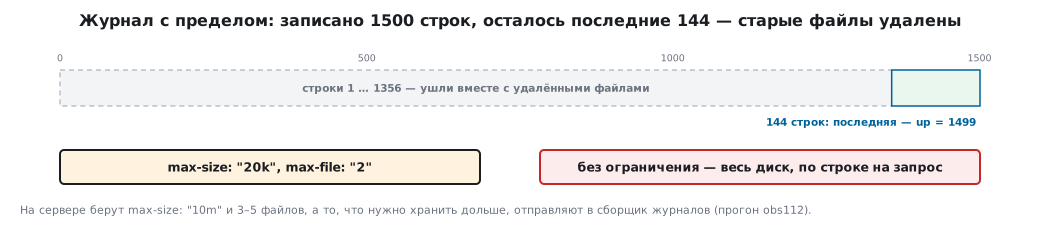
По умолчанию Docker хранит журнал контейнера без ограничений — приёмник, который пишет строку на каждый запрос, за месяцы заполнит диск сервера. Ограничение задаётся в Compose:
x-logging: &logging
  driver: json-file
  options:
    max-size: "20k"
    max-file: "2"
В опыте приёмник записал 1500 строк телеметрии, а docker logs вернул
только последние — около полутора сотен (в опыте — 144): остальные ушли вместе с удалёнными файлами. Последняя
строка — с up = 1499, то есть самая свежая. На сервере берут
max-size: "10m" и три-пять файлов; то, что нужно хранить дольше,
отправляют в сборщик журналов.
112.4 Метрики: счётчики и показатели
Метрика — число с именем и метками, которое Prometheus читает по запросу. Приёмник отдаёт их простым текстом:
telemetry_lines_total 2
telemetry_bad_total 1
device_temperature_celsius{dev="B2"} 65.0
device_uptime_seconds{dev="A1"} 100
Два вида, которые нельзя путать:
- счётчик (
_total) только растёт: принято строк, отвергнуто пакетов, ответов с кодом 200. Сам по себе он мало что говорит — важна скорость роста; - показатель — текущее значение: температура, время работы, момент последнего сообщения.
В имени — единица измерения (_celsius, _seconds), в метках — то, по чему
будут группировать (dev). Метки не должны расти без предела: номер
прибора — хорошая метка, время или текст ошибки — плохая, каждое новое
значение создаёт новый ряд.
В опыте строка «garbage» получила ответ 400 и попала в telemetry_bad_total:
счётчик ошибок так же важен, как счётчик успехов.
112.5 Что должен сообщать прибор
Приёмник знает только то, что ему прислали. Минимум, который стоит передавать в каждом сообщении:
- время работы с последнего сброса — по его падению видны перезагрузки;
- причину сброса — сторожевой таймер, питание, программный сброс (раздел 12.4);
- счётчики ошибок — повторы передачи, ошибки CRC, переполнения буферов;
- запас стека и свободную память, если есть ОСРВ (раздел 35);
- сами показания — температуру, напряжение питания.
Сообщение приходит регулярно, даже когда показания не изменились: молчание тоже сигнал, и правило о нём ниже.
112.6 Prometheus: сбор и запросы
global:
  scrape_interval: 1s
  evaluation_interval: 1s
scrape_configs:
  - job_name: receiver
    static_configs:
      - targets: ["receiver:8080"]
Раз в секунду Prometheus читает /metrics и сохраняет каждое значение
с отметкой времени. На сервере хватает 15–30 секунд; секунда в опыте —
чтобы не ждать. Для каждой цели Prometheus сам заводит ряд up: 1 — цель
ответила, 0 — нет.
Запросы на языке PromQL, которые дали в опыте:
| Запрос | Что считает | Результат |
|---|---|---|
rate(telemetry_lines_total[10s]) |
строк в секунду | около 1 |
max_over_time(device_temperature_celsius{dev="B2"}[1m]) |
максимум B2 за минуту | 65 |
resets(device_uptime_seconds{dev="A1"}[1m]) |
перезагрузок A1 за минуту | 1 |
rate() сам учитывает обнуление счётчика: после перезапуска приёмника
счётчик начался заново — 1500 после 1500 новых строк, — а скорость не
«провалилась» в минус.
112.7 Правила оповещений
      - alert: DeviceHot
        expr: device_temperature_celsius > 60
        for: 2s
      - alert: DeviceSilent
        expr: time() - device_last_seen_seconds > 10
      - alert: ReceiverDown
        expr: up{job="receiver"} == 0
        for: 3s
expr — условие, for — сколько оно должно держаться, прежде чем правило
сработает. Без for одиночный выброс датчика будил бы дежурного; с ним
правило сначала «ждёт», потом «срабатывает». DeviceRebooted построен
на resets() — оповещение о каждой перезагрузке прибора.
Главное правило — о самом наблюдателе. Когда приёмник остановлен, метрик
приборов нет, и правила о текущих значениях молчат: в опыте DeviceSilent
исчез в тот же момент — сравнивать стало не с чем. DeviceRebooted ещё
держался: он смотрит на минуту истории. Без ReceiverDown упавший приёмник
выглядел бы как «всё спокойно».
Но и ReceiverDown — правило того же Prometheus. Упадёт сам Prometheus,
Alertmanager, сервер целиком или связь с дежурным — не придёт ни одного
оповещения, и тишина снова выглядит как «всё спокойно». Последний уровень —
правило, которое горит всегда: expr: vector(1), обычно с именем Watchdog;
promtool test rules подтверждает, что оно горит, даже когда метрик нет вовсе.
Alertmanager повторяет его, скажем, раз в минуту во внешнюю службу, и она
сама будит дежурного, когда повторы перестали приходить. Плюс проверка
доступности сервера с другой машины.
112.8 Alertmanager: группы, маршруты, «снято»
route:
  receiver: notifier
  group_by: ["alertname", "dev"]
  group_wait: 1s
receivers:
  - name: notifier
    webhook_configs:
      - url: http://notifier:8080/api/alert
        send_resolved: true
Alertmanager собирает оповещения в группы — одно сообщение о десяти
замолчавших приборах вместо десяти, — отправляет по маршруту и повторяет,
если проблема не ушла. send_resolved присылает и отбой: в опыте
notifier получил DeviceHot со статусом firing, а когда B2 остыл —
тот же DeviceHot со статусом resolved.
Оповещения идут в notifier, а не в сам приёмник: ReceiverDown дошёл
именно потому, что получатель — другой сервис. Канал оповещений не должен
зависеть от того, за чем он следит.
112.9 Опыт по шагам
| Шаг | Что сделали | Сработало |
|---|---|---|
| 1 | A1 и B2 шлют показания, у B2 — 65.0 °C | DeviceHot для B2 |
| 2 | A1 перезагрузился и шлёт дальше, B2 остыл и замолчал | DeviceRebooted для A1, DeviceSilent для B2; DeviceHot снят |
| 3 | приёмник остановлен | ReceiverDown; DeviceSilent исчез вместе с метриками, DeviceRebooted держится |
До дежурного через Alertmanager дошли DeviceHot и DeviceSilent — оба
сработали и сняты, — DeviceRebooted и ReceiverDown. DeviceSilent сняли
не потому, что B2 заговорил, а потому, что пропали метрики: отбой
не всегда значит «исправлено».
112.10 Грабли
Диск сервера заполнился журналами. Нет max-size у журнала. Задать
ограничение в Compose или в настройках Docker.
Строки журнала приходят пачками с опозданием. Вывод буферизуется.
fflush(stdout) после записи или построчная буферизация.
Prometheus съел память. В метках — время, текст ошибки или номер запроса: каждое значение — новый ряд. Метки — только с ограниченным набором значений.
Дежурного будят выбросы. Нет for в правиле. Условие должно держаться.
Упал приёмник — и тишина. Правила только о приборах. Нужно правило
up == 0 о самом приёмнике.
Оповещение о падении не пришло. Его отправлял сервис, который упал. Канал оповещений — отдельно.
График счётчика «пилой». Показывают сырой счётчик, а он обнуляется
при перезапуске. Строить rate().
112.11 Итоги
- Журнал — строка JSON на событие в стандартный вывод; ограничение
max-sizeиmax-file: из 1500 строк осталось около полутора сотен последних. - Метрики: счётчики
_totalи показатели с единицей в имени; метки — только с ограниченным набором значений. - PromQL:
rate()— скорость счётчика с учётом обнуления,max_over_time()— максимум за окно,resets()— перезагрузки прибора. - Правила:
forпротив выбросов, отдельное правило о самом наблюдателе (ReceiverDown): без данных правила о текущих значениях молчат. - Alertmanager группирует, присылает
resolvedи шлёт в канал, не зависящий от наблюдаемого сервиса.
Этим разделом закончена часть XII «Сети и DevOps для инженера».
Полные исходники
obs.c — приёмник телеметрии с журналом в JSON и метриками для Prometheus.
/* Раздел 112: приёмник телеметрии, за которым можно наблюдать.
 *
 *   POST /api/telemetry   тело «dev=A1 t=21.5 up=120» — показания прибора
 *   POST /api/alert       приём оповещений от Alertmanager (роль notifier)
 *   GET  /metrics         счётчики и показания в текстовом формате Prometheus
 *   GET  /health          проверка здоровья
 *   obs --check           проверка здоровья изнутри образа FROM scratch
 *
 * Каждое событие — одна строка JSON в stdout: её собирает Docker, а читают
 * docker logs и любые сборщики журналов. Один процесс, одно соединение за раз. */
#define _GNU_SOURCE /* strcasestr */
#include <arpa/inet.h>
#include <netinet/in.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/socket.h>
#include <time.h>
#include <unistd.h>

#define MAX_DEV 8

struct device {
    char name[8];
    double temp;
    double uptime;
    double last_seen;
};

static struct device dev[MAX_DEV];
static int n_dev;
static unsigned long lines_total, alerts_total, bad_total;
static unsigned long http_total[6]; /* 200, 400, 404, 413, 500, прочие */

static double now(void)
{
    struct timespec ts;
    clock_gettime(CLOCK_REALTIME, &ts);
    return (double)ts.tv_sec + ts.tv_nsec / 1e9;
}

static void log_json(const char *level, const char *event, const char *extra)
{
    printf("{\"ts\":%.3f,\"level\":\"%s\",\"event\":\"%s\"%s%s}\n", now(), level, event, extra[0] ? "," : "", extra);
    fflush(stdout);
}

static void reply(int fd, int code, const char *type, const char *body)
{
    static const int codes[] = { 200, 400, 404, 413, 500 };
    const char *text = code == 200 ? "OK" : code == 400 ? "Bad Request" : code == 404 ? "Not Found"
                     : code == 413 ? "Payload Too Large" : "Internal Server Error";
    char head[256];
    int k = 5;
    for (int i = 0; i < 5; i++)
        if (codes[i] == code)
            k = i;
    http_total[k]++;
    int n = snprintf(head, sizeof head,
                     "HTTP/1.1 %d %s\r\nContent-Type: %s\r\nContent-Length: %zu\r\nConnection: close\r\n\r\n",
                     code, text, type, strlen(body));
    if (write(fd, head, (size_t)n) < 0 || write(fd, body, strlen(body)) < 0)
        return;
}

static struct device *find_dev(const char *name)
{
    for (int i = 0; i < n_dev; i++)
        if (strcmp(dev[i].name, name) == 0)
            return &dev[i];
    if (n_dev == MAX_DEV)
        return NULL;
    snprintf(dev[n_dev].name, sizeof dev[n_dev].name, "%s", name);
    return &dev[n_dev++];
}

/* «dev=A1 t=21.5 up=120»: 0 — принято, -1 — строка не разобрана. */
static int take_telemetry(const char *body)
{
    char name[8];
    double t, up;
    if (sscanf(body, "dev=%7[A-Za-z0-9] t=%lf up=%lf", name, &t, &up) != 3)
        return -1;
    struct device *d = find_dev(name);
    if (!d)
        return -1;
    d->temp = t;
    d->uptime = up;
    d->last_seen = now();
    lines_total++;
    char extra[96];
    snprintf(extra, sizeof extra, "\"dev\":\"%s\",\"t\":%.1f,\"up\":%.0f", name, t, up);
    log_json("info", "telemetry", extra);
    return 0;
}

static void metrics(char *out, size_t cap)
{
    static const char *const code_name[] = { "200", "400", "404", "413", "500", "other" };
    size_t n = 0;
    n += (size_t)snprintf(out + n, cap - n,
                          "# HELP telemetry_lines_total Lines of telemetry accepted.\n"
                          "# TYPE telemetry_lines_total counter\ntelemetry_lines_total %lu\n"
                          "# TYPE telemetry_bad_total counter\ntelemetry_bad_total %lu\n"
                          "# TYPE alerts_received_total counter\nalerts_received_total %lu\n"
                          "# TYPE http_requests_total counter\n",
                          lines_total, bad_total, alerts_total);
    for (int i = 0; i < 6; i++)
        n += (size_t)snprintf(out + n, cap - n, "http_requests_total{code=\"%s\"} %lu\n", code_name[i], http_total[i]);
    n += (size_t)snprintf(out + n, cap - n, "# TYPE device_temperature_celsius gauge\n");
    for (int i = 0; i < n_dev; i++)
        n += (size_t)snprintf(out + n, cap - n, "device_temperature_celsius{dev=\"%s\"} %.1f\n", dev[i].name, dev[i].temp);
    n += (size_t)snprintf(out + n, cap - n, "# TYPE device_uptime_seconds gauge\n");
    for (int i = 0; i < n_dev; i++)
        n += (size_t)snprintf(out + n, cap - n, "device_uptime_seconds{dev=\"%s\"} %.0f\n", dev[i].name, dev[i].uptime);
    n += (size_t)snprintf(out + n, cap - n, "# TYPE device_last_seen_seconds gauge\n");
    for (int i = 0; i < n_dev; i++)
        n += (size_t)snprintf(out + n, cap - n, "device_last_seen_seconds{dev=\"%s\"} %.3f\n", dev[i].name,
                              dev[i].last_seen);
}

/* Из тела оповещения Alertmanager берём статус и имя правила — для журнала. */
static void take_alert(const char *body)
{
    char status[16] = "?", name[48] = "?";
    const char *p = strstr(body, "\"status\":\"");
    if (p)
        sscanf(p + 10, "%15[a-z]", status);
    p = strstr(body, "\"alertname\":\"");
    if (p)
        sscanf(p + 13, "%47[A-Za-z0-9_]", name);
    alerts_total++;
    char extra[96];
    snprintf(extra, sizeof extra, "\"alert\":\"%s\",\"status\":\"%s\"", name, status);
    log_json("warn", "alert", extra);
}

static void serve(int fd)
{
    static char req[16384], out[8192];
    ssize_t got = 0, r;
    char *end = NULL;
    long want = 0;

    while (got < (ssize_t)sizeof req - 1 && (r = read(fd, req + got, sizeof req - 1 - (size_t)got)) > 0) {
        got += r;
        req[got] = 0;
        if (!end && (end = strstr(req, "\r\n\r\n")) != NULL) {
            const char *cl = strcasestr(req, "\r\nContent-Length:");
            want = cl ? atol(cl + 17) : 0;
        }
        if (end && got - (end + 4 - req) >= want)
            break;
    }
    if (!end) {
        reply(fd, 400, "text/plain", "bad request\n");
        return;
    }
    const char *body = end + 4;
    if (strncmp(req, "POST /api/telemetry ", 20) == 0) {
        if (want > 256) {
            reply(fd, 413, "text/plain", "too large\n");
        } else if (take_telemetry(body) == 0) {
            reply(fd, 200, "text/plain", "ok\n");
        } else {
            bad_total++;
            log_json("error", "bad_telemetry", "");
            reply(fd, 400, "text/plain", "bad telemetry\n");
        }
    } else if (strncmp(req, "POST /api/alert ", 16) == 0) {
        take_alert(body);
        reply(fd, 200, "text/plain", "ok\n");
    } else if (strncmp(req, "GET /metrics ", 13) == 0) {
        metrics(out, sizeof out);
        reply(fd, 200, "text/plain; version=0.0.4", out);
    } else if (strncmp(req, "GET /health ", 12) == 0) {
        reply(fd, 200, "text/plain", "ok\n");
    } else {
        reply(fd, 404, "text/plain", "not found\n");
    }
}

static int self_check(void)
{
    int s = socket(AF_INET, SOCK_STREAM, 0);
    struct sockaddr_in a = { .sin_family = AF_INET, .sin_port = htons(8080), .sin_addr.s_addr = htonl(INADDR_LOOPBACK) };
    const char q[] = "GET /health HTTP/1.1\r\nHost: self\r\n\r\n";
    char ans[64] = { 0 };
    if (s < 0 || connect(s, (struct sockaddr *)&a, sizeof a) < 0 || write(s, q, sizeof q - 1) < 0
        || read(s, ans, sizeof ans - 1) <= 0)
        return 1;
    close(s);
    return strncmp(ans, "HTTP/1.1 200", 12) == 0 ? 0 : 1;
}

int main(int argc, char **argv)
{
    if (argc > 1 && strcmp(argv[1], "--check") == 0)
        return self_check();
    int s = socket(AF_INET, SOCK_STREAM, 0), one = 1;
    struct sockaddr_in a = { .sin_family = AF_INET, .sin_port = htons(8080), .sin_addr.s_addr = htonl(INADDR_ANY) };
    setsockopt(s, SOL_SOCKET, SO_REUSEADDR, &one, sizeof one);
    if (bind(s, (struct sockaddr *)&a, sizeof a) < 0 || listen(s, 64) < 0) {
        perror("bind");
        return 1;
    }
    log_json("info", "start", "");
    for (;;) {
        int c = accept(s, NULL, NULL);
        if (c < 0)
            continue;
        serve(c);
        close(c);
    }
}
prometheus.yml — сбор метрик и подключение правил и Alertmanager.
# Раздел 112: сбор метрик раз в секунду (в опыте — чтобы не ждать; на сервере — 15–30 с).
global:
  scrape_interval: 1s
  evaluation_interval: 1s

rule_files:
  - /etc/prometheus/alerts.yml

alerting:
  alertmanagers:
    - static_configs:
        - targets: ["alertmanager:9093"]

scrape_configs:
  - job_name: receiver
    static_configs:
      - targets: ["receiver:8080"]
alerts.yml — правила оповещений.
# Раздел 112: правила оповещений. Порог и длительность — в правиле, а не в голове.
groups:
  - name: devices
    rules:
      - alert: ReceiverDown
        expr: up{job="receiver"} == 0
        for: 3s
        labels:
          severity: critical
        annotations:
          summary: "Приёмник телеметрии не отвечает"

      - alert: DeviceHot
        expr: device_temperature_celsius > 60
        for: 2s
        labels:
          severity: warning
        annotations:
          summary: "Прибор {{ $labels.dev }}: {{ $value }} °C"

      - alert: DeviceSilent
        expr: time() - device_last_seen_seconds > 10
        labels:
          severity: warning
        annotations:
          summary: "Прибор {{ $labels.dev }} молчит больше 10 с"

      - alert: DeviceRebooted
        expr: resets(device_uptime_seconds[1m]) > 0
        labels:
          severity: info
        annotations:
          summary: "Прибор {{ $labels.dev }} перезагрузился"
alertmanager.yml — куда и как группируются оповещения.
# Раздел 112: куда уходят оповещения. В опыте — в отдельный сервис notifier;
# на сервере — в почту, мессенджер или телефон дежурного.
route:
  receiver: notifier
  group_by: ["alertname", "dev"]
  group_wait: 1s
  group_interval: 2s
  repeat_interval: 1h

receivers:
  - name: notifier
    webhook_configs:
      - url: http://notifier:8080/api/alert
        send_resolved: true
Дальше: раздел 113 «Ada и SPARK: Alire, GNAT для Cortex-M, доказательство».