 Embedded HandbookПриложения
1. Микроконтроллер как таковой
Прежде чем мигать светодиодом, полезно понимать, чем именно вы управляете. Этот раздел — про устройство того, что лежит под всеми остальными: ядро, память, набор команд. Без него дальнейшие разделы придётся принимать на веру.
Как это называется в документации
Оригинал Перевод MCU (microcontroller unit) микроконтроллер: ядро, память и периферия на одном кристалле core, processor ядро, процессорная часть peripheral периферийный блок: таймер, АЦП, UART RISC (reduced instruction set computer) набор простых команд одинаковой длины architecture (ARMv7-M) архитектура: спецификация команд и модели исполнения licensee производитель, купивший лицензию на ядро core registers (R0–R12, SP, LR, PC, xPSR) регистры ядра memory map карта памяти: какие адреса чему принадлежат memory management unit (MMU) блок управления памятью: переводит виртуальные адреса в физические; у Cortex-M его нет bit-band region, alias region область бит-бэндинга и её отражение по битам Thumb-2 instruction set набор команд Thumb-2: 16- и 32-битные команды вперемешку pipeline: fetch, decode, execute конвейер: выборка, декодирование, исполнение
1.1 Что это вообще такое
Микроконтроллер (MCU, Micro Controller Unit) — цифровая микросхема, в которой на одном кристалле собрано всё, что нужно для самостоятельной работы:
- ядро — арифметико-логическое устройство и управление;
- ОЗУ (RAM) — оперативная память для данных;
- ПЗУ (Flash) — постоянная память для программы;
- периферия — АЦП, ЦАП, UART, SPI, I²C, таймеры и прочее.
Ключевое отличие от процессора: у процессора Flash и RAM на кристалле обычно нет — они выносятся наружу, чтобы удешевить и упростить производство. Микроконтроллер самодостаточен: подал питание — он работает.
Второе отличие для программиста важнее первого — блок управления памятью (MMU). Процессор, на котором работает Linux или Windows, переводит адреса: у каждой программы своё виртуальное адресное пространство, MMU на ходу отображает его на физическую память и не пускает программу в чужие страницы. На этом стоят процессы, защита памяти и подкачка. У микроконтроллера MMU нет: адрес в программе — это и есть физический адрес, и программа видит всю память сразу. У части Cortex-M есть MPU — он запрещает доступ к областям, но адресов не переводит (раздел 11а). Поэтому обычный Linux на Cortex-M не ставится (раздел 191.1), а работают на нём прошивка «на голом железе» или RTOS.
Первые однокристальные микроконтроллеры появились в 1970-х: TMS1000 у Texas Instruments и 8048 у Intel.
Две популярные архитектуры ядра
| ARM | RISC-V | |
|---|---|---|
| расшифровка | Advanced RISC Machine | reduced instruction set computer |
| лицензия | проприетарная, роялти в ARM Holdings | открытая и бесплатная |
| ниша | от МК до серверов и Apple M1 | недорогие МК, кастомные ядра |
Обе — RISC: команды закодированы так, чтобы декодироваться просто и выполняться быстро.
1.2 ARM, Cortex и кто что делает
Здесь легко запутаться, поэтому разложим по слоям.
Архитектура ARM (ARMv6-M, ARMv7-M, ARMv8-M…) — это спецификация: набор команд, модель исполнения, организация памяти, стоимость инструкций в тактах. Не железо, а документ. Компилятор, умеющий генерировать код для архитектуры, умеет его для всех процессоров, эту архитектуру реализующих.
Ядро Cortex-M — конкретная реализация архитектуры, готовый блок для встраивания в кристалл. Cortex-M3, например, спроектирован по ARMv7-M, а Cortex-M4 — по ARMv7E-M: та же архитектура плюс расширение DSP-командами. Часто пишут просто «M4 — это ARMv7-M», но буква E в названии как раз и означает добавленные команды цифровой обработки сигналов.
Микроконтроллер — ядро плюс то, что вокруг него добавил производитель кремния: Flash, RAM, периферия, шины. Этим занимаются ST, NXP, TI, Микрон, «Миландр» и десятки других. Сама ARM Holdings ничего не производит — она лицензирует архитектуру и ядра.
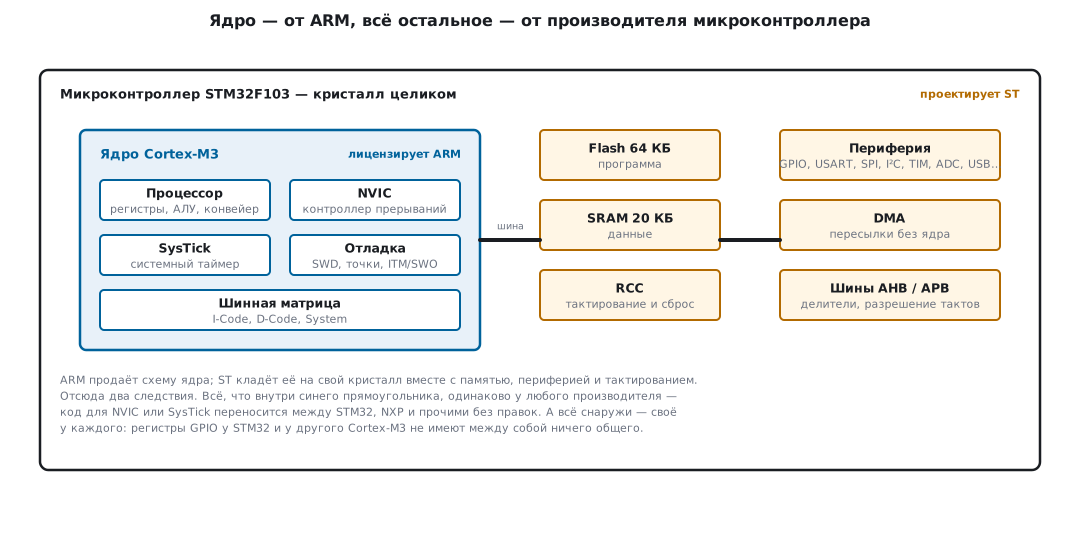 Ядро Cortex-M3 внутри микроконтроллера на его основе
Важное следствие: наличие ядра не гарантирует наличия функции. Cortex-M3 спроектирован с поддержкой bit-banding, но реализовать её — решение производителя. STM32F1 её реализует, а Cortex-M7 не имеет вовсе. Всегда сверяйтесь с reference manual конкретного МК, а не с описанием ядра.
Три семейства Cortex
| Семейство | Буква | Для чего |
|---|---|---|
| Cortex-A | Application | сложные вычисления, операционные системы (Linux, Android): телефоны, планшеты, одноплатники |
| Cortex-M | eMbedded | встраиваемые задачи: IoT, управление двигателями, счётчики, бытовая техника, медтехника |
| Cortex-R | Real-time | системы, где важны отказоустойчивость и гарантированное время реакции |
Нас интересует Cortex-M.
Cortex-M3 против Cortex-M4: что реально даёт переход на F4
Две опорные платформы этого справочника — STM32F103 (Cortex-M3) и STM32F407/F401 (Cortex-M4). Разница между ними не косметическая.
| Cortex-M3 (F1) | Cortex-M4 (F4) | |
|---|---|---|
| архитектура | ARMv7-M | ARMv7E-M |
| тактовая частота | до 72 МГц | до 180 МГц (F427/F429/F446/F469), 168 МГц (F405/F407), 84–100 МГц (F401/F410/F411) |
| FPU | нет | есть у всех STM32F4, одинарной точности |
| DSP-команды | нет | есть: MAC за такт, насыщающая арифметика, SIMD |
| конвейер | 3 стадии | 3 стадии |
| bit-banding | есть | есть |
| ускоритель Flash | префетч-буфер | ART Accelerator — кэш команд, ноль тактов ожидания |
| шина портов GPIO | APB2 | AHB1 |
| DMA | 7+5 каналов, без FIFO | 2 контроллера × 8 потоков, FIFO, burst |
Что это значит на практике.
Плавающая точка. На M3 каждое float-умножение — это вызов библиотечной функции
на десятки тактов. На M4 с FPU — одна инструкция. Для регуляторов, фильтров,
пересчёта показаний датчиков разница на порядок. Но FPU надо включить —
он выключен после сброса, и компилятору надо сказать -mfpu=fpv4-sp-d16
-mfloat-abi=hard, иначе вы получите M4, считающий как M3.
DSP-команды. Умножение с накоплением за такт, насыщающая арифметика (результат не переполняется, а упирается в предел) — то, на чём построена библиотека CMSIS-DSP: БПФ, КИХ- и БИХ-фильтры, матрицы. На M3 то же считается, но в разы медленнее.
ART Accelerator. На 168–180 МГц Flash физически не успевает отдавать команды — нужны такты ожидания. ART кэширует команды и ветви так, что при линейном исполнении ожиданий фактически нет. Именно поэтому F407 на 168 МГц даёт около 210 DMIPS — те же 1,25 DMIPS на мегагерц, что и F103 на 72 МГц (90 DMIPS): производительность растёт вместе с частотой, хотя Flash требует пяти тактов ожидания. Без ART на тех же 168 МГц ядро большую часть времени ждало бы Flash.
⚠️ Главная ловушка перехода F1 → F4 лежит не в ядре, а в периферии: другие шины тактирования (
AHB1ENRвместоAPB2ENR), другие базовые адреса, другая регистровая модель GPIO, другой DMA. Код, работающий с ядром — NVIC, SysTick, bit-banding, — переносится без правок. Код, работающий с периферией, переписывается почти весь. Разбор по каждой периферии — в соответствующих разделах.
1.3 Регистры ядра
Cortex-M — машина типа load/store: арифметика выполняется только над регистрами, а с памятью работают отдельные инструкции загрузки и сохранения.
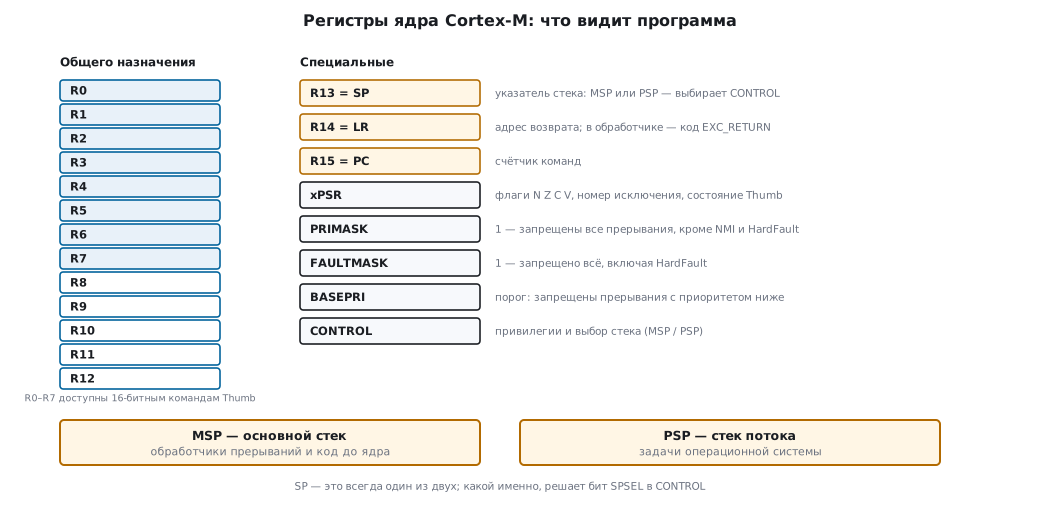 Регистры ядра Cortex-M
| Регистр | Назначение |
|---|---|
R0–R12 |
общего назначения; часть компилятор использует под свои нужды |
R13 (SP) |
указатель стека, банкированный — меняется при смене режима CPU |
R14 (LR) |
адрес возврата из подпрограммы |
R15 (PC) |
счётчик команд |
xPSR |
флаги состояния программы |
«Банкированный» SP означает, что физически указателей стека два — MSP и PSP.
Обработчики исключений всегда работают на MSP, а основной код — на MSP после
сброса или на PSP, если в регистре CONTROL поставлен бит SPSEL. Привилегии
задаёт отдельный бит того же регистра (nPRIV), и выбор стека от них не зависит.
На двух стеках построено переключение задач в ОСРВ: у каждой задачи свой PSP,
а прерывания работают на общем MSP. Подробнее — в разделе 26.
Как это выглядит в жизни. Простой код на C:
uint8_t a, b, c;
a = 3;
b = 2;
c = a * b;
компилируется примерно в такое (Thumb, без оптимизации, под Cortex-M4):
movs   r3, #3         ; занести 3 в r3
strb   r3, [r7, #7]   ; сохранить r3 в переменную a
movs   r3, #2         ; занести 2 в r3
strb   r3, [r7, #6]   ; сохранить r3 в переменную b
ldrb   r2, [r7, #7]   ; загрузить a в r2
ldrb   r3, [r7, #6]   ; загрузить b в r3
smulbb r3, r2, r3     ; умножить, результат в r3
strb   r3, [r7, #5]   ; сохранить результат в c
smulbb — умножение младших 16-битных половин из DSP-команд Cortex-M4.
У Cortex-M3 (F103) такой команды нет, там на этом месте будет mul r3, r2, r3.
Ни одна операция не выполняется «в памяти» — всё проходит через регистры. Отсюда практический вывод: чем меньше лишних обращений к памяти в горячем цикле, тем быстрее код.
1.4 Карта памяти
Адрес у Cortex-M 32-битный, поэтому адресов ровно 2³² = 4 294 967 296 — это и есть
4 ГБ: последний байт имеет номер 0xFFFF FFFF, больше в 32 бита не помещается.
ARM делит это пространство на области одинаково у всех Cortex-M любого
производителя: код внизу, SRAM с 0x2000 0000, периферия с 0x4000 0000, регистры
ядра наверху. Переносимым это делает только код ядра — о нём сразу под таблицей.
Периферия внутри своей области у каждого производителя и даже у каждого семейства
STM32 своя: порт, таймер или UART с F1 на F4 без правки не переносятся (раздел 1.10).
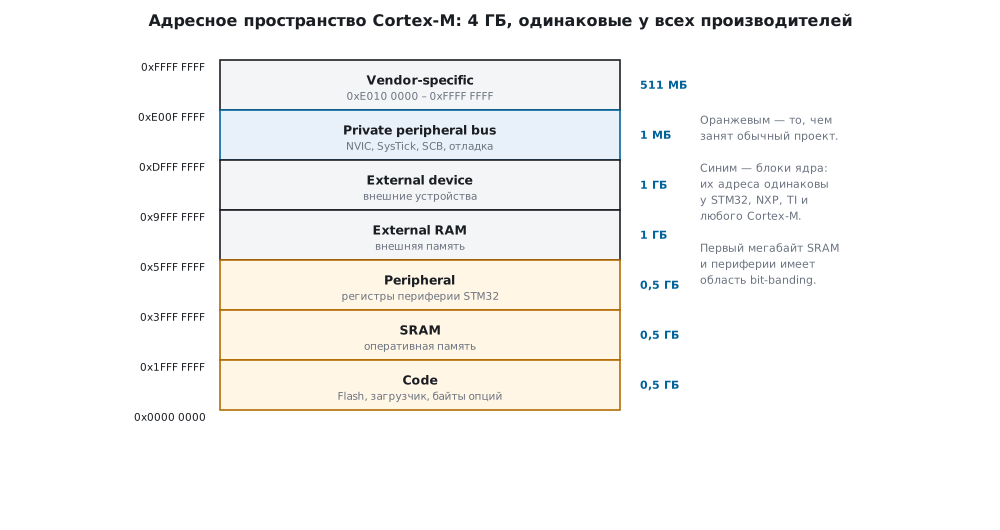 Фиксированная карта адресного пространства Cortex-M
| Диапазон | Размер | Что там |
|---|---|---|
0x0000 0000 … |
512 МБ | код: таблица векторов, начальный указатель стека, программа |
0x2000 0000 … |
512 МБ | внутренняя SRAM |
0x4000 0000 … |
512 МБ | периферия |
0x6000 0000 … |
2 ГБ | внешняя память через FSMC/EMI |
0xE000 0000 … |
512 МБ | регистры самого ядра Cortex (NVIC, SysTick, отладка) |
Регистры ядра лежат по фиксированным адресам у всех Cortex-M — поэтому код, работающий с NVIC или SysTick, переносится без правок.
Область кода у STM32
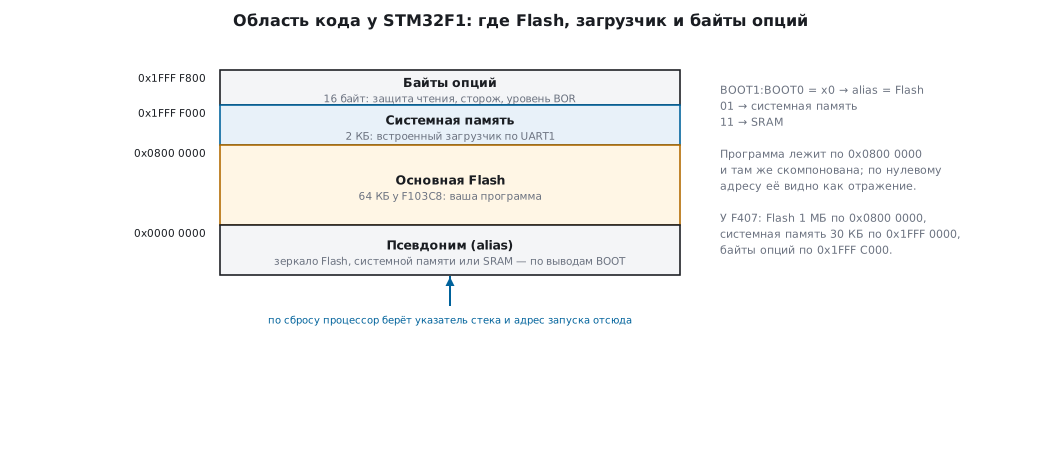 Разметка области кода у STM32
Внутренняя Flash у всех STM32 живёт с адреса 0x0800 0000. При этом она
дублируется («алиасится») с адреса 0x0000 0000 — в зависимости от настройки
загрузки. Одна и та же функция доступна и как 0x0800 16DC, и как 0x0000 16DC.
Дальше идут две служебные области:
- System memory — ПЗУ с заводским загрузчиком: плата шьётся без программатора.
Интерфейсы загрузчика зависят от семейства: у F103C8 (BluePill) — только
USART1наPA9/PA10, у F105/F107 и F405/F407 к нему добавляются USB DFU и CAN, у F401 — USB DFU, I²C и SPI. Подробности в разделах 4.9 и 11. - Option bytes — флаги конфигурации МК: защита Flash от чтения, аппаратный сторожевой таймер, режим загрузки.
Сколько на самом деле SRAM
Область SRAM начинается с 0x2000 0000, но реальный конец зависит от объёма памяти
в вашем кристалле. Для STM32F103RB с 20 КБ:
20 КБ = 20 × 1024 = 0x5000 байт
последний адрес = 0x2000 0000 + 0x4FFF = 0x2000 4FFF
Обращение за эту границу вызывает исключение Bus Fault.
1.5 Bit-banding
Проблема
Менять один бит переменной приходится постоянно:
uint8_t temp = 0;
temp |= 0x4;     // установить бит 2
temp &= ~0x4;    // сбросить бит 2
Каждая такая строка превращается в три инструкции — загрузить, изменить, сохранить:
ldrb   r3, [r7, #7]
orr.w  r3, r3, #4
strb   r3, [r7, #7]
Отсюда две беды. Первая — потраченные такты. Вторая серьёзнее: между чтением и записью может вклиниться прерывание или переключение задачи, изменить то же слово — и ваша запись затрёт чужое изменение. Классическая гонка.
Решение
Bit-banding отображает каждый бит специальной области памяти на целое слово в другой, «зеркальной» области. Записал слово — изменился ровно один бит, одной операцией, без гонок.
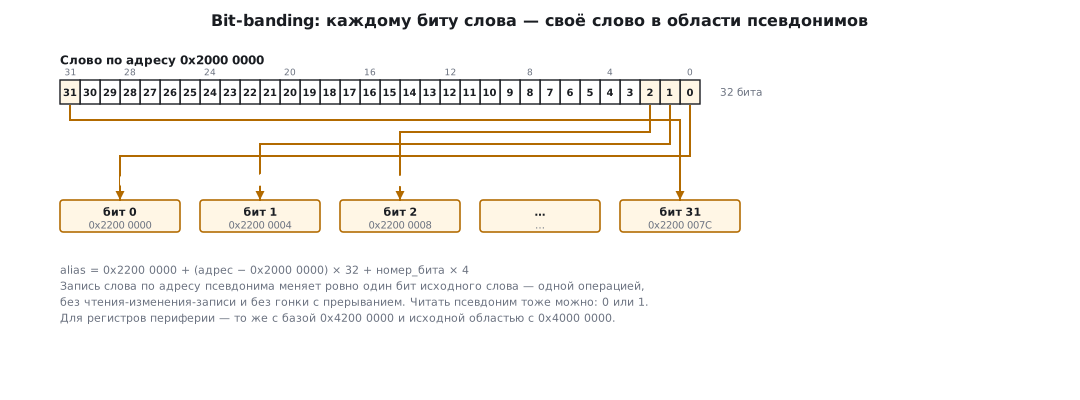 Отображение бит адреса
0x2000 0000 в bit-band область
Формула пересчёта:
alias_адрес = база_alias + (смещение_в_области × 32) + (номер_бита × 4)
Две области у Cortex-M3/M4:
| Что | bit-band область | alias-область |
|---|---|---|
| SRAM | 0x2000 0000–0x200F FFFF (1 МБ) |
0x2200 0000–0x23FF FFFF (32 МБ) |
| периферия | 0x4000 0000–0x400F FFFF (1 МБ) |
0x4200 0000–0x43FF FFFF (32 МБ) |
Соотношение 1 МБ ↔ 32 МБ объясняется просто: каждому биту исходной области соответствует целое 32-битное слово в alias.
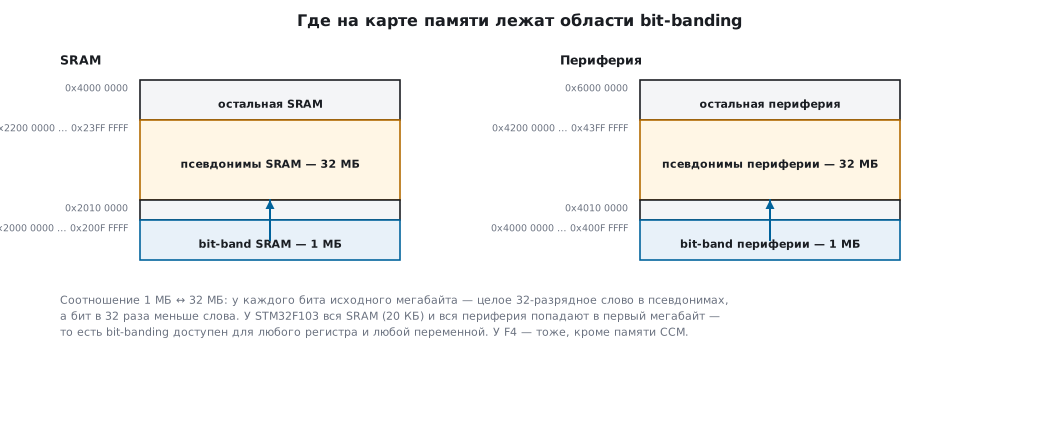 Области bit-banding на общей карте памяти
Макросы
#define BITBAND_SRAM_BASE   0x20000000u
#define ALIAS_SRAM_BASE     0x22000000u
#define BITBAND_SRAM(a, b)  ((ALIAS_SRAM_BASE + (((uint32_t)&(a)) - BITBAND_SRAM_BASE) * 32u + ((b) * 4u)))

#define BITBAND_PERI_BASE   0x40000000u
#define ALIAS_PERI_BASE     0x42000000u
#define BITBAND_PERI(a, b)  ((ALIAS_PERI_BASE + (((uint32_t)(a)) - BITBAND_PERI_BASE) * 32u + ((b) * 4u)))
Мигание светодиодом на PC13 (STM32F103) без операции «чтение-изменение-запись»:
volatile uint32_t *pc13 = (uint32_t *)BITBAND_PERI(&GPIOC->ODR, 13);
*pc13 = 1;      /* одна запись — один бит */
Считаем вручную для проверки: база GPIOC у F1 равна 0x4001 1000, смещение ODR — 0x0C.
смещение   = 0x4001100C − 0x40000000 = 0x1100C
alias      = 0x42000000 + 0x1100C × 32 + 13 × 4 = 0x4222 01B4
⚠️ Адреса из чужих примеров не переносятся. В руководствах часто встречается расчёт для
GPIOA->ODRпо адресу0x4002 0014— это STM32F4. У STM32F1 базы портов другие (GPIOA=0x4001 0800), и смещениеODRравно0x0C, а не0x14. Скопировав такой адрес на F1, вы попадёте мимо регистра. Всегда считайте адрес от&GPIOx->ODR, а не от константы.⚠️ Номер бита зависит от того, какой адрес вы подставили. Для адреса байта номера бит идут 0…7, для адреса слова — 0…31. Оба варианта дают один и тот же alias-адрес (4 байта × 32 = 32 бита × 4), но перепутать диапазоны легко: байт
0x400F FFFFс «битом 31» вылетает за границу alias-области.⚠️ Bit-banding не отменяет чтения. Запись в псевдоним шина выполняет сама как чтение-изменение-запись всего регистра. От прерываний это защищает, от самой периферии — нет. В регистре флагов, которые сбрасываются записью единицы (
EXTI->PR), запись единицы в один бит прочитает все взведённые флаги и вернёт их единицами — сбросятся все ждущие линии, та же ошибка, что сEXTI->PR |=(раздел 7.9). В регистре, где флаг сбрасывается записью нуля (TIMx->SR), сотрётся флаг, который железо поднимет между чтением и записью. Такие флаги сбрасывают прямой записью маски:EXTI->PR = EXTI_PR_PR3,TIM2->SR = ~TIM_SR_UIF.⚠️ Bit-banding есть не везде. Его нет у Cortex-M0/M0+, нет у Cortex-M7 (F7, H7) и у ядер ARMv8-M — Cortex-M33 и более новых (L5, U5, H5, WBA). На эти семейства код с bit-band не перенесётся; атомарно менять бит там можно через
BSRRу выводов,LDREX/STREX(кроме M0/M0+) или критическую секцию.
1.6 Thumb-2 и выравнивание
Зачем понадобился Thumb
У ARM исторически 32-битные команды: богатый набор и хорошая производительность, но каждая команда занимает 4 байта Flash. Flash — это площадь кристалла, а значит цена и потребление.
Thumb — 16-битный набор, подмножество самых ходовых команд. Они прозрачно разворачиваются в 32-битные при исполнении, без потери скорости. Код на Thumb занимает около 65 % от размера ARM-кода. Плата — урезанные возможности: условными могут быть только переходы, многие команды видят лишь половину регистров.
Thumb-2 смешивает 16- и 32-битные команды в одном режиме: плотность кода как у Thumb, полнота набора почти как у ARM. Cortex-M3/M4/M7 поддерживают его целиком, а M4/M7 добавляют команды для чисел с плавающей точкой.
Выравнивание
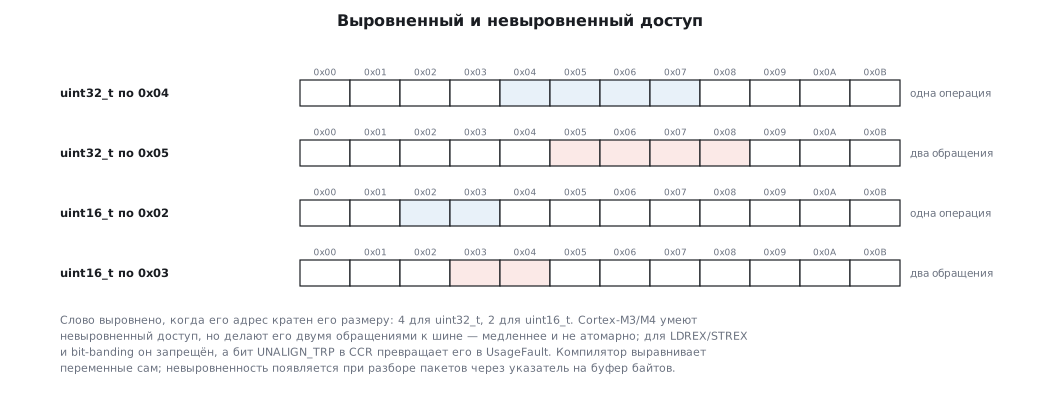 Выровненный и невыровненный доступ
Выровненный доступ означает, что 32-битная переменная лежит по адресу, кратному
4 (0x2000 0000, 0x2000 0004…), 16-битная — кратному 2. Ранние ARM иначе не умели,
и это дробило память: между переменными оставались неиспользуемые байты.
Cortex-M3/M4/M7 умеют невыровненный доступ: команды LDR/STR и их
полусловные варианты работают и с адресом, не кратным размеру. Компилятор при этом
всё равно выравнивает переменные и поля структур. Плотно данные ложатся только
в упакованной структуре (__attribute__((packed))), например при разборе пакета.
Невыровненное обращение дороже — шина делает два обращения — и не атомарно.
У Cortex-M0/M0+ такого доступа нет вовсе, там будет HardFault; у M3/M4 его можно
превратить в отказ битом UNALIGN_TRP в SCB->CCR.
⚠️ Невыровненный доступ разрешён не всем командам — только
LDR,LDRT,LDRH,LDRHT,LDRSH,LDRSHT,STR,STRT,STRH,STRHT. Остальные при невыровненном адресе дают исключение UsageFault. Отдельно помните: регистры периферии почти всегда требуют доступа целым словом. У GPIO STM32F1 доступ полусловом или байтом запрещён прямо в документации.
1.7 Конвейер
Выполнение команды — это не один шаг: сначала её надо достать из памяти (fetch), затем декодировать (decode), и только потом выполнить (execute). Если делать это последовательно, процессор большую часть времени простаивает.
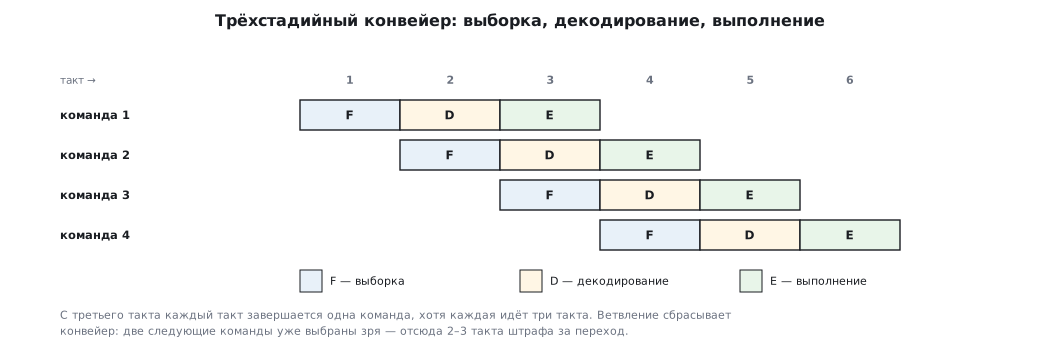 Трёхстадийный конвейер команд
Конвейер выполняет стадии разных команд параллельно: пока одна исполняется, следующая декодируется, а третья загружается.
| Ядро | Стадий |
|---|---|
| Cortex-M0+ | 2 (меньше стадий — меньше энергии, что важно для маломощных МК) |
| Cortex-M0/M3/M4 | 3 |
| Cortex-M7 | 6 |
Плата за конвейер — ветвления. Когда программа делает условный переход, уже загруженные в конвейер команды оказываются ненужными и отбрасываются («тень ветвления»). Отсюда практический вывод для горячих циклов: меньше непредсказуемых переходов — плотнее работа конвейера.
1.8 На чём пишут
Язык Си, созданный Деннисом Ритчи в 1970-х, остаётся основным инструментом: на нём написано больше 80 % кода микроконтроллерных систем.
Почему именно он:
- Компилируемый и эффективный — машинный код, высокая производительность, компактные программы. Во встраиваемых системах, где ресурсы жёстко ограничены, это решает.
- Низкоуровневый — позволяет работать на уровне регистров и оптимизировать под конкретное железо.
- Переносимый — код переносится между платформами.
Исследование университетов Minho, Nova de Lisboa и Coimbra по 27 языкам показало, что Си — самый энергоэффективный и самый быстрый по времени исполнения.
C++ применяется там, где нужна работа с графикой и сложным интерфейсом — на нём построена библиотека TouchGFX от ST для дисплеев высокого разрешения.
1.9 Тот же Cortex-M3, но отечественный: 1986ВЕ9х
Полезное упражнение для понимания, где кончается ядро и начинается производитель: российский микроконтроллер 1986ВЕ9х («Миландр») построен на том же ядре ARM Cortex-M3, что и STM32F1.
| 1986ВЕ9х | STM32F103C8 | |
|---|---|---|
| ядро | Cortex-M3 | Cortex-M3 |
| тактовая частота | до 80 МГц | до 72 МГц |
| Flash | 128 КБ | 64/128 КБ |
| ОЗУ | 32 КБ | 20 КБ |
| АЦП | 2 × 12 бит, до 0,5 Мвыб/с, 16 каналов | 2 × 12 бит, 1 Мвыб/с |
| ЦАП | 2 × 12 бит | нет у C8 |
| генераторы | HSI 8 МГц, LSI 40 кГц, HSE 2…16 МГц, LSE 32 кГц | HSI 8 МГц, LSI 40 кГц, HSE 4…16 МГц, LSE 32,768 кГц |
| питание | 2,2–3,6 В, встроенный регулятор 1,8 В | 2,0–3,6 В |
| батарейный домен | есть, с RTC | есть, с RTC |
Совпадает почти всё, кроме имён регистров периферии: у «Миландра» настройка вывода
задаётся отдельными регистрами OE, FUNC, ANALOG, PULL, PWR, а не парой
MODE/CNF, как у STM32F1.
Что из этого следует. Всё, что относится к ядру — регистры R0–R15, карта
памяти, NVIC, SysTick, Thumb-2, конвейер — переносится один в один. Всё, что
относится к периферии, — не переносится вообще. Граница между «знаниями об ARM»
и «знаниями об STM32» проходит ровно здесь.
1.10 Грабли
Код с F1 на F4 «почти» переносится, но периферия молчит. Ядро то же, а шины тактирования, базовые адреса, GPIO и DMA другие: код ядра (NVIC, SysTick) переносится, код периферии — переписывается (1.2).
Запись по адресу из чужого примера ничего не делает. Адрес 0x4002 0014 — GPIOA->ODR у F4; у F1 база
порта и смещение другие. Адрес берут выражением &GPIOx->ODR, а не числом (1.5).
Bit-banding выходит за пределы области. Номер бита для адреса байта — 0…7, для слова — 0…31; перепутали — промах мимо alias-области (1.5).
Код с bit-banding собирается на F7/H7, но не работает. Адрес псевдонима для компилятора — обычное число, а у Cortex-M0/M0+, M7 и M33 такой области нет: запись уходит в пустоту или кончается отказом шины (1.5).
UsageFault на ровном месте. Невыровненный доступ разрешён только LDR/STR и их вариантам; регистры
периферии — только целым словом, у GPIO F1 полуслово и байт запрещены (1.6).
1.11 Итоги
- Микроконтроллер = ядро + Flash + RAM + периферия на одном кристалле; процессор память наружу выносит.
- ARM продаёт архитектуру и ядра, кремний делают ST, «Миландр» и другие. Ядро определяет систему команд и карту памяти, производитель — периферию.
- Наличие функции в описании ядра не значит наличия её в вашем МК: bit-banding есть у M3/M4, нет у M0/M0+, M7 и M33.
- Адресное пространство 4 ГБ одинаково у всех Cortex-M; регистры ядра всегда по одним адресам — отсюда переносимость системного кода.
- Flash у STM32 начинается с
0x0800 0000и дублируется с0x0000 0000. - Bit-banding заменяет «чтение-изменение-запись» одной атомарной записью, но адреса
надо считать от реального
&GPIOx->ODR, а не от готовой константы. - Cortex-M работает в Thumb-2; невыровненный доступ разрешён, но не всем командам и почти никогда — регистрам периферии.
Дальше: раздел 2 «Портфель STM32 и выбор камня» — как из двух с лишним тысяч микроконтроллеров выбрать нужный и что означают буквы в маркировке.