 Embedded HandbookПриложения
69. Вещественные числа
float выглядит как обычное число с дробной частью, но ведёт себя
иначе: у него ограниченная точность, одни и те же вычисления в разном
порядке дают разный результат, а сравнение на равенство работает
случайно.
На микроконтроллере добавляется вопрос цены. У Cortex-M4 есть блок
вещественной арифметики, но только одинарной точности: float он
считает одной командой, а double уходит в библиотеку. Одна пропущенная
буква f в константе незаметно превращает команду в три вызова
функций. У Cortex-M3 блока нет вовсе. Всё это видно по машинному коду.
Как это называется в документации
Оригинал Перевод floating point, IEEE 754 плавающая точка, стандарт IEEE 754 sign, exponent, mantissa (significand) знак, порядок, мантисса bias смещение порядка normalized, denormal (subnormal) нормализованное, денормализованное machine epsilon машинный эпсилон ulp (unit in the last place) шаг между соседними числами infinity, NaN бесконечность, «не число» rounding mode режим округления FPU блок вещественной арифметики single, double precision одинарная, двойная точность fixed point, Q15 фиксированная точка, формат Q15 double promotion неявное расширение до double
69.1 Как устроено число
Число хранится в нормализованном виде — как в научной записи, только по основанию 2:
значение = (−1)^знак × 1,мантисса × 2^(порядок − смещение)
float |
double |
|
|---|---|---|
| всего бит | 32 | 64 |
| знак | 1 | 1 |
| порядок | 8, смещение 127 | 11, смещение 1023 |
| мантисса | 23 (+1 скрытый) | 52 (+1 скрытый) |
Ведущая единица мантиссы не хранится: у нормализованного числа она есть
всегда. Поэтому у float 24 значащих бита при 23 хранимых.
Пример из раздела 63.15: 15,625 = 1111,101₂ = 1,111101 × 2³. Знак 0,
порядок 3 + 127 = 130, мантисса — всё после запятой. Получается слово
0x417A0000. Ещё несколько чисел:
| Число | Слово в памяти |
|---|---|
| 1,0 | 0x3F800000 |
| −2,0 | 0xC0000000 |
| 0,625 | 0x3F200000 |
| 3,875 | 0x40780000 |
| 64 | 0x42800000 |
| 0,1 | 0x3DCCCCCD |
| 3,14 | 0x4048F5C3 |
| 3,1415926535 | 0x40490FDB |
Строка про 0,1 заслуживает внимания. Двоичная запись 0,1 бесконечна, и
мантисса обрезана с округлением — вверх. Поэтому 0.1f на самом деле
равно 0,10000000149…, чуть больше одной десятой.
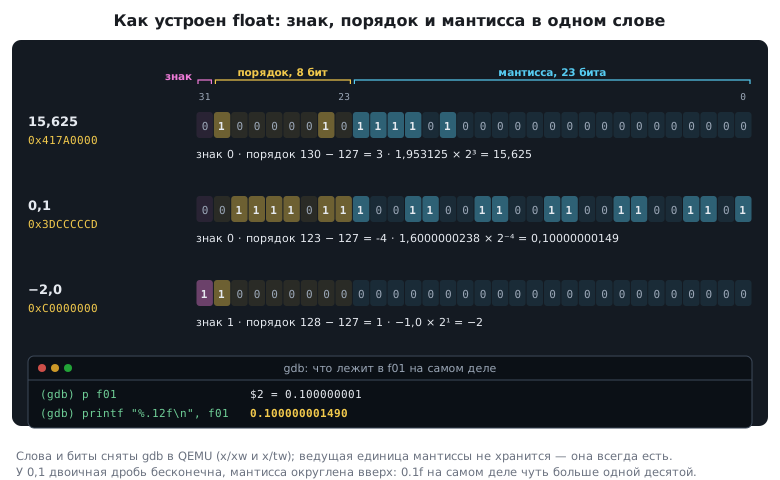
Разобрать любое число по битам — вкладка «float / Q» в калькуляторах приложения: слово в памяти, порядок, мантисса, что хранится на деле, и то же число в Q15 и Q16.16 (раздел 69.9).
69.2 Точность: около семи цифр
Главная характеристика — шаг между соседними числами. Около единицы
у float он равен 1,19·10⁻⁷ — это FLT_EPSILON, 2⁻²³. У double —
2,2·10⁻¹⁶.
float |
double |
|
|---|---|---|
| шаг после 1,0 | 1,19·10⁻⁷ | 2,2·10⁻¹⁶ |
| верных десятичных цифр гарантированно | 6 | 15 |
| наибольшее | 3,4·10³⁸ | 1,8·10³⁰⁸ |
| наименьшее нормальное | 1,18·10⁻³⁸ | 2,2·10⁻³⁰⁸ |
Шаг растёт вместе с числом: чем больше значение, тем грубее сетка. Отсюда два эффекта, которые удивляют.
Большие целые теряют единицы. float точно хранит целые только до
2²⁴ = 16 777 216. Прибавьте к этому числу единицу — получите его же:
следующее представимое число на 2 больше. Счётчик импульсов в float
однажды перестанет расти.
Малое теряется рядом с большим. Около 10⁸ соседние float отстоят
на 8. Поэтому (1e8f + 1.0f) − 1e8f — это ноль, а не единица.
Складывая много чисел разного масштаба, их упорядочивают от меньших к
большим — тогда малые успевают накопиться.
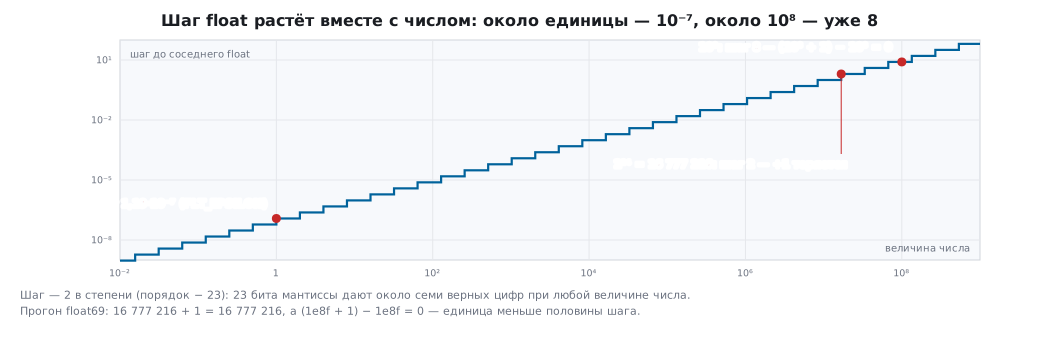
Для double те же эффекты наступают гораздо дальше — но на Cortex-M4 он
дорог (69.6).
69.3 Сравнение
Раз числа приближённые, сравнение на равенство — лотерея:
0.1f + 0.2f == 0.3f     /* истина — совпало случайно */
0.1  + 0.2  == 0.3      /* ложь — в double не совпало */
Одно и то же выражение в одинарной точности даёт «равно», в двойной —
«не равно». Верить нельзя ни тому, ни другому. А десять раз прибавленная
0.1f даёт 1,000000119, и с 1.0f она не равна вовсе (раздел 65.7).
Сравнивают с допуском:
if (fabsf(a - b) < 1e-6f)                              /* абсолютный */
if (fabsf(a - b) <= 1e-6f * fmaxf(fabsf(a), fabsf(b))) /* относительный */
Абсолютный допуск годится, когда масштаб чисел известен: напряжения,
углы. Для величин, которые могут быть и крошечными, и огромными, нужен
относительный — иначе при больших значениях допуск меньше шага сетки и
не срабатывает никогда. Относительный же не работает около нуля: при b = 0
он сам равен нулю. Поэтому обычно проверяют оба:
fabsf(a - b) <= 1e-6f || fabsf(a - b) <= 1e-5f * fmaxf(fabsf(a), fabsf(b)) —
абсолютный для малых значений, относительный для больших.
69.4 Бесконечность и «не число»
Вещественная арифметика не падает на делении на ноль:
| Выражение | Результат |
|---|---|
1.0f / 0.0f |
бесконечность, inf |
0.0f / 0.0f |
«не число», NaN |
NaN == NaN |
ложь |
любое действие с NaN |
снова NaN |
NaN не равен даже сам себе — поэтому его проверяют функцией isnan
(или трюком x != x). И он заразен: попав в вычисление, он проходит
через все формулы до результата.
На камне это выглядит так: датчик вернул ноль, деление дало
бесконечность, регулятор (раздел 47) посчитал из неё NaN — и дальше
все его выходы NaN, а ШИМ получает мусор. Ничего не упало, всё просто
перестало работать. Входы формул проверяют до деления, а результат —
isnan или isfinite, прежде чем отдать его в железо.
Между наименьшим нормальным числом и нулём есть ещё денормализованные — вплоть до 1,4·10⁻⁴⁵. Они нужны, чтобы вычитание близких чисел не давало внезапный ноль.
69.5 Округление
Способов несколько, и дают они разное:
| Выражение | Результат | Как округляет |
|---|---|---|
(int)2.7f, (int)-2.7f |
2, −2 | отбрасывает дробь (раздел 64.7) |
roundf(2.5f) |
3 | половину — от нуля |
rintf(2.5f) |
2 | половину — к чётному |
roundf(-2.7f) |
−3 | к ближайшему |
(int)(-2.7f + 0.5f) |
−2 | трюк «прибавить половину» ломается на отрицательных |
Округление к чётному — режим по умолчанию в самой арифметике: при накоплении оно не даёт систематического сдвига в одну сторону.
Про цену: приведение (int)x на Cortex-M4 — одна команда, а roundf —
вызов библиотечной функции.
69.6 FPU Cortex-M4: что он умеет
Вот что компилятор делает из простых функций на Cortex-M4 с блоком вещественной арифметики:
| Операция | Машинный код |
|---|---|
a * b, float |
vmul.f32 — одна команда |
a / b, float |
vdiv.f32 |
sqrtf(x) |
vsqrt.f32; у GCC — только с -fno-math-errno, иначе добавляются проверка и запасной вызов |
fabsf(x) |
vabs.f32 |
x < y |
vcmp.f32 и перенос флагов vmrs |
(int)x |
vcvt.s32.f32 |
a * b, double |
вызов __aeabi_dmul |
roundf(x) |
вызов библиотеки |
FPU у M4 только одинарной точности. Каждое действие с double —
вызов программной функции, в десятки раз медленнее (раздел 3.1). У Cortex-M7
в H7 и F76x/F77x блок двойной точности, и double там — тоже команды; у F74x/F75x
и у Cortex-M33 (U5, L5) снова только float. Что именно есть в камне, код
узнаёт по битам предопределённого имени __ARM_FP (раздел 77.2).
На Cortex-M3 блока нет вообще, и даже float умножается библиотечной
__aeabi_fmul. На F103 вещественная арифметика — всегда программная, и
это главный довод в пользу фиксированной точки (69.9).
69.7 Невидимый double
Три места, где double появляется без вашего ведома:
Константа без суффикса.
float scale(float x)  { return x * 0.1;  }   /* 0.1 — это double */
float scalef(float x) { return x * 0.1f; }
Первая функция на Cortex-M4 — это три вызова библиотеки: расширить
x до double, умножить в double, сузить обратно. Вторая — одна
команда vmul.f32. Разница в одну букву.
Иногда компилятор выручает сам. Если константа во float записывается
точно — 1.5, 0.5, 3.0, — а результат снова float, он вправе посчитать
одной командой: ответ выйдет тот же до бита. С 0.1 так нельзя — во float
это другое число, и умножение остаётся в double. Вот что делают оба
компилятора с одним и тем же файлом для Cortex-M4 с FPU:
float x, выражение |
GCC -O0 |
GCC -O2 |
GCC -O2 -fsingle-precision-constant |
armclang -O0 |
armclang -O2 |
|---|---|---|---|---|---|
x * 1.5 |
FPU | FPU | FPU | библиотека | FPU |
x / 3.0 |
FPU | FPU | FPU | библиотека | FPU |
x * 0.1 |
библиотека | библиотека | FPU | библиотека | библиотека |
sin(x) |
double |
double |
double |
double |
double |
Ключ GCC -fsingle-precision-constant делает float все константы без
суффикса, но действует на весь файл — и там, где двойная точность была нужна:
double y = x * 1.5 с ним считается во float и только потом расширяется.
armclang этого ключа не знает и пропускает его с предупреждением. Функций ключ
не касается вовсе: sin(x) при float x — это расширение, sin в double и
сужение; нужен sinf(x). Поэтому правило остаётся прежним — суффикс f у каждой
вещественной константы.
Присваивание или возврат double. double y = x; при float x —
вызов __aeabi_f2d.
printf с float. Функции с переменным числом аргументов получают
float расширенным до double — таково правило языка. printf("%f", x)
при float x тоже вызывает __aeabi_f2d, и с этим ничего не сделать:
%f принимает только double.
Хуже всего то, что компилятор молчит — даже с -Wall -Wextra. Все
три места находит только ключ -Wdouble-promotion. В проекте для M4 его
стоит включить с первого дня, как и привычку писать f в каждой
вещественной константе.
69.8 FPU нужно включить
После сброса блок вещественной арифметики выключен. Включает его
запись в регистр SCB->CPACR — полный доступ для сопроцессоров 10 и 11:
SCB->CPACR |= (3UL << 10 * 2) | (3UL << 11 * 2); /* 0x00F00000 */
Обычно этого не видно: строка стоит в SystemInit системного файла F4
и выполняется до main. Но только при условии, что в камне FPU есть и
проект собран с ним: ключи -mfpu=fpv4-sp-d16 и -mfloat-abi=hard или
softfp (раздел 77.3), в Keil — выбор FPU в настройках цели. Тогда
__FPU_USED равно 1, иначе условие ложно, и строка пропускается. В своём
стартовом коде после записи в CPACR ставят __DSB(); __ISB();: до них
вещественная команда может ещё не увидеть включённый блок.
float в прерывании на M4 допустим. Если прерванный код пользовался FPU,
ядро при входе оставляет в стеке место и под его регистры: кадр растёт с 32
до 104 байт. Сохраняет их ядро лениво — только когда обработчик сам выполнит
вещественную команду. Стек задач и прерываний считают с этим запасом (7а.4).
Если FPU не включён, а в коде встретилась вещественная команда,
процессор уходит в отказ: в регистре состояния отказов выставляется бит
NOCP, девятнадцатый, — «сопроцессор недоступен» (раздел 35.2).
Типичный случай — свой стартовый код без SystemInit или вещественная
операция раньше него.
69.9 Фиксированная точка
Если FPU нет или важна предсказуемость, дробные величины хранят целыми с известным масштабом (раздел 3.1).
Масштаб — удобная единица. Напряжение с АЦП в милливольтах вместо вольт:
int mv_i = adc * 3300 / 4095;                   /* целые */
int mv_f = (int)(adc * 3.3f / 4095.0f * 1000);  /* через float */
Обе строки дают для кодов 0, 2048 и 4095 одно и то же: 0, 1650 и
3300 мВ. Но целая версия даже на Cortex-M3 обходится без библиотеки: и
без команды деления — деление на постоянное 4095 компилятор заменил
умножением на обратное число. Произведение 4095 × 3300 = 13 513 500
легко помещается в 32 бита. Формула пересчёта — в разделе 14.1.
Формат Q15 — стандарт для цифровой обработки сигналов: число
хранится в int16_t, а означает n / 32768. Диапазон — от −1 до
0,99997. Умножение — целое умножение и сдвиг:
int16_t q15_mul(int16_t a, int16_t b) { return (int16_t)(((int32_t)a * b) >> 15); }
/* 0,5 × 0,5: 16384 × 16384 >> 15 = 8192, то есть 0,25 */
Эту формулу ломает одна пара: −1 × −1. Произведение 32 768 в int16_t
не помещается и становится −32 768 — минус на минус дал минус единицу.
В фильтрах и регуляторах на полной шкале такая пара встречается, поэтому
результат ограничивают:
int16_t q15_mul_sat(int16_t a, int16_t b)
{
    int32_t p = ((int32_t)a * b) >> 15;
    return p > 32767 ? 32767 : (int16_t)p;      /* за край выходит только −1 × −1 */
}
На Cortex-M3 и M4 то же делает команда насыщения SSAT — в C
__SSAT(p, 16); ей ограничивают результат и функции Q15 библиотеки
CMSIS-DSP (раздел 81а).
Формат Q16.16 — когда у величины есть целая часть: число хранится в
int32_t, старшие 16 бит — целая часть, младшие — дробная, значение —
n / 65536. Диапазон — от −32 768 до 32 767,99998, шаг — 0,0000153.
Складывают и вычитают обычными целыми командами; умножение и деление
требуют 64-битного промежутка:
typedef int32_t q16_t;
#define Q16(x) ((q16_t)((x) * 65536.0))

static q16_t q16_mul(q16_t a, q16_t b) { return (q16_t)(((int64_t)a * b) >> 16); }
static q16_t q16_div(q16_t a, q16_t b) { return (q16_t)(((int64_t)a << 16) / b); }
В опыте 3,3 записывается как 216 268: преобразование отбрасывает дробь
шага, и хранится 3,29999. Умножение на 1,5 даёт 4,949982, деление —
2,199982. Промежуточное произведение 216 268 × 98 304 = 21 260 009 472 в
32 бита не помещается, и без приведения к int64_t результат был бы
мусором — это переполнение знакового числа, то есть неопределённое
поведение.
На Cortex-M4 умножение Q16.16 обходится тремя командами: SMULL даёт
64-битное произведение, два сдвига собирают нужные 32 бита. Деления
64 на 32 бита в железе нет — компилятор вызывает библиотечную
__aeabi_ldivmod. Поэтому в быстрых циклах делят заранее: умножают на
обратную величину, посчитанную один раз.
Фиксированная точка требует думать о переполнении и масштабе, зато результат одинаков на любом камне, а скорость не зависит от наличия FPU.
69.10 Грабли
Расчёт на M4 медленный, хотя FPU есть. Где-то double: константа
без f, double-переменная, возврат double. Ключ
-Wdouble-promotion найдёт.
printf("%f") тянет библиотеку double. Так устроены функции с
переменным числом аргументов.
Сравнение == то работает, то нет. Равенство вещественных — дело
случая; нужен допуск.
Допуск не срабатывает на больших значениях. Абсолютный допуск меньше шага сетки; нужен относительный.
Счётчик в float перестал расти. После 16 777 216 единица теряется.
Сумма многих малых чисел оказалась меньше ожидаемой. Малые терялись на фоне большого накопленного значения.
Регулятор выдаёт NaN. Деление на ноль где-то в начале формулы;
NaN прошёл до выхода.
(int)(x + 0.5f) округляет отрицательные неправильно. Нужен
roundf.
Программа падает на первой вещественной операции. FPU не включён:
бит NOCP в регистре отказов.
На F103 вещественный расчёт в десятки раз медленнее, чем на F407. У Cortex-M3 нет FPU: всё программно.
69.11 Итоги
float— 1 бит знака, 8 порядка со смещением 127 и 23 мантиссы плюс скрытая единица; 15,625 — это0x417A0000.- Шаг сетки около единицы — 1,19·10⁻⁷, около семи верных цифр; шаг растёт с числом: после 16 777 216 теряются единицы, около 10⁸ шаг — 8.
- Равенство вещественных — случайность:
0.1f + 0.2f == 0.3fистинно,0.1 + 0.2 == 0.3ложно. Сравнивают с допуском. - Деление на ноль даёт бесконечность или
NaN;NaNне равен сам себе и заражает вычисления. roundf(2.5f)— 3,rintf(2.5f)— 2, а трюк с прибавлением половины ломается на отрицательных.- FPU Cortex-M4 считает
floatодной командой,double— библиотекой; у M3 FPU нет. - Константа без
fпревращает одну команду в три вызова; компилятор молчит, находит-Wdouble-promotion. - FPU включается в
SystemInitзаписью0x00F00000вSCB->CPACR; без этого — отказ с битомNOCP. - Фиксированная точка — целые с масштабом: милливольты, сотые доли градуса, Q15.
Полные исходники
q1616.c — формат Q16.16: умножение и деление.
/* Подраздел 69.9: формат Q16.16 — старшие 16 бит целая часть, младшие 16 дробная.
 * Значения печатаются на компьютере и на ARM (qemu-arm); во что компилируются
 * умножение и деление для Cortex-M4 — смотрит q16_ops.c. */
#include <stdint.h>
#include <stdio.h>

typedef int32_t q16_t;
#define Q16(x) ((q16_t)((x) * 65536.0))

static q16_t q16_mul(q16_t a, q16_t b) { return (q16_t)(((int64_t)a * b) >> 16); }
static q16_t q16_div(q16_t a, q16_t b) { return (q16_t)(((int64_t)a << 16) / b); }

int main(void)
{
    q16_t v = Q16(3.3), k = Q16(1.5);
    q16_t p = q16_mul(v, k), d = q16_div(v, k);
    printf("v=%ld k=%ld\n", (long)v, (long)k);
    printf("mul=%ld val=%.6f\n", (long)p, p / 65536.0);
    printf("div=%ld val=%.6f\n", (long)d, d / 65536.0);
    printf("step=%.9f max=%.5f\n", 1 / 65536.0, 2147483647 / 65536.0);
    long long wide = (long long)v * k;
    printf("wide=%lld fits32=%d\n", wide, wide <= 2147483647LL);
    printf("done=1\n");
    return 0;
}
Дальше: раздел 70 «Структуры и файлы».