 Embedded HandbookПриложения
9. Прямой доступ к памяти (DMA)
Пока процессор перекладывает байты из массива в регистр периферии, он не делает ничего полезного. DMA — отдельный контроллер, который занимается этим сам: ядро задаёт откуда, куда и сколько, а дальше свободно.
9.1 Что это даёт
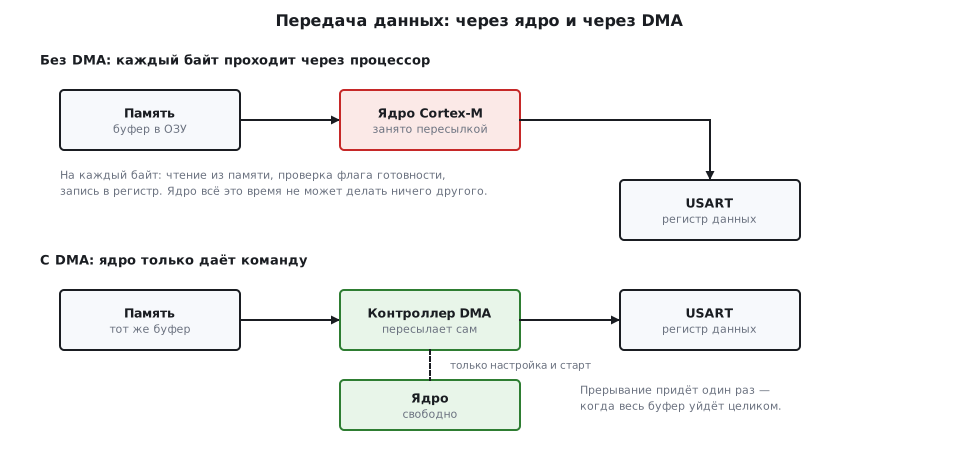
Разница не только в скорости. При передаче через ядро на каждый байт уходит чтение, проверка флага готовности и запись — и всё это в цикле, из которого нельзя выйти, не потеряв данные. При передаче через DMA прерывание приходит один раз, когда весь буфер ушёл целиком.
Типичные задачи, где без DMA плохо:
- приём и передача больших пакетов по UART, SPI, I²C;
- непрерывная оцифровка АЦП: без DMA часть отсчётов будет потеряна;
- вывод на дисплей — там счёт идёт на десятки килобайт за кадр;
- генерация сигнала на ЦАП или ШИМ по таблице;
- управление адресными светодиодами, где важна точность до микросекунд.
Как это называется в документации
Оригинал Перевод direct memory access прямой доступ к памяти channel / stream канал (F1) / поток (F4) transfer complete передача завершена half transfer передана половина буфера circular mode циклический режим memory increment инкремент адреса памяти peripheral increment инкремент адреса периферии source / destination источник / приёмник burst transfer пакетная передача FIFO threshold порог заполнения буфера FIFO double buffer mode режим двойной буферизации arbiter арбитр приоритетов update DMA request ( UDE)запрос DMA по событию обновления таймера pacing timer таймер, задающий темп передачи repetition counter ( RCR)счётчик повторений
9.2 Каналы у F1, потоки у F4
Это одно из самых заметных расхождений между платформами. Код не переносится вообще: отличаются и имена регистров, и сама модель.
| STM32F1 | STM32F407 | |
|---|---|---|
| единица | канал | поток (stream) |
| сколько | DMA1 — 7 каналов, DMA2 — 5 | DMA1 и DMA2 — по 8 потоков |
| выбор источника | жёстко зашит: у каждого канала свой список | поток + выбор одного из 8 каналов |
| буфер FIFO | нет | есть, 4 слова |
| пакетная передача | нет | есть |
| двойная буферизация | нет | есть |
| память ↔ память | умеет DMA1 и DMA2 | только DMA2 |
| регистры | CCRx, CNDTRx, CPARx, CMARx |
SxCR, SxNDTR, SxPAR, SxM0AR, SxFCR |
| флаги | один регистр ISR на все каналы |
LISR для потоков 0–3, HISR для 4–7 |
Что это значит на практике. У F1 вы не выбираете, каким каналом обслуживать
периферию: USART1_TX — это всегда канал 4 контроллера DMA1, и никак иначе.
Таблица привязок есть в reference manual, и её приходится держать под рукой.
Отсюда же и конфликты: если двум блокам периферии нужен один канал, одновременно
работать они не смогут.
У F4 гибче: поток выбирается вами, а внутри него полем CHSEL указывается,
чей запрос он обслуживает. Тот же USART1_TX — это поток 7 контроллера DMA2,
канал 4.
Куда DMA вообще дотягивается. Ведущих на шине несколько: ядро, оба контроллера DMA, Ethernet, USB HS. Соединяет их с памятью и периферией шинная матрица — набор путей, по которым ведущий доходит до ведомого, и арбитр, который решает, кто пройдёт первым, когда двое просят одного и того же. Пока ведущие ходят к разным ведомым, они работают по-настоящему одновременно: DMA перекладывает байты из UART в память, а ядро в это же время исполняет код из Flash.
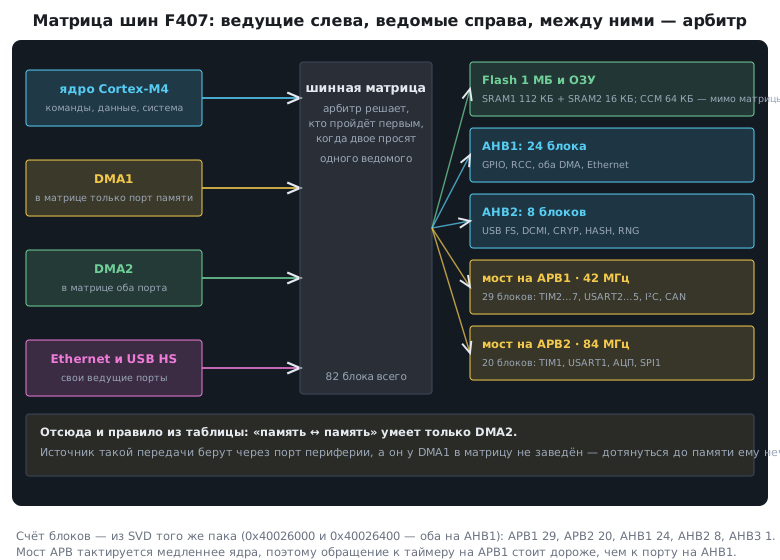
Периферия висит не на одной шине, а на пяти. У STM32F407 блоков 82 — по описанию камня (SVD): 24 на AHB1 (порты, RCC, оба DMA, Ethernet), 8 на AHB2, один на AHB3 и остальные за двумя мостами — 29 на APB1 и 20 на APB2. Мост нужен потому, что APB тактируется медленнее: при 168 МГц у ядра APB1 работает на 42 МГц, APB2 — на 84 (раздел 6.6). Обращение через мост стоит дороже: запрос идёт через переходник между шинами с разной частотой, и ответ приходит не в том же такте, что с AHB1.
Отсюда и строка таблицы «память ↔ память — только DMA2», которая иначе выглядит произволом. Источник такой передачи контроллер берёт через порт периферии, а у DMA1 этот порт в матрицу не заведён — дотянуться до памяти ему нечем. У DMA2 в матрице оба порта, поэтому он читает из одного места памяти и пишет в другое.
⚠️ Два ведущих к одному ведомому — это очередь, а не «одновременно». Если DMA и ядро одновременно лезут в SRAM, арбитр пропустит одного, а второй подождёт такт. На глаз это незаметно, но в измерении времени обработчика появляется разброс, которого нет в расчёте по тактам (раздел 73).
9.3 Что нужно задать для передачи
Независимо от платформы, настройка сводится к пяти вещам:
| Что | F1 | F4 |
|---|---|---|
| адрес периферии | CPAR |
SxPAR |
| адрес памяти | CMAR |
SxM0AR |
| количество элементов | CNDTR |
SxNDTR |
| направление | бит DIR |
поле DIR (два бита) |
| размер элемента и инкремент | PSIZE, MSIZE, PINC, MINC |
те же имена в SxCR |
Инкремент — ключевая настройка, которую путают чаще всего. Адрес памяти
обычно должен расти (MINC включён), адрес периферии — нет: регистр данных
всегда один и тот же. Включите PINC по ошибке — и DMA пойдёт писать в соседние
регистры периферии.
Размер элемента задаётся отдельно для памяти и для периферии, и они могут различаться: например, 16-битные отсчёты АЦП складывать в 16-битный массив. Несовпадение размеров — источник загадочных «сдвинутых» данных.
⚠️ Счётчик передач 16-битный. Максимум 65535 элементов за одну настройку — и на F1, и на F4. Для большего нужен циклический режим с обработкой по половине буфера.
9.4 Режимы
Обычный. Передал NDTR элементов, выключился, поднял флаг завершения.
Для повторной передачи канал надо перенастроить.
Циклический (CIRC у F1, CIRC у F4). Досчитав до конца, счётчик
перезагружается сам и передача идёт по кругу. Незаменим для непрерывной
оцифровки АЦП и вывода звука: настроили один раз — работает вечно.
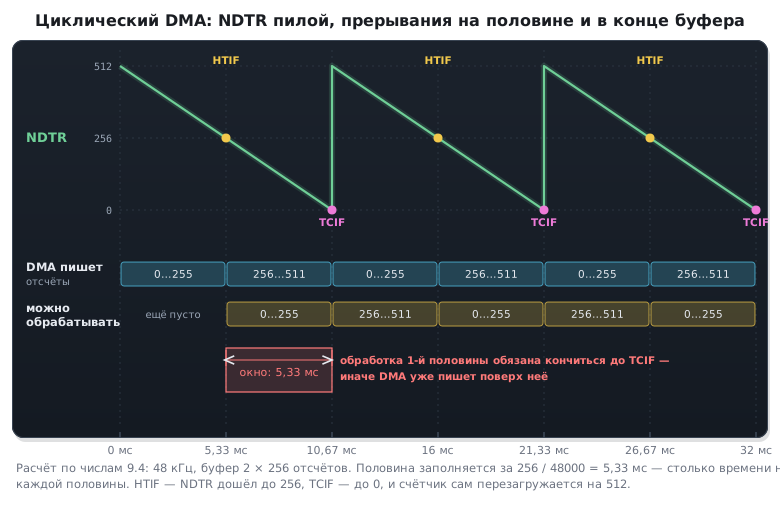
При этом приходят два прерывания: половина буфера (HTIF) и конец
буфера (TCIF). Приём такой: пока DMA заполняет вторую половину, вы
обрабатываете первую, и наоборот. Данные не переписываются под руками,
пока обработка половины укладывается во время заполнения другой: при 48 кГц
и буфере 2 × 256 отсчётов это 5,3 мс. Не успели — DMA молча запишет поверх.
Это классическая двойная буферизация «на бедных», доступная и на F1.
Память в память. DMA копирует не обязательно быстрее memcpy, зато ядро
в это время свободно: считает, обслуживает прерывания или спит. У F4 есть
ограничение: DMA1 этого не умеет вовсе, только DMA2.
Периферия в периферию. Режима с таким именем нет. Направление у F4 задаёт
поле DIR в SxCR — два бита, и занятых значений три: «периферия → память»
(0), «память → периферия» (1), «память → память» (2); у F1 направление —
бит DIR в CCRx, а «память в память» — отдельный бит MEM2MEM. Четвёртого
варианта в списке нет, и это не упущение: он не нужен.
Передачу между двумя блоками делают обычной «периферия → память»:
| Что задать | Значение |
|---|---|
| направление | периферия → память |
| адрес со стороны периферии | регистр данных источника |
| адрес со стороны памяти | регистр данных приёмника |
| приращение адресов | выключено с обеих сторон: PINC = 0, MINC = 0 |
Контроллеру всё равно, что стоит за адресом: для него оба — просто точки на шине. Отсюда и требование к приращению: регистр блока один, двигать указатель некуда, а включённое приращение уедет на соседний регистр и испортит настройку приёмника.
Так перекладывают, например, отсчёты АЦП прямо в регистр ЦАП или принятые по SPI байты в передатчик USART — без единой команды процессора.
⚠️ Запрос даёт только одна сторона. Канал привязан к одному блоку — тому, чей запрос он слушает. Второй обязан быть готов всегда: механизма «подожди, я занят» здесь нет, и если приёмник не успел, данные пропадут молча. Поэтому так соединяют блоки с заведомо разной скоростью: медленный источник — быстрый приёмник.
⚠️ Оба адреса должны быть видны из матрицы шин. Память CCM у старших F4 подключена прямо к ядру и в матрицу не заведена (раздел 2) — ни как источник, ни как приёмник DMA она не годится.
9.5 🔧 Рецепт: передача по UART через DMA
STM32F103. USART1_TX жёстко привязан к каналу 4 DMA1.
static char tx_buf[64];

void DMA_USART1_TX_Init(void)
{
    RCC->AHBENR |= RCC_AHBENR_DMA1EN;          /* DMA на шине AHB */

    DMA1_Channel4->CCR &= ~DMA_CCR4_EN;        /* настраивать только выключенным */

    DMA1_Channel4->CPAR = (uint32_t)&USART1->DR;
    DMA1_Channel4->CMAR = (uint32_t)tx_buf;
    DMA1_Channel4->CNDTR = 0;

    DMA1_Channel4->CCR = DMA_CCR4_DIR          /* из памяти в периферию */
                       | DMA_CCR4_MINC         /* адрес памяти растёт */
                       | DMA_CCR4_TCIE         /* прерывание по завершении */
                       | DMA_CCR4_PL_1;        /* высокий приоритет */

    NVIC_SetPriority(DMA1_Channel4_IRQn, 6);
    NVIC_EnableIRQ(DMA1_Channel4_IRQn);

    USART1->CR3 |= USART_CR3_DMAT;             /* разрешить запросы от USART */
}

void DMA_USART1_Send(const char *data, uint16_t len)
{
    if (len > sizeof(tx_buf)) {
        len = sizeof(tx_buf);
    }
    while (DMA1_Channel4->CCR & DMA_CCR4_EN) { }   /* прошлая передача ещё идёт */
    memcpy(tx_buf, data, len);

    DMA1_Channel4->CCR &= ~DMA_CCR4_EN;
    DMA1_Channel4->CNDTR = len;
    DMA1_Channel4->CCR |= DMA_CCR4_EN;
}

void DMA1_Channel4_IRQHandler(void)
{
    if (DMA1->ISR & DMA_ISR_TCIF4) {
        DMA1->IFCR = DMA_IFCR_CTCIF4;          /* сброс — в отдельном регистре */
        DMA1_Channel4->CCR &= ~DMA_CCR4_EN;
    }
}
Пока DMA отдаёт буфер, писать в него нельзя: поэтому DMA_USART1_Send сначала
ждёт, пока обработчик по TCIF4 выключит канал.
STM32F407. Тот же USART1_TX — поток 7 контроллера DMA2, канал 4.
void DMA_USART1_TX_Init(void)
{
    RCC->AHB1ENR |= RCC_AHB1ENR_DMA2EN;

    /* Выключаем поток и ЖДЁМ подтверждения: у F4 бит EN сбрасывается не сразу. */
    DMA2_Stream7->CR &= ~DMA_SxCR_EN;
    while (DMA2_Stream7->CR & DMA_SxCR_EN) { }

    /* Сбрасываем флаги прошлой передачи — иначе новая может не пойти. */
    DMA2->HIFCR = DMA_HIFCR_CTCIF7 | DMA_HIFCR_CHTIF7 | DMA_HIFCR_CTEIF7
                | DMA_HIFCR_CDMEIF7 | DMA_HIFCR_CFEIF7;

    DMA2_Stream7->PAR  = (uint32_t)&USART1->DR;
    DMA2_Stream7->M0AR = (uint32_t)tx_buf;
    DMA2_Stream7->NDTR = 0;

    DMA2_Stream7->CR = (4u << DMA_SxCR_CHSEL_Pos)   /* канал 4 = USART1_TX */
                     | DMA_SxCR_DIR_0               /* 01: память -> периферия */
                     | DMA_SxCR_MINC
                     | DMA_SxCR_TCIE
                     | DMA_SxCR_PL_1;

    DMA2_Stream7->FCR &= ~DMA_SxFCR_DMDIS;          /* прямой режим, без FIFO */

    NVIC_SetPriority(DMA2_Stream7_IRQn, 6);
    NVIC_EnableIRQ(DMA2_Stream7_IRQn);

    USART1->CR3 |= USART_CR3_DMAT;
}
Два отличия, которые стоит запомнить: ожидание сброса EN и обязательный
сброс флагов перед новой передачей. У F1 ни того, ни другого не требуется,
и именно на этом спотыкаются при переносе.
9.6 FIFO у F4
У каждого потока есть буфер на 4 слова. Он позволяет собирать мелкие порции в крупные обращения к шине: DMA накапливает данные и пишет их пачкой.
DMA2_Stream7->FCR |= DMA_SxFCR_DMDIS;                 /* включить FIFO */
DMA2_Stream7->FCR |= DMA_SxFCR_FTH;                   /* порог — полный буфер */
Когда это нужно: при высоких скоростях и при разной разрядности источника и приёмника — например, читать из памяти словами, а отдавать в периферию байтами.
Когда не нужно: для UART на обычных скоростях прямой режим (DMDIS = 0) проще
и надёжнее. Неверно подобранный порог даёт ошибку FEIF и молчаливо портит
передачу.
Пакеты: несколько слов за одно обращение к шине
С включённым FIFO поток умеет отдавать накопленное пакетом — 4, 8 или
16 обращений подряд, без арбитража между ними (MBURST для памяти,
PBURST для периферии). В прямом режиме пакеты недоступны: железо
принудительно держит одиночные обращения. Правила, за нарушение которых
платят ошибкой на шине, не видной в регистрах DMA:
| Правило | Откуда |
|---|---|
| размер пакета × ширина данных не больше порога FIFO: при пороге ¼ и байтах — только пакет из 4, при полном FIFO и словах — тоже только из 4 | таблица допустимых сочетаний в описании контроллера |
| порог ¾ запрещён, если пакет периферии ровно заполняет FIFO (4 слова) | там же |
| пакет не должен пересекать границу 1 КБ адресов | требование протокола AHB: минимальный участок одного ведомого — 1 КБ |
| обращения внутри пакета выровнены по своей ширине | там же |
HAL проверяет первое правило сам: HAL_DMA_Init с несовместимой парой
порог–пакет возвращает ошибку HAL_DMA_ERROR_PARAM, не трогая железо.
Границу 1 КБ никто не проверяет — она на совести того, кто выбирает
адрес буфера.
Арбитр: кто пройдёт первым
У каждого потока четыре уровня приоритета в PL (DMA_PRIORITY_LOW …
VERY_HIGH в HAL). Если у двух потоков уровень одинаковый, побеждает
поток с меньшим номером: поток 2 пройдёт раньше потока 4. Отсюда
практика: самому требовательному источнику — и высокий уровень, и
младший номер потока, если выбор каналов это позволяет.
9.7 🔧 ШИМ из таблицы: светодиод дышит без процессора
DMA пишет не только в регистры данных интерфейсов, а в любой регистр
периферии — например, в CCR1 таймера. Так скважность ШИМ берётся из таблицы:
светодиод плавно разгорается и гаснет, а процессор после настройки спит.
Таймеров два. Первый выдаёт ШИМ 1 кГц, второй задаёт темп: 50 раз в секунду
шлёт запрос DMA, и DMA по кругу переносит очередное значение из таблицы
в CCR1 первого. 100 значений при таком темпе — вдох и выдох за 2 с.
| F103 | F407 | |
|---|---|---|
| ШИМ | TIM3, канал 1: PA6 | TIM4, канал 1: PD12 — зелёный светодиод Discovery |
| темп | TIM4 | TIM3 |
| запрос | TIM4_UP — канал 7 DMA1 | TIM3_UP — поток 2, канал 5 DMA1 |
Таблица — round(1000 · pow((1 − cos(2π·i / 100)) / 2, 2.2)): плавный вдох
по косинусу, возведённый в степень 2,2 по гамме (57.3), чтобы глаз видел его
равномерным.
Пик 1000 = ARR + 1 — полная яркость на 50-м значении. 11 значений на стыке
выдоха и вдоха — нули: 0,22 с темноты между вдохами.
static void dma_init(void)
{
#if defined(STM32F10X_MD)
    DMA1_Channel7->CCR   = 0;                                  /* настраивать выключенным */
    DMA1_Channel7->CPAR  = (uint32_t)&PWM->CCR1;               /* куда: регистр другого таймера */
    DMA1_Channel7->CMAR  = (uint32_t)breath;
    DMA1_Channel7->CNDTR = STEPS;
    DMA1_Channel7->CCR   = DMA_CCR7_DIR | DMA_CCR7_MINC | DMA_CCR7_CIRC   /* из памяти, по кругу */
                         | DMA_CCR7_PSIZE_0 | DMA_CCR7_MSIZE_0            /* по 16 бит */
                         | DMA_CCR7_EN;
#elif defined(STM32F407xx)
    DMA1_Stream2->CR &= ~DMA_SxCR_EN;
    while (DMA1_Stream2->CR & DMA_SxCR_EN) { }
    DMA1->LIFCR = DMA_LIFCR_CTCIF2 | DMA_LIFCR_CHTIF2 | DMA_LIFCR_CTEIF2
                | DMA_LIFCR_CDMEIF2 | DMA_LIFCR_CFEIF2;
    DMA1_Stream2->PAR  = (uint32_t)&PWM->CCR1;
    DMA1_Stream2->M0AR = (uint32_t)breath;
    DMA1_Stream2->NDTR = STEPS;
    DMA1_Stream2->CR   = (5u << DMA_SxCR_CHSEL_Pos)            /* канал 5 = TIM3_UP */
                       | DMA_SxCR_DIR_0 | DMA_SxCR_MINC | DMA_SxCR_CIRC
                       | DMA_SxCR_PSIZE_0 | DMA_SxCR_MSIZE_0
                       | DMA_SxCR_EN;
#endif
}

void breath_init(void)
{
    clocks_and_pins();
    dma_init();

    /* ШИМ 1 кГц: новое CCR1 вступает в силу с началом периода */
    PWM->PSC   = PWM_PSC;
    PWM->ARR   = 999u;
    PWM->CCMR1 = TIM_CCMR1_OC1M_2 | TIM_CCMR1_OC1M_1 | TIM_CCMR1_OC1PE;   /* ШИМ 1, предзагрузка */
    PWM->CCER  = TIM_CCER_CC1E;
    PWM->CR1   = TIM_CR1_ARPE;
    PWM->EGR   = TIM_EGR_UG;
    PWM->CR1  |= TIM_CR1_CEN;

    /* темп: 50 раз в секунду запрос DMA, прерывания нет */
    PACE->PSC  = PACE_PSC;                  /* тик 0,1 мс */
    PACE->ARR  = 199u;                      /* 200 тиков — 20 мс */
    PACE->DIER = TIM_DIER_UDE;
    PACE->CR1  = TIM_CR1_CEN;
}

int main(void)
{
    breath_init();
    for (;;)
        __WFI();                            /* спит: таймеры и DMA работают и в Sleep */
}
Почему яркость не дёргается. Благодаря предзагрузке OC1PE DMA пишет
в теневой регистр, а ШИМ подхватывает новое значение с началом следующего
периода — укороченных импульсов не бывает (13.4).
Дышит и во сне. В Sleep ядро стоит, а таймеры и DMA работают (10.2),
поэтому весь главный цикл — один __WFI(). В Stop — нет: там остановлены такты.
А если прерыванием? Тот же перенос в обработчике — 18 команд после
armclang с -O2. Вход в прерывание и выход из него стоят по 12 тактов
у Cortex-M3 и M4; считая с запасом по два такта на команду, получаем
24 + 2 × 18 = 60 тактов. При 50 обновлениях в секунду это ничто, и даже при
10 000 обновлений в секунду на 48 МГц — 10 000 × 60 / 48 000 000 = 1,25 %
процессора. Выигрыш DMA здесь не в процентах: обновление не ждёт других
прерываний — ни задержек, ни дрожания — и идёт, пока ядро спит.
Один таймер вместо двух. У TIM1 и TIM8 есть счётчик повторений RCR:
событие обновления приходит раз в RCR + 1 периодов. При RCR = 19 ШИМ 1 кГц
сам запрашивает DMA 1000 / 20 = 50 раз в секунду. Только не забудьте MOE (13.5).
9.8 F0 и G0: каналы как у F1, у G0 — DMAMUX
DMA у F0 и G0 устроен как у F1, а не как у F4: пять или семь каналов (пять —
у F030, F031, G030, G031; семь — у F072, F091, G071), у каждого
CCR, CNDTR, CPAR, CMAR, общие ISR и IFCR. Ни потоков, ни FIFO
нет. Рецепт 9.5 переносится почти дословно, но три мелочи в именах ловят
при переносе — и одна крупная у G0.
Мелочи. Бит тактирования у F0 зовётся DMAEN; имя DMA1EN в заголовке
оставлено как устаревший псевдоним, и в новом коде его лучше не смешивать
с основным. Биты
CCR — без номера канала: DMA_CCR_DIR, DMA_CCR_MINC, DMA_CCR_TCIE;
код с DMA_CCR4_DIR из рецепта для F1 не собирается — use of undeclared
identifier 'DMA_CCR4_DIR'. И регистр данных USART — TDR, а не DR
(раздел 16.9). Прерывания сгруппированы: у F0 и G0 канал 1 — своё,
каналы 2 и 3 — одно на двоих (DMA1_Channel2_3_IRQn), каналы 4–7 — одно
на четверых; у G0 к последнему добавлено переполнение DMAMUX
(DMA1_Ch4_7_DMAMUX1_OVR_IRQn). В обработчике сначала смотрят ISR,
чей это канал:
void DMA1_Channel2_3_IRQHandler(void)
{
    if (DMA1->ISR & DMA_ISR_TCIF2) {
        DMA1->IFCR = DMA_IFCR_CTCIF2;
    }
}
Привязка запросов у F0 — жёсткая, как у F1, только таблица другая:
USART1_TX — канал 2, USART1_RX — канал 3; бит USART1TX_DMA_RMP
в SYSCFG->CFGR1 переносит передачу на канал 4, USART1RX_DMA_RMP —
приём на канал 5. Настройка канала — как в 9.5:
    RCC->AHBENR |= RCC_AHBENR_DMAEN;            /* у F0 бит зовётся DMAEN; DMA1EN — устаревший псевдоним */
    DMA1_Channel2->CCR &= ~DMA_CCR_EN;          /* настраивать только выключенным */
    DMA1_Channel2->CPAR = (uint32_t)&USART1->TDR;   /* у нового USART — TDR, не DR */
    DMA1_Channel2->CMAR = (uint32_t)tx_buf;
    DMA1_Channel2->CNDTR = 0;
    DMA1_Channel2->CCR = DMA_CCR_DIR            /* имена битов без номера канала: DMA_CCR_DIR, не DMA_CCR4_DIR */
                       | DMA_CCR_MINC
                       | DMA_CCR_TCIE
                       | DMA_CCR_PL_1;
У G0 привязки нет вовсе — есть DMAMUX. Любой запрос можно подвести
к любому каналу: у каждого канала DMA есть свой канал мультиплексора с
одним регистром CCR, куда пишут номер запроса. Номера — в заголовке LL
stm32g0xx_ll_dmamux.h: USART1_TX — 51, USART2_TX — 53, ADC1 — 5,
память-память — 0. Нумерация со сдвигом: канал 1 DMA — это канал 0 DMAMUX.
Без записи в DMAMUX канал настроен верно, включён — и молчит: запрос
до него не доходит. Это самая частая ошибка при переносе с F0 и F1:
    /* канал 1 DMA1 — это канал 0 DMAMUX: нумерация со сдвигом на единицу */
    DMAMUX1_Channel0->CCR = LL_DMAMUX_REQ_USART2_TX;    /* без этой строки канал молчит */
    DMA1_Channel1->CCR &= ~DMA_CCR_EN;
    DMA1_Channel1->CPAR = (uint32_t)&USART2->TDR;
Дальше всё как у F0: CMAR, CNDTR, CCR, DMAT в USART. Зато у G0
нет и таблицы привязок с её конфликтами «два нужных запроса на одном
канале» — любой периферии достаётся любой свободный канал.
9.9 Грабли
Настройка при включённом канале. Запись в регистры адресов и счётчика
при взведённом EN игнорируется. У F4 мало сбросить бит — надо дождаться,
пока железо это подтвердит.
Несброшенные флаги. У F4 новая передача может не начаться, если остались флаги предыдущей. Сбрасывайте их перед стартом, а не после.
Забытое разрешение со стороны периферии. Сам DMA настроен верно, но
USART_CR3_DMAT, ADC_CR2_DMA или SPI_CR2_TXDMAEN не включены — запросов
просто нет, и передача не идёт. Диагностики никакой.
Через HAL: обмен «завис» в BUSY. HAL_UART_Transmit_DMA вернул
HAL_OK, данные ушли, а следующий вызов отвечает HAL_BUSY. В HAL
состояние возвращается в READY не по концу DMA, а по прерыванию TC
самого USART: обработчик DMA лишь снимает DMAT и взводит TCIE. Нужны
оба прерывания в NVIC — потока DMA и USART; отсутствие любого из них
оставляет gState = BUSY_TX навсегда. Приём в режиме Normal после
RxCpltCallback не перезапускается сам: HAL снимает DMAR и ждёт нового
HAL_UART_Receive_DMA; продолжение без вызова даёт только Circular.
Через HAL: буферное прерывание I²C при DMA. В режиме DMA HAL включает
только ITEVTEN и ITERREN; ITBUFEN он оставляет прерываниям без DMA.
Взведённый вручную ITBUFEN заставит обработчик событий разбирать байты,
которые уже переносит DMA.
Буфер в CCM. У старших F4 есть 64 КБ быстрой памяти, подключённой прямо
к ядру. Она недоступна контроллеру DMA: буфер, размещённый там, не будет
передан — поток сразу выключится с флагом ошибки TEIFx. Если этот флаг не
смотреть, будет тишина. Держите буферы DMA в обычной SRAM.
Локальный буфер. Массив, объявленный внутри функции, живёт на стеке и исчезает при выходе. DMA продолжит писать по его адресу уже после того, как там появятся другие данные. Буферы под DMA делайте статическими или глобальными.
Отсутствие volatile. Данные, которые приносит DMA, меняются помимо
кода — как и в случае прерываний. Без volatile компилятор вправе
закэшировать значение (разбор с ассемблером — раздел 3).
Кэш данных у F7 и H7. У Cortex-M7 ядро работает с памятью через кэш,
а DMA — прямо с ОЗУ, и volatile тут не спасает: ядро читает из кэша
старую копию принятого буфера, а записанное ядром может не дойти до ОЗУ к
началу передачи. Перед передачей буфер выталкивают в ОЗУ
(SCB_CleanDCache_by_Addr), после приёма выбрасывают из кэша
(SCB_InvalidateDCache_by_Addr), сам буфер выравнивают и делают кратным
32 байтам — строке кэша; или кладут буферы в область, которую MPU помечает
некэшируемой (раздел 124.6).
Конфликт каналов на F1. Два блока периферии, привязанных к одному каналу, одновременно работать не будут. Проверять по таблице привязок заранее, а не после того, как «SPI сломал АЦП».
Выравнивание. Если элемент 16- или 32-битный, адреса буферов должны быть
выровнены соответственно. Массив uint8_t, приведённый к uint16_t*,
может дать ошибку передачи.
DMA в таймер молчит. Запрос по обновлению разрешается битом UDE
в DIER таймера темпа. Без него канал DMA настроен верно, а переносов нет —
как с DMAT у UART.
Размер элемента не совпал с таблицей. Таблица uint16_t при MSIZE
в 32 бита читается словами: DMA берёт каждое второе значение и вылезает
за конец таблицы. MSIZE — по размеру элемента в памяти, PSIZE — по регистру.
9.10 Итоги
- DMA освобождает ядро: прерывание приходит один раз на весь буфер, а не на каждый байт.
- У F1 каналы с жёсткой привязкой периферии, у F4 — потоки с выбором канала, FIFO, пакетной и двойной буферизацией. Код между платформами не переносится.
- Настройка — это адрес периферии, адрес памяти, количество, направление,
размеры и инкременты.
MINCвключён,PINCобычно нет. - Счётчик 16-битный: максимум 65535 элементов за настройку.
- Циклический режим плюс прерывания по половине и по концу буфера дают непрерывный поток без потери данных.
- Настраивать только при выключенном канале; у F4 дождаться подтверждения
сброса
ENи очистить флаги предыдущей передачи. - Не забыть разрешить запросы со стороны периферии (
DMAT,DMA,TXDMAEN). - Буферы — статические, в обычной SRAM (не в CCM), выровненные,
volatile; у F7 и H7 — ещё и работа с кэшем: очистить перед передачей, сбросить после приёма. - DMA пишет в любой регистр периферии: таблица →
CCRтаймера по запросу другого таймера (UDE) даёт ШИМ из таблицы без процессора, в том числе во сне.
Полные исходники
dma_f0.c — DMA на STM32F072: USART1_TX на канале 2.
/* Раздел 9.8: DMA на STM32F072 — как у F1: каналы, USART1_TX на канале 2
 * (перенос на канал 4 — бит USART1TX_DMA_RMP в SYSCFG). */
#include <stddef.h>
#include "stm32f0xx.h"

_Static_assert(offsetof(DMA_Channel_TypeDef, CNDTR) == 0x04u && offsetof(DMA_Channel_TypeDef, CMAR) == 0x0Cu,
               "регистры канала — как у F1");
_Static_assert(offsetof(DMA_TypeDef, IFCR) == 0x04u, "ISR и IFCR");

static char tx_buf[64];

void dma_usart1_tx_init_f0(void)
{
    RCC->AHBENR |= RCC_AHBENR_DMAEN;            /* у F0 бит зовётся DMAEN; DMA1EN — устаревший псевдоним */
    DMA1_Channel2->CCR &= ~DMA_CCR_EN;          /* настраивать только выключенным */
    DMA1_Channel2->CPAR = (uint32_t)&USART1->TDR;   /* у нового USART — TDR, не DR */
    DMA1_Channel2->CMAR = (uint32_t)tx_buf;
    DMA1_Channel2->CNDTR = 0;
    DMA1_Channel2->CCR = DMA_CCR_DIR            /* имена битов без номера канала: DMA_CCR_DIR, не DMA_CCR4_DIR */
                       | DMA_CCR_MINC
                       | DMA_CCR_TCIE
                       | DMA_CCR_PL_1;
    NVIC_SetPriority(DMA1_Channel2_3_IRQn, 2);  /* у F0 одно прерывание на каналы 2 и 3 */
    NVIC_EnableIRQ(DMA1_Channel2_3_IRQn);
    USART1->CR3 |= USART_CR3_DMAT;
}

void dma_usart1_send_f0(const char *data, uint16_t len)
{
    for (uint16_t i = 0; i < len && i < sizeof tx_buf; i++)
        tx_buf[i] = data[i];
    DMA1_Channel2->CCR &= ~DMA_CCR_EN;
    DMA1_Channel2->CNDTR = len;
    DMA1_Channel2->CCR |= DMA_CCR_EN;
}

void DMA1_Channel2_3_IRQHandler(void)
{
    if (DMA1->ISR & DMA_ISR_TCIF2) {
        DMA1->IFCR = DMA_IFCR_CTCIF2;
    }
}
dma_g0.c — DMA на STM32G071: запрос USART2_TX через DMAMUX.
/* Раздел 9.8: DMA на STM32G071 — те же каналы, но запрос к каналу подводит DMAMUX:
 * USART2_TX на канале 1 DMA1 через DMAMUX1_Channel0. */
#include <stddef.h>
#include "stm32g0xx.h"
#include "stm32g0xx_ll_dmamux.h"

_Static_assert(offsetof(DMA_Channel_TypeDef, CMAR) == 0x0Cu, "регистры канала — как у F0 и F1");
_Static_assert(LL_DMAMUX_REQ_USART2_TX == 53u && LL_DMAMUX_REQ_USART1_TX == 51u && LL_DMAMUX_REQ_ADC1 == 5u,
               "номера запросов DMAMUX из LL");
_Static_assert(offsetof(DMAMUX_Channel_TypeDef, CCR) == 0u, "у канала DMAMUX один регистр CCR");

static char tx_buf[64];

void dma_usart2_tx_init_g0(void)
{
    RCC->AHBENR |= RCC_AHBENR_DMA1EN;
    /* канал 1 DMA1 — это канал 0 DMAMUX: нумерация со сдвигом на единицу */
    DMAMUX1_Channel0->CCR = LL_DMAMUX_REQ_USART2_TX;    /* без этой строки канал молчит */
    DMA1_Channel1->CCR &= ~DMA_CCR_EN;
    DMA1_Channel1->CPAR = (uint32_t)&USART2->TDR;
    DMA1_Channel1->CMAR = (uint32_t)tx_buf;
    DMA1_Channel1->CNDTR = 0;
    DMA1_Channel1->CCR = DMA_CCR_DIR | DMA_CCR_MINC | DMA_CCR_TCIE | DMA_CCR_PL_1;
    NVIC_SetPriority(DMA1_Channel1_IRQn, 2);
    NVIC_EnableIRQ(DMA1_Channel1_IRQn);
    USART2->CR3 |= USART_CR3_DMAT;
}

void dma_usart2_send_g0(const char *data, uint16_t len)
{
    for (uint16_t i = 0; i < len && i < sizeof tx_buf; i++)
        tx_buf[i] = data[i];
    DMA1_Channel1->CCR &= ~DMA_CCR_EN;
    DMA1_Channel1->CNDTR = len;
    DMA1_Channel1->CCR |= DMA_CCR_EN;
}

void DMA1_Channel1_IRQHandler(void)
{
    if (DMA1->ISR & DMA_ISR_TCIF1) {
        DMA1->IFCR = DMA_IFCR_CTCIF1;
    }
}
Дальше: раздел 9а «GPDMA на STM32U5: связные списки, триггеры и приём в кольцо без прерываний» —
у U5 вместо бита CIRC и таблицы привязок — цепочка описаний пересылок в памяти.