 Embedded HandbookПриложения
11б. Кэш, TCM и домены памяти у F7 и H7
Раздел 11 разбирал память F103 и F407: одна Flash, одно-два ОЗУ, и всё, что лежит по адресу, видят и ядро, и DMA. У Cortex-M7 в F7 и H7 между ядром и памятью появились кэши, рядом с ядром — своя быстрая память TCM, а у H7 ОЗУ ещё и разнесено по трём доменам. Код с F407 переносится и работает — до первого буфера DMA, который вдруг принимает старые данные или отправляет нули.
В разделах 9 и 124 это сказано в двух абзацах: «чистить кэш перед передачей, сбрасывать после приёма». Здесь — почему, где буферу можно лежать, а где нет, и какая ловушка остаётся, даже когда кэш обслуживают по правилам.
Опоры: справочные руководства RM0385 (F74x/F75x) и RM0433 (H742/H743/H750), даташиты F746 и H743, руководство по ядру Cortex-M7 (DUI 0646B). Поведение кэша с DMA прогнано на модели на ПК — QEMU кэшей не моделирует; листинги собраны armclang для F746 и H743.
Как это называется в документации
Оригинал Перевод L1 cache: I-cache, D-cache кэш первого уровня: команд и данных cache line строка кэша write-back, write-allocate обратная запись, размещение при записи clean очистить: записать грязную строку в память invalidate сбросить: забыть строку, не записывая cache coherency согласованность кэша и памяти tightly coupled memory (ITCM, DTCM) память, связанная с ядром: для команд, для данных AHB slave bus (AHBS) ведомая шина ядра: вход для DMA в DTCM bus matrix матрица шин domain (D1, D2, D3) домен: часть кристалла со своими шинами и питанием
11б.1 Зачем кэш и где он стоит
Ядро F746 работает на 216 МГц, H743 — на 480 МГц. Flash на такой частоте не успевает, и даже ОЗУ за матрицей шин отвечает не за такт. Поэтому у Cortex-M7 есть кэш первого уровня — раздельный для команд и данных:
| F746 | H743 | |
|---|---|---|
| кэш команд | 4 КБ | 16 КБ |
| кэш данных | 4 КБ | 16 КБ |
| строка | 32 байта (8 слов) | 32 байта (8 слов) |
Строка — единица обмена кэша с памятью: промах по одному байту приносит из памяти всю строку в 32 байта, в которую он входит (строки выровнены по своей длине), а запись меняет байт только в кэше. Атрибут ОЗУ по умолчанию у обеих серий — обратная запись с размещением при записи (таблица 7 RM0433): записанное ядром остаётся в кэше «грязным» и уходит в память, когда строку вытеснят или когда её явно очистят.
После сброса оба кэша выключены. Включает их программа: в проекте, который
создал CubeMX (пример Blinky для H743I-EVAL в паке Keil), main вызывает
SCB_EnableICache() и SCB_EnableDCache() до всякой периферии. С этого момента
у ядра и у памяти может быть разное мнение об одном и том же байте.
11б.2 Карта памяти: TCM и домены
Кроме кэша, у M7 есть память, подключённая прямо к ядру, — TCM. Она работает на частоте ядра без тактов ожидания, и кэш ей не нужен: TCM не кэшируется.
F746 (раздел 2.3 RM0385):
| Память | Адрес | Размер | Кто видит |
|---|---|---|---|
| ITCM | 0x0000 0000 |
16 КБ | только ядро |
| DTCM | 0x2000 0000 |
64 КБ | ядро и все DMA — через ведомую шину ядра AHBS |
| SRAM1 | 0x2001 0000 |
240 КБ | все ведущие матрицы |
| SRAM2 | 0x2004 C000 |
16 КБ | все ведущие матрицы |
У F746 DMA пишет в DTCM, а в ITCM — нет: «передача DMA в ITCM не поддерживается».
H743 — три домена со своими матрицами шин: D1 (ядро, AXI SRAM, Flash), D2 (DMA1, DMA2, Ethernet, USB, SRAM1–3) и D3 (BDMA, SRAM4, резервное ОЗУ). Карта — таблица 7 RM0433, доступ — таблица 3:
| Память | Адрес | Размер |
|---|---|---|
| ITCM | 0x0000 0000 |
64 КБ |
| DTCM | 0x2000 0000 |
128 КБ |
| AXI SRAM (D1) | 0x2400 0000 |
512 КБ |
| SRAM1, SRAM2, SRAM3 (D2) | 0x3000 0000, 0x3002 0000, 0x3004 0000 |
128 + 128 + 32 КБ |
| SRAM4 (D3) | 0x3800 0000 |
64 КБ |
| резервное ОЗУ | 0x3880 0000 |
4 КБ |
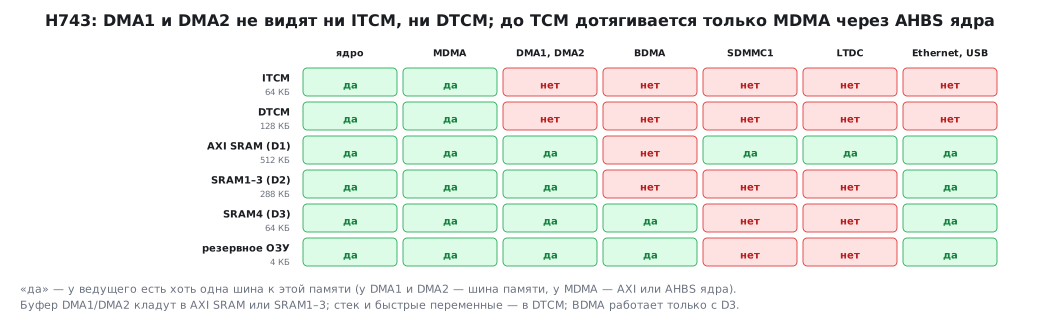
Главное отличие от F7: у H743 DMA1 и DMA2 не видят DTCM. А DTCM —
то место, куда данные попадают по умолчанию: в шаблонах скриптов компоновщика
из пака (GCC для H745/H747, пример Keil для H743I-EVAL) переменные, куча
и стек лежат с адреса 0x2000 0000. Глобальный буфер, объявленный как
на F407, окажется в DTCM, и DMA получит на нём ошибку шины — флаг ошибки
передачи вместо данных. Буферы DMA1/DMA2
кладут в AXI SRAM или SRAM1–3, буферы BDMA — только в SRAM4, а в TCM
данные носит только MDMA.
11б.3 Кэш и DMA: два направления
DMA работает с памятью мимо кэша ядра. Отсюда две беды — по одной на направление. Модель на ПК: кэш со строками по 32 байта и обратной записью, буфер 64 байта, DMA читает и пишет ОЗУ напрямую.
| Опыт | Неверных байт у получателя |
|---|---|
| передача: ядро заполнило буфер, DMA забрал его без очистки | 64 из 64 |
передача с SCB_CleanDCache_by_Addr перед запуском |
0 |
| приём: ядро раньше читало буфер, DMA положил новое, сброса нет | 64 из 64 |
приём с SCB_InvalidateDCache_by_Addr после приёма |
0 |
При передаче новое лежит в кэше, а DMA берёт из ОЗУ старое. При приёме новое лежит в ОЗУ, а ядро читает из кэша строки, которые оно прочитало раньше. Операции CMSIS исправляют это: очистить перед передачей (выписать грязные строки в память), сбросить после приёма (забыть строки, чтобы следующее чтение пришло из памяти):
#define BUF_LEN  64u                    /* кратно 32: буфер занимает строки целиком */

static uint8_t tx_buf[BUF_LEN] __attribute__((aligned(32)));
static uint8_t rx_buf[BUF_LEN] __attribute__((aligned(32)));

void tx_start(DMA_Stream_TypeDef *s, uint32_t n)
{
    SCB_CleanDCache_by_Addr(tx_buf, (int32_t)n);   /* вытолкнуть в ОЗУ то, что записало ядро */
    s->M0AR = (uint32_t)tx_buf;
    s->NDTR = n;
    s->CR |= DMA_SxCR_EN;
}

void rx_done(uint32_t n)
{
    SCB_InvalidateDCache_by_Addr(rx_buf, (int32_t)((n + 31u) & ~31u));   /* забыть старые строки */
}
volatile здесь ничего не решает: он запрещает компилятору держать
значение в регистре, но чтение всё равно идёт через кэш (раздел 124).
11б.4 Ловушка: буфер делит строку с соседом
Операции кэша работают целыми строками: SCB_InvalidateDCache_by_Addr
в CMSIS округляет диапазон до границ строк, которые он задевает. Если буфер
приёма начинается не с границы 32 байт, первая строка у него общая с чем-то
ещё — например, со счётчиком, который ядро меняет, пока DMA принимает.
Модель: строка 0x300…0x31F, в первых 16 байтах — счётчик, с 0x310
начинается буфер на 64 байта. За время приёма ядро 1000 раз увеличило
счётчик (строка грязная, в памяти он всё ещё 0), затем DMA закончил.
| После приёма | Счётчик | Неверных байт в буфере |
|---|---|---|
| сбросить диапазон буфера | 0 из 1000 | 0 |
| очистить и сбросить диапазон буфера | 1000 | 16 |
| буфер выровнен по 32 и кратен 32, сбросить | 1000 | 0 |
Сброс выбросил из кэша и грязный счётчик — тысяча прибавлений пропала.
Очистка перед сбросом спасла счётчик, но записала в память всю строку —
вместе с устаревшим началом буфера поверх того, что только что положил DMA.
Правильного порядка операций здесь нет: буфер DMA должен занимать строки
целиком — начало выровнено по 32 байтам (aligned(32)), длина кратна 32.
Тогда ни одной общей строки с соседями у него нет, и простой сброс
безопасен.
11б.5 Второй путь: некэшируемая область MPU
Вместо обслуживания кэша буферы можно положить туда, где кэша нет вовсе: в TCM (если DMA туда достаёт — у F7 да, у H7 только MDMA) или в область, которую MPU (раздел 11а) помечает как обычную некэшируемую память:
/* Второй путь: область 32 КБ, которую кэш не трогает вовсе (TEX = 1, C = 0, B = 0) */
void mpu_dma_region(uint32_t base)
{
    ARM_MPU_Disable();
    ARM_MPU_SetRegion(ARM_MPU_RBAR(0u, base),
                      ARM_MPU_RASR(1u, ARM_MPU_AP_FULL, 1u, 0u, 0u, 0u, 0x00u, ARM_MPU_REGION_SIZE_32KB));
    ARM_MPU_Enable(MPU_CTRL_PRIVDEFENA_Msk);
}
В модели такая область даёт ноль неверных байт в обе стороны без единой
операции с кэшем. Цена — скорость: ядро обращается к этим буферам
на полной задержке ОЗУ. Буферы DMA собирают в одну секцию скрипта
компоновщика (.dma_buffers в начале SRAM1 у H743), чтобы область MPU
накрыла их все и ничего лишнего; база области кратна её размеру.
| Путь | Что делать | Цена |
|---|---|---|
| обслуживание кэша | очистить перед передачей, сбросить после приёма; выравнивание 32 | легко забыть одну операцию |
| некэшируемая область | одна настройка MPU при старте | медленный доступ ядра к буферам |
| TCM | ничего | у H7 недоступно DMA1/DMA2; у F7 — только DTCM |
11б.6 Что положить в TCM
TCM — самая быстрая память ядра, и её мало. Разумное деление:
- ITCM — код, которому важна задержка: обработчики прерываний,
внутренний цикл фильтра, функции, которые работают, пока стирается Flash.
Такие функции помечают секцией
.itcm_text(илиRAMFUNCв примерах ST) и копируют в ITCM из Flash при старте — как.dataв разделе 11. - DTCM — стек, куча, горячие переменные. У F7 — и буферы DMA, у H7 — нет.
- Буферы периферии — в обычное ОЗУ того домена, где стоит их DMA: DMA1/DMA2 — AXI SRAM или SRAM1–3, BDMA — SRAM4, Ethernet и USB — SRAM1–3.
11б.7 Грабли
- Буфер DMA в DTCM на H7. DMA1 и DMA2 туда не достают; передача кончается флагом ошибки. На F7 тот же код работает — перенос ломается молча.
- Очистка без выравнивания. Буфер делит строку с соседней переменной: сброс теряет изменения соседа, очистка портит начало принятого. Выровнять по 32 байтам и сделать длину кратной 32.
- Сброс до приёма вместо после. Ядро может успеть прочитать буфер и снова занести строки в кэш, пока DMA работает, — и не только по вашей команде: ядро читает кэшируемую память на опережение само. Сбрасывают после окончания приёма (или и до, и после).
volatileвместо обслуживания кэша. Компилятор перестаёт кэшировать значение в регистре, но аппаратный кэш остаётся.- Кэш включили, а буферы остались от F407. Весь код DMA, который работал на F4, надо пройти заново: каждый буфер — выравнивание, очистка или сброс, или некэшируемая область.
- Область MPU не по размеру. База области MPU кратна её размеру; область 32 КБ с базой не на границе 32 КБ не накроет то, что ожидалось.
- BDMA и SRAM1. BDMA работает только в домене D3: SRAM4 и резервное ОЗУ.
11б.8 Итоги
- У M7 кэш команд и данных по 4 КБ у F746 и по 16 КБ у H743, строка — 32 байта; ОЗУ по умолчанию — обратная запись с размещением при записи.
- F746: ITCM 16 КБ — только ядро, DTCM 64 КБ — ядро и DMA через AHBS, SRAM1 240 КБ и SRAM2 16 КБ — все.
- H743: ITCM 64 КБ и DTCM 128 КБ — ядро и MDMA; DMA1/DMA2 — AXI SRAM и SRAM1–3; BDMA — только SRAM4 и резервное ОЗУ.
- Передача без очистки и приём без сброса — 64 неверных байта из 64 в модели; с операциями CMSIS — ноль.
- Невыровненный буфер ломает соседа: сброс теряет 1000 прибавлений счётчика из 1000, очистка со сбросом портит 16 байт принятого. Выравнивание по 32 и длина, кратная 32, снимают проблему.
- Некэшируемая область MPU обходится без обслуживания кэша, но медленнее для ядра.
Полные исходники
cache11b.c — буферы DMA на Cortex-M7: выравнивание, обслуживание кэша, некэшируемая область MPU.
/* 11б: буферы DMA на Cortex-M7 — выравнивание, обслуживание кэша, некэшируемая область MPU.
   Собирается armclang для STM32F746 и STM32H743 (проверка _verify/cache11b_check.py). */
#include <stdint.h>

#define BUF_LEN  64u                    /* кратно 32: буфер занимает строки целиком */

static uint8_t tx_buf[BUF_LEN] __attribute__((aligned(32)));
static uint8_t rx_buf[BUF_LEN] __attribute__((aligned(32)));

void cache_on(void)
{
    SCB_EnableICache();
    SCB_EnableDCache();                 /* после сброса оба кэша выключены */
}

void tx_start(DMA_Stream_TypeDef *s, uint32_t n)
{
    SCB_CleanDCache_by_Addr(tx_buf, (int32_t)n);   /* вытолкнуть в ОЗУ то, что записало ядро */
    s->M0AR = (uint32_t)tx_buf;
    s->NDTR = n;
    s->CR |= DMA_SxCR_EN;
}

void rx_done(uint32_t n)
{
    SCB_InvalidateDCache_by_Addr(rx_buf, (int32_t)((n + 31u) & ~31u));   /* забыть старые строки */
}

uint8_t rx_byte(uint32_t i) { return rx_buf[i]; }
uint8_t *tx_area(void) { return tx_buf; }

/* Второй путь: область 32 КБ, которую кэш не трогает вовсе (TEX = 1, C = 0, B = 0) */
void mpu_dma_region(uint32_t base)
{
    ARM_MPU_Disable();
    ARM_MPU_SetRegion(ARM_MPU_RBAR(0u, base),
                      ARM_MPU_RASR(1u, ARM_MPU_AP_FULL, 1u, 0u, 0u, 0u, 0x00u, ARM_MPU_REGION_SIZE_32KB));
    ARM_MPU_Enable(MPU_CTRL_PRIVDEFENA_Msk);
}
Дальше: раздел 11в «Защита чтения на F1: почему уровень 1 не спасает прошивку» — что обещает RDP уровня 1 и почему это не сейф.