 Embedded HandbookПриложения
32. Буферы потоков и сообщений
Очередь хранит элементы одного фиксированного размера — и это её сила, пока данные укладываются в такие элементы. Байты с UART не укладываются: они идут потоком без границ. Кадры протокола тоже не укладываются: длина у них разная. Для обоих случаев ядро даёт отдельные буферы — и они устроены проще очереди, потому что от неё осталась половина возможностей.
Как это называется в документации
Оригинал Перевод stream buffer потоковый буфер message buffer буфер сообщений trigger level уровень триггера, порог пробуждения single writer / single reader один писатель / один читатель bytes available сколько лежит spaces available сколько влезет discrete message отдельное сообщение с границами completed callback обратный вызов по завершении inter-core между ядрами процессора
32.1 Потоковый буфер
Кольцевой буфер байтов с ожиданием. Писатель кладёт сколько угодно байт, читатель забирает сколько нужно; границы записей не сохраняются.
static StreamBufferHandle_t sb_rx;

/* в main, до vTaskStartScheduler */
sb_rx = xStreamBufferCreate(128, 16);      /* размер, уровень триггера */
configASSERT(sb_rx != NULL);
| Очередь | Потоковый буфер | |
|---|---|---|
| единица | элемент фиксированного размера | байт |
| границы записей | сохраняются | нет |
| заголовок | 80 байт | 36 |
| писателей / читателей | сколько угодно | по одному |
| ждать можно | место / элемент | место / N байт |
Заголовок вдвое меньше очереди, а байты лежат плотно — без округления каждого элемента до слова.
⚠️ Один байт хранилища всегда пустой — так кольцевой буфер с двумя индексами отличает «полон» от «пуст». Динамическое создание добавляет этот байт само: в
xStreamBufferCreate(128, …)помещается ровно 128 байт. Статическое берёт массив как есть:xStreamBufferCreateStatic(128, …)с массивом на 128 вмещает 127. Чтобы поместилосьNбайт, массив объявляют наN + 1и передают размерN + 1.
Запись и чтение
/* прерывание: байт пришёл */
xStreamBufferSendFromISR(sb_rx, &byte, 1, &woken);
portYIELD_FROM_ISR(woken);

/* задача: забрать порцию */
n = xStreamBufferReceive(sb_rx, chunk, sizeof(chunk), pdMS_TO_TICKS(50));
Обе функции возвращают число байт, а не признак успеха. Запись вернёт меньше запрошенного, если места не хватило; чтение — сколько смогла забрать, вплоть до нуля по истечении времени.
⚠️ Из прерывания байт может потеряться молча.
SendFromISRждать не умеет; вернула ноль — буфер полон, байт пропал. Возвращаемое значение из обработчика обычно не проверяют, и это единственное место, где потеря данных не оставляет следа. Считайте отказы.
32.2 Уровень триггера
Второй аргумент создания — то, ради чего потоковый буфер стоит предпочесть очереди для приёма с UART.
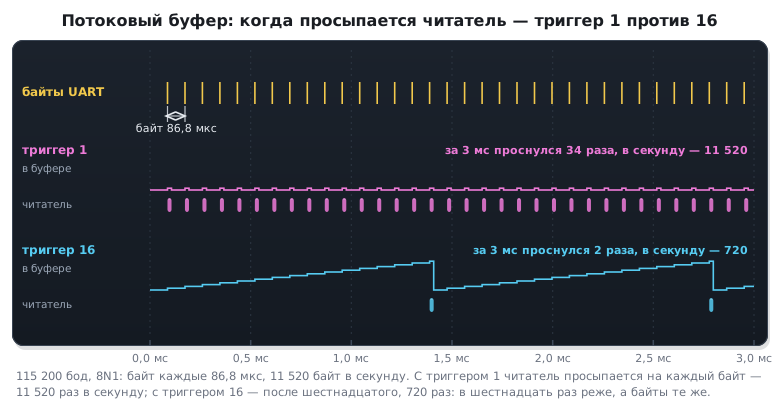
Читатель просыпается не по первому байту, а когда накопилось не меньше триггера.
Смысл на числах. При 115 200 бод приходит 11 520 байт в секунду. Очередь будила бы задачу на каждый: 11 520 пробуждений и переключений контекста в секунду. С триггером 16 — 720, в шестнадцать раз реже; процессор занимается разбором, а не пробуждениями.
| Триггер | Пробуждений в секунду при 115 200 бод |
|---|---|
| 1 | 11 520 |
| 16 | 720 |
| 64 | 180 |
Так это выглядит по времени — первые три миллисекунды приёма:
Две тонкости:
Триггер — порог пробуждения, не гарантия порции. Если время ожидания истекло, читатель получит всё, что лежит, — хоть один байт. Данные не застревают в ожидании порога.
Ноль превращается в единицу молча. Хотите «по первому байту» — ставьте 1 явно.
Триггер не должен превышать размер буфера, иначе читатель не проснётся никогда — ядро это ловит проверкой при создании.
32.3 Правило одного
⚠️ Один писатель и один читатель. Буфер не защищён от двух задач, пишущих одновременно, и от двух читающих — ради скорости. Две задачи в один буфер портят его без всякой диагностики.
Это не недостаток, а осознанный обмен: очередь платит за многих писателей критическими секциями на каждой операции, буфер — нет. Отсюда и его назначение: связь двух сторон — прерывание и задача, задача и задача, ядро и ядро.
Нужно много писателей — либо мьютекс перед каждой записью, либо очередь, которая умеет это сама.
32.4 Буфер сообщений
Тот же потоковый буфер, но с границами: каждое сообщение предваряется своей длиной, и читатель получает ровно одно сообщение целиком.
static MessageBufferHandle_t mb;

/* в main, до vTaskStartScheduler */
mb = xMessageBufferCreate(256);
configASSERT(mb != NULL);

/* отправитель: кадр любой длины */
xMessageBufferSend(mb, frame, len, pdMS_TO_TICKS(10));

/* получатель: len — длина именно этого кадра */
len = xMessageBufferReceive(mb, frame, sizeof(frame), portMAX_DELAY);
Триггера нет — сообщение либо лежит целиком, либо нет.
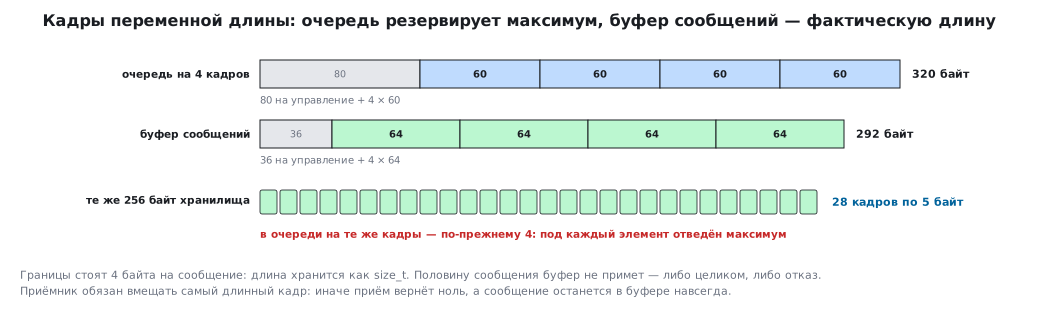
Цена границ — четыре байта на сообщение: длина хранится как size_t.
Отсюда размер хранилища: сумма длин плюс четыре на каждое.
Сравнение с очередью на кадры переменной длины показывает, зачем это нужно:
| Четыре кадра до 60 байт | Байт |
|---|---|
| очередь: 80 + 4 × 60 | 320 |
| буфер сообщений: 36 + 4 × (60 + 4) | 292 |
| в нём же — кадров по 5 байт | 28 вместо четырёх |
Очередь резервирует под каждый кадр максимум. Буфер сообщений хранит кадр по фактической длине: короткие кадры занимают меньше, и в те же 256 байт их влезает всемеро больше.
Целиком или никак
if (xMessageBufferSend(mb, frame, len, 0) == 0) {
    /* места под ВСЁ сообщение нет — не положено ничего */
}
Половину сообщения буфер не примет: либо целиком, либо отказ. Это удобнее очереди, где переполнение режет поток на границе элемента, а не кадра.
⚠️ Приёмный буфер обязан вмещать самое длинное сообщение. Если сообщение длиннее приёмника, функция вернёт ноль, а сообщение останется в буфере — и так при каждом вызове, навсегда. Прибор выглядит как «данные перестали приходить». Приёмник — размером с максимальный кадр, без экономии.
32.5 Наблюдение и сброс
size_t used = xStreamBufferBytesAvailable(sb);     /* сколько лежит  */
size_t free = xStreamBufferSpacesAvailable(sb);    /* сколько влезет */
Растущее used при постоянном free — читатель не успевает, и скоро
SendFromISR начнёт возвращать нули. Те же функции есть у буфера
сообщений с соответствующими именами.
xStreamBufferReset очищает буфер — но только если на нём никто
не ждёт; иначе вернёт отказ. Удаление — vStreamBufferDelete,
и оно тоже недопустимо при ждущих задачах.
Есть и обратные вызовы: ядро может вызывать функцию при каждой записи и при каждом чтении. Нужны они для одного применения — следующего.
32.6 Связь между ядрами
Буферы спроектированы так, что никакие функции ядра не вызываются из обработчика пробуждения, и это делает их пригодным для связи между двумя процессорными ядрами с независимыми копиями FreeRTOS.
Схема: буфер лежит в общей памяти; ядро A пишет, ядро B читает.
Пробуждение читателя на ядре B делается не планировщиком ядра A —
он о задачах B не знает, — а межпроцессорным прерыванием, которое
ядро A взводит в обратном вызове записи, а обработчик на ядре B
вызывает xMessageBufferSendCompletedFromISR (у потокового буфера —
xStreamBufferSendCompletedFromISR): «данные записаны, буди читателя».
Обратный путь — …ReceiveCompletedFromISR — будит писателя, когда
читатель освободил место.
На F103 и F407 ядро одно, и раздел здесь — для понимания, почему
буфер устроен именно так. На двухъядерных семействах (H745/H747, WL5x)
это один из штатных способов обмена; рядом с ним — аппаратные семафоры
HSEM. Общую область у ядра M7 с кэшем данных делают некэшируемой, иначе
второе ядро увидит старое содержимое.
32.7 Что выбрать
| Данные | Средство |
|---|---|
| байты без границ: UART, поток датчика | потоковый буфер |
| кадры переменной длины | буфер сообщений |
| кадры одного размера, много писателей | очередь |
| одно слово | уведомление (раздел 31) |
| много писателей в поток | очередь или буфер под мьютексом |
Практическое правило: приём с UART — потоковый буфер с триггером, разбор кадров из него — в задаче; результат разбора, если он нужен дальше, — в буфер сообщений или очередь.
32.8 Грабли
Байты с UART теряются под нагрузкой. Буфер полон, SendFromISR
возвращает ноль. Увеличить буфер или поднять приоритет читателя.
Задача просыпается на каждый байт. Триггер 1 или 0. Поставить разумный порог.
Задача не просыпается вовсе. Триггер больше размера буфера — ядро должно было поймать при создании; либо ждать некому — писатель другой и данные идут в другой буфер.
Данные портятся. Два писателя или два читателя на одном буфере.
xMessageBufferReceive вечно возвращает ноль. Приёмник меньше
сообщения; оно застряло навсегда. Увеличить приёмник.
xMessageBufferSend не кладёт, хотя место есть. Места нет
под сообщение целиком с его четырьмя байтами длины.
Reset возвращает отказ. На буфере кто-то ждёт.
Статический буфер вмещает на байт меньше, чем объявлено. Один байт
хранилища всегда пустой, а …CreateStatic его не добавляет: массив
и размер — N + 1.
32.9 Итоги
- Потоковый буфер — байты без границ, 36 байт заголовка, один писатель и один читатель.
- Один байт хранилища всегда пустой — он отличает «полон» от «пуст»;
Createдобавляет его сам, дляCreateStaticмассив и размер —N + 1. - Триггер — порог пробуждения читателя; при 115 200 бод триггер 16 снижает пробуждения с 11 520 до 720 в секунду.
- Триггер не задерживает данные: по истечении времени читатель получает всё, что есть; ноль означает единицу.
- Функции возвращают число байт, не признак;
SendFromISRтеряет байты молча, если буфер полон. - Буфер сообщений добавляет границы ценой четырёх байт на сообщение; кладёт целиком или никак.
- Приёмник обязан вмещать самое длинное сообщение, иначе оно застревает навсегда.
- Буферы не вызывают функций ядра из пробуждения — потому годятся для связи между ядрами процессора.
Дальше: раздел 32а «Активные объекты: архитектура прибора на событиях — задача, своя очередь и автомат» — как собрать из задач, очередей и таймеров прибор целиком: каждый объект ждёт только на своей очереди событий.